Prologue
本篇文章是对 Operating System: Three Easy Pieces 的 CPU 虚拟化部分的梳理,结合 xv6 教学级内核代码进行解释,并对原文内容做一些补充。
什么是 CPU Virtualization
CPU 虚拟化是操作系统必须要实现的一个部分,简单的来说,操作系统需要给每个正在运行的程序制造出一种 “独占 CPU ” 的错觉(Illusion)。当你正在使用计算机的时候,你不会希望运行某个程序时只能干等着而无法进行任何其他操作,你也不希望某个程序能够轻易地干扰其他程序的进行。操作系统不仅要让每个程序觉得自己独占了 CPU ,并且还能对程序进行限制,以免造成灾难性的后果。
从具体实现的角度来看,计算机除了基本的 CPU 以外,在硬件层面还实现了不同的特权模式,比如 RISC-V 添加了 Control and Status Register (CSR) 来存储特权模式、中断地址等一系列需要的数据以及相关中断/异常机制,OS 可以通过新增的特权指令来读取和修改这些寄存器,从而实现中断异常的处理、系统调用的实现等。
特权模式:Machine-Mode, Supervisor-Mode and User-Mode
为了实现内核的保护机制,对用户程序进行限制,RISC-V 规定了三种状态,Machine-Mode, Supervisor-Mode 和 User-Mode。机器从上电到进入内核前这段时间处于 M-Mode 或者说机器态,内核运行时则是 S-Mode 或者说内核态,用户程序运行时则是 U-Mode 或者说用户态。
M-Mode 拥有最高权限,可以访问所有内存,可以访问所有 CSR ,控制CPU状态。在 xv6 的M-Mode期间出现的一些CSR如下,可供参考
csrr a1, mhartid: 意思是将mhartid的值读取到a1寄存器中mhartid(Machine Hart ID Register) 存储了当前硬件线程 (hart) 的标识符,这段代码出现在entry.S中,在上电时用于修改sp寄存器,完成不同硬件线程的栈空间的分配。
mstatus(Machine Status Register): 存储了一些状态值- xv6 中通过掩码来对某些状态位进行修改,比如 M Previous Privilege mode 就是这么设置的。xv6在启动时设置其为 S-Mode ,这样只要执行返回指令(
mret)就能够在跳转到内核的main()的同时将 CPU 特权模式设置为 S-Mode。
- xv6 中通过掩码来对某些状态位进行修改,比如 M Previous Privilege mode 就是这么设置的。xv6在启动时设置其为 S-Mode ,这样只要执行返回指令(
mepc(Machine Exception Program Counter): 存储了进入 M-Mode 之后返回时的地址,调用mret就会将 PC 设置成这个值来进行返回- xv6 中将
mepc的值设置成了内核的入口main()的地址:w_mepc((uint64)main);
- xv6 中将
medeleg和mideleg(Machine Interrupts/Exceptions Delegation): 异常委托寄存器和中断委托寄存器。- 中断/异常委托(Trap Delegation)是指 M-mode 通过
medeleg和mideleg寄存器,将指定类型的 trap 在发生于 S-mode 或 U-mode 时交由 S-mode 的 trap handler 处理,从而避免这些 trap 进入 M-mode。 - xv6 通过
w_medeleg(0xffff);和w_mideleg(0xffff);委托常见的异常和中断,使它们在 S-mode 或 U-mode 发生时可以直接交给 S-mode kernel 处理
- 中断/异常委托(Trap Delegation)是指 M-mode 通过
pmpaddr0(Physical Memory Protection Address 0): 第 0 个 PMP 地址寄存器 (PMP address = Physical Address / 4)- xv6 使用
w_pmpaddr0(0x1fffffffffffffull);来让其覆盖几乎整个 64-bit 地址空间
- xv6 使用
pmpcfg0(Physical Memory Protection Configuration Register 0): PMP 配置寄存器- xv6 使用
w_pmpcfg0(0x1f);配合上面的pmpaddr0来让 S-Mode/U-Mode 能够读、写、执行整个物理内存
- xv6 使用
mie(Machine-mode Interrupt Enable): 启用中断- xv6 使用
w_mie(r_mie() | MIE_MTIE);来启用计时器中断
- xv6 使用
mscratch: M-Mode 专用的临时寄存器- xv6 使用
mscratch存储了 Timer 中断需要的数据
- xv6 使用
mtvec(Machine Trap-Vector Base-Address Register): 指定发生 Machine-mode trap 时,CPU 跳转到哪里执行处理代码。mie(Machine Interrupt Enable Register): 机器中断使能寄存器- xv6 启用了 Timer 中断 (
w_mie(r_mie() | MIE_MTIE);),发生 Timer 中断时会通过mtvec进入timervec设置下一次中断并触发 S-Mode 软件中断(sip设置为2)改变进程调度
- xv6 启用了 Timer 中断 (
S-Mode 则提供了内核运行时所需要的权限,可以用于处理异常/中断(Trap)、处理系统调用、调度进程、管理虚拟内存等,下面是一些 CSR 以及特权指令
sstatus(Supervisor Status Register)sepc(Supervisor Exception Program Counter)sie(Supervisor Interrupt Enable Register)stvec(Supervisor Trap-Vector Base-Address Register)sip(Supervisor Interrupt Pending Register)satp(Supervisor Address Translation and Protection Register)- 用于设置虚拟内存地址转换,比如
w_satp(0);表示禁用
- 用于设置虚拟内存地址转换,比如
sscratch临时寄存器scause(Supervisor Cause Register)- 保存导致 S-mode trap 的原因(为什么进入 trap)
- Interrupt bit 用于判断中断(1)/异常(0),Exception Code 表示原因(例如 xv6 使用8表示syscall)
stval- 特权指令:
sfence.vma rs1, rs2(Supervisor Fence Virtual Memory Access)- 用于刷新(invalidate)TLB 中与指定虚拟地址和地址空间相关的缓存项,使后续地址转换使用最新的页表内容
- rs1:虚拟地址,rs2:ASID
U-Mode 无法使用特权指令,也无法访问特权寄存器,如果出现必要的情况,需要使用系统调用进入 S-Mode 完成,以下是 xv6 提供的一些系统调用
// system calls
int fork(void);
int exit(int) __attribute__((noreturn));
int wait(int*);
int pipe(int*);
int write(int, const void*, int);
int read(int, void*, int);
int close(int);
int kill(int);
int exec(char*, char**);
int open(const char*, int);
int mknod(const char*, short, short);
int unlink(const char*);
int fstat(int fd, struct stat*);
int link(const char*, const char*);
int mkdir(const char*);
int chdir(const char*);
int dup(int);
int getpid(void);
char* sbrk(int);
int sleep(int);
int uptime(void);
Trap Handling ——如何处理中断和异常?
什么是中断?什么是异常?
中断是外部触发的异步事件(如I/O请求),异常是 CPU 内部检测的同步事件
在 xv6 中,中断可以按来源分为以下几类
- 计时器中断(Timer Interrupt)
- 软件中断(Software Interrupt)
- 外部中断(External Interrupt)
异常的来源比较多样,比如系统调用、页表缺页、非法指令等
发生中断/异常怎么办?
发生中断和异常后,CPU 会根据 trap 的类型和委托设置切换到相应的特权模式,并跳转到对应的 trap vector。未被委托的 Machine-mode trap 进入 mtvec;被委托到 S-mode 的 trap 则进入 stvec。在 xv6 中,mtvec 被设置成了 timervec,用于处理 Machine-mode 计时器中断,而 stvec 则由内核根据实际情况调整:返回用户态前设置为 uservec(处理用户程序产生的 trap),内核运行期间临时设置为 kernelvec(处理内核产生的 trap)。
PC 跳转之后,一般需要保存用于恢复的寄存器状态和数据,执行相应的指令,直到 mret 或者 sret 返回 mepc/sepc 对应的位置,通常是 r_sepc()+4
System Call ——通过系统调用进入内核态,完成用户态程序不能做的事情
为了管理用户程序,用户程序需要使用系统调用来请求操作系统核心服务,实现文件操作、进程控制、内存管理等功能,从而安全地访问系统资源。
System Call 的实质是一种异常,由用户程序触发,关键的 RISCV 汇编指令是 ecall (environment call) 。以 xv6 为例,这一异常触发之后,当前的 PC 值会被硬件保存到 sepc 中并且将 scause 设置为 8 表明这是系统调用引发的异常,随后 PC 跳转到 stvec 指向的地址,交给内核处理,处理完之后就会回到用户程序中。
xv6 中更详细一点的调用过程如下(以 sleep() 为例)
1. U-Mode: 触发系统调用异常 sleep()–>ecall
// in user program
sleep()
// user.h 中的声明
int sleep(int);
# usys.S 中的实现
.global sleep
sleep:
    li a7, SYS_sleep     # 这里#define SYS_sleep  13
    ecall
    ret
2. S-Mode: 保存寄存器、切换页表、恢复内核寄存器 uservec–>usertrap()
stvec 指向 uservec,这是之前返回时写入的,在后面的 usertrap() 中会看到
w_stvec(TRAMPOLINE + (uservec - trampoline));
所以 PC 会跳转至 trampoline.S 中的 uservec
.globl trampoline
trampoline:
.align 4
.globl uservec
uservec:
    # 交换 a0 和 sscratch
    # a0 会指向当前进程的 trapframe 的虚拟地址
    # 这个地址是 sscratch 在之前的返回中写入的,后面在 userret 中会看到
    # trapframe 是一个结构体,里面保存了内核的satp,sp,usertrap地址和hartid,以及进程的epc和的ra,sp,gp,tp等寄存器
    csrrw a0, sscratch, a0

    # 将当前寄存器值保存到内存中的 p->trapframe
    sd ra, 40(a0)
    sd sp, 48(a0)
    sd gp, 56(a0)
    sd tp, 64(a0)
    ...
    # 将当前的 a0 值保存到内存中的 p->trapframe->a0
    csrr t0, sscratch
    sd t0, 112(a0)

    # 从 p->trapframe->kernel_sp 中恢复内核 sp 寄存器
    ld sp, 8(a0)
    # 从 p->trapframe->kernel_hartid 中恢复内核的 tp 寄存器(存储了hartid)
    ld tp, 32(a0)
    # 从 p->trapframe->kernel_trap 中拿到 user_trap 的地址(内核中的虚拟地址)
    ld t0, 16(a0)
    # 从 p->trapframe->kernel_satp 中拿到内核的 satp,并恢复内核的页表,刷新TLB
    ld t1, 0(a0)
    csrw satp, t1
    sfence.vma zero, zero

    # 因为页表切换,原先用户进程中的虚拟地址(比如p->trapframe的地址)已经不适用了
    # 跳转至user_trap
    jr t0
3. S-Mode:处理 Trap,进入系统调用 usertrap()–>syscall()
// trap.c
// 下面省略去了正常情况下不会执行的代码
void usertrap(void) {
    int which_dev = 0;

    // 重新设置 stvec ,内核运行期间发生中断异常会去 kernelvec 处理
    w_stvec((uint64)kernelvec);
    // 前面获得了内核的tp,所以知道 cpuid ,从而从内存中获取当前进程信息
    struct proc *p = myproc();
    // 保存发生异常时的地址到内存中
    p->trapframe->epc = r_sepc();

    if (r_scause() == 8) {
        // system call
        if (p->killed) exit(-1);
        // sepc + 4 从而返回时跳到下一条指令
        p->trapframe->epc += 4;
        // 重新启用中断
        intr_on();
        syscall();
    }
    // ...
    usertrapret();
}
// syscall.c
static uint64 (*syscalls[])(void) = {
    [SYS_fork] sys_fork,   [SYS_exit] sys_exit,     [SYS_wait] sys_wait,     [SYS_pipe] sys_pipe,
    [SYS_read] sys_read,   [SYS_kill] sys_kill,     [SYS_exec] sys_exec,     [SYS_fstat] sys_fstat,
    [SYS_chdir] sys_chdir, [SYS_dup] sys_dup,       [SYS_getpid] sys_getpid, [SYS_sbrk] sys_sbrk,
    [SYS_sleep] sys_sleep, [SYS_uptime] sys_uptime, [SYS_open] sys_open,     [SYS_write] sys_write,
    [SYS_mknod] sys_mknod, [SYS_unlink] sys_unlink, [SYS_link] sys_link,     [SYS_mkdir] sys_mkdir,
    [SYS_close] sys_close,
};
void syscall(void) {
    int num;
    struct proc *p = myproc();
    num = p->trapframe->a7;
    if (num > 0 && num < NELEM(syscalls) && syscalls[num]) {
        p->trapframe->a0 = syscalls[num]();     // 根据 a7 存储的系统调用号执行对应的函数
    } else {
        printf("%d %s: unknown sys call %d\n", p->pid, p->name, num);
        p->trapframe->a0 = -1;
    }
}
执行 sys_sleep()
// sysproc.c
uint64 sys_sleep(void) {
    int n;
    uint ticks0;

    if (argint(0, &n) < 0) return -1;
    acquire(&tickslock);
    ticks0 = ticks;
    while (ticks - ticks0 < n) {
        if (myproc()->killed) {
        release(&tickslock);
        return -1;
        }
        sleep(&ticks, &tickslock);
    }
    release(&tickslock);
    return 0;
}
4. S-Mode: 收尾工作,即将回到用户程序 usertrapret()–>userret
系统调用执行完成回到 usertrap() 最后执行 usertrapret()
// trap.c
void usertrapret(void) {
  struct proc *p = myproc();

  // 禁用中断
  intr_off();
  // 重新写入 uservec 的地址,xv6用了一些手段让其在用户页表和内核页表中都映射到了 trampoline 代码所在的同一物理页。
  w_stvec(TRAMPOLINE + (uservec - trampoline));

  // 设置前面 trampoline.S 中要用的数据到 trapframe 中
  p->trapframe->kernel_satp = r_satp();          // kernel page table
  p->trapframe->kernel_sp = p->kstack + PGSIZE;  // process's kernel stack
  p->trapframe->kernel_trap = (uint64)usertrap;
  p->trapframe->kernel_hartid = r_tp();  // hartid for cpuid()
  // 设置 sret 时需要的寄存器
  // 设置 S Previous Privilege mode 为 User
  unsigned long x = r_sstatus();
  x &= ~SSTATUS_SPP;  // clear SPP to 0 for user mode
  x |= SSTATUS_SPIE;  // enable interrupts in user mode
  w_sstatus(x);
  // 设置 sepc
  w_sepc(p->trapframe->epc);

  // 根据进程的 pagetable 生成用户程序要用的 satp,便于后续页表切换
  uint64 satp = MAKE_SATP(p->pagetable);

  // 跳转到 userret 并在那里切换页表并完成返回
  uint64 fn = TRAMPOLINE + (userret - trampoline);
  ((void (*)(uint64, uint64))fn)(TRAPFRAME, satp);  // ABI 保证了 a0=TRAPFRAME, a1=satp
}
PC 会跳转至 trampoline.S 中的 userret
5. U-Mode前的最后工作:切换页表,恢复寄存器并返回 userret
.globl userret
userret:
        # a0: TRAPFRAME,是进程的 trapframe 地址,xv6 规定了不同进程中 TRAPFRAME 虚拟地址都是 TRAMPOLINE - PAGESIZE,所以是一样的
        # a1: user page table, for satp.

        # 切换页表并刷新TLB
        csrw satp, a1
        sfence.vma zero, zero

        # 将进程的 a0 值暂存到 sscratch 中
        ld t0, 112(a0)
        csrw sscratch, t0

        # 恢复除了 a0 以外的全部寄存器
        ld ra, 40(a0)
        ld sp, 48(a0)
        ld gp, 56(a0)
        ld tp, 64(a0)
        ld t0, 72(a0)
        ld t1, 80(a0)
        ld t2, 88(a0)
        ld s0, 96(a0)
        ld s1, 104(a0)
        ld a1, 120(a0)
        ld a2, 128(a0)
        ld a3, 136(a0)
        ld a4, 144(a0)
        ld a5, 152(a0)
        ld a6, 160(a0)
        ld a7, 168(a0)
        ld s2, 176(a0)
        ld s3, 184(a0)
        ld s4, 192(a0)
        ld s5, 200(a0)
        ld s6, 208(a0)
        ld s7, 216(a0)
        ld s8, 224(a0)
        ld s9, 232(a0)
        ld s10, 240(a0)
        ld s11, 248(a0)
        ld t3, 256(a0)
        ld t4, 264(a0)
        ld t5, 272(a0)
        ld t6, 280(a0)

        # 交换 a0 和 sscratch
        # 这样 a0 恢复,sscratch 保存了下次系统调用时会用到的 trapframe 地址
        csrrw a0, sscratch, a0

        # 返回,会变成用户态,回到原来的位置
        sret
Context Switch ——切换进程以避免独占 CPU
为了实现多任务,让机器运行的任务数量高于 CPU 数量,操作系统会隔一段时间就进行切换进程的操作,这样看起来就像是在同时执行很多任务。在切换进程的过程中需要保存旧进程的各种寄存器信息,恢复新进程的寄存器信息。
在 xv6 中实现的上下文切换过程大致是
计时器中断
-->PC跳转至STVEC指向的uservec
-->usertrap()
-->yield(),进程状态设置成 RUNNABLE 并且上锁
-->sched(),保存CPU的中断启用状态
-->swtch(),保存当前进程的上下文,加载CPU的上下文,从而回到scheduler()
-->scheduler(),进程释放锁,选择下一个进程,切换上下文
-->执行下一个用户程序
...某次计时器中断之后
-->scheduler(),切换到了原来这个进程,并且上锁
-->切换上下文,回到了sched()中
-->sched()返回到了yield()中,释放进程锁
-->yield()返回usertrap()
-->usertrapret()(新版的 xv6 代码中简化了这部分流程,函数名改成了prepare_return(),不是调用userret,而是返回 satp 后接着执行userret)
-->userret
-->返回用户程序
比较关键的一些代码
// usertrap()中
// give up the CPU if this is a timer interrupt.
if (which_dev == 2)     // 前面有 which_dev = devintr() 来获取中断来源,2表示中断类型是时钟中断,本质是通过 scause 来判断的
    yield();
void yield(void) {
  struct proc *p = myproc();
  acquire(&p->lock);
  p->state = RUNNABLE;
  sched();
  release(&p->lock);
}
void sched(void) {
  int intena;
  struct proc *p = myproc();

  if (!holding(&p->lock)) panic("sched p->lock");
  if (mycpu()->noff != 1) panic("sched locks");
  if (p->state == RUNNING) panic("sched running");
  if (intr_get()) panic("sched interruptible");

  intena = mycpu()->intena;
  swtch(&p->context, &mycpu()->context);    // 执行完之后会载入 mycpu 的 context 进入到 scheduler 的 swtch 语句的下一条中
  mycpu()->intena = intena;
}
.globl swtch
swtch:
        # 根据 ABI ,a0=&p->context, a1=&mycpu()->context
        sd ra, 0(a0)
        sd sp, 8(a0)
        sd s0, 16(a0)
        sd s1, 24(a0)
        sd s2, 32(a0)
        sd s3, 40(a0)
        sd s4, 48(a0)
        sd s5, 56(a0)
        sd s6, 64(a0)
        sd s7, 72(a0)
        sd s8, 80(a0)
        sd s9, 88(a0)
        sd s10, 96(a0)
        sd s11, 104(a0)

        ld ra, 0(a1)
        ld sp, 8(a1)
        ld s0, 16(a1)
        ld s1, 24(a1)
        ld s2, 32(a1)
        ld s3, 40(a1)
        ld s4, 48(a1)
        ld s5, 56(a1)
        ld s6, 64(a1)
        ld s7, 72(a1)
        ld s8, 80(a1)
        ld s9, 88(a1)
        ld s10, 96(a1)
        ld s11, 104(a1)

        ret     # 只是普通的返回,新的 ra 决定了其返回的地址是上条 swtch() 语句的下一个条指令
void scheduler(void) {
  struct proc *p;
  struct cpu *c = mycpu();
  c->proc = 0;
  for (;;) {
    // Avoid deadlock by ensuring that devices can interrupt.
    intr_on();
    int found = 0;
    for (p = proc; p < &proc[NPROC]; p++) {
      acquire(&p->lock);
      if (p->state == RUNNABLE) {   // xv6 使用的调度策略比较简单,遍历进程数组直到有一个可执行的,类似于后面的 SQMS
        p->state = RUNNING;
        c->proc = p;
        swtch(&c->context, &p->context);    // 切换之后就会进入用户程序的上下文中,后面的 c-proc=0; 等语句暂时不会执行
        c->proc = 0;    // sched() 中的 swtch 执行完后会回到这里来
        found = 1;
      }
      release(&p->lock);
    }
    if (found == 0) {
      intr_on();
      asm volatile("wfi");  // Wait For Interrupt 找不到 RUNNABLE 进程则让当前 hart(硬件线程)进入低功耗等待状态,直到发生中断。
    }
  }
}
和系统调用的主要区别在于计时器造成的中断会在 usertrap() 期间识别出来,然后调用 yield(),sched(),swtch() 来回到内核的 scheduler() 函数中,以完成进程的切换
Scheduler ——什么时候应该运行什么程序?
前面介绍了进程切换的机制(mechanism),这里还需要解决一个调度问题,也就是选择哪个进程来执行的问题(policy)
给定一些任务,虽然 CPU 的总花费时间是一定的(如果不考虑I/O的话),但是先后执行顺序的不同会影响下面三个参数
$$ T_{response} = T_{first-run} - T_{arrival} \ T_{turnaround} = T_{completion} - T_{arrival} \ T_{waiting} = T_{turnaround} - T_{burst} $$
响应时间 (Response Time) 一般对交互式程序和实时程序相当重要;周转时间(Turnaround Time)则对批处理程序(batch)比较重要;
| 程序类型 | Response Time | Turnaround Time | Waiting Time | 原因 |
|---|---|---|---|---|
| 交互式程序(Interactive) | ⭐⭐⭐ 最重要 | ⭐ | ⭐⭐ | 用户希望立即得到反馈,不能卡顿 |
| 批处理程序(Batch) | ⭐ | ⭐⭐⭐ 最重要 | ⭐⭐ | 关注整体完成效率,例如编译、大规模计算 |
| 实时程序(Real-time) | ⭐⭐⭐ 关键 | ⭐⭐ | ⭐⭐ | 必须满足 deadline,延迟不可接受 |
| 后台任务(Background) | ☆ | ⭐⭐ | ⭐⭐ | 用户不直接感知,吞吐量更重要 |
| 服务器请求(Web server) | ⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐ | 用户等待响应,同时希望请求快速完成 |
Fairness v.s. Performance ——公平与性能不可兼得
调度的公平性(Fairness)指的不同进程获得 CPU 资源的机会是否公平,是否有进程长期得不到运行机会;而调度的性能(Performance)指的是系统完成工作的能力,它的指标包括周转时间、响应时间等等。下面的调度算法将会体现这一矛盾。
First In First Out (FIFO) ——先进先出
假设不考虑 I/O ,也不考虑多核的情况,给定一系列已知时间的任务,你会怎么安排?
FIFO 调度是一个公平的调度算法,就像排队一样,先来的人先占用 CPU 资源,结束后才是下一个。比如给定下面的任务。
| 任务编号 | 执行时间(burst time) | 进入时间(arrival time) |
|---|---|---|
| A | 100 | 0 |
| B | 10 | 0 |
| C | 10 | 0 |
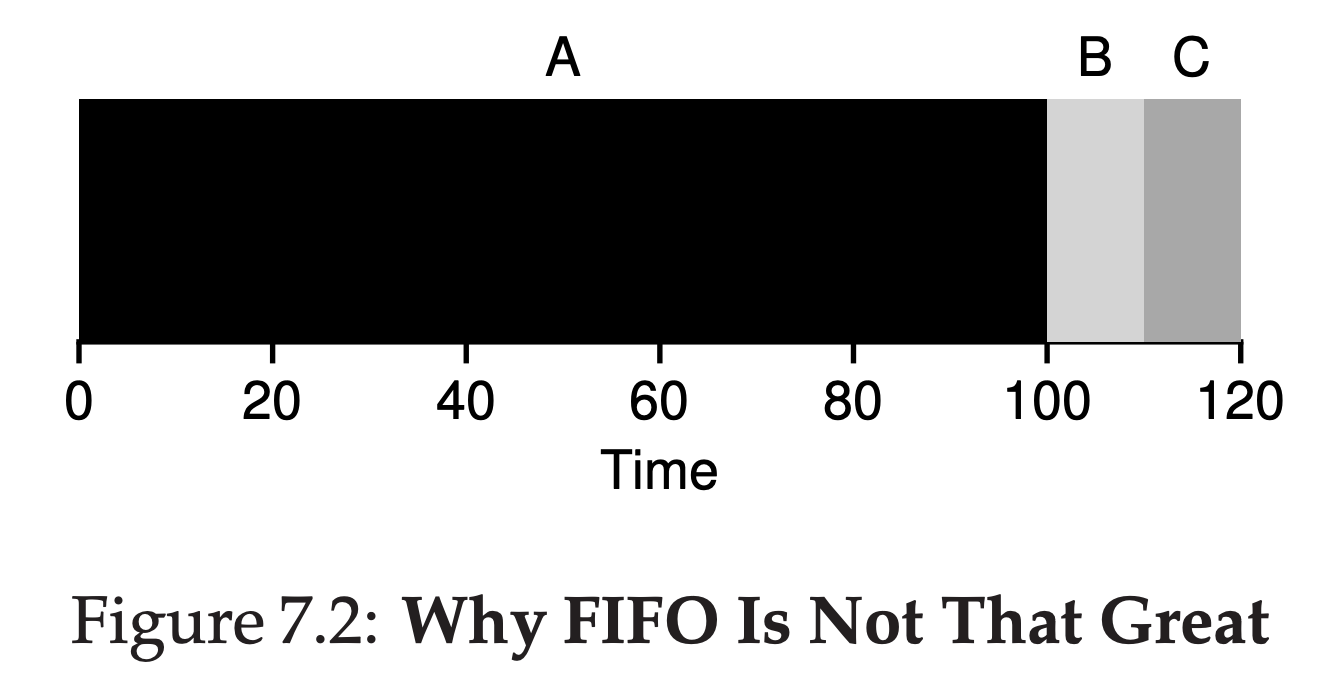
可以计算出图片中的响应时间、周转时间和等待时间
| 任务编号 | 响应时间(Response Time) | 周转时间(Turnaround Time) | 等待时间(Waiting Time) |
|---|---|---|---|
| A | 0 | 100 | 0 |
| B | 100 | 110 | 100 |
| C | 100 | 120 | 110 |
| Average | 66.67 | 110 | 70 |
可以看到,B 和 C 因为 A 长时间执行而拖慢了响应时间、周转时间和等待时间,这一现象称为护航效应 (convoy effect) 。整个系统的平均响应时间、周转时间都被拉高了。
Shortest Job First (SJF) ——容易的事情先完成
对于刚才的情况,显然有一种更好的算法,也就是把短任务放在前面。
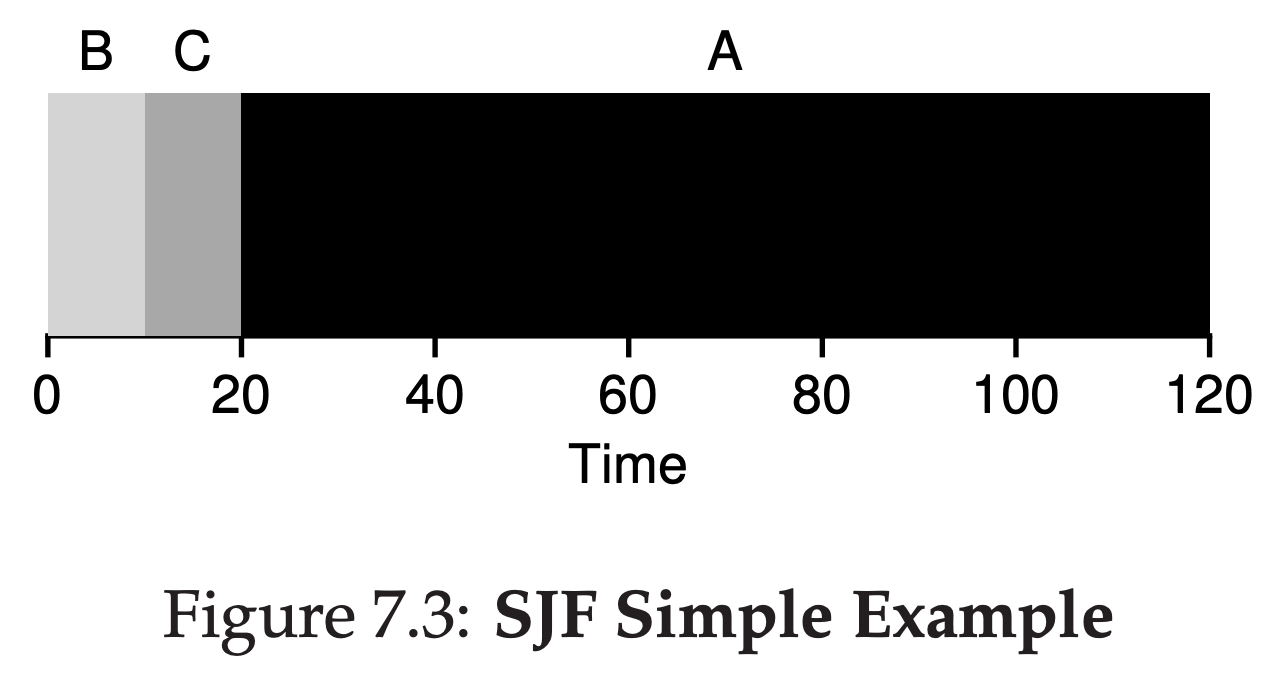
重新计算如下
| 任务编号 | 响应时间(Response Time) | 周转时间(Turnaround Time) | 等待时间(Waiting Time) |
|---|---|---|---|
| A | 20 | 120 | 20 |
| B | 0 | 10 | 0 |
| C | 10 | 20 | 10 |
| Average | 10 | 50 | 10 |
可以看到,三个指标都明显比先前要好
但是 SJF 也有它的问题,看看下面的图片,B 和 C 只是来晚了一点,就被 A 阻塞了,然后又出现前面提到的护航效应
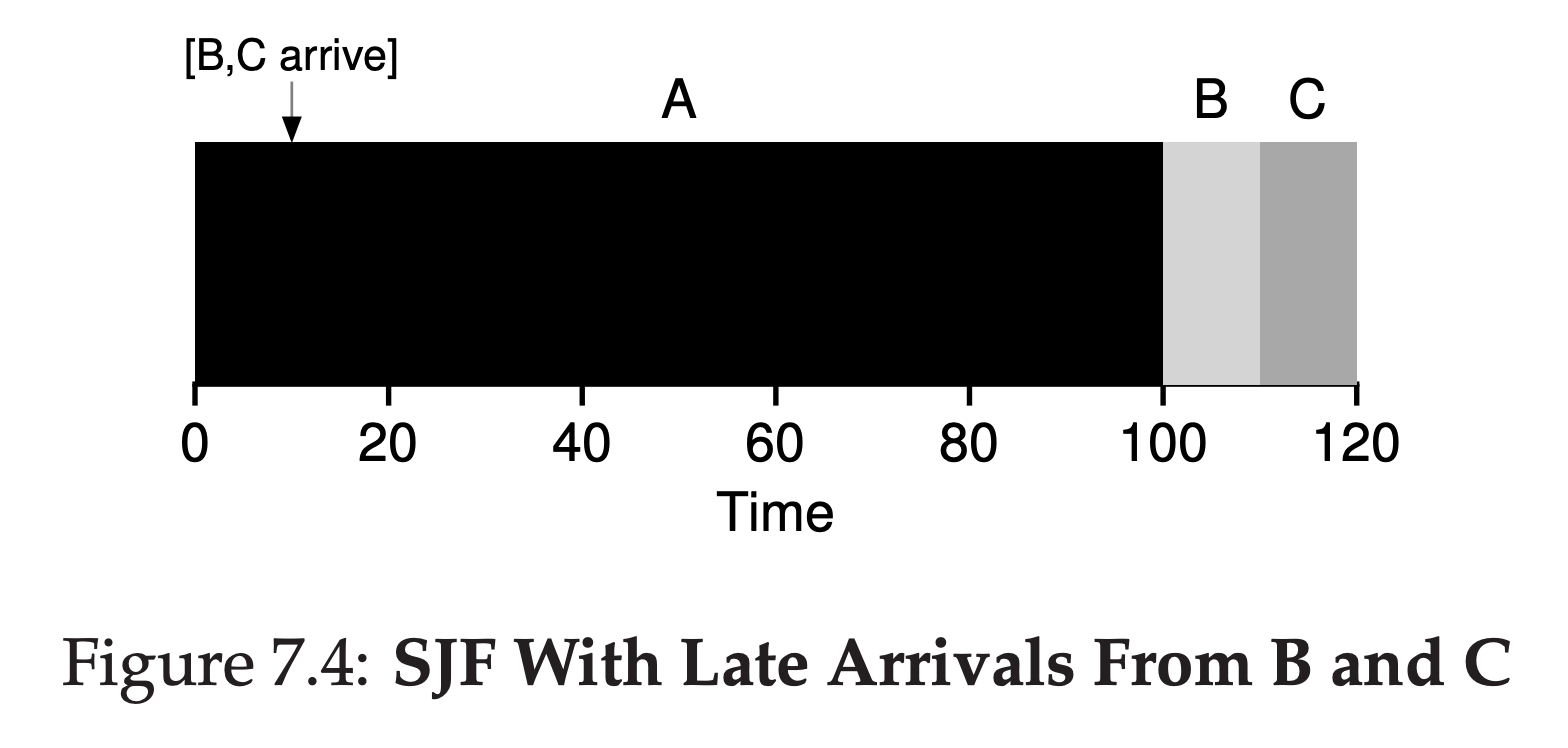
所以就有了一个改进算法——STCF
Shortest Time-to-Completion First (STCF) ——先完成快完成的事情
STCF 算法是对 SJF 的一个改进,在前面的例子中,B 和 C 明显比 A 要更快完成,所以这个算法的指标是选择当前任务列表中最接近完成的任务来执行
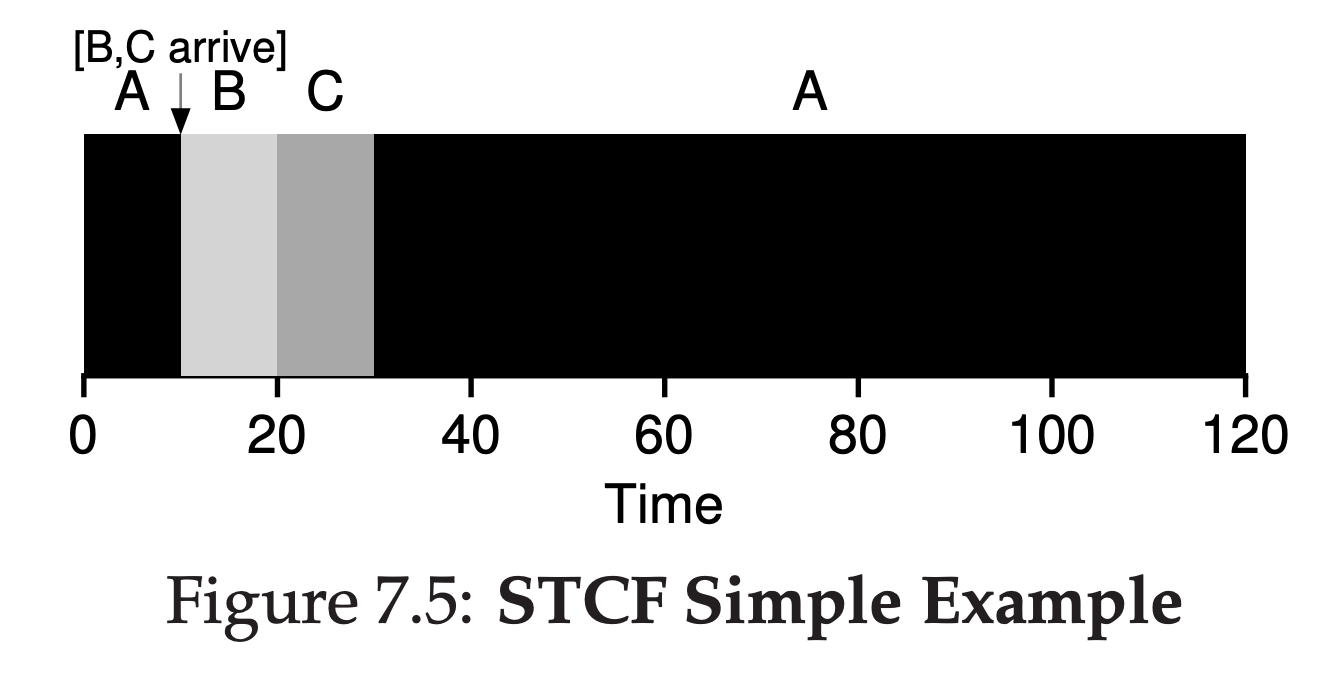
这样就可以避免前面的护航效应了。
但是考虑这样一个情况,如果不断有短的任务加入,那么长时间的任务(比如这里的任务 A)就一直被插队,从而无法获得 CPU 资源,这意味着公平性的下降。不过更重要的是,上面的算法响应时间都不够快。假设上面的 C 是某个用户交互的程序,那么它的等待时间是 10;如果单位是秒,这会非常糟糕。
Round Robin (RR) ——将任务切片完成
为了更快的响应时间,出现了轮询调度算法(Round Robin),也就是每个任务轮流执行一定时间。
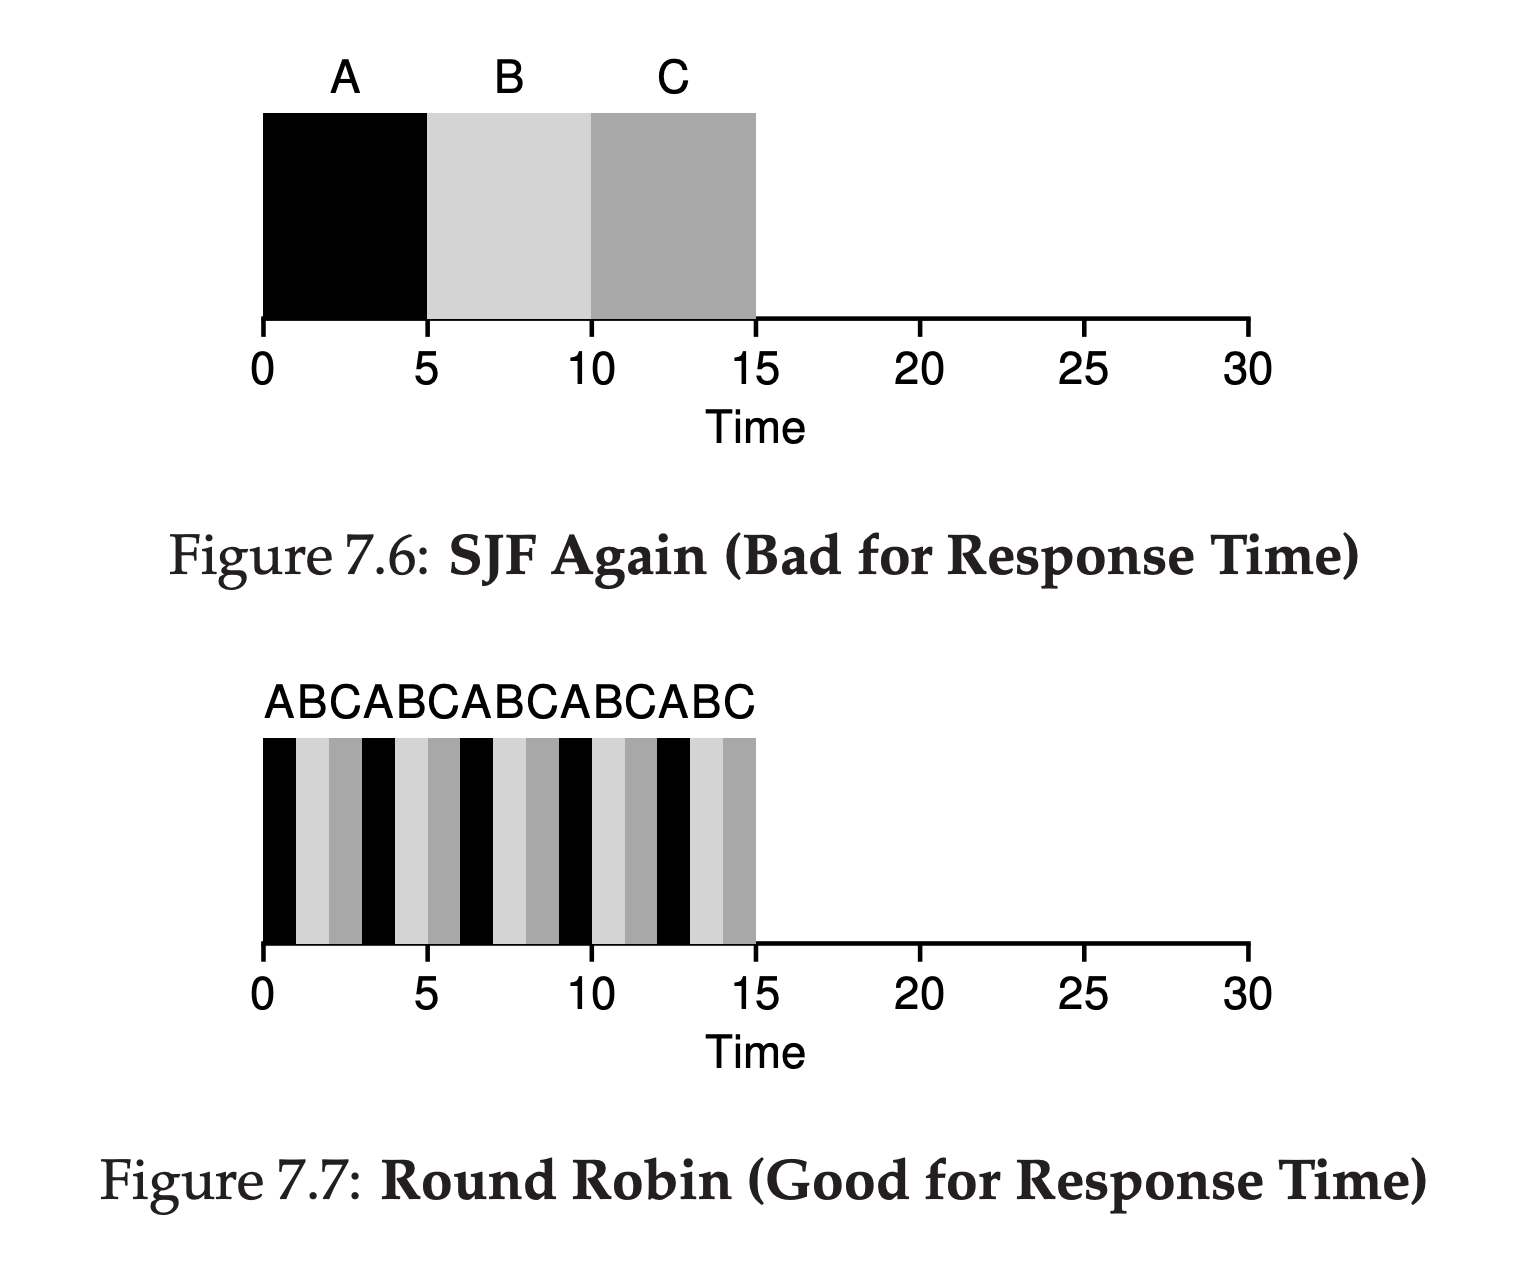
| 任务编号 | 响应时间(Response Time) | 周转时间(Turnaround Time) | 等待时间(Waiting Time) |
|---|---|---|---|
| A | 0->0 | 5->13 | 0->8 |
| B | 5->1 | 10->14 | 5->9 |
| C | 10->2 | 15->15 | 10->10 |
| Average | 5->1 | 10->14 | 5->9 |
可以看到,RR 算法大幅降低了响应时间,代价是拉长了周转时间和等待时间。想象一下,当你使用电脑同时打开很多个程序,每个程序的运行速度都会整体变慢。
此外还有一个问题是进程切换的开销,如果切片切得越碎,虽然响应时间会变小,但是上下文切换的时间占比也会越大。
I/O 对调度的影响
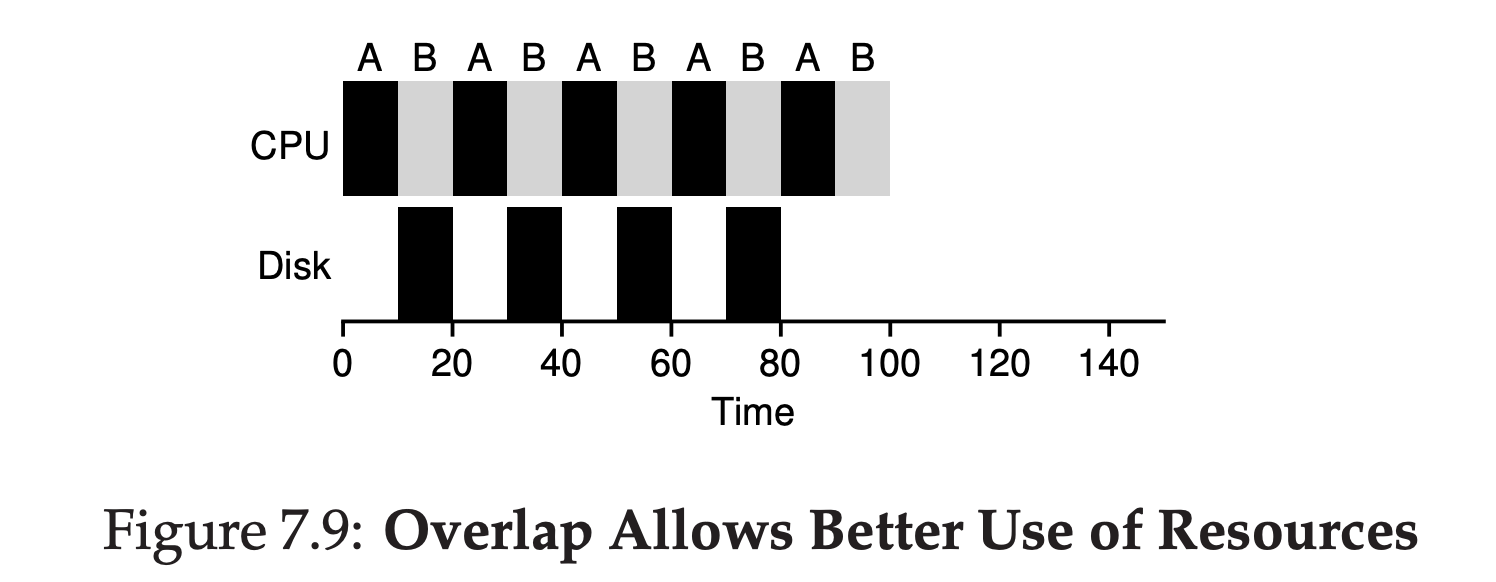
前面的讨论忽略了 I/O,如果加入了I/O,那么可以引入重叠(Overlap)来提高 CPU 利用效率
当前进程等待 I/O 的期间,CPU 如果干等着是非常浪费的,这个时候就可以去执行别的程序,直到原来的进程可以继续进行。一般进程在等待 I/O 的期间会从 Running 状态变成 Sleeping 状态,I/O 请求完成会产生中断把进程变成 Runnable 状态(在 xv6 中存在UNUSED, SLEEPING, RUNNABLE, RUNNING, ZOMBIE 状态,出现中断时会在 devintr() 中判断,外部中断会在这里处理)
enum procstate {
  UNUSED,     // 未使用
  SLEEPING,  // 睡眠等待事件
  RUNNABLE,  // 可运行,等待 CPU
  RUNNING,   // 正在 CPU 上运行
  ZOMBIE     // 已退出但父进程未回收
};
引入 Overlap 之后的图像如下
Multi-Level Feedback Queue (MLFQ) ——按不同优先级执行
前面的讨论中有一个不切实际的假设,也就是调度器提前知道每个任务会花费的时长,这显然是不可能的,OSTEP 中称之为神谕(Oracle)。如同 CPU 的分支预测一样,真实的调度器通过过去的行为来预测未来。
我们可以简单的把用户程序分成两类,一类程序交互频繁,要求尽量低的响应时间,而另一类程序则以密集计算为主,不太追求响应时间,反而更需要降低周转时间。可以看到前者在 RR 算法中表现良好,后者在 SJF/STCF 中表现良好,怎么样才能兼顾两者?
我们的调度算法应该有某种机制把这两类程序区分开来,交互类程序应该有较短的切片时长(slice)并且优先级高以追求响应速度,批处理程序的切片则不需要短切片。
一个简单的想法是,给出多个优先级队列(Queue),然后将不同的程序分成三六九等,高优先级的程序先执行,低优先级的程序后执行。
我们的机制初步如下
- Rule 1: 如果优先级 A > B,执行 A
- Rule 2: 如果优先级 A = B, 交替执行 A 和 B (RR)
我们还需要有调整优先级的机制
- Rule 3: 任务进入系统时,默认放在最高优先级
- Rule 4a:任务如果用完了这个级别的整个时间片,降级
- Rule 4b:任务如果在时间片用完之前就放弃了 CPU ,不降级
注意到这个规则有一些漏洞
- 编写用户程序的程序员可以在每次时间片用完之前提前放弃 CPU ,来实现独占资源的目的
- 程序优先级降到最低之后没法回来,如果程序此时有交互部分的话将会变得很糟糕。
所以新添加 Rule 5,并且修改原来的 Rule 4a,4b
- Rule 4: 如果任务用完了当前优先级的时间份额(不管中间放弃了多少次 CPU),就降低优先级
- Rule 5: 隔了一段时间 S 之后,所有任务都变成最高优先级
这就是 OSTEP 中的 MLFQ 全部规则,适用于单核心 CPU 的调度。
Lottery Scheduling ——通过抽奖实现按比例调度
Fair-Share Scheduling 公平调度让所有应用程序平均可获得相等的资源份额
Proportional-Share Scheduling 比例份额调度则是让每个任务获得某一百分比的 CPU 时间,这一类型的调度方法一般会用于数据库、服务器上,比如每个用户需要分到不同的 CPU 份额。
前面说的 MLFQ 很显然不属于这一范畴,OSTEP 介绍了一种称之为彩票调度(Lottery Scheduling)的方法。
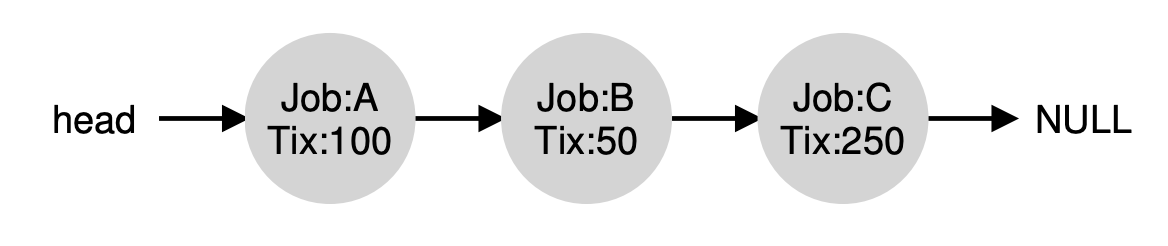
所有的任务使用链表来连接,每个链表节点存储了任务的内容以及票数(Number of Tickets)
// counter: 用于判断是否找到了 winner
int counter = 0;
// winner: 通过随机数生成来决定 winner
// 在总票数和0之间生成一个随机数
int winner = getrandom(0, totaltickets);
// current指针: 用于指向任务链表中的任务
node_t *current = head;
// 循环,直到找到 winner
while (current) {
    counter = counter + current->tickets;
    if (counter > winner)
    break; // found the winner
    current = current->next;
}
// ’current’ is the winner: schedule it...
在图片的例子中,假设生成的 winner 是 140 ,那么对应的任务就是 Job B (100 < 140 < 100+50)
用概率来调度的好处是可以规避一些边界情况,这里每个任务的执行时间越长,时间切片越短,或者说抽奖的次数越多,总体上越公平。但是它也有一些问题,比如每个任务 tickets 不好确定,新加入的任务 tickets 过多会产生通货膨胀(inflation)。
Stride Scheduling ——严格按比例分配时间
除了采用抽奖的方式,OSTEP 还提供了一个调度方法: Stride 调度
系统中的每个任务都有一个 Stride,但是和 Ticket 不同,Stride 越大,分到的 CPU 份额就会越少。下面是一个简单的例子
| A | B | C | |
|---|---|---|---|
| Tickets数量 | 100 | 50 | 250 |
| 对应的 Stride (这里用10000/Ticket数量) | 100 | 200 | 40 |
| 初始的 Pass | 0 | 0 | 0 |
调度过程如下
current = remove_min(queue);    // 从队伍中选出 pass 最小的任务
schedule(current);              // 任务占用一段时间资源
current->pass += current->stride; // pass 增加 stride
insert(queue, current);         // 将这个任务插入回原先的队伍中
| Pass(A)(stride=100) | Pass(B)(stride=200) | Pass(C)(stride=40) | Who Runs? |
|---|---|---|---|
| 0 | 0 | 0 | A |
| 100 | 0 | 0 | B |
| 100 | 200 | 0 | C |
| 100 | 200 | 40 | C |
| 100 | 200 | 80 | C |
| 100 | 200 | 120 | A |
| 200 | 200 | 120 | C |
| 200 | 200 | 160 | C |
| 200 | 200 | 200 | … |
这个算法也有它的问题,除了份额确定问题以外,还有如果中间插入新的进程,pass 要怎么处理的问题。
Multiprocessor Scheduling
前面讲的调度算法都假设单 CPU ,而现在的机器基本上都是多核心的,因此多核调度非常重要。多核调度不仅要均衡分配核心,避免所谓一核有难八核围观的问题,还要解决死锁和抢夺锁而造成的额外开销问题。
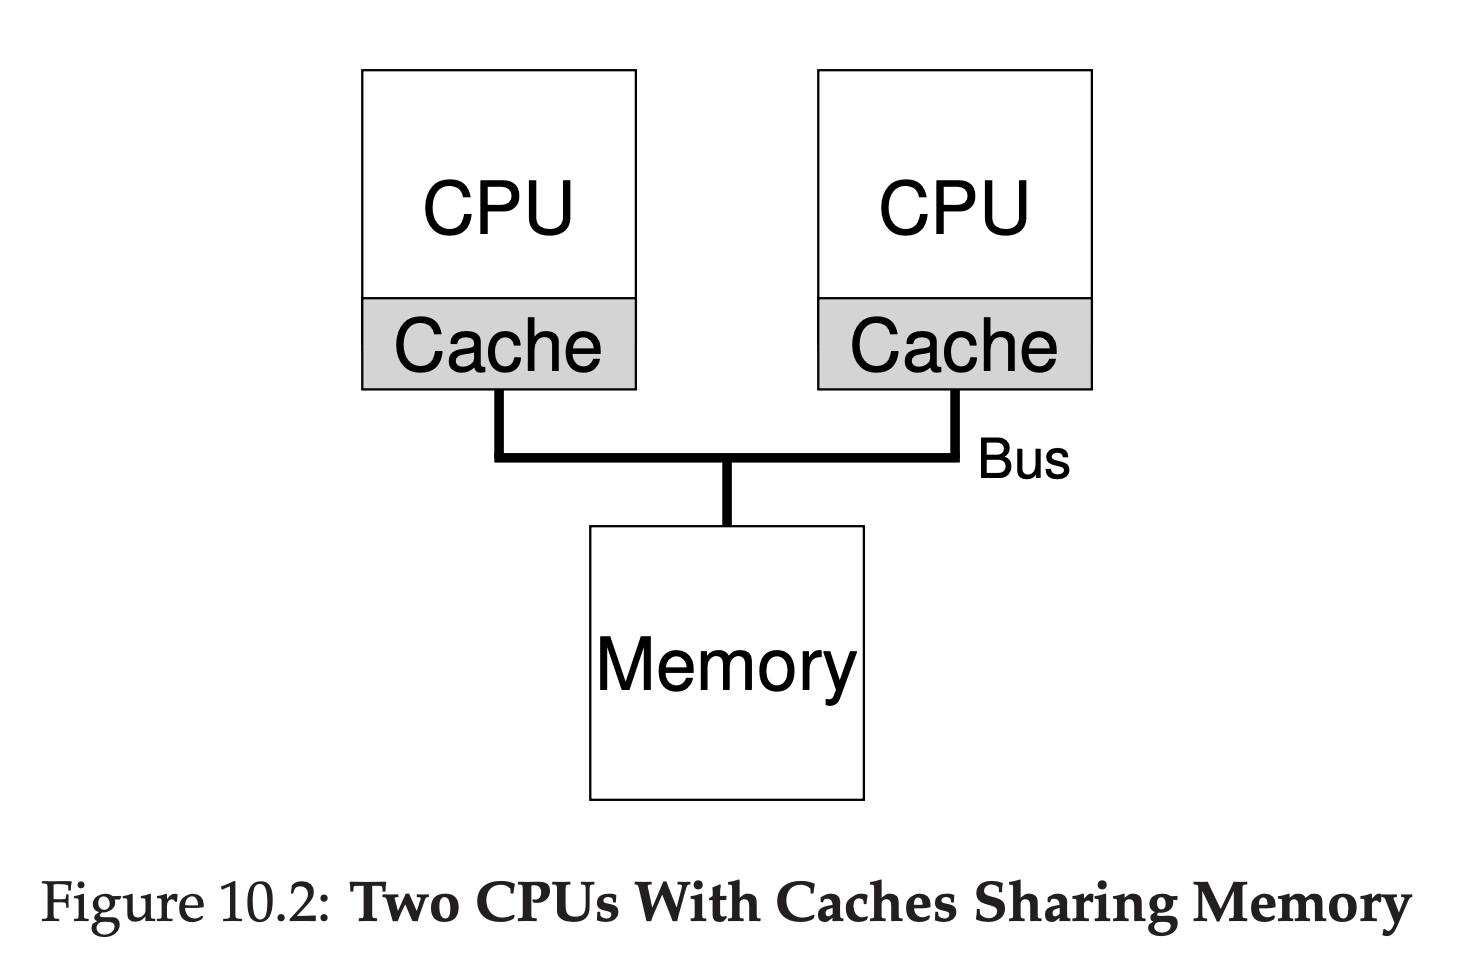
由于不同的 CPU 拥有自己 Cache,这就带来了缓存一致性(Cache Coherence)的问题,如果地址为 A 的数据 D 被加载到了 CPU0 的 Cache中,并且修改成了 D’,在 D’ 被写回内存之前,CPU1 要获取地址 A 的数据,那么它得到的就是旧的数据 D。
一个简单的解决方案是,Cache 之间存在一个总线监听(Bus Snooping)的机制,每个 CPU 的 Cache 控制器监听(snoop)共享总线上的内存访问请求,如果发现其他 CPU 修改了自己缓存中的数据,就采取相应动作,保证多个 Cache 中的数据一致。
虽然缓存提供了这样一个方案来解决缓存一致性的问题,用户程序实际上仍然需要注意访问共享数据的情况。虽然缓存是一致了,但是每个 CPU 内的寄存器数据未必一致,所以程序通常还会使用锁(lock)机制(还有比较复杂的原子操作(atomic operation))来确保一致性的问题。
除此之外,一个任务应该尽量避免切换核心,这意味着原先的 CPU 的缓存(还有 TLB )里的相关数据会浪费掉,所以出现了一个术语:缓存亲和力(Cache Affinity)来描述这一情况,相似的还有 CPU 亲和力(CPU Affinity)
Single-Queue Multiprocessor Scheduling (SQMS)
多核调度的一个最简单,同时也能够复用先前的调度机制的方法是 SQMS 调度,这也是 xv6 采取的调度方案,建立一个调度队列如下
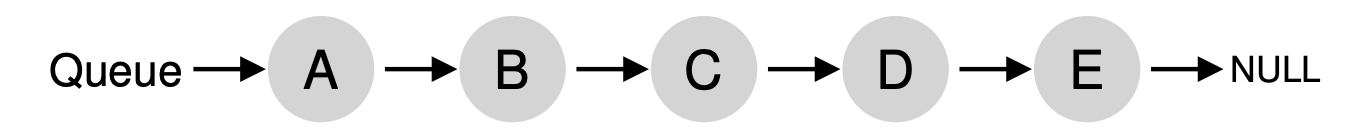
不同的 CPU 就会从这个队列里面获取可执行的任务,然后执行,类似于下面的样子
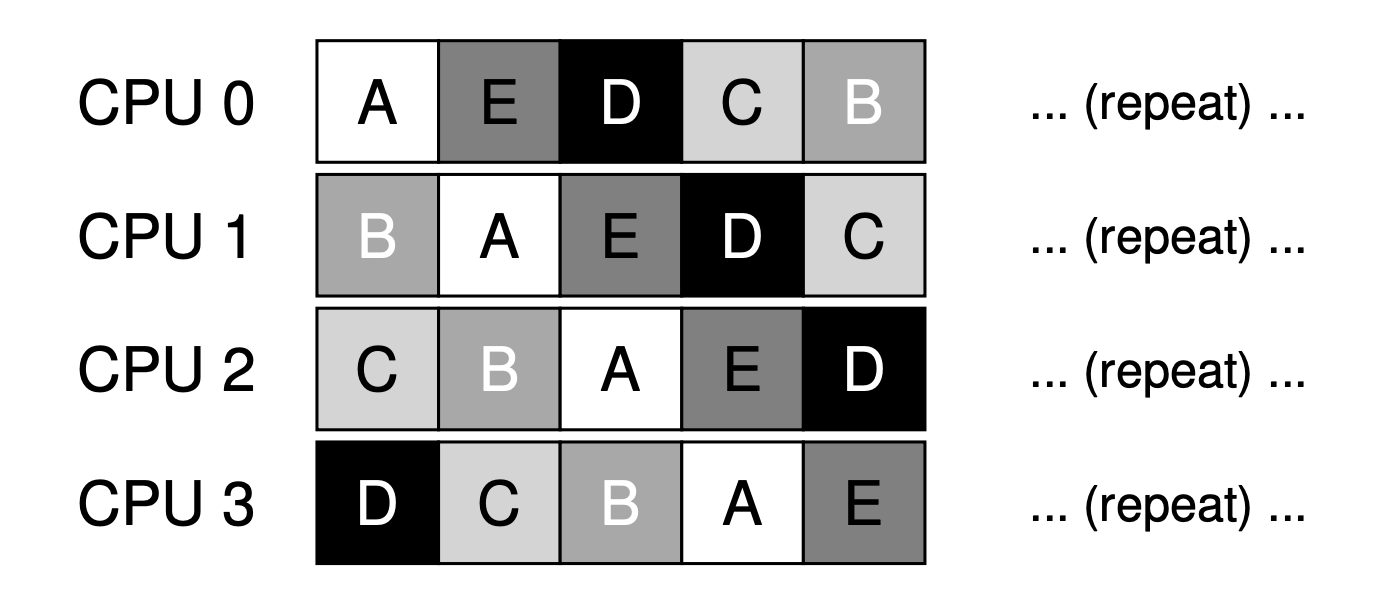
可以看到这个现象完全违背了前面的缓存亲和力要求,所以大部分 SQMS 调度器会采用一些机制来提高缓存亲和力。
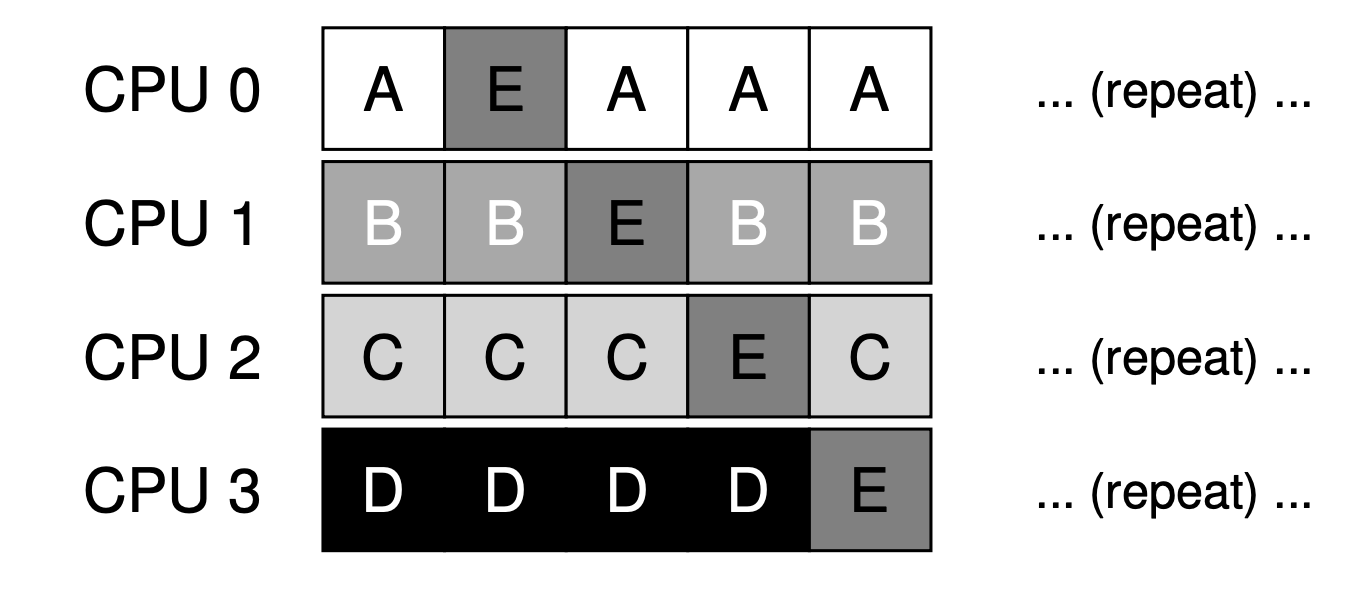
这样只有 E 一直在 CPU 之间穿梭
SQMS 通常使用锁机制来确保一致性的问题,但是锁机制会产生额外开销,其带来的竞争也会显著降低并行性能,尤其是核心变多的时候,这也使得 SQMS 的可扩展性(Scalability)较差
Multi-Queue Multiprocessor Scheduling (MQMS)
为了解决上面提到的两个问题(缓存亲和力和锁开销),还有一种方案是 MQMS:每个 CPU 都有自己的队列,执行自己队列的任务。
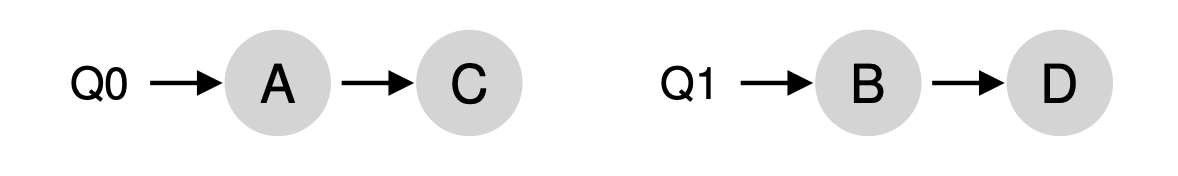
每个 CPU 都可以自己选择不同的调度策略来执行队列内的任务,比如 RR
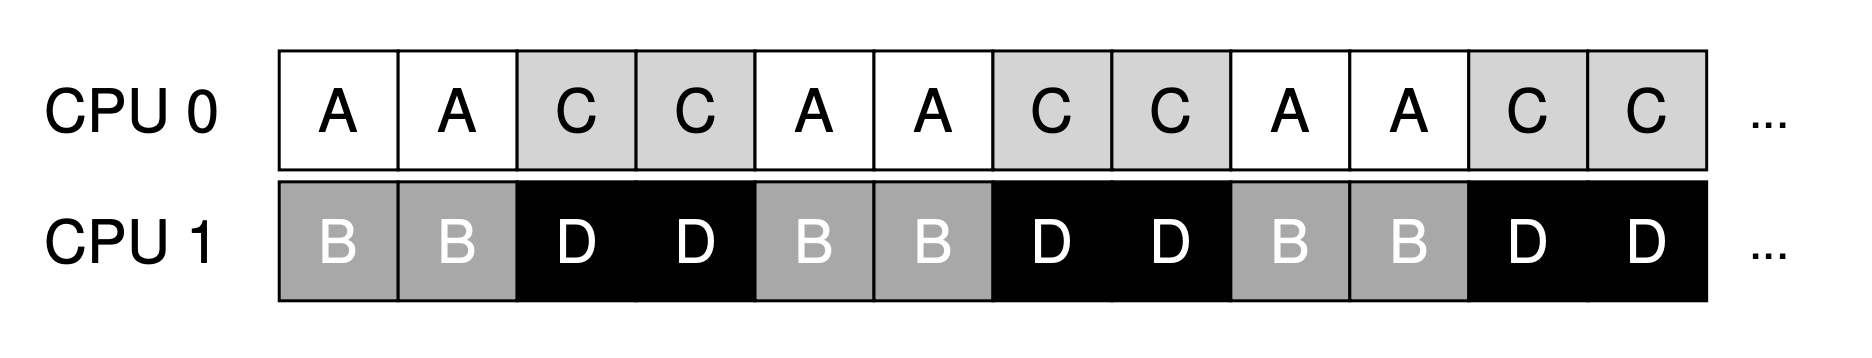
这样就解决了缓存亲和力和锁开销的问题,提高了可扩展性和性能。
任务迁移(migration)和工作窃取(work stealing)
MQMS 的问题在于容易造成负载不均衡,在上面的例子中,如果 CPU0 执行完了任务C,那么 CPU0 的负荷就会明显小于 CPU1. 当 CPU0 完成了任务 A 和 C 后,CPU1 没完成 B 和 D,就会造成利用率低下的问题。
为了解决这个问题,必须存在一个机制允许任务的迁移(Migration)
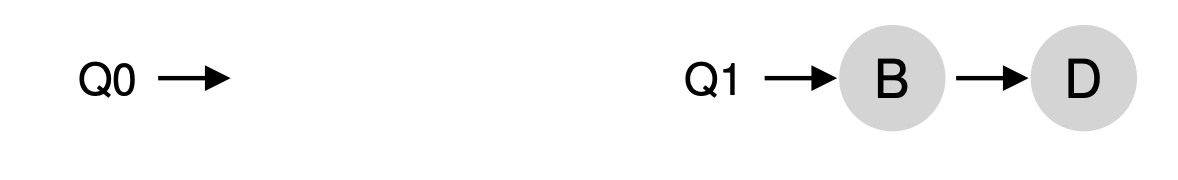
在这个例子中,可以把 B 或者 D 迁移到 Q0 中。
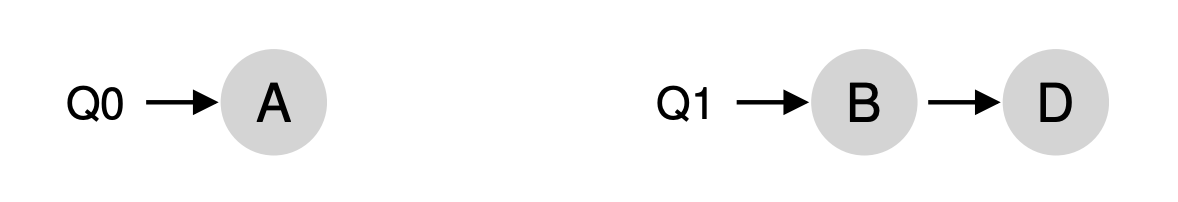
而在这个例子中似乎无论怎么迁移都不太合适,OSTEP 给出的解决方案是隔一段时间迁移一次。
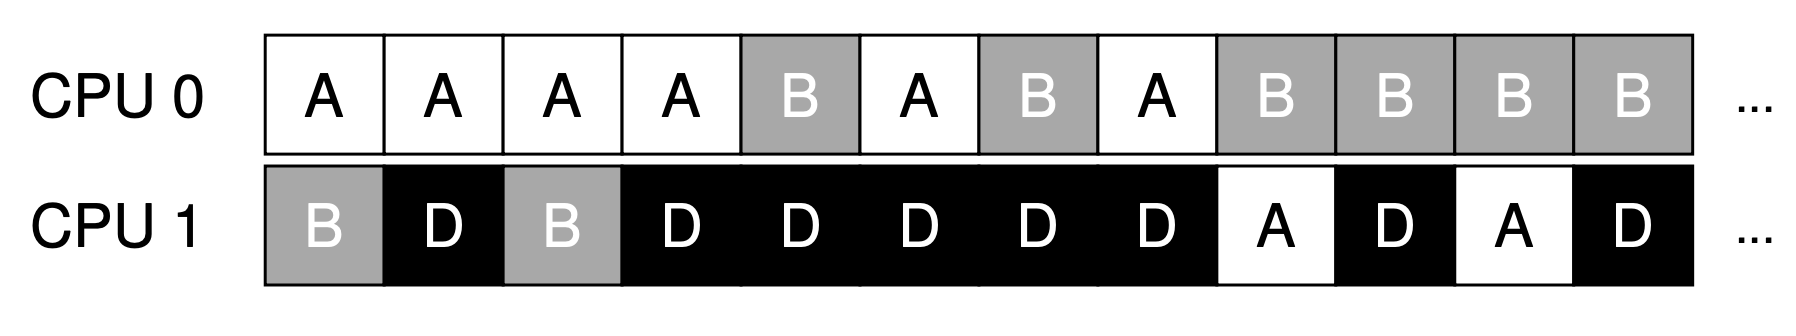
系统实施任务迁移的手段是工作窃取(Work Stealing),负载低的队列(Source Queue)会时不时查看(peek)其他队列(Target Queue),如果其他队列的负载明显过高,就会偷取一些任务以平衡负载。
Linux Multiprocessor Schedulers
OSTEP 介绍了 Linux 使用的三种调度器,但是随着时间的推移,情况发生了一些变化
| 调度器 | 时间 | 结构 | 状态 |
|---|---|---|---|
| O(n) | Linux 2.4 | 单队列扫描 | 已废弃 |
| O(1) | Linux 2.6早期 | 多队列 | 已废弃 |
| CFS | 2007-2023 | per-CPU 多队列 + RB tree | 曾为主流 |
| BFS | 2009 实验 | 单队列 | 未进入主线 |
| EEVDF | Linux 6.6+ | CFS 的改进 | 当前使用 |
O(1) Scheduler
特征:多队列,有优先级,类似于 MLFQ
原本的调度器需要扫描全部进程,因其复杂度 $O(n)$ 被称为 $O(n)$ 调度器
在 O(1) 调度器中,每个核心都有一个 runqueue,维护两个数组
- active: 正在运行等待调度的任务
- expired: 时间片耗尽的任务
          runqueue

              |
     -------------------
     |                 |
 active array     expired array

 priority 0
 priority 1
 priority 2
 ...
 priority 139
每个优先级都对应一个队列
priority 20:
    P1 P2

priority 50:
    P3

priority 100:
    P4 P5
调度器通过位图可以直接找到最高优先级非空队列,然后取任务即可
O(1) 有一个问题:太依赖大量 heuristic(启发式规则)
- 怎么判断交互任务?
- 优先级应该提高多少?
- 时间片应该多长?
这些参数不好调整,所以后来使用 CFS ,哪个任务得到的 CPU 时间短就优先给谁
Completely Fair Scheduler (CFS) 完全公平调度器
特征:多队列,按比例调度,不使用随机性,类似于 Stride Scheduling
核心思想:不再通过固定优先级决定谁运行,而是尽可能让所有进程获得公平的 CPU 时间。
每个任务维护:vruntime (virtual runtime)
- 这个任务已经被调度了多少“公平份额”的 CPU 时间。
vruntime 不一定等于真实的运行时间,这会受到优先级的影响(比如 nice=0 和 nice=-5 ),优先级高的进程增加的 vruntime 会更少
Unix-like 系统中的 nice 值是一个用于调整进程优先级的参数。 它的取值范围通常是 -20(最高优先级)到 +19(最低优先级)。 默认情况下,普通用户创建的进程 nice 值为 0。 nice 值越小,进程的优先级越高。
为了快速选出 vruntime 最小的任务,CFS使用红黑树来管理 runnable 任务,每次选择最左边的任务,插入的时间复杂度是 $O(\log n)$,但是查找的复杂度是 $O(1)$.
多核中的 CFS 中每个 CPU 会维护一个 runqueue,类似 MQMS,各有一个 CFS Tree,通过执行 load balancing 来平衡负载
Brain Fuck Scheduler (BFS)
特征:单队列,按比例调度,优先考虑低延迟和桌面交互体验。BFS 与 Linux 6.6 引入的 EEVDF 不是同一个调度器。
BFS 的名字来源于编程语言 Brainfuck。BFS优先追求低延迟和桌面交互体验,而不是大规模服务器吞吐量。
BFS 所有的 CPU 共享一个全局队列,哪个 CPU 空闲就直接取任务。
BFS 会根据任务的优先级和调度策略选择任务,并不等同于 EEVDF 的 virtual deadline 选择机制。
它的问题和前面说的 SQMS 一样,可扩展性差,CPU 亲和力差
补充内容:现在 Linux 6.6 后的调度器简介
整体结构如下
                 Linux Scheduler

                       |
        --------------------------------
        |              |               |
     Stop class    Deadline class   RT class
                                      |
                              Fair class
                                      |
                                  EEVDF/CFS
不同类型任务会进入不同的调度类(scheduling class)
多个调度策略按优先级排列
最高
 |
 |  Stop scheduler
 |
 |  Deadline scheduler (SCHED_DEADLINE)
 |
 |  Real-time scheduler (SCHED_FIFO/SCHED_RR)
 |
 |  Fair scheduler (普通进程)
 |
最低
| 调度优先级 | 调度类 / 调度器 | 用户可见策略 | 对应程序 | 调度逻辑 | 典型用途 |
|---|---|---|---|---|---|
| 最高 | Stop Scheduler | 内核专用 | stop_machine()、CPU 热插拔任务等 | 暂停其他任务,让某个内核操作独占 CPU | 内核维护、系统级操作 |
| ↑ | Deadline Scheduler | SCHED_DEADLINE | 实时音视频、工业控制程序 | EDF/EEVDF 思想:选择最早 deadline 的任务 | 硬实时、软实时任务 |
| ↑ | Real-Time Scheduler | SCHED_FIFO / SCHED_RR | 音频线程、实时控制线程 | 固定实时优先级,优先运行高优先级任务 | 低延迟实时应用 |
| ↑ | Fair Scheduler(CFS/EEVDF) | SCHED_NORMAL / SCHED_OTHER | 普通应用:浏览器、编辑器、编译器、服务器进程 | 按权重公平分配 CPU,通过 vruntime / virtual deadline 选择任务 | 日常 Linux 工作负载 |
| 最低 | Idle Scheduler | SCHED_IDLE | 后台低优先级任务 | 只有没有其他任务可运行时才执行 | 后台计算 |