Prologue
从“程序如何在有限内存中运行”这个角度看,内存虚拟化是操作系统最关键的抽象之一。它解决的并不是单纯的“把代码搬进 RAM”,而是让每个进程都认为自己拥有一张连续、私有、统一的地址空间,同时给内核以严密的控制权:哪些地址可读、哪些可写、哪些属于代码、哪些属于栈和堆,以及什么时候需要从磁盘把数据换回内存。
OSTEP 中关于内存虚拟化的内容,最重要的几条主线是:
- 地址空间是如何从“裸机物理内存”抽象成“进程独立视角”的
- Base/Bound、Segmentation、Paging 这几种地址转换机制分别如何演化
- 为什么分页和 TLB 组合起来成为现代虚拟内存的核心
- 为什么缺页、swap、page fault 和写时复制是系统设计的关键支柱
这份笔记结合了 OSTEP 的概念模型与 xv6/RISC-V 的实现细节,力图把“硬件如何翻译地址”和“操作系统如何管理页表”两层逻辑串起来。对于学习操作系统来说,内存虚拟化是从“看懂程序”走向“理解系统”最关键的一步。
地址空间
早期系统
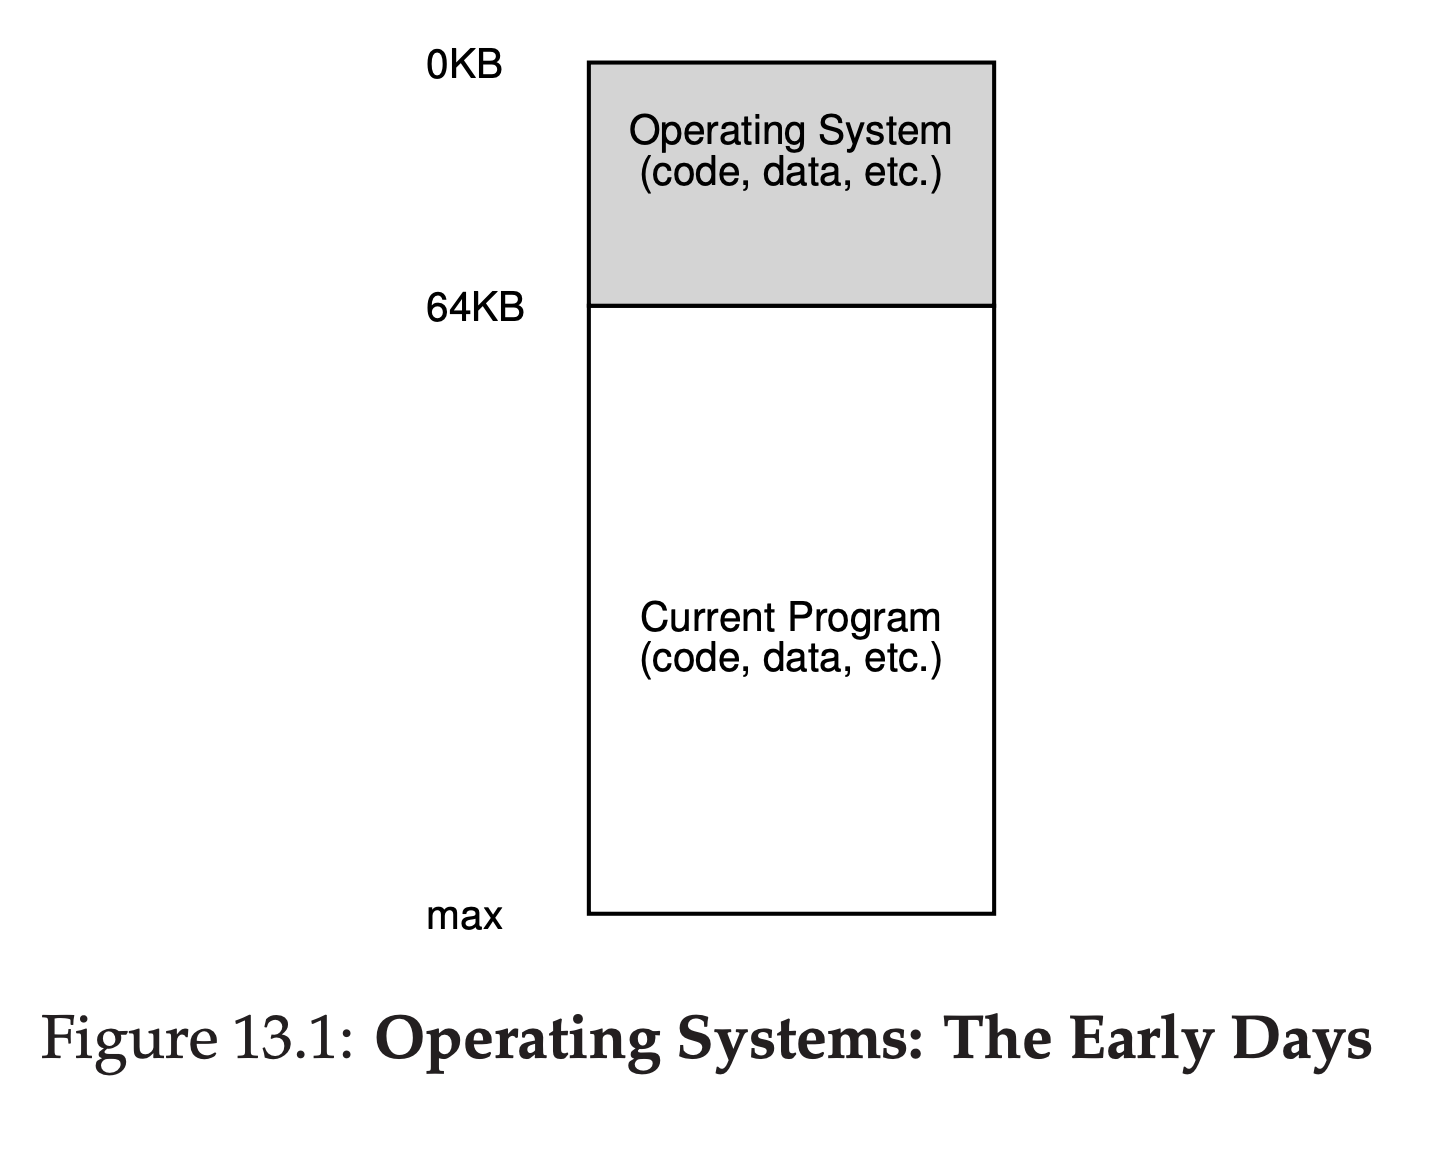
在早期的操作系统中,内存空间的布局非常简单,操作系统的代码和数据放在内存中,剩下的空间放置当前正在运行的程序的代码和数据。
让多个程序运行在操作系统上
为了高效地利用机器,人们希望一台机器能够同时运行多个程序,每个程序都会运行一段时间,然后切换。
一种做法是像 Figure 13.1 一样切换到一个进程,就把相应的数据从硬盘加载到内存中,切换时写回硬盘,加载下一个进程。很显然,这种做法太低效了。
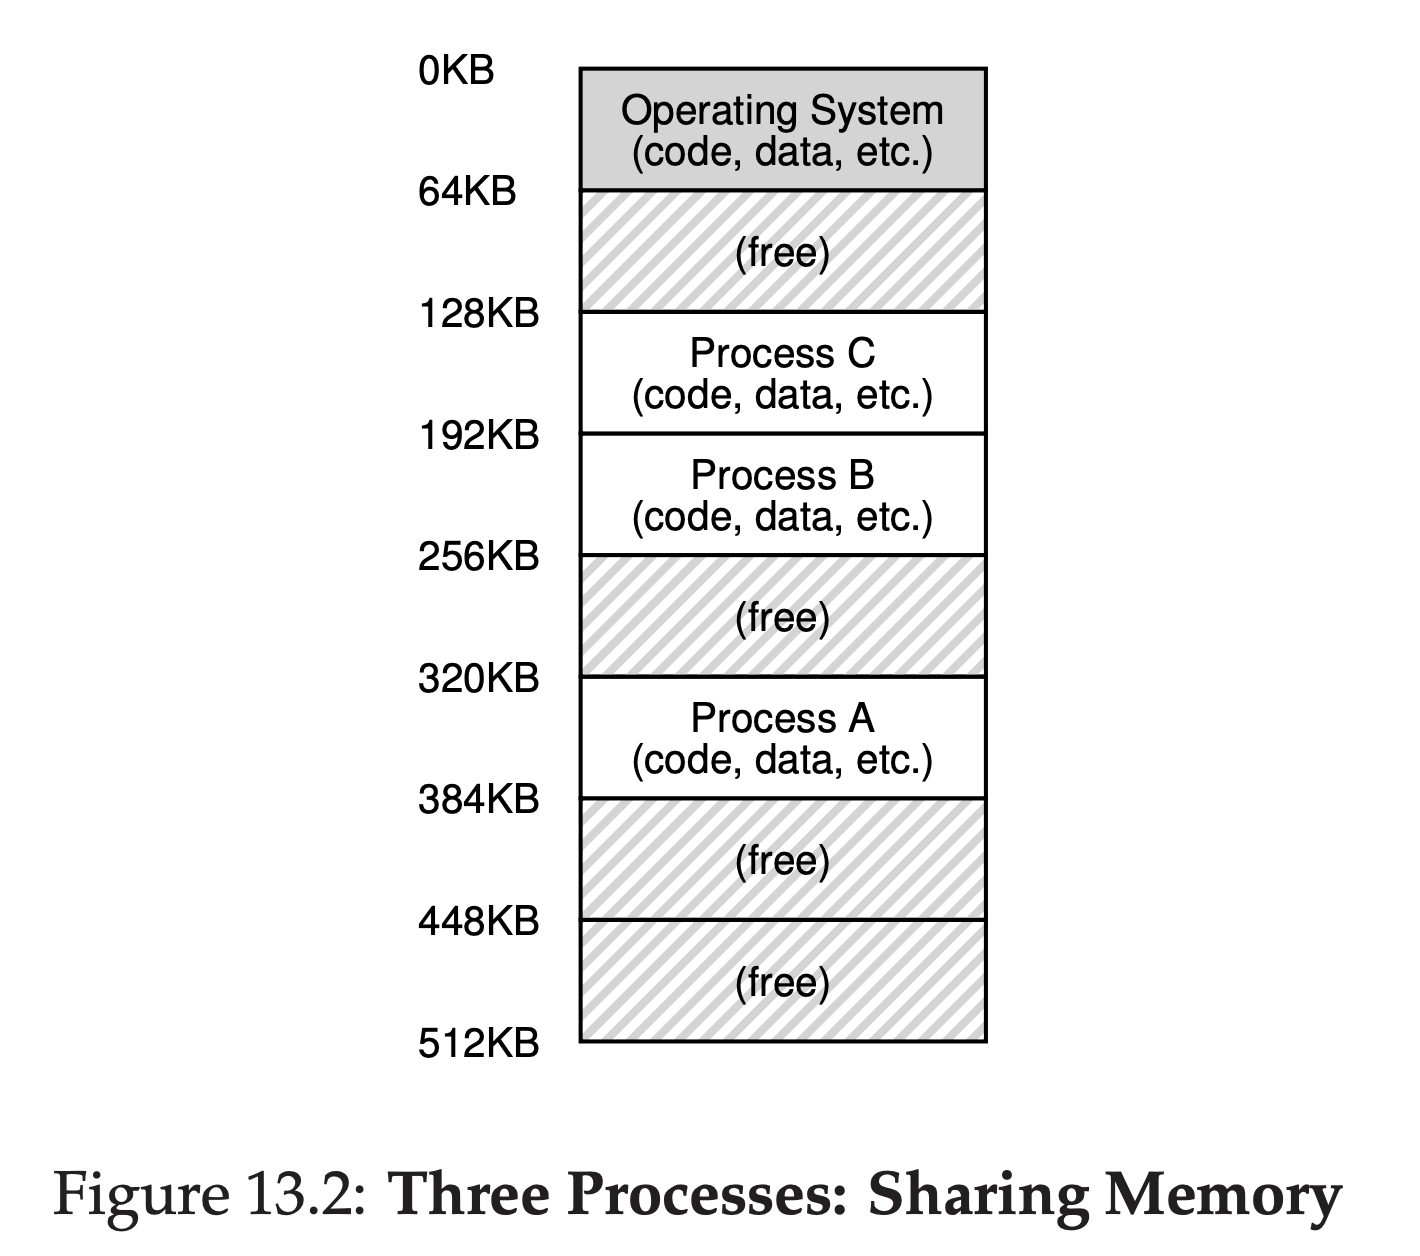
随着内存容量的增大,一种更高效的做法是把多个进程的数据同时放在内存中,这样只需要切换寄存器状态就够了。
地址空间和内存虚拟化
在上面的图片中,不同的进程数据放在内存的不同位置,但是这样带来了一个新的问题,程序员要怎么处理程序的地址?如果每次运行时进程都放在了内存中不同的位置,那么相应的地址显然也要改变。并且上面的方案中,别有用心的用户还能够访问别的进程的空间。
为了易用性和安全性,操作系统提供了地址空间这一抽象,每个用户程序看到的都是一块完整的内存。一个进程的地址空间包含了运行这个程序所需要的全部内存状态,包括 Program Code, Stack 和 Heap.
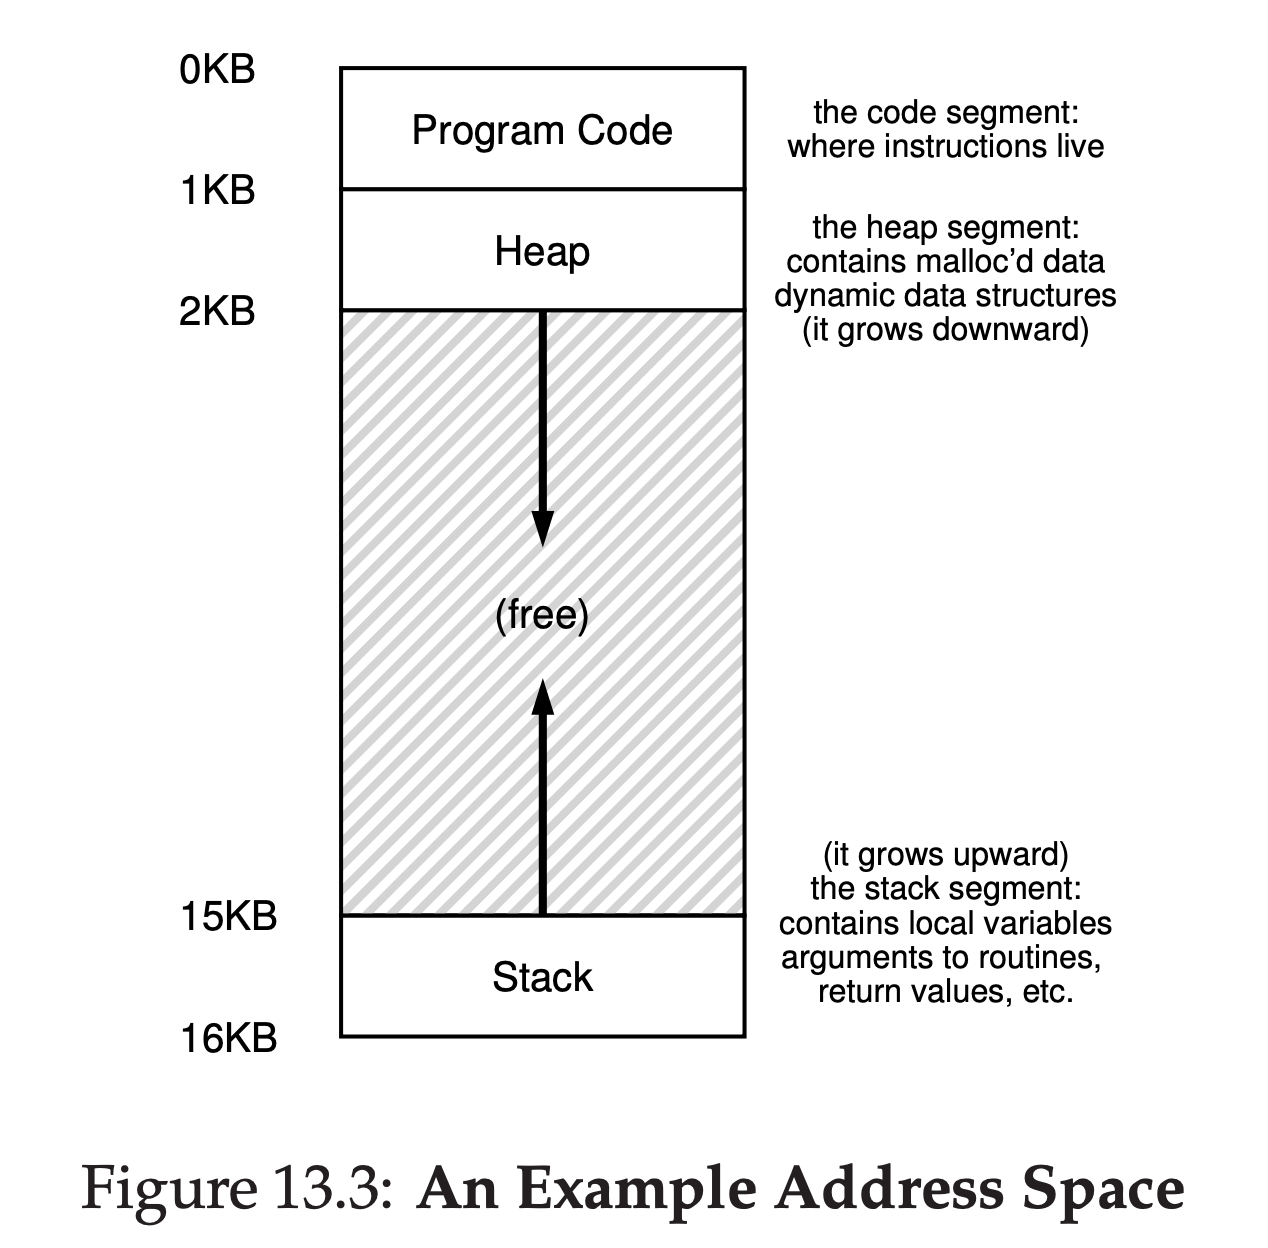
我们希望实现的目的是,每个程序的视角中都仿佛独占了整个内存,也就是实现内存虚拟化,这样不仅方便了程序的编写,而且也限制了进程访问不该访问的内存。在地址空间中,Program Code 存放了执行程序所需要的全部指令;而 Heap 或者说堆内存用于动态分配,存放了用户管理的内存,比如使用 new 关键字创建的对象数据便存放在这里;Stack 或者栈内存则用来跟踪函数调用链的位置,分配局部变量、传递参数和返回值。
在这样的情况下,一个程序便不需要关心其在物理内存上的位置是什么样的。
不过很显然的是,实现这一虚拟化需要某种映射或者转换,毕竟物理内存上每个地址都是独特的,不同的进程的地址,或者说虚拟地址,虽然相同,但是却需要映射到不同的物理地址上。
常见的 Memory API
OSTEP 介绍了几个 UNIX 标准下的内存相关的系统调用接口
栈内存和堆内存
在 C 程序中可以分配两种类型的内存,分别称为栈内存(Stack Memory)和堆内存(Heap Memory)
栈内存是由编译器隐式地管理的,比如下面的代码
void func() {
    int c;  // declares an integer on the stack
}
编译器会自动帮你管理栈指针,生成对应的汇编/机器码,这些栈内存对象在离开其作用域,比如函数返回后就会失效。
堆内存则是由程序员显式管理的,除非手动释放或者程序关闭,否则会一直存在。
void func() {
    int *x = (int *) malloc(sizeof(int));
}
在上面的代码中,malloc 请求了一块 int 类型大小的内存,然后返回了一个指针类型,指向这块内存。
malloc() 和 free()
#include <stdlib.h>
...
void *malloc(size_t size);
基本的用法上面已经提过了,如果分配失败会返回空指针
值得注意的一点是 sizeof() 是一个编译期间完成的操作。对于字符串,建议使用 strlen()
int *x = malloc(10 * sizeof(int));
...
free(x);
free() 的使用方法很简单,只需要把对应的指针传入即可,之所以不需要输入内存大小是因为内存分配器完成了这一工作,malloc 时额外分配了元数据(metadata)记录了相关信息。因此,不要随便往 free 传指针。
在 Linux 上,你可以通过查看指针地址的前几位来看到这一元数据,不过在 macOS 上不行,因为分配方式不同。
ubuntu@VM-0-6-ubuntu:~/workspace/c_test$ ./malloc_test
p = 0x6369b65e32a0
sizeof(int) = 4
requested size = 20 bytes

User data:
p[0] @ 0x6369b65e32a0 = 1
p[1] @ 0x6369b65e32a4 = 2
p[2] @ 0x6369b65e32a8 = 3
p[3] @ 0x6369b65e32ac = 4
p[4] @ 0x6369b65e32b0 = 5

Memory around p:
0x6369b65e3280 : 0x0000000000000000
0x6369b65e3288 : 0x0000000000000000
0x6369b65e3290 : 0x0000000000000000
0x6369b65e3298 : 0x0000000000000021
0x6369b65e32a0 : 0x0000000200000001
0x6369b65e32a8 : 0x0000000400000003
0x6369b65e32b0 : 0x0000000000000005
这里 0x21 转换成二进制 0010 0001,其中低 3 位是 flag,高位是size,将低三位清零之后得到 0x20 就是实际分配的空间大小,也就是 32 Bytes.
| bit | 十六进制 | 宏 | 实际含义 |
|---|---|---|---|
| bit 0 | 0x1 | PREV_INUSE | 前一个物理相邻 chunk 是否处于 in-use 状态 |
| bit 1 | 0x2 | IS_MMAPPED | 当前 chunk 是否是通过 mmap() 获得的 |
| bit 2 | 0x4 | NON_MAIN_ARENA | 当前 chunk 是否来自 non-main arena |
常见错误
OSTEP 列出了使用堆内存时候的常见错误
- 忘记分配内存
- 没有分配足够内存
- 忘记初始化内存
- 忘记释放内存
- 二次释放内存
- 错误调用
free(),传入的指针必须是malloc返回的指针
地址转换
利用 Base-Bound 来进行转换
前面提到了实现内存虚拟化,为用户程序提供地址空间的幻觉需要进行地址转换。一个最直接的想法是使用 base-bound 寄存器来进行翻译,虚拟地址加上基地址就是实际的物理地址,而 bound 则用来控制访问权限,超过之后不允许访问内存。
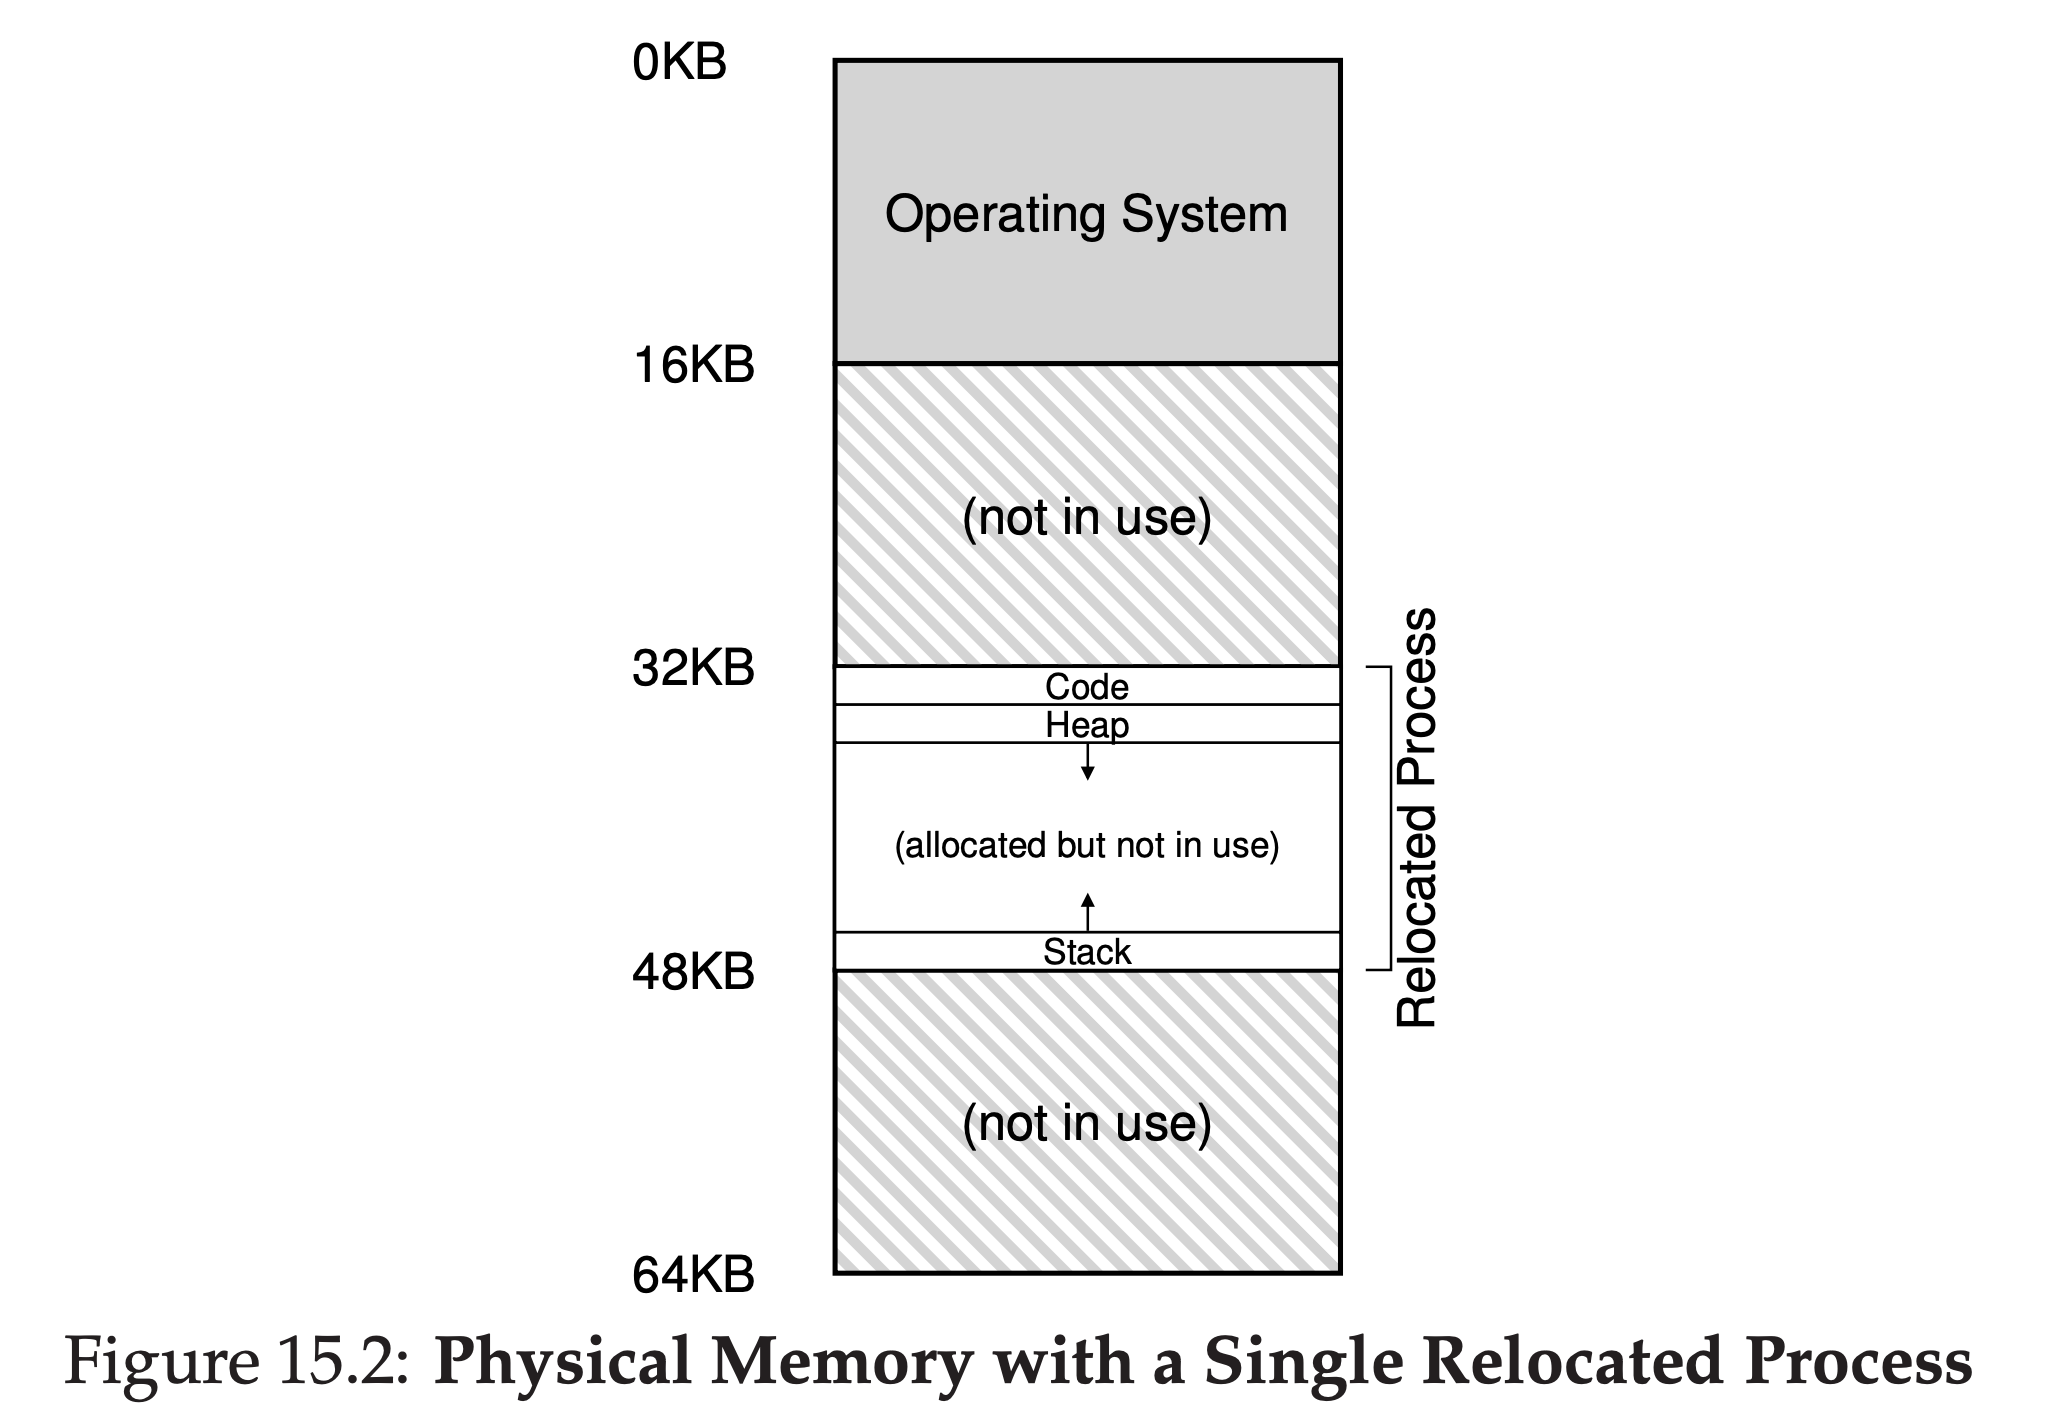
图中的例子中,如果 CPU 要从虚拟地址 1KB 取指令,那么实际访问的物理地址就是 1KB+32KB=33KB,其中基地址是 32KB. 相应的,每个进程都会有自己的 base register 和 bound register 数值,作为进程状态的一部分,和其他寄存器状态一样存放在 Process Control Block 中,用于进程的切换。这样就可以实现不同进程的地址空间的切换,只需要向 Memory Management Unit (MMU) 提供相应的 base 和 bound 就可以让硬件自行翻译地址。
除此之外,OS 还需要管理空闲空间,比如使用 free list 来管理各个空白的区域,然后遍历每个连续的空闲空间来进行进程空间的分配。
这个方案有一个很明显的问题是空间的浪费,注意到 Heap 和 Stack 中间的区域,如果程序没有使用这一片,那么完全就是浪费,这也被称之为 internal fragmentation
Segmentation 机制
为了利用 Heap 和 Stack 中间的区域,产生了一种新的方案,既然每一个地址空间都可以分为 Code, Heap 和 Stack,那么为什么不直接用三对 Base-Bound 寄存器来分别管理呢?这样三块区域就可以随便摆放而互不影响了,这就是 Segmentation.
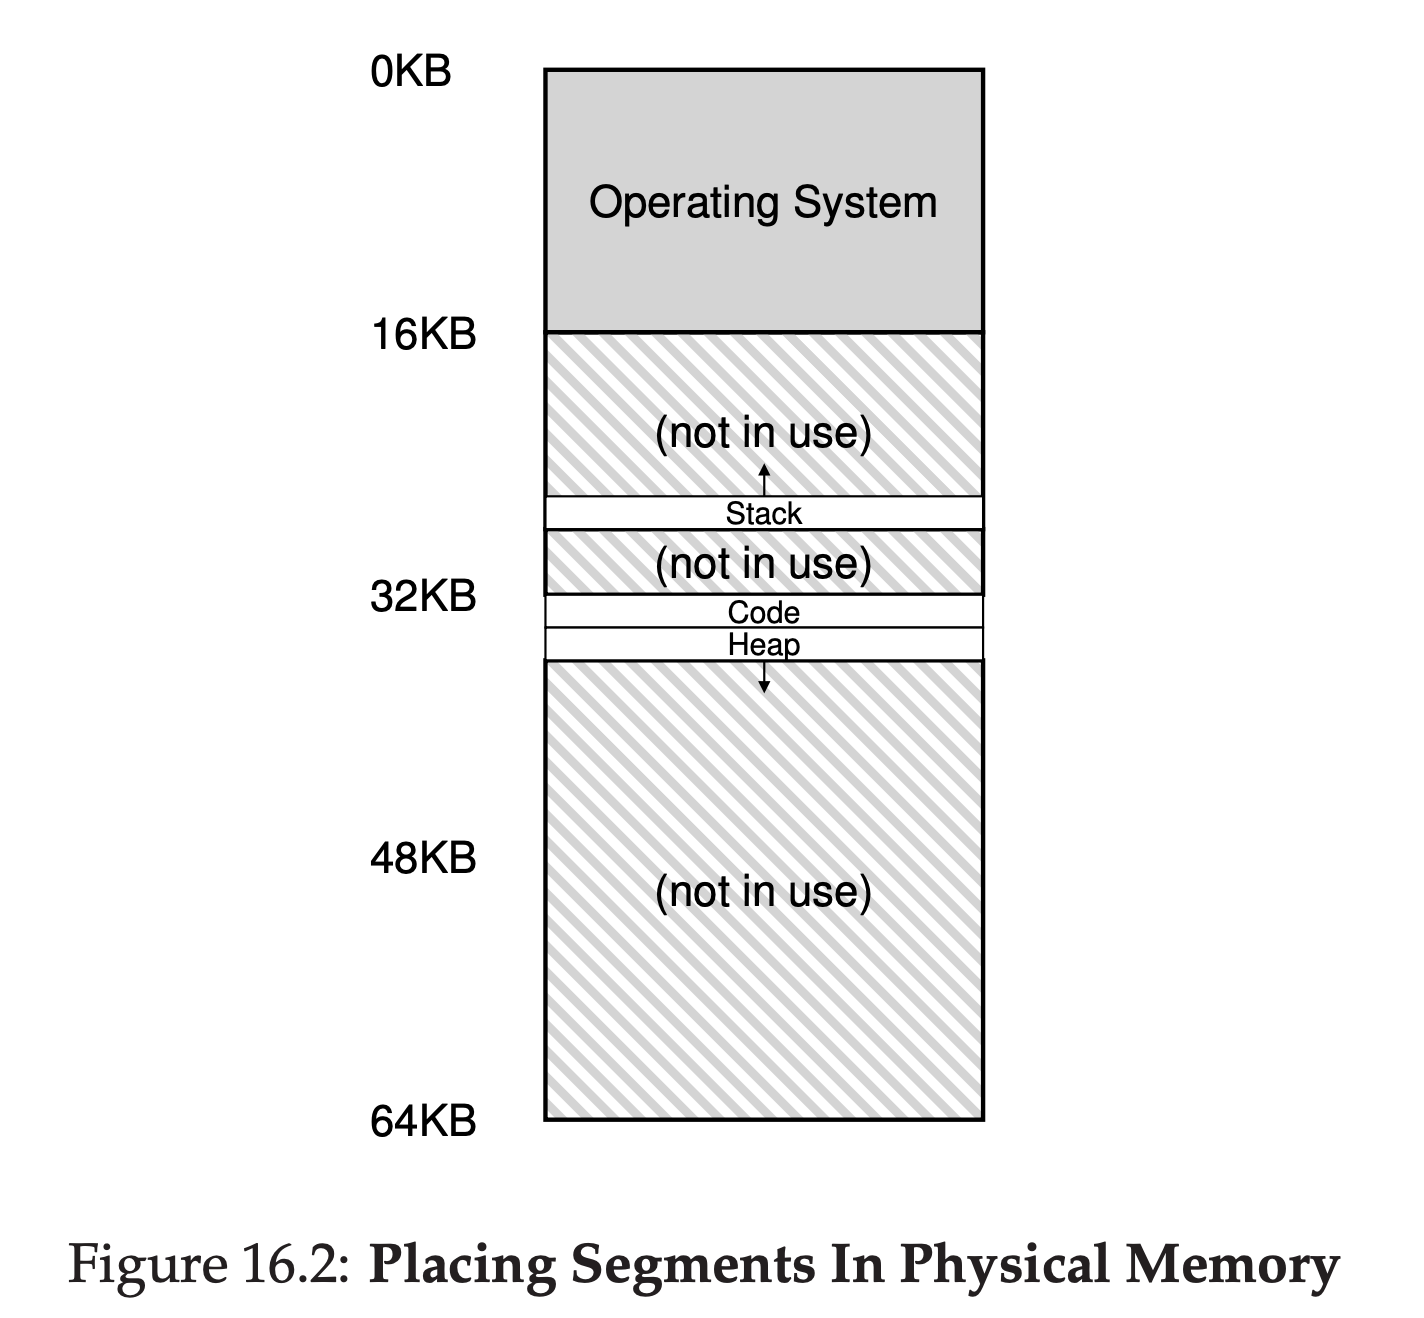
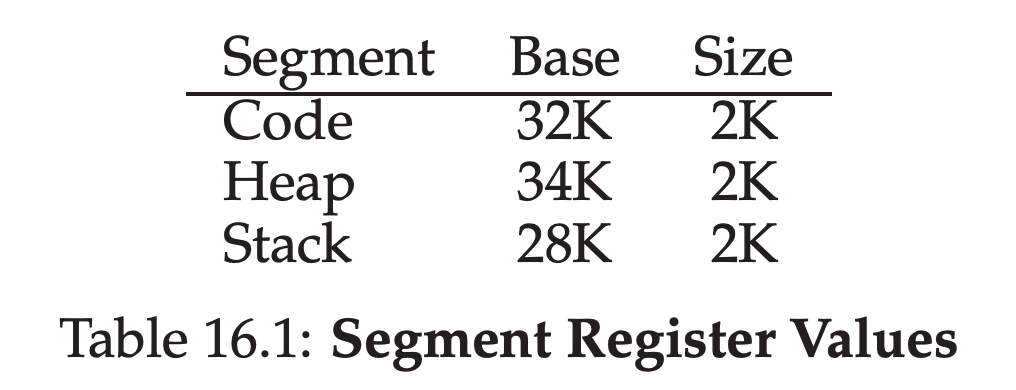
需要注意的一点是,Stack 和 Heap 生长方向不同。
但这样又迎来了一个新的问题,怎么知道某个虚拟地址属于哪个分段?
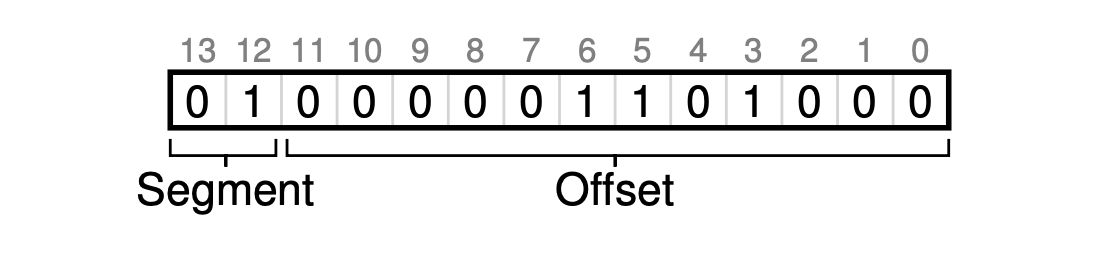
一个常见的做法是用高位来区分不同的分段,图中的虚拟地址是十进制 4200,高位 01 向硬件表明这是 Heap 分段,那么物理地址就是 Base[Heap] + Offset
对于 Code 分段也是同样的计算方法,因为它们的生长方向是一样的,都是往高位增长。但是对于 Stack 分段,计算 PA 的方法有些出入。
假设虚拟地址是十进制 15KB,转换成二进制是 11 1100 0000 0000 其中 11 向硬件表明这是 Stack 分段,offset 是 3KB。由于offset的范围为 0~4KB(4095),所以作用在 Base[Stack] 上的负偏差(negative offset) 应该是 3KB-4KB = -1KB, PA = 28KB+(-1KB)=27KB (注意减去的是4096,不是4095)
根据上面的计算过程,不难发现 Stack 的 Base 永远不会被映射到。
上面的例子将地址空间分成了三个分段,这并不是固定的,一些早期的操作系统可能有更多的分段。除此之外,分段寄存器存储的值也不止上面展示出来的 base 和 size,可能记录了生长方向,读/写/执行权限等,用于不同进程共享分段(比如 code 分段可以被多个进程共享)。当用户程序访问了不该访问的内存区域时,便会触发硬件异常:Segmentation Fault,这个术语一直保留到了现在,尽管现在已经不采用 Segmentation 机制了
Segmentation 的一个问题在于,不同的分段没有固定尺寸,所以整个内存随着进程数量的增加,会变得碎片化,不利于管理,产生很多的浪费,称之为 external fragmentation. 一些解决措施是通过改变分配空间的方式来减少碎片的产生,或者使用压缩技术,重新安排不同进程的位置来压缩内存,但它们都无法完全避免浪费。
空间管理
为了解决 external fragmentation 或者说外部碎片的问题,OSTEP 介绍了几种分配空间的办法。
出于某些原因,比如某些内存的释放,或者分配策略,内存中会出现这样一种现象,两块空白内存中间有一片正在被使用的内存区域,因此内存连续性被破坏了,这意味着虽然内存的总空间足够,但是你可能无法分配一块较大的连续区间。最后的结果是内存充斥了大量非常小的碎片,无法利用。
Splitting 和 Coalescing
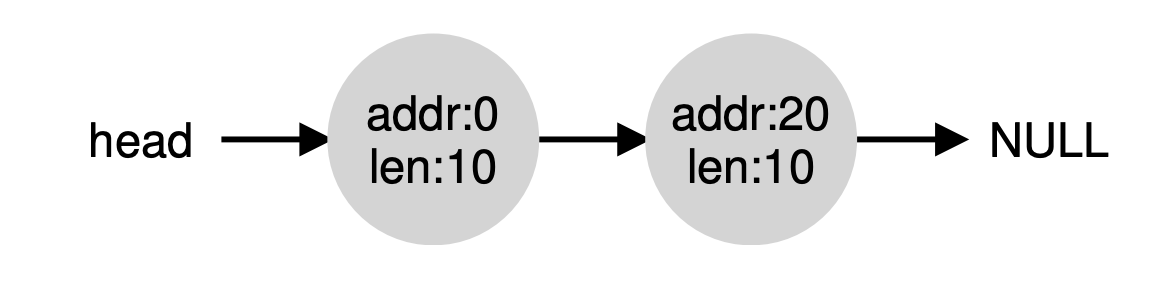
假设采用了链表的数据结构来管理可用空间,如图。现在需要分配一块连续内存,如果要求的大小超过10,那么分配失败;如果刚好是10,那么第二个结点可以直接删去,对应内存的分配;如果小于10,比如假设大小是1,那么其中一个结点必须进行 Splitting,产生一个大小为1的结点和一个大小为9的结点,然后将大小为1的结点删去,最后结果如下。
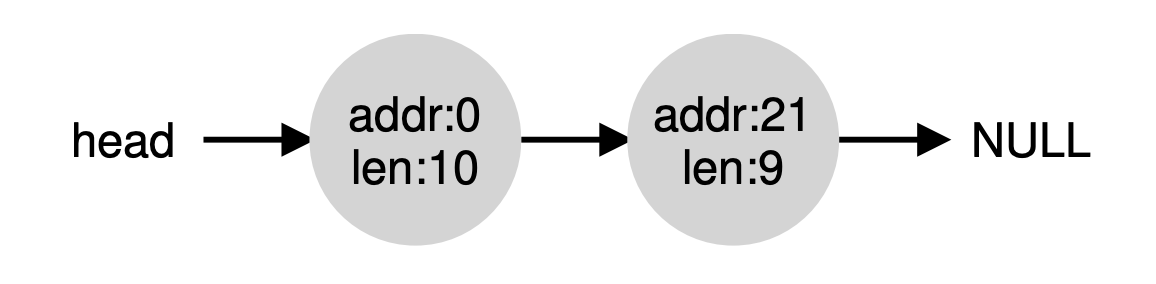
和 Splitting 相对应的一个机制是 Coalescing,当某些内存被释放后,可能出现相邻的可用空间,那么两个结点就可以合并为一个结点。
下图和之前一样,两块长度为10的可用空间中间有一片长度为10的区域被占用。
当中间那块区域被释放后,得到的链表如下:
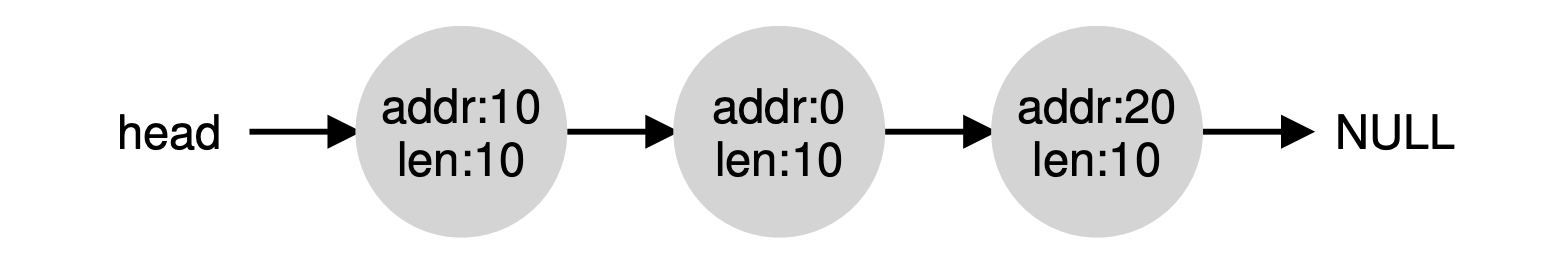
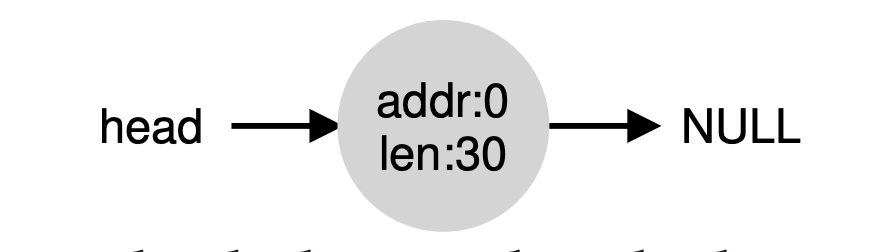
这个时候不难发现,它们可以发生合并,最后变成一大块连续的可用空间。
实际的分配区域和空白区域都会有元数据(metadata),记录了大小,下一个结点的位置等。
一些分配空间的算法
- Best fit
- 从大小满足要求的区块中选择一块最小的区域
- 问题:遍历链表花费时间;容易产生小碎片
- Worst fit
- 从大小满足要求的区块中选择一块最大的区域
- 问题:遍历链表花费时间;对需要分配大块内存的情况不友好(因为大片的连续区域都被切开了)
- First fit
- 找到第一块满足要求的区块后直接返回
- 问题:内存的开头部分会充满小块的碎片/数据,不好管理
- Next fit
- 从上一次返回的结点开始进行查找,直到找到满足要求的区块
- Slab allocator:专门用来高效分配大量“固定大小的小对象”的内核内存分配器。
- 思想:将频繁使用的大小统一管理,其他的请求用一般的方法管理
- slab allocator 之下有多个 cache,每个 cache 用于存放不同类型的对象,比如 inode. 每个 cache 下有很多个 slab,每个 slab 都是一块大小固定的区域,能够存放固定数量的对象。
- Buddy allocation
- 类似于反向的 2048 游戏,一块大小为 $2^N$ 的区域会被不断二分为 $2^{N-1},2^{N-2}\dots$ 区域,直到某块区域刚好可以放下对象。内存释放时,可以很方便地和相邻的区块进行合并。
- 缺点:会产生 internal fragmentation
虽然现在虚拟内存都采用了页表机制,避免了 Segmentation 带来的外部碎片问题,但是上面这些算法在面对用户空间内的空间分配问题时仍有重要作用。
下面是 xv6 的 umalloc.c 中的 malloc() 函数,使用了循环链表 + next fit
// umalloc.c
typedef long Align;

union header
{
    struct
    {
        union header *ptr;
        uint size;
    } s;
    Align x;
};

typedef union header Header;

static Header base;
static Header *freep;
// ....
void *malloc(uint nbytes)
{
    Header *p, *prevp;
    uint nunits;
    // Number of Header-sized unit
    nunits = (nbytes + sizeof(Header) - 1) / sizeof(Header) + 1;
    if ((prevp = freep) == 0)
    {
        base.s.ptr = freep = prevp = &base; // sentinel
        base.s.size = 0;
    }
    // next-fit
    for (p = prevp->s.ptr;; prevp = p, p = p->s.ptr)
    {
        if (p->s.size >= nunits)
        {
            if (p->s.size == nunits)
                prevp->s.ptr = p->s.ptr;
            else
            {
                p->s.size -= nunits;
                p += p->s.size;
                p->s.size = nunits;
            }
            freep = prevp;
            return (void *)(p + 1);
        }
        if (p == freep) // a round finished. failed to find.
            if ((p = morecore(nunits)) == 0)
                return 0; // failed to allocate
    }
}
页表机制介绍
前面提到外部碎片的产生原因是 Segmentation 机制让每一块被分配的空间大小不一,那么解决这个问题的关键就在于把内存划分成为大小一致的块,或者更准确地说,页(page),下图中 128 Bytes 大小的空间被划分成了 8 pages
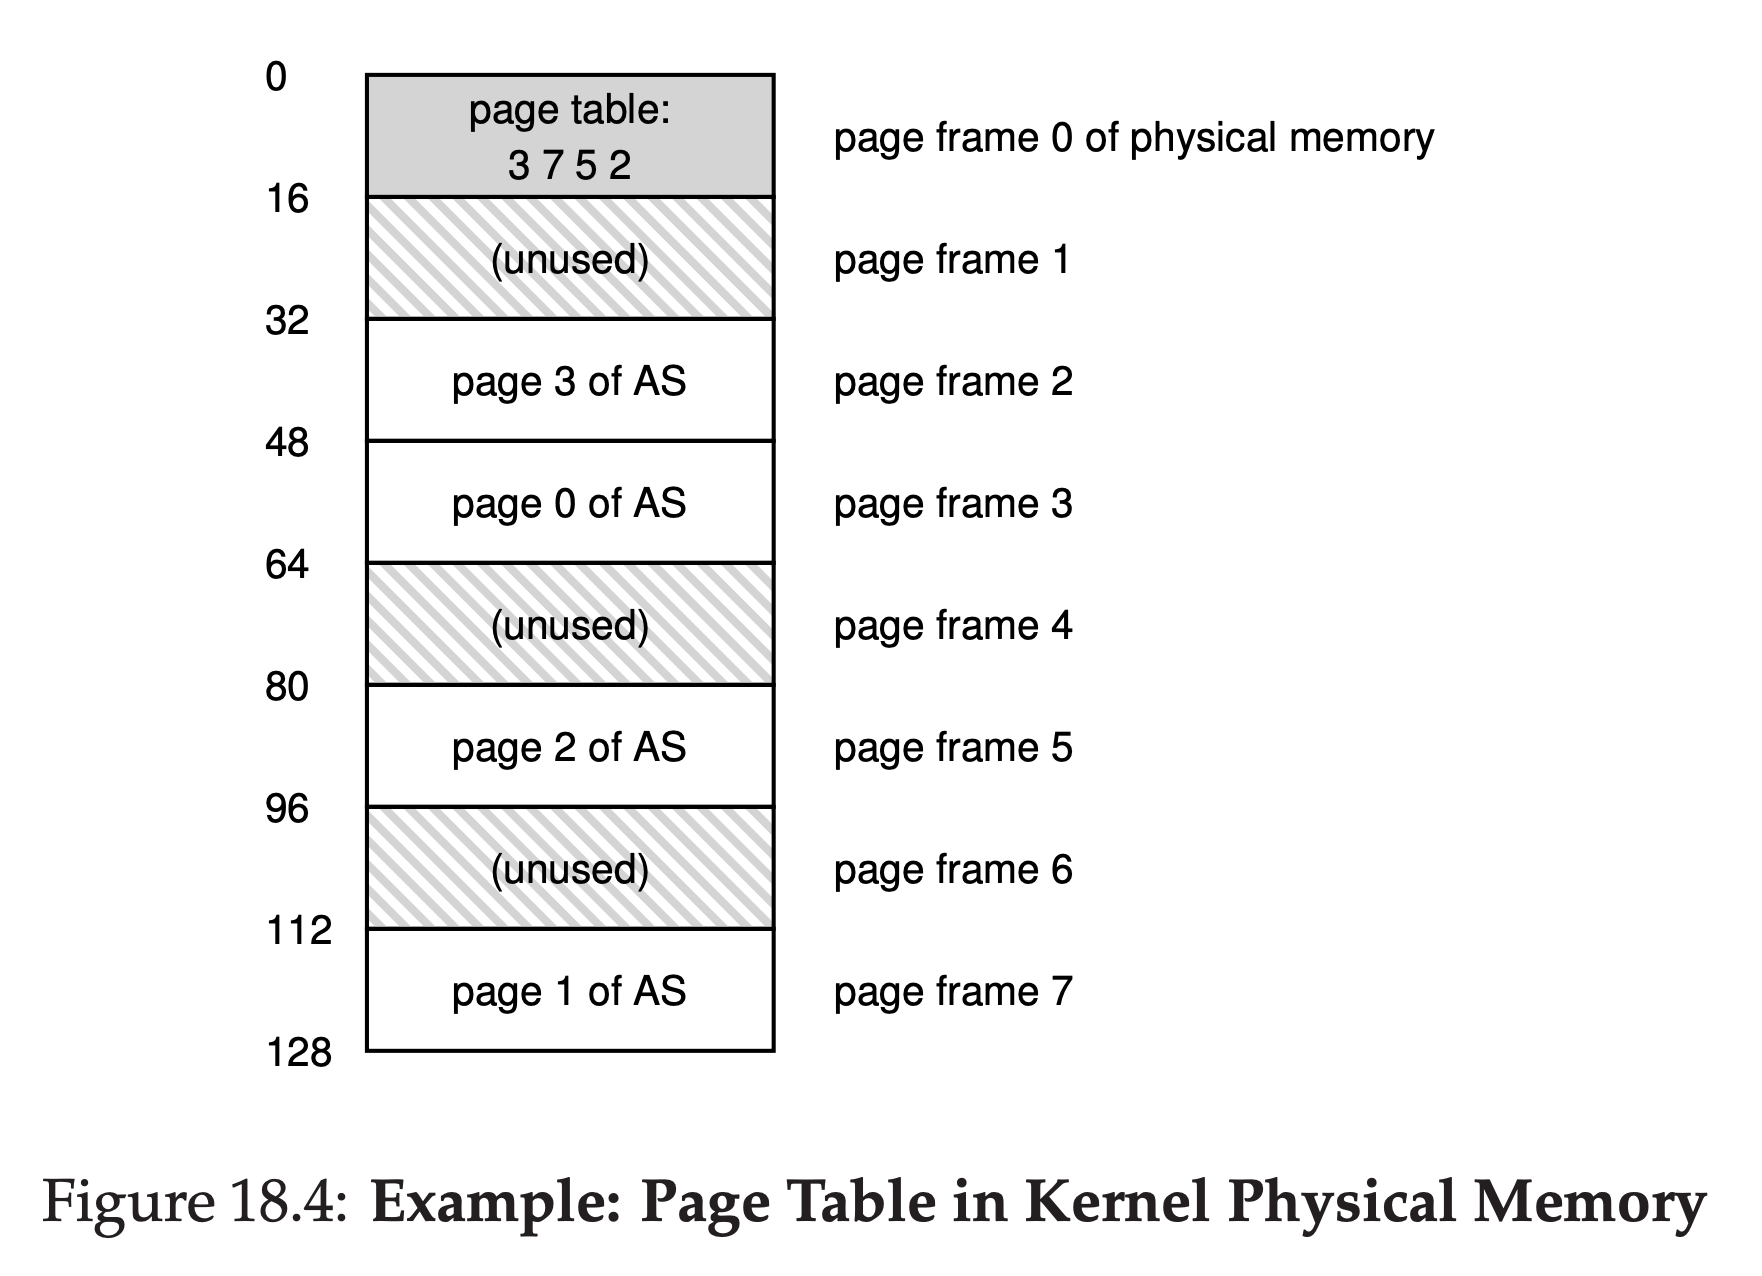
假设每一页的大小是 4096 Bytes,那么物理地址可以分成 PPN (Physical Page Number, OSTEP 或者 Physical Frame Number/PFN) 和 offset,考虑 32 位地址,那么 offset 应该是 12 位,PPN 应该是 20 位.
对于虚拟地址,同样可以分成20位的 VPN (Virtual Page Number)和12位的 offset
那么我们只要知道 VPN 到 PPN 的映射关系,就可以完成地址的转换了。
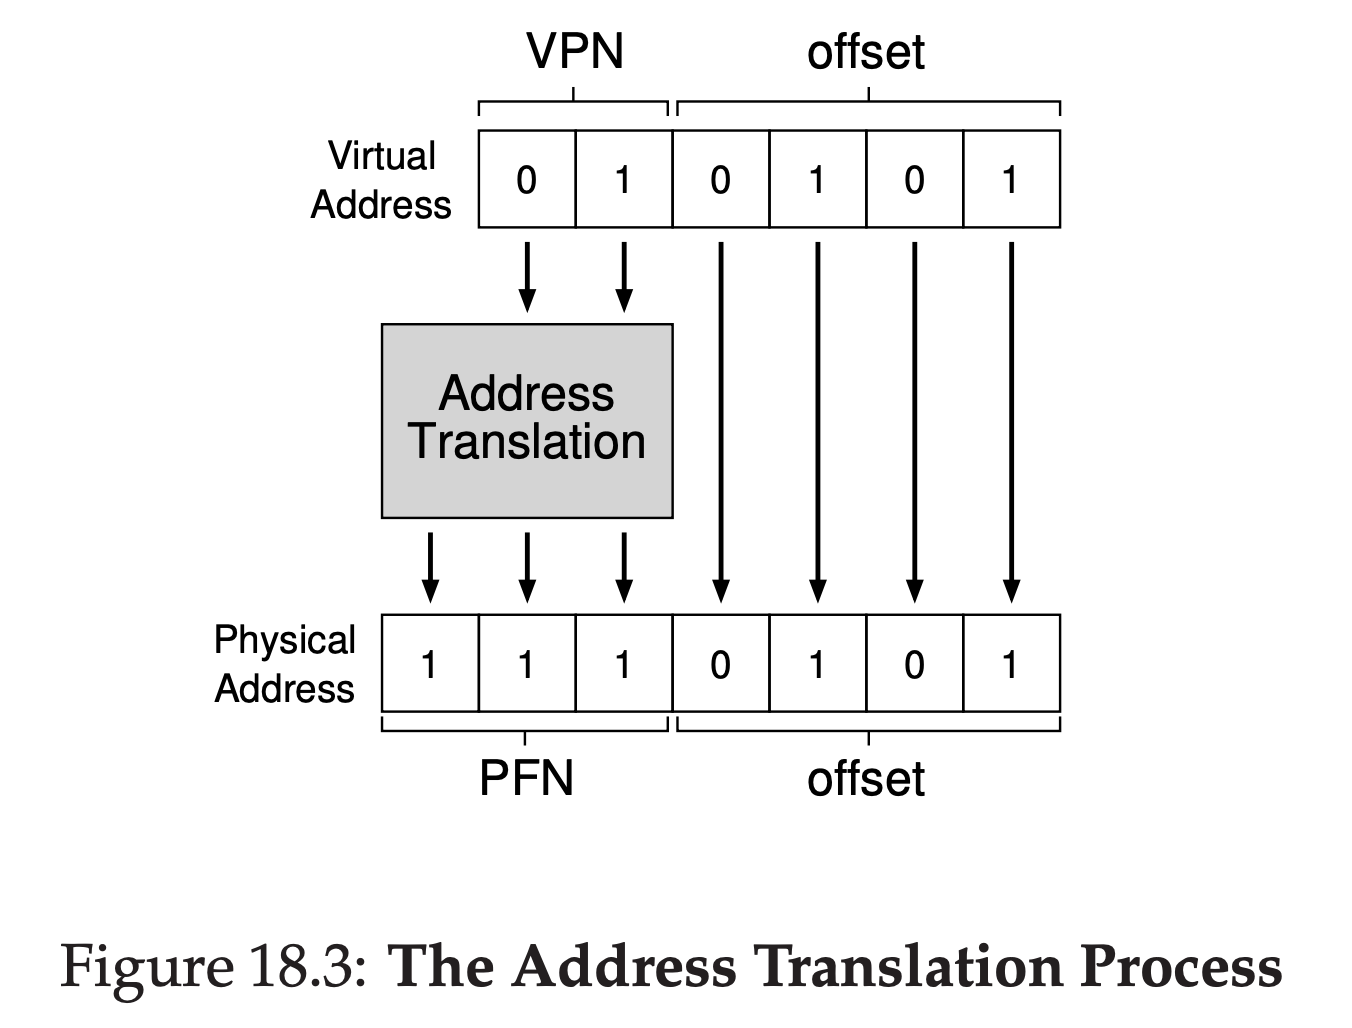
VPN 到 PPN 的映射关系存储在内存中一个名为页表(Page Table) 的数据结构中,页表中有多个条目,称之为 Page Table Entry (PTE),里面存储了转换所需要的 PPN. 那么根据 VPN 和页表的基地址就可以计算出 PTE 的物理地址,然后访存之后就可以得到需要的 PPN 了,此时再把 PPN 和 offset 拼起来就得到了 PA 或者说物理地址(Physical Address)
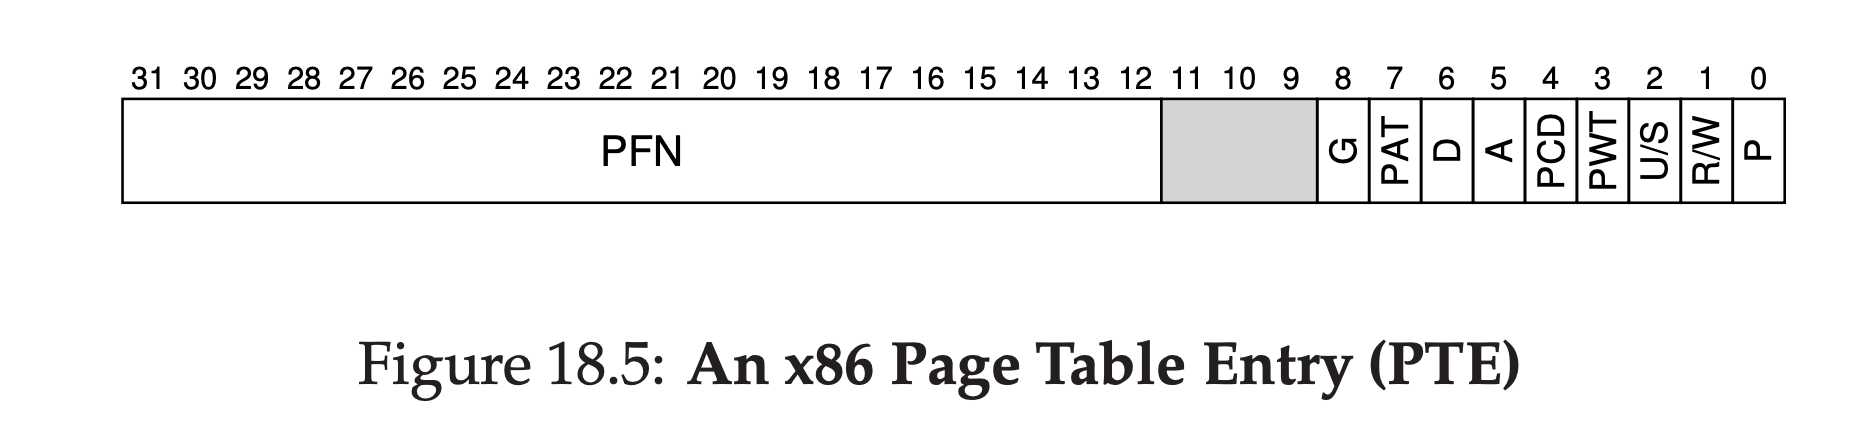
PTE 除了 PPN/PFN 以外还保存了一些状态信息,比如读/写/执行权限等。
目前为止介绍的页表机制存在两个大问题
- 页表太大了
- 考虑20位PPN/VPN,假设每一个 PTE 的大小为 4 Bytes,那么每一个 VPN 对应一个 PTE 意味着20位 VPN 需要 $2^{20}$ 个 PTE,也就需要 4MB 大小的页表,而这只是一个进程的页表,如果有100个进程,那么光是页表就要占用400MB
- 页表查询太慢了
- 因为每进行一次访存都需要使用地址,也就需要进行一次地址翻译,也就得额外进行一次访存运算(访问PTE),而每一次取指令都要进行翻译。
让页表转换地更快:TLB
TLB(Translation Lookaside Buffer)本质上是页表查找的高速缓存。它保存了最近用过的虚拟页号到物理页号的映射,避免每次访问都重新走一遍页表遍历。
其控制逻辑可以概括为:
VPN = (VirtualAddress & VPN_MASK) >> SHIFT
(Success, TlbEntry) = TLB_Lookup(VPN)
if (Success == True) // TLB Hit
    if (CanAccess(TlbEntry.ProtectBits) == True)
        Offset = VirtualAddress & OFFSET_MASK
        PhysAddr = (TlbEntry.PFN << SHIFT) | Offset
        AccessMemory(PhysAddr)
    else
        RaiseException(PROTECTION_FAULT)
else // TLB Miss
    PTEAddr = PTBR + (VPN * sizeof(PTE))
    PTE = AccessMemory(PTEAddr)
    if (PTE.Valid == False)
        RaiseException(SEGMENTATION_FAULT)
    else if (CanAccess(PTE.ProtectBits) == False)
        RaiseException(PROTECTION_FAULT)
    else
        TLB_Insert(VPN, PTE.PFN, PTE.ProtectBits)
    RetryInstruction()
TLB 里通常保存三类信息:
- VPN:虚拟页号
- PFN/PPN:对应的物理页号
- 其他标志位:如 ASID、保护位、访问位等
TLB 既可以采用相联度较高的全相联(fully associative)设计,也可能使用 set-associative 的较低复杂度实现;其核心思想都是让“最近使用的映射”更容易命中。
TLB 在权限不允许访问、页表项无效或页面缺失时都会触发异常,由硬件交给操作系统处理。对于页表寻址基址,实际由硬件/软件约定的页表基寄存器(如 x86 的 CR3、RISC-V 的 satp)提供,并在上下文切换时更新。
在上下文切换时,同样的 VPN 可能会映射到不同的 PPN,因此旧的 TLB 条目就失效了。常见做法有两种:
- flush TLB:清空所有缓存项
- 使用 ASID:给不同地址空间加上标识,TLB 里可以同时保存多个进程的映射
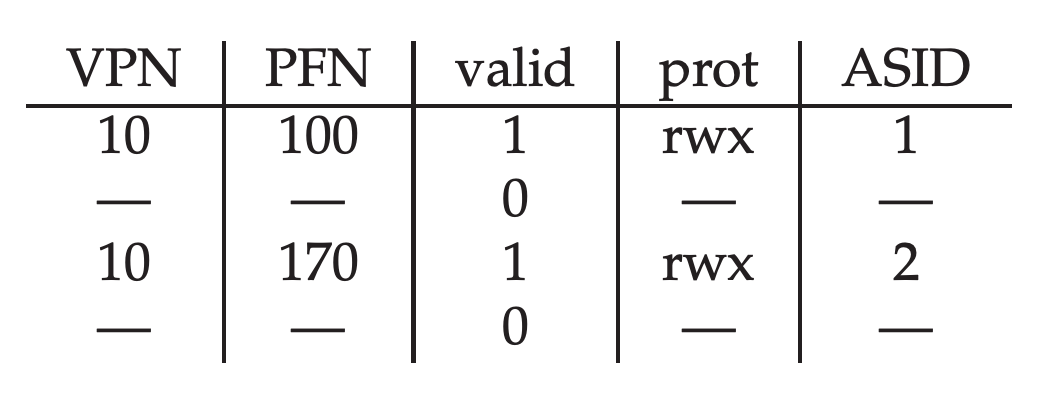
因为 TLB 容量有限,必然会发生替换。常见策略包括:
- LRU(Least Recently Used):替换最近最少使用的项
- Random:随机替换
- FIFO:替换最早进入的项
在实际实现中,性能和硬件成本往往使得近似 LRU 或者 clock-like 策略更常见。
让页表变得更小:多级页表
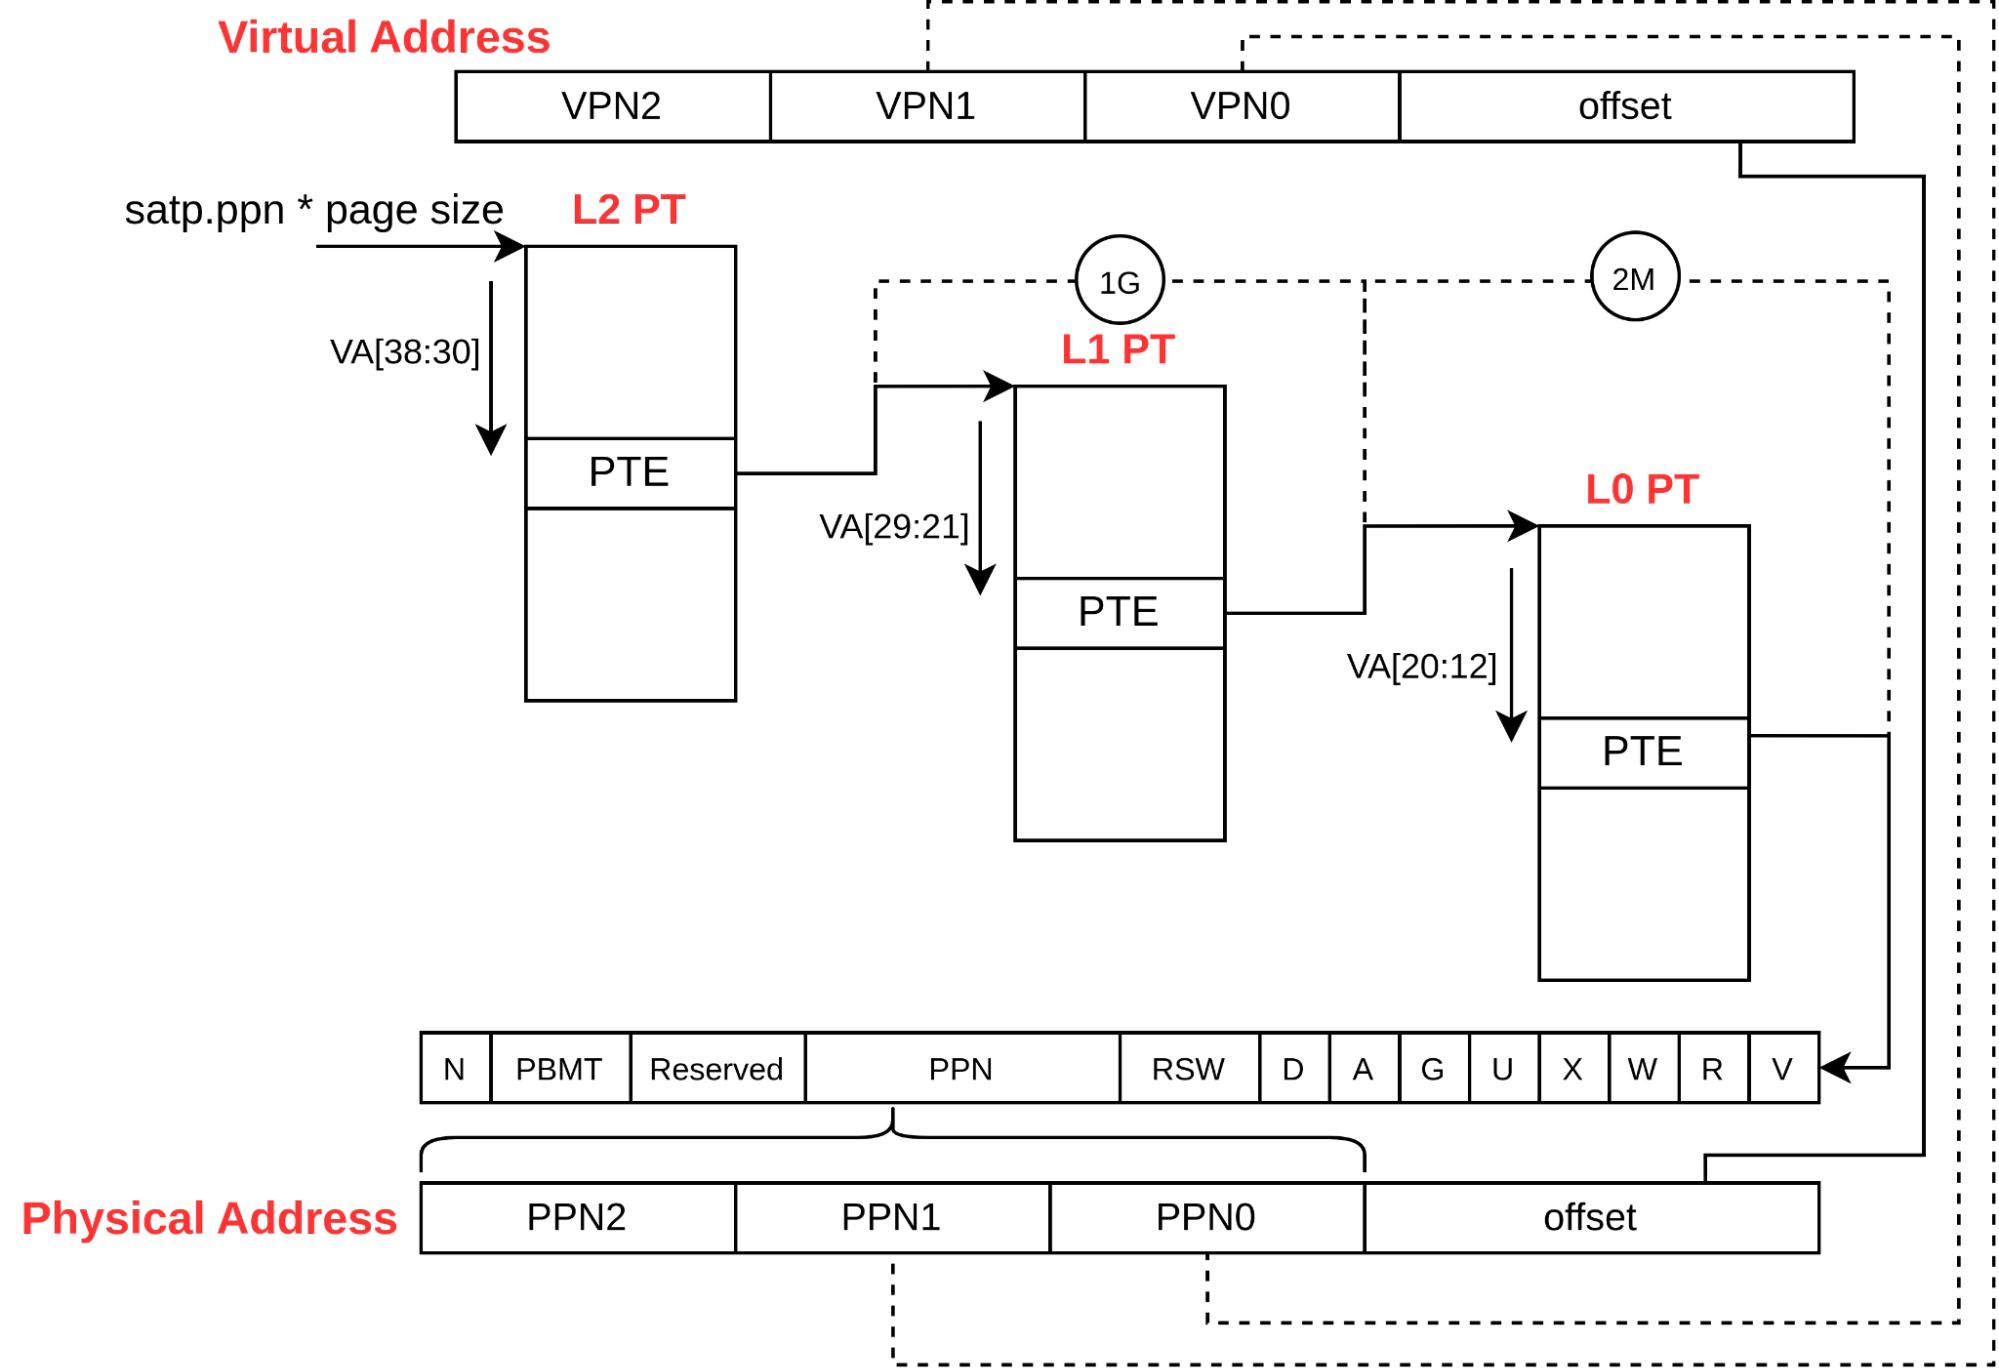
让页表变小的策略是采用多级页表。具体的做法是将原本的 VPN 切割,每一段 VPN 作为偏移量都来计算出下一级 PDE/PTE 的位置,而 PDE/PTE 存放的 PPN 则是下一级页表的基地址的页号或者 PA 的页号。详情可以看附录中 sv39 的地址转换过程
VPN = (VirtualAddress & VPN_MASK) >> SHIFT
(Success, TlbEntry) = TLB_Lookup (VPN)
if (Success == True)
    // TLB Hit
    if (CanAccess(IlbEntry.ProtectBits) == True)
        Offset = VirtualAddress & OFFSET_MASK
        PhysAddr = (TlbEntry.PFN << SHIFT) | Offset
        Register = AccessMemory (PhysAddr)
    else
        RaiseException (PROTECTION_FAULT)
else
    // TLB Miss
    // first, get page directory entry
    PDIndex = (VPN & PD_MASK) >> PD_SHIFT
    PDEAddr = PDBR + (PDIndex * sizeof (PDE))
    PDE = AccessMemory (PDEAddr)
    if (PDE.Valid == False)
        RaiseException (SEGMENTATION_FAULT)
    else
        // PDE is valid: now fetch PTE from page table
        PTIndex = (VPN & PI_MASK) >> PI_SHIFT
        PTEAddr = (PDE.PFN << SHIFT) + (PTIndex * sizeof(PTE))
        PTE = AccessMemory (PTEAddr)
    if (PTE.Valid == False)
        RaiseException (SEGMENTATION_FAULT)
    else if (CanAccess(PTE.ProtectBits) == False)
        RaiseException (PROTECTION_FAULT)
    else
        ILB_Insert (VPN, PTE.PFN, PIE.ProtectBits)
        RetryInstruction ()
在 xv6 中,虽然 CPU 执行指令时,地址翻译的机制通常是由硬件层面的 MMU 完成的,但是内核需要使用用户程序的 VA 时,就需要软件模拟翻译来得到用户程序数据的物理地址,或者内核需要建立新页表/查找页表时同样也需要类似的翻译过程,这一过程由 walk() 完成。
// vm.c
// Return the address of the PTE in page table pagetable
// that corresponds to virtual address va.  If alloc!=0,
// create any required page-table pages.
//
// The risc-v Sv39 scheme has three levels of page-table
// pages. A page-table page contains 512 64-bit PTEs.
// A 64-bit virtual address is split into five fields:
//   39..63 -- must be zero.
//   30..38 -- 9 bits of level-2 index.
//   21..29 -- 9 bits of level-1 index.
//   12..20 -- 9 bits of level-0 index.
//    0..11 -- 12 bits of byte offset within the page.
#define PX(level, va)  ((((uint64)(va)) >> PXSHIFT(level)) & PXMASK)    // riscv.h

pte_t *walk(pagetable_t pagetable, uint64 va, int alloc) {
    if (va >= MAXVA)
        panic("walk");

    for (int level = 2; level > 0; level--) {
        pte_t *pte = &pagetable[PX(level, va)]; // 获取对应 VPN 分段
        if (*pte & PTE_V) {
            pagetable = (pagetable_t)PTE2PA(*pte);  // 正常情况下直接从 PTE 获取下一级页表 PA
        } else {
            if (!alloc || (pagetable = (pde_t *)kalloc()) == 0) // alloc==0时直接return 0表示没有找到
                return 0;
            memset(pagetable, 0, PGSIZE);   // alloc != 0并且kalloc成功,在此基础上继续填满垃圾数据
            *pte = PA2PTE(pagetable) | PTE_V;   // 修改当前级别 pte 指向新分配的 pagetable(下一级别的pagetable)
        }
    }
    return &pagetable[PX(0, va)];   // 最后返回 level 0 的pte的地址
}
在 xv6 初始化过程中,内核会调用 kvminit() 来创建并初始化内核页表(包括硬件地址映射、kernel text executable、kernel data 和 physical RAM 直接映射、TRAMPOLINE映射、内核栈地址映射等),然后使用 kvminithart() ,将页表地址写入 satp 寄存器。
让页不止于内存:缺页和页表管理
为了让机器支持的地址空间能够大于内存大小,让用户程序完全不用关心内存够不够,那么注定有一些页不会一直放在内存中,而会被操作系统暂时放到硬盘中。
Swap Space
由于内存大小的有限,当内存可用空间不足时,一些暂时不需要的页可能会被操作系统驱逐出内存,暂存到硬盘中。
为了收留这些从内存中被“驱逐”(evict)出来的页数据,硬盘中预留了一部分区域,用来存放这些页的数据,称为 Swap Space. 操作系统需要提前知道硬盘这块区域的地址,以便于页的管理。
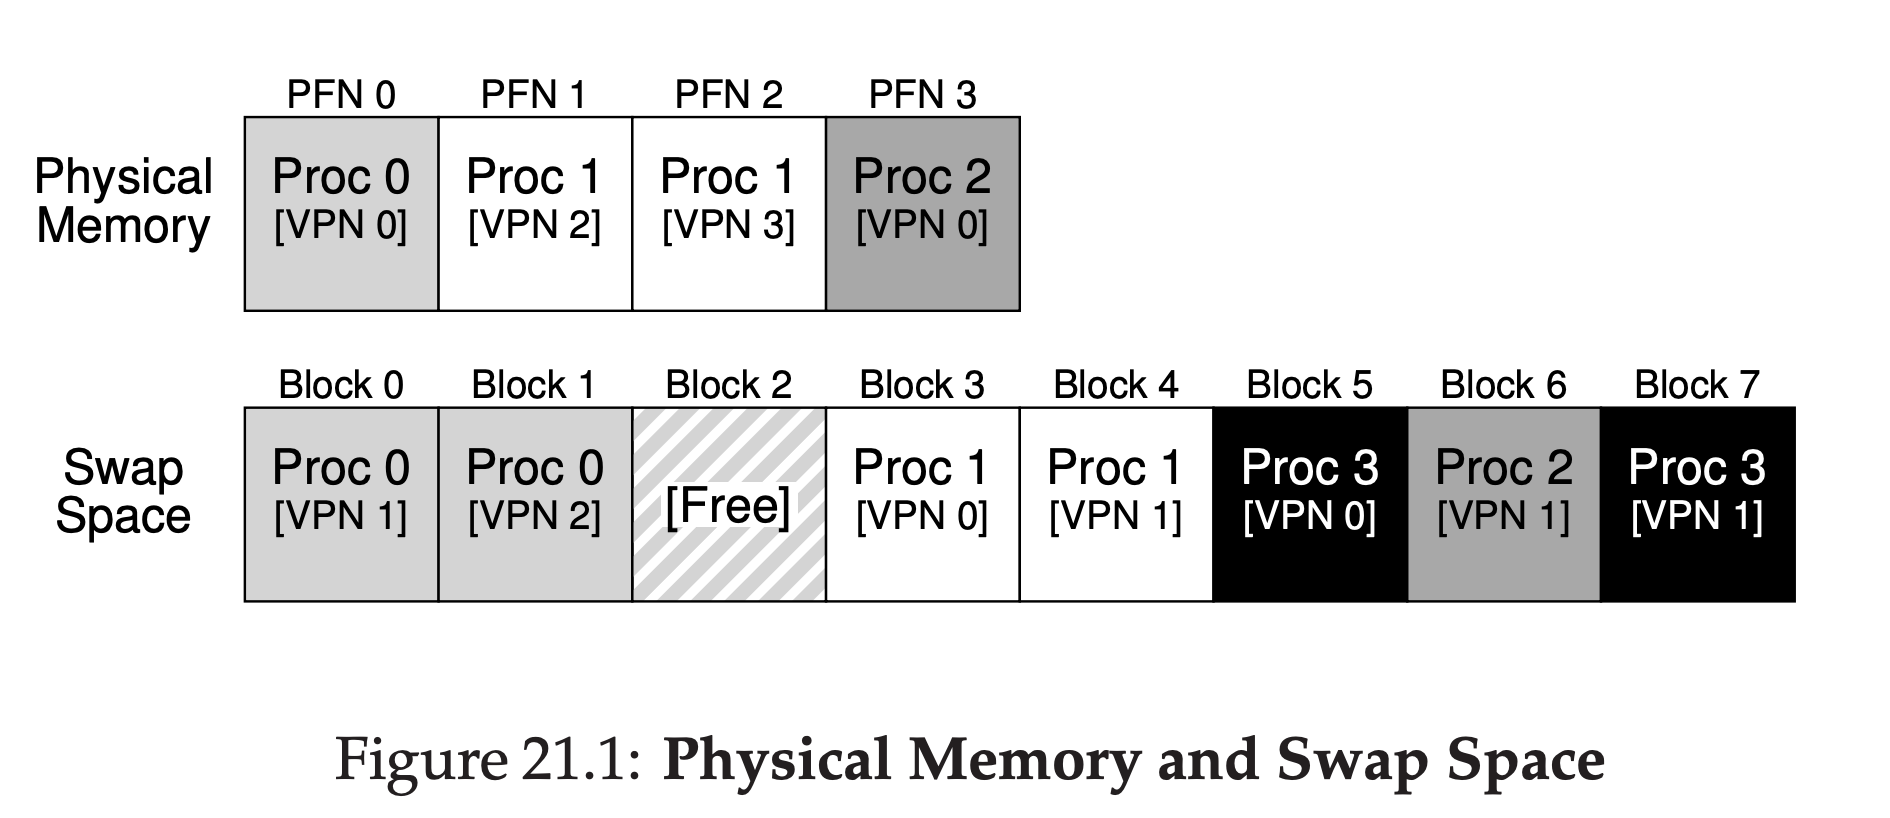
Present Bit
当一个页被换出内存,或者根本还没有被分配/映射时,页表中对应的 PTE 不能简单地看成“有效映射”。如果 TLB 中仍保留旧条目,硬件可能会误以为该地址仍然有效,从而跳过页表检查,造成错误访问。
因此需要在 PTE 中加入一个 Present Bit,用于标记该页是否在内存中,当某一页被驱逐出内存时,页表中的 Present Bit 就会设置成0,同时 TLB 里面如果有这一页的 Entry,它的 Valid 也会设置成0. 于是 TLB 进行相应地址转换时会 TLB miss,随后查页表时发现 Present bit 为0,那么就会触发 page fault 异常,交给操作系统进行处理,操作系统随后可能会将硬盘中的页放回内存中,并更新 PTE,TLB 重新查询页表。
值得一提的是,OS 中的 demand paging 与这一机制高度一致:用户程序的某一页往往并不会在一开始就被全部加载进内存,而是在第一次访问时由 page fault 触发“按需分配/读入”。
虽然 xv6 本身没有完整实现 swap 机制,但其 lazy allocation 的处理方式与 demand paging 的思想非常接近。下面的代码展示了 vmfault() 在第一次访问一个未映射地址时,如何为其分配一页物理内存并建立映射:
// trap.c
uint64 usertrap(void)
{
    // ...
    if (r_scause() == 8)
    {
        // system call
        if (killed(p))
            kexit(-1);
        p->trapframe->epc += 4;
        intr_on();
        syscall();
    }
    else if ((which_dev = devintr()) != 0)
    {
        // ok
    }
    else if ((r_scause() == 15 || r_scause() == 13) &&
             vmfault(p->pagetable, p->sz, r_stval(),
                     (r_scause() == 13) ? 1 : 0) != 0)
    {
        // page fault on lazily-allocated page
    }
    else
    {
        printk("usertrap(): unexpected scause 0x%lx pid=%d\n", r_scause(), p->pid);
        printk("            sepc=0x%lx stval=0x%lx\n", r_sepc(), r_stval());
        setkilled(p);
    }
    // ...
}
// vm.c
uint64 vmfault(pagetable_t pagetable, uint64 psz, uint64 va, int read)
{
    uint64 mem;
    if (va >= psz)
        return 0;                   // va 无效
    va = PGROUNDDOWN(va);           // 掩码,清除 offset 位
    if (ismapped(pagetable, va))
    {
        return 0;           // 页表中已经有这个地址了
    }
    mem = (uint64)kalloc(); // 分配 4KB page
    if (mem == 0)
        return 0;           // 分配失败
    memset((void *)mem, 0, PGSIZE); // 页内容初始化为0
    if (mappages(pagetable, va, PGSIZE, mem, PTE_W | PTE_U | PTE_R) != 0)   // 创建 PTE
    {
        kfree((void *)mem); // 创建失败
        return 0;
    }
    return mem;     // 返回新表的起始地址
}
什么时候应该发生页的替换?
为了灵活性和性能,操作系统不能等到内存完全耗尽才开始换出页面。通常会设置两个水位线:
- Low Watermark(LW):低水位线
- High Watermark(HW):高水位线
当可用页数低于 LW 时,后台线程(swap daemon / page daemon)会开始回收页面;直到可用页数达到 HW 后才停止。这种做法能避免“过早触发大量 I/O”或“频繁在临界点上下抖动”。
怎么选择替换出去的页
由于内存中存放的页可以看作是系统中所有页的子集,所以内存可以看作是虚拟内存系统的缓存(Cache),缓存命中意味着不需要访问硬盘I/O,从而节省时间。这里的目标便是尽量提高缓存命中率。
OSTEP 介绍了几种 policy
- optimal policy:
- 驱逐未来最晚会被访问的 page
- 现实中不可能实现,一般作为最优情况的参考
- FIFO
- 驱逐最早进来的 page
- 循环遍历时可能命中率极低(想象cache size刚好小于array size的情况,这种情况称之为 scan resistane)
- random
- 随机驱逐,能够避免临界情况(比如上面的循环遍历)
- Least-Recently-Used/Least-Frequently-Used(LRU/LFU)
- 驱逐最早使用的/最近使用次数最少的
- 遍历使用次数这类的状态信息开销很大,并且面对循环遍历依旧表现不佳。
- MRU/MFU
- 和 LRU/LFU 相反,因为不考虑 locality ,表现通常不好
- clock algorithm
- 一种近似 LRU 算法,假设所有的 pages 以循环链表的数据结构组织
- 每页都有一个 use bit,被使用的时候就会设置为 1
- 存在一个 clock hand 指针,指向链表中某个 page
- 需要发生替换时,检查当前指向的 page 的 use bit,如果是 1 ,那么设置为0,并且指针往后移动,继续检查,直到找到 use bit 为0的页进行替换。(最坏情况可能遍历整个链表)
不同算法的表现如图
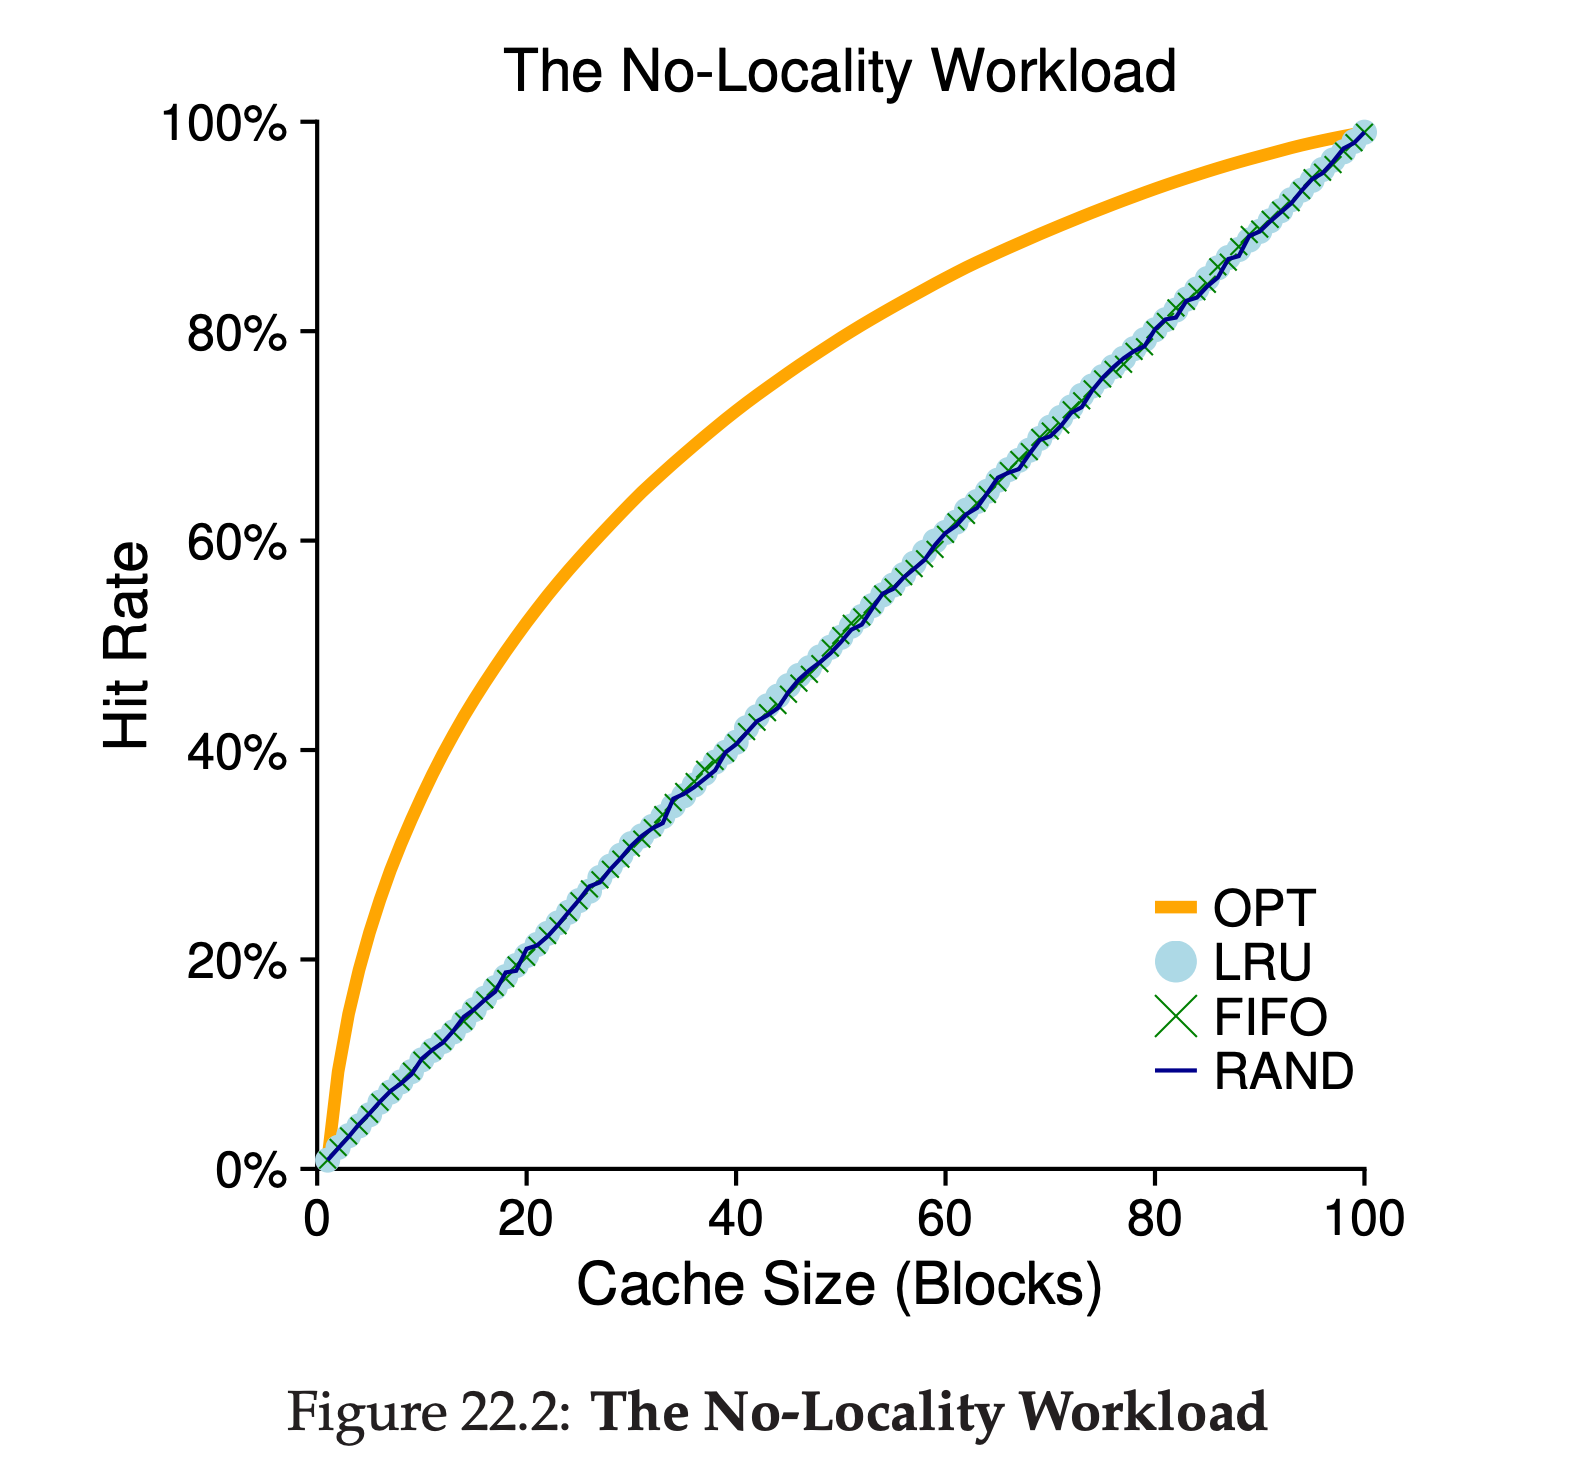
对于随机访问的情况,除了 Optimal Policy 以外,其他算法的表现没有什么区别。
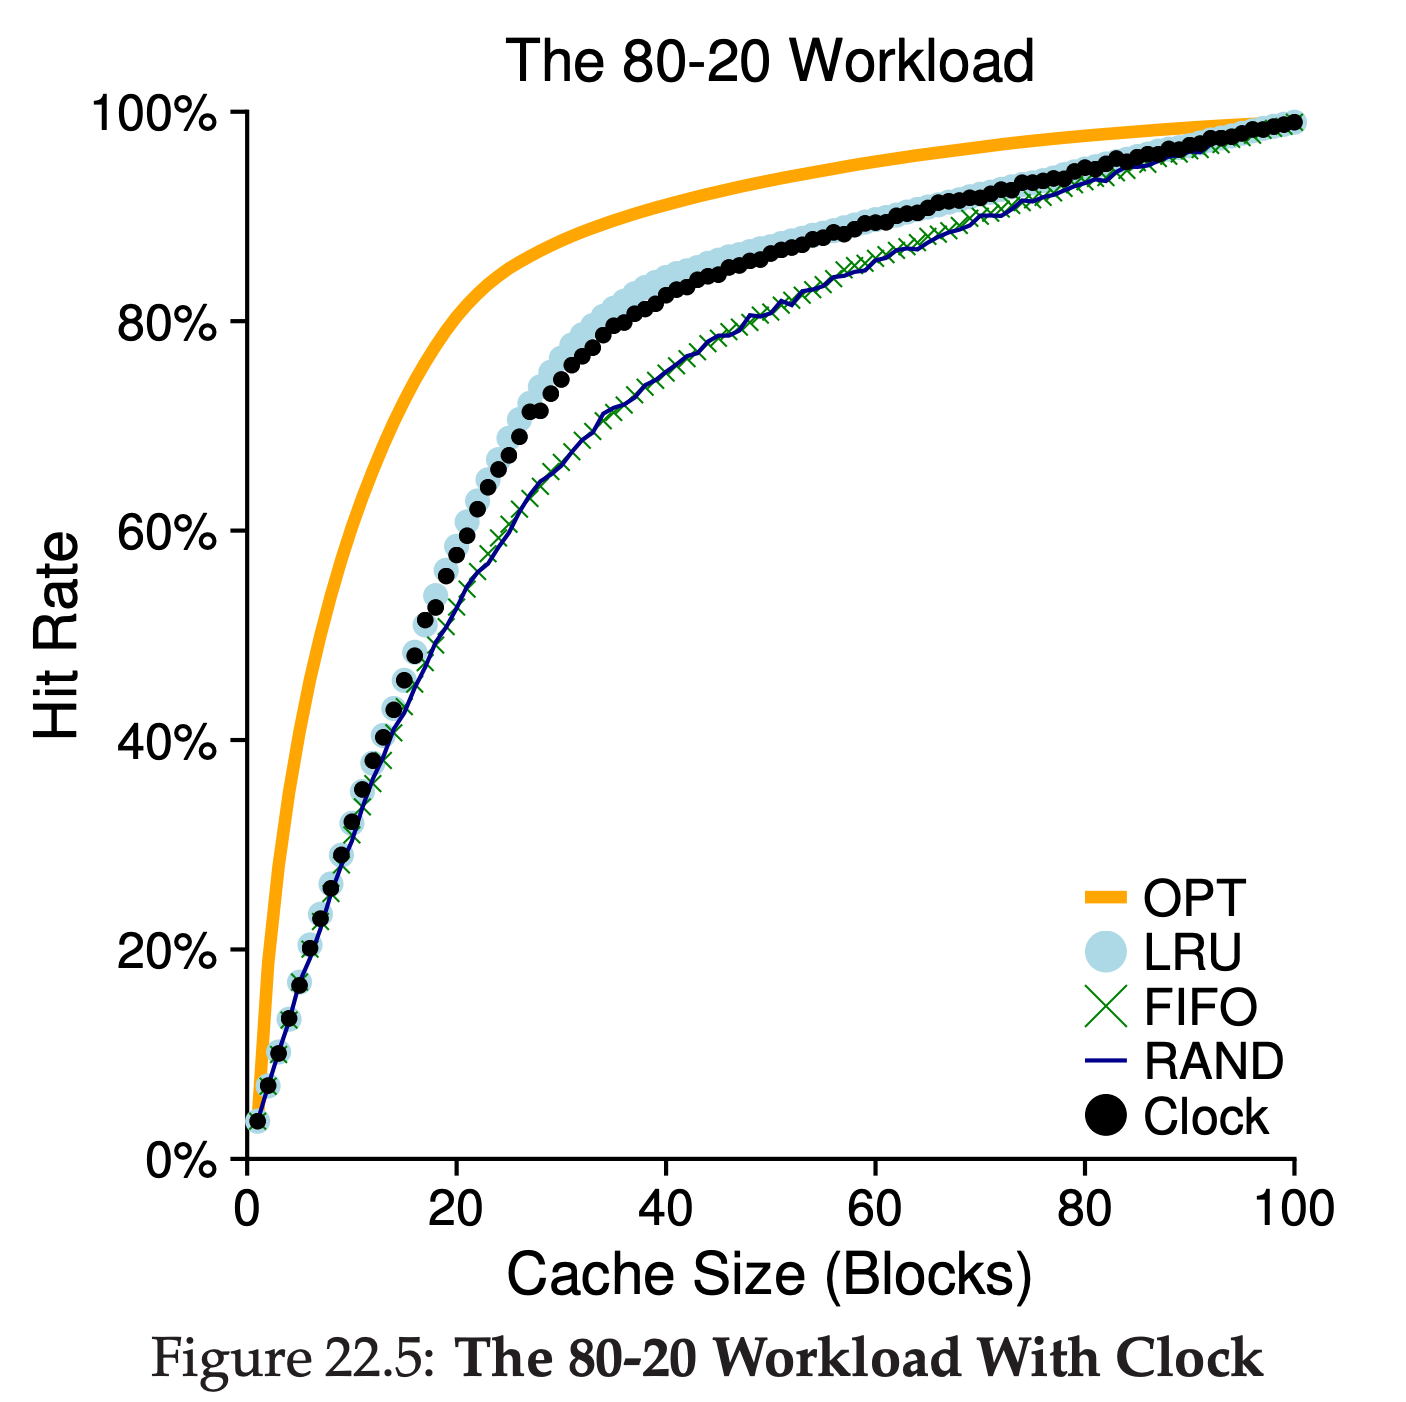
对于存在一定 locality 的读写情况(这里是80%的访问指向20%的页),$\rm OPT > LRU > Clock > FIFO \approx RAND$
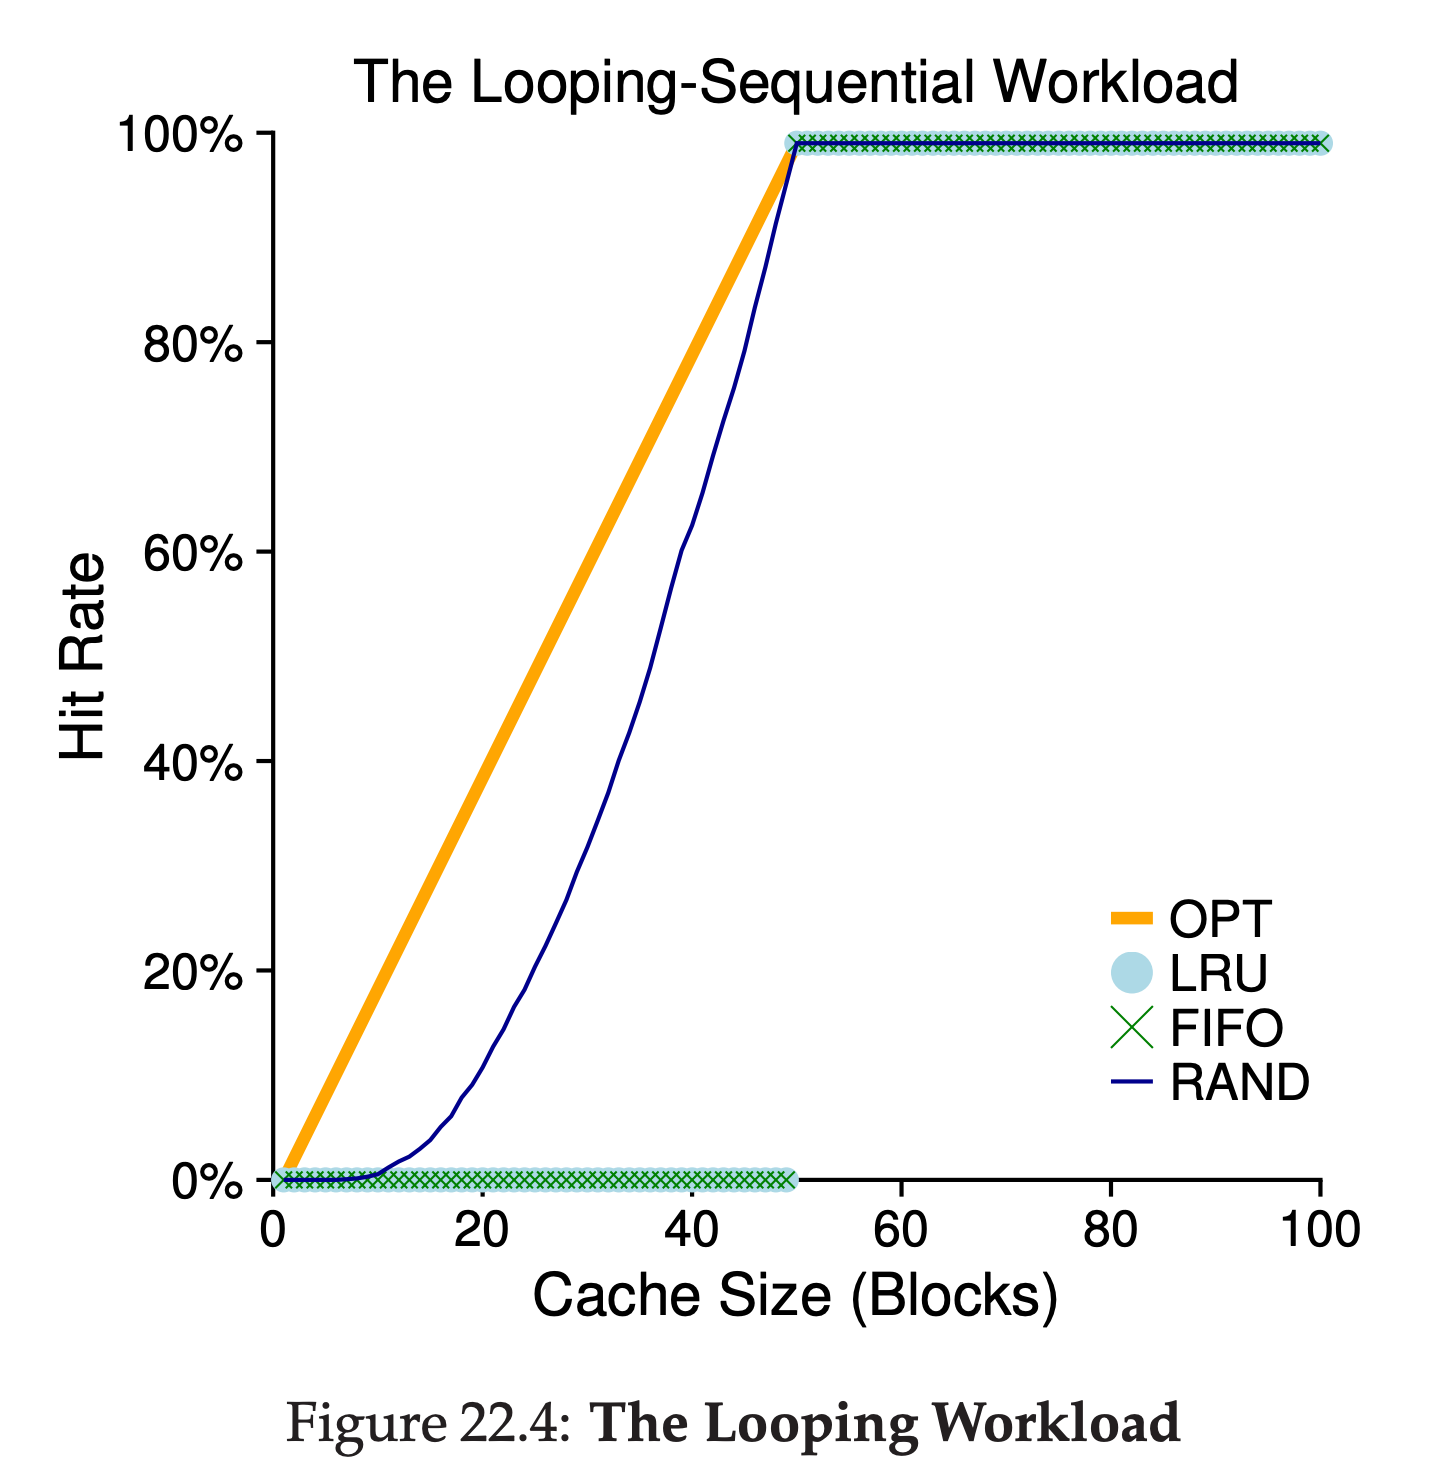
对于循环遍历的情况,只有 RAND 在 Cache Size 小于 Loop 大小时有作用,其他算法在此时缓存作用为0
Dirty Pages
考虑某一页要被驱逐出内存了,如果这一页自从载入到内存以来没有进行过任何修改,那么驱逐操作是零成本的;如果这一页发生了修改,那么驱逐操作必须把它写会到磁盘中。
为了进行上面的区分,硬件必须支持 modified bit 或者 dirty bit,当页被写时,相应的 dirty bit 或者说脏位必须设置为 1. 这样在驱逐时就可以优先选择没有修改过的页。
其他策略
- demand paging
- 需要访问时再把页载入内存
- prefetching
- 根据过往行为预测未来,将可能要访问的页提前载入内存中(一般会出现在顺序读写的情况中)
- clustering/grouping
- 将要写入磁盘的页聚集起来,一起写入磁盘
- Copy on Write
- 要复制什么东西的时候,先是共享这一片内存,等到什么时候其中一个进程要修改这片内存时,再执行复制操作,把新的内容直接写到新的位置。
内存超额订阅(memory oversubscription)和 thrashing(抖动)
当前所有进程需要的内存超过了物理内存大小,这一现象称之为 memory oversubscription
在这种情况下,如果进程不断访问被 swap 出去的页,page fault 和 I/O 消耗时间的占比会变高,CPU有效执行时间会变少,极大拖累性能,称之为 thrashing.
为了尽量避免这种情况的发生,操作系统可能会选择不运行一些进程,从而降低工作集大小,这一措施称为 admission control
还有一种更严苛的做法是让守护线程(out-of-memory killer)在内存超额订阅时把频繁占用内存的进程杀死。
Linux 虚拟内存系统介绍
Linux Address Space
Linux 采用的地址空间和我们之前提到的类似,但是除了 Code, Heap, Stack 之外,还有 Page 0, 以及内核地址空间,如图
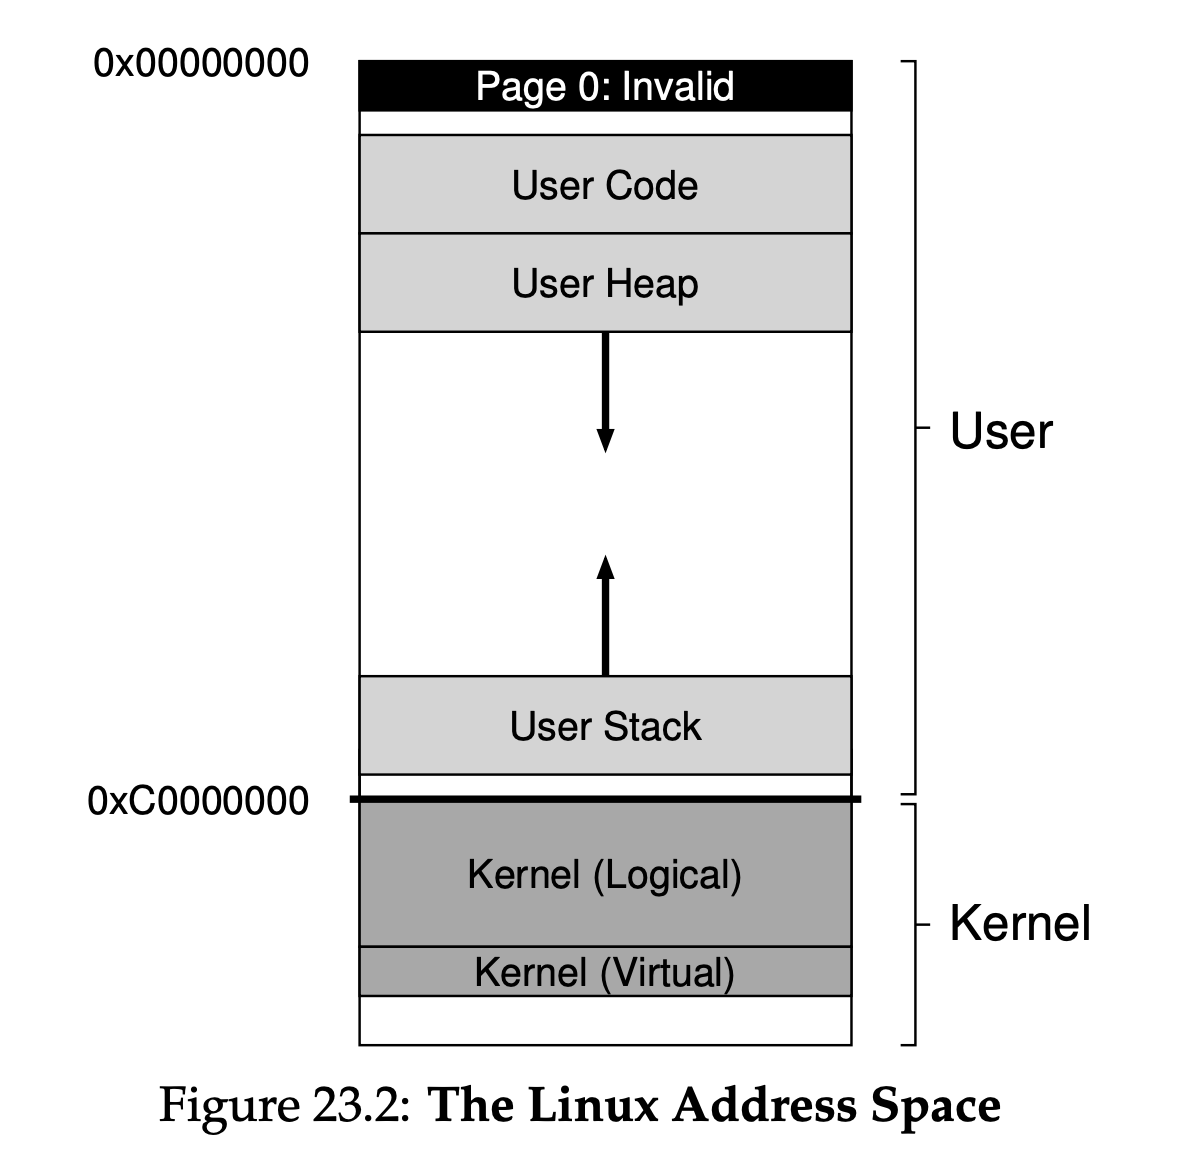
注意到 Linux Kernel Address Space 在每一个进程的地址空间中都被映射到的同一个位置,这样可以节省页表切换的开销,方便数据拷贝。虽然同处一块地址空间,但是内核部分的数据只有进入特权模式才能访问,用户程序不能直接访问内核的数据。
Kernel Logical Address
这个地方是内核使用的一般的虚拟地址空间,用来存放大部分的内核数据结构,比如页表,内核栈等。如果需要分配更多内存,内核可以使用 kmalloc。和其他内存不同,这块内存不能被交换到硬盘中
特殊的,这块内存直接映射到物理内存中的第一片区域,比如0xC000000 映射到物理地址 0x00000000,0xC000FFFF 映射到物理地址 0x0000FFFF
这么做的好处显然是方便地址转换,并且能够让这片地址空间在物理上连续,便于一些操作的进行,比如 DMA.
Kernel Virtual Address
内核需要通过 vmalloc 来获取这部分的内存。和 Kernel Logical Memory 不一样的是,这块内存在物理上并不是连续的,这也使得内存更容易分配,尤其是需要大片缓冲区的时候,这个时候连续的物理内存可能很难找。
这片虚拟内存还有一个用法是通过切换页表,使其实际能映射到的物理内存超过地址空间的大小。这在32位的 Linux 上有实际意义,让其 Kernel Virtual Address 能访问的物理内存大小超过 1GB.
Linux Page Table Structure
Linux 64位操作系统采用了四级页表的结构,对于标准的 4KB 页,VA的组成如下
16bit Unused + 9bit P1 + … + 9bit P4 + 12bit offset
除此之外,Linux 和 x86 支持更大的页。大容量页带来的好处是显而易见的,更小的 TLB 占用,更少的页表查询次数,代价则是可能带来的内部碎片,连续内存不那么容易寻找等。
Linux Page Cache
为了降低对持久化存储访问的消耗,Linux和许多操作系统一样,将热门数据存储在了内存中,这部分内存称为 Page Cache,是散布在物理内存中的大量 physical pages 的集合
Page Cache 的数据有三个来源。
- Memory-mapped files:内存映射文件
- 程序调用
mmap()可以让硬盘上某个文件映射到虚拟地址中,当第一次读写这个虚拟地址时,就会触发 page fault,相应数据加载进内存,建立 PTE,这时候再重新访问。
- 程序调用
- File data and metadata:文件数据和文件系统相关数据
- 程序调用
read(),write()等 I/O 相关接口时产生的缓存数据,包括文件内容和元数据
- 程序调用
- Heap and stack:匿名内存(anonymous memory)
- 这部分内存不能直接在硬盘上找到对应的实际文件,比如栈和堆里的数据, ram 不够时就会放到 swap space 中,相比之下,其他数据则是有实际的硬盘文件作为 backing store
物理 RAM
低地址
┌─────────────────────┐
│ kernel page         │
├─────────────────────┤
│ Process A page      │
├─────────────────────┤
│ foo.txt page #37    │ ← page cache
├─────────────────────┤
│ Process B page      │
├─────────────────────┤
│ bar.txt page #12    │ ← page cache
├─────────────────────┤
│ Process A page      │
├─────────────────────┤
│ foo.txt page #38    │ ← page cache
├─────────────────────┤
│ anonymous page      │
├─────────────────────┤
│ filesystem metadata │ ← page cache
├─────────────────────┤
│ ...                 │
└─────────────────────┘
高地址
操作系统采用哈希表的方式来找到对应的物理页
                 Page Cache Hash Table

(file=foo.txt, offset=0)    ──→ physical page 125
(file=foo.txt, offset=4096) ──→ physical page 892
(file=foo.txt, offset=8192) ──→ physical page 341
(file=bar.txt, offset=0)    ──→ physical page 17
2Q replacement
标准的 LRU 算法通常很好用,但是遇到一些情况时会表现的非常糟糕。比如一个进程需要反复地访问一个大文件的时候,LRU 会把其他文件挤出去。
Linux 采用的 2Q 替代算法避免了这个问题,这个算法维护了两个列表(2 Queue)
- Inactive list: 当页第一次被访问时放在这里
- Active list: 当页再次被访问时会放在这里
当需要替换的时候,Linux 优先从 Inactive list 里面寻找受害者(victim),并且 Linux 会周期性地将 Active list 末尾的页转移到 Inactive list,保持 Active list 大小占整个 Page Cache 的 $\frac{2}{3}$ .
Linux 在列表内部会采用近似 LRU 的策略进行管理,比如 clock algorithm.
在 2Q 算法中,大文件的页在被驱逐出去之前不会进入到 Active list,这样就保住了原来的热门数据。
安全问题
OSTEP 在这部分结束之前还介绍了一些安全问题
Buffer Overflow 和 NX-bit
int some_function(char *input) {
    char dest_buffer[100];
    strcpy(dest_buffer, input); // oops, unbounded copy!
}
缓存溢出可能导致一些未定义行为(UB),访问到不该访问的内存。攻击者可能会用这个手段访问内核的内存,从而获得更多资源,这一现象称为 privilege escalation,指用户程序获得了内核访问权限
防范这个措施的最简单的方法是引入 No-eXecute bit(NX-bit),这样就可以避免执行攻击者在目标栈内存中植入的程序。
ROP (Return-Oriented-Programming) 和 ASLR (Address Space Layout Randomization)
虽然不能显式地执行植入的代码了,但是攻击者可以采用另外一种方式,既然不能执行栈里面的代码,那就执行库里面的机器指令,从而达到目的。通过改变返回栈内存中的地址,让程序跳转并执行一段指令,这些指令称为 gadget,每个 gadget 又可以修改寄存器/内存,同时继续改变跳转地址。
gadget_A:
    ld   a0, 0(sp)      # 修改寄存器
    ld   ra, 8(sp)      # 修改返回地址
    addi sp, sp, 16
    ret
为了防范这种攻击,现在的系统引入了 ASLR,栈内存数据、堆内存数据的位置都不是固定的,如此一来这类攻击最多只能让程序崩溃,而无法获得控制权。
int main(int argc, char *argv[]) {
    int stack = 0;
    printf("%p\n", &stack);
    return 0;
}
上面的代码便可以体现 ASLR,编译之后,每次运行时打印出来的地址都不一样。
同样的,内核中也引入了 KASLR (kernel address space layout randomization) 来提高安全性。
Meltdown, Spectre 和 KPTI (Kernel Page-Table Isolation)
这是一个 2018 年才发现的漏洞,和前面的不同,这里攻击者借助了计算机的微架构来实现目的。
- Meltdown:突破应用程序和操作系统之间的隔离。
- Spectre:欺骗一个本身“没有 bug”的程序,让它通过推测执行泄露自己的秘密。
为了提高机器的运行速度,现在的 CPU 都具有预测执行的机制(speculative execution),虽然呈现出来的运行结果是正确的,但是其在分支预测、处理器缓存等地方留下的痕迹能够被攻击者所利用。
比如虽然 MMU 不允许你访问这块内存,但是 CPU 的预测执行很可能已经拿出来访问过了一遍,然后撤销操作,并在 Cache 中留下痕迹,这样只要扫描 Cache 并根据访问用时,就能推测原本无法获取的信息。
又或者直接利用分支预测机制,人为构造一个跳转历史,让 CPU 执行错误的路径,从而改变 Cache 状态,推测秘密数据。
前面介绍的 Linux 内存空间中用户空间和内核空间还没有隔离开来,而现在为了提高安全性,操作系统大都引入了 KPTI,让内核地址空间和用户空间隔离,代价是牺牲一部分性能,因为多了切换页表的操作。
附录:xv6 内存管理涉及的 RISC-V 的特权指令/硬件基础
SATP 寄存器(Supervision Address Translation and Protection)
[63:60]: Mode 地址转换模式- Mode=0: 不进行地址转换
- Mode=8: 按 Sv39 三级页表规则进行翻译
- Mode=9: Sv48
- Mode=10: Sv57
[59:44]: ASID 当前进程的 ASID (Address Space Identifier)- 用于区分不同进程的虚拟地址空间,不同的进程可以有同样的虚拟地址,但是映射的物理地址不同
- 但是 xv6 没有用到这个,而是使用
sfence.vma清除 TLB 来防止错误的映射
[43:0]: PPN 第一级页表基地址的物理页号- root page table 的物理地址进行右移得到 PPN
sfence.vma (Store Fence for Virtual Memory Address)
这条指令的作用是让之前对页表的修改对后续地址翻译生效,并使处理器中可能缓存的旧地址翻译失效。
sfence.vma rs1, rs2
rs1: virtual addressrs2: ASID
rs1 | rs2 | 作用 |
|---|---|---|
x0 | x0 | 所有虚拟地址、所有 ASID |
VA | x0 | 指定 VA,所有 ASID |
x0 | ASID | 所有 VA,指定 ASID |
VA | ASID | 指定 VA + 指定 ASID |
xv6 中使用的 sfence.vma x0,x0 就是让所有的虚拟地址、所有的ASID的地址转换在 TLB 中都失效,都需要重新查询页表(page-table walk)
Sv39 / Sv48 / Sv57
RISC-V 在 RV64 下有三种分页虚拟地址格式/页表级数方案
| 模式 | 虚拟地址位数 | 页表级数 | 每级索引 | 页大小 | VA位组成 |
|---|---|---|---|---|---|
| Sv39 | 39 bit | 3 | 9 bit | 4 KiB | 9+9+9+12 |
| Sv48 | 48 bit | 4 | 9 bit | 4 KiB | 9+9+9+9+12 |
| Sv57 | 57 bit | 5 | 9 bit | 4 KiB | 9+9+9+9+9+12 |
VA 的组成
以 xv6 使用的 sv39 为例,其虚拟地址构成如下
63            39 38        30 29        21 20        12 11       0
+---------------+------------+------------+------------+-----------+
| sign extension|   VPN[2]   |   VPN[1]   |   VPN[0]   |  offset   |
+---------------+------------+------------+------------+-----------+
                 9 bits        9 bits        9 bits       12 bits

VA
 │
 ├── VPN[2]   ← 第一级索引,用于 L2 Page Table/Root Page Table
 ├── VPN[1]   ← 第二级索引,用于 L1 Page Table
 ├── VPN[0]   ← 第三级索引,用于 L0 Page Table
 └── offset   ← 页内偏移
Sv48, Sv57同理,添加了更多索引
PA 的组成
sv39的物理地址由 PPN 和 offset 组成
63            56 55        30 29        21 20        12 11       0
+---------------+------------+------------+------------+-----------+
|         /     |   PPN[2]   |   PPN[1]   |   PPN[0]   |  offset   |
+---------------+------------+------------+------------+-----------+
                   26 bits      9 bits        9 bits       12 bits
PTE 的组成
页表由多个 PTE 排列组成,每个 PTE 的大小是 8 Bytes 内容如下
 63      54 53      28 27      19 18      10 9   8 7 6 5 4 3 2 1 0
+----------+----------+----------+----------+-----+-+-+-+-+-+-+-+-+
| reserved |  PPN[2]  |  PPN[1]  |  PPN[0]  | RSW |D|A|G|U|X|W|R|V|
+----------+----------+----------+----------+-----+-+-+-+-+-+-+-+-+
     10         26          9          9       2   1 1 1 1 1 1 1 1
这里 PPN[2:0] 可以看作是一个完整的PPN
注意到 $2^{12}=4096$ (4KiB Page), $2^{12+9}=2097152$ (2MiB Page), $2^{12+9+9}=1,073,741,824$ (1GiB Page),这样原本不同分段的 VPN/PPN 可以合并到 offset 中,用于支持更大的页表
Sv39 的 2 MiB 和 1 GiB 大页支持,本质上就是通过“中间层级的 PTE 也可以成为 leaf PTE”实现的,不需要另外增加一套页表结构或专门的“大页表”。 官方规范明确规定:Sv39 中任意层级的 PTE 都可以是 leaf PTE。
| 位/字段 | 名称 | 作用 |
|---|---|---|
| V | Valid | PTE 是否有效。V=0 时,该 PTE 不能用于合法地址转换;访问会导致 page fault。(RISC-V Docs) |
| R | Read | 允许对该页执行 load/read。没有读权限时,对该页进行 load 会产生 load page fault。(RISC-V Docs) |
| W | Write | 允许对该页执行 store/write。没有写权限时,对该页写入会产生 store page fault。(RISC-V Docs) |
| X | Execute | 允许从该页取指执行。没有执行权限时,从该页取指会产生 instruction/fetch page fault。(RISC-V Docs) |
| U | User | 指示该页是否允许 U-mode 用户态访问。U=0 的页面不能被普通用户态直接访问。(RISC-V Docs) |
| G | Global | 表示该映射是全局映射,不依赖当前 ASID。全局映射不需要在 sfence.vma 指定 ASID 时从地址转换缓存中刷新。(RISC-V Docs) |
| A | Accessed | 页面被访问过时置位。一次访问包括 读、写或取指。具体由硬件/软件 A-bit 管理机制决定。(RISC-V Docs) |
| D | Dirty | 页面被写过时置位。表示自上次清除 D 位以来发生过写操作。(RISC-V Docs) |
| RSW | Reserved for Software | 留给 supervisor software 使用,硬件忽略其含义。(RISC-V Docs) |
X,W,R 除了记录读写权限以外还有标记 leaf/non=leaf 的作用
| X | W | R | 含义 |
|---|---|---|---|
| 0 | 0 | 0 | Non-leaf,指向下一级页表 |
| 0 | 0 | 1 | Leaf:只读 |
| 0 | 1 | 0 | Reserved |
| 0 | 1 | 1 | Leaf:读写 |
| 1 | 0 | 0 | Leaf:只执行 |
| 1 | 0 | 1 | Leaf:读 + 执行 |
| 1 | 1 | 0 | Reserved |
| 1 | 1 | 1 | Leaf:读 + 写 + 执行 |
注:经典 Sv39 PTE 的高 10 位原本是 Reserved,但现在已经有两个标准扩展占用了其中 3 位
| 位 | 字段 | 扩展 | 作用 |
|---|---|---|---|
| 63 | N | Svnapot | 描述 NAPOT(Naturally Aligned Power-of-Two)连续物理页映射 |
| 62:61 | PBMT | Svpbmt | 指定该页的物理内存类型(Memory Type) |
| 60:54 | Reserved | — | 目前仍保留给未来标准扩展 |
xv6 的基础页表机制本身并不依赖它们。
VA->PA的转换
对于某一个VA,其翻译成PA的逻辑如下
satp.PPN左移 12 位得到根页表的物理地址(Root Page Table Base/L2 Page Table Base) -Root Page Table Base = satp.PPN << 12- 根据
VPN[2]和 Root Page Table Base 找到第一级的 Page Table Entry- 假如
VPN[2]=3, 那么取 Root Page Table 中的第3个 PTE PTE_PA = Root Page Table Base + VPN[2] * sizeof(PTE)- 根据 PTE PA 访问对应的PTE,从而得到下一级页表的 PPN (从而得到 L1 Page Table Base)或者如果 PTE 无效或者不满足访问类型对应的权限要求,则产生相应的 page-fault exception。
- 假如
- 根据
VPN[1]和 L1 Page Table Base 找到第二级的 Page Table Entry- 假如
VPN[1]=10, 那么取 L1 Page Table 中的第10个 PTE PTE_PA = L1 Page Table Base + VPN[1] * sizeof(PTE)- 根据 PTE PA 访问对应的PTE,从而得到下一级页表的 PPN(左移得到 L0 Page Table Base)
- 假如
- 根据
VPN[0]和 L0 Page Table Base 找到第三级的 Page Table Entry- 假如
VPN[0]=20, 那么取 L0 Page Table 中的第20个 PTE PTE_PA = L0 Page Table Base + VPN[0] * sizeof(PTE)- 根据 PTE PA 访问对应的PTE,从而得到当前 VA 对应的的 PPN(Non-leaf表明这是最后一级)
- 假如
- 根据 offset 和 PPN 拼成真实的 PA
PA = PPN << 12 | offset
csrw menvcfg, %0
xv6中相关代码如下
// Machine Environment Configuration Register

#define MENVCFG_STCE (1L << 63)
#define MENVCFG_ADUE (1L << 61)

static inline uint64
r_menvcfg()
{
  uint64 x;
  // asm volatile("csrr %0, menvcfg" : "=r" (x) );
  asm volatile("csrr %0, 0x30a" : "=r"(x));
  return x;
}

static inline void
w_menvcfg(uint64 x)
{
  // asm volatile("csrw menvcfg, %0" : : "r" (x));
  asm volatile("csrw 0x30a, %0" : : "r"(x));
}
这里 ADUE 作用是让硬件自动更新 PTE 中的 A/D位,在新版的 xv6 中加入;STCE 的作用则是控制 S-mode 是否允许使用 stimecmp 来设置 supervisor timer interrupt 的比较值。