Prologue
想象有一个桃子和一堆猴子,当许多双手同时伸向一个桃子的时候,事情就会变的混乱。这在操作系统中也是一样的,存在一些公共资源和多个并发的进程/线程,当它们同时需要访问资源的时候,可能就会出现问题。下面是一个简单的例子,假设两个 worker 都让 sp 寄存器指向的数据加一,CPU 进行 RR 调度。
| worker A | worker B | sp |
|---|---|---|
| ld sp, a0 | 1 | |
| ld sp, a0 | 1 | |
| add a0, 1 | 1 | |
| add a0, 1 | 1 | |
| sd sp, a0 | 2 | |
| sd sp, a0 | 2 |
两个 worker 都要完成加一的操作,但是最后的结果却是只有一次操作被完成。这种情况被称之为竞态条件(race condition),而造成这个问题的代码被称之为临界区(critical section)
为了解决这种并发问题,OSTEP 介绍了一些概念,包括 原子操作(atomic operation)、互斥锁(mutual exclusion)和信号量(semaphore) 等。上面的问题的直接解决办法就是引入互斥(mutual exclusion)的概念,临界区只能同时被一个线程执行。
除此之外,不同 worker 的执行顺序可能有要求,因此又有了 条件变量(condition variable)
锁机制:Locks
基本思想
锁机制的思想很简单,一个锁同时只能被一个进程/线程占有,如果拿不到锁,那就可以等着(Spin Lock),或者进入阻塞状态(sleep lock)等待被唤醒。
lock_t mutex; // some globally-allocated lock ’mutex’
...
lock(&mutex);
balance = balance + 1;
unlock(&mutex);
这里,lock, balance 都是公共资源。如果没人持有锁,那么当前进程就会获得锁并且进入临界区,完成之后释放锁。在此期间,其他进程无法进入临界区。
当然,锁是有代价的,它引入了额外的空间和时间开销(主要是时间,在后面的编程作业中将会看到这一点,差距是相当明显的)。因此,存在两种使用倾向,一种是粗粒度锁(coarse-grained locking),用一个锁来保护多个临界区和多种公共资源,另一种则是用细粒度锁(fine-grained locking),用多种锁来保护不同的资源。不过这两者在性能上并不是一种永远优于另一种的,需要实际测试才能知道。
如何造一个锁
一个很简单的想法就是,持有锁时,把状态设置成已持有的状态(比如 locked=1),然后这个时候如果有其他进程想要获得锁,就原地旋转(spin),直到释放时再把状态重制,类似于下面的代码。
struct lock{
    int locked;
}lock;

void init(struct lock *l){
    l->locked = 0;
}

void lock(struct lock *l){
    while (l->locked)
        ;
    l->locked = 1;
    return;
}

void unlock(struct lock *l){
    l->locked = 0;
}
然而实际上这根本行不通,因为 l->locked 本身就是公共资源,很可能会出现多个线程同时进入这条语句的情况,然后它们都得到了锁,并不能起到保护的作用。
另一种想法是,lock的时候禁用中断,unlock的时候恢复中断,这样就不会被打断,但这只在单CPU上有效,并且关闭中断可能会造成一些隐患。这种方法只在 OS 内部的一部分区域进行了使用(比如 xv6 的 push_off 在获取当前CPU时不希望发生上下文切换)
使用原子操作
回到上面的代码中,要让上面的代码实现锁机制,必须要引入处理器的支持,让上面的操作自身不会被打断,其中一个支持便是 test-and-set 指令,它的逻辑如下
int TestAndSet(int *old_ptr, int new) {
    int old = *old_ptr; // fetch old value at old_ptr
    *old_ptr = new;
    return old;
}
还有一种是 compare-and-swap
int CompareAndSwap(int *ptr, int expected, int new) {
    int original = *ptr;
    if (original == expected)
        *ptr = new;
    return original;
}
虽然上面看起来有很多句子,但是它们执行起来相当于一条指令,不会被中途打断,不过这样的指令开销也会明显更大。引入指令之后,就可以让上面的代码真正实现锁机制。
void lock(lock_t *lock) {
    while (TestAndSet(&lock->flag, 1) == 1)
        ; // spin-wait (do nothing)
}
void lock(lock_t *lock) {
    while (CompareAndSwap(&lock->flag, 0, 1) == 1)
        ; // spin
}
OSTEP 还介绍了另外一种原子操作
int LoadLinked(int *ptr) {
    return *ptr;
}
int StoreConditional(int *ptr, int value) {
    if (no update to *ptr since LL to this addr) {
        *ptr = value;
        return 1; // success!
    } else {
        return 0; // failed to update
    }
}
实现锁的方式也是类似的
void lock(lock_t *lock) {
    while (1) {
        while (LoadLinked(&lock->flag) == 1)
            ; // spin until it’s zero
        if (StoreConditional(&lock->flag, 1) == 1)
            return; // if set-to-1 was success: done
        // otherwise: try again
    }
}
void unlock(lock_t *lock) {
    lock->flag = 0;
}
OSTEP介绍的最后一种硬件支持是 fetch-and-add 用来建造一个 ticket lock
int FetchAndAdd(int *ptr) {
    int old = *ptr;
    *ptr = old + 1;
    return old;
}
typedef struct __lock_t {
    int ticket;
    int turn;
} lock_t;

void lock_init(lock_t *lock) {
    lock->ticket = 0;
    lock->turn = 0;
}
void lock(lock_t *lock) {
    int myturn = FetchAndAdd(&lock->ticket);
    while (lock->turn != myturn)
        ; // spin
}
void unlock(lock_t *lock) {
    lock->turn = lock->turn + 1;
}
这样就自动形成了排队机制
在 xv6 中,普通的自旋锁的实现也是类似的,借助了原子操作
struct spinlock {
  uint locked; // Is the lock held?

  // For debugging:
  char *name;      // Name of lock.
  struct cpu *cpu; // The cpu holding the lock.
};

void
initlock(struct spinlock *lk, char *name)
{
  lk->name = name;
  lk->locked = 0;
  lk->cpu = 0;
}

// Acquire the lock.
// Loops (spins) until the lock is acquired.
void
acquire(struct spinlock *lk)
{
  push_off(); // disable interrupts to avoid deadlock.
  if (holding(lk))
    panic("acquire");
  while (__atomic_exchange_n(&lk->locked, 1, __ATOMIC_ACQUIRE) != 0)
    ;
  lk->cpu = mycpu();
}

// Release the lock.
void
release(struct spinlock *lk)
{
  if (!holding(lk))
    panic("release");
  lk->cpu = 0;
  __atomic_store_n(&lk->locked, 0, __ATOMIC_RELEASE);
  pop_off();
}
这里的 atomic_exchange_n 就是将 1 写入 locked 并返回 locked 的旧值,如果旧值是 0 说明获取成功, __atomic_store_n 也是类似的。
__ATOMIC_ACQUIRE 告诉编译器和CPU,获得锁之后的内存操作,不能被重排到获得锁之前。而 __ATOMIC_RELEASE 则是释放锁之前,前面的操作不能跑到释放之后。现代 CPU 基本上支持乱序执行来进行性能优化,这可能破坏掉我们的锁机制。同时这也意味着锁机制使得 CPU 的优化措施暂时失效,对性能会有影响。
Peterson 算法
有没有不用原子操作也能实现锁的方法呢?有的:Peterson’s algorithm
int flag[2];
int turn;
void init() {
    // indicate you intend to hold the lock w/ ’flag’
    flag[0] = flag[1] = 0;
    // whose turn is it? (thread 0 or 1)
    turn = 0;
}
void lock() {
    // ’self’ is the thread ID of caller
    flag[self] = 1;
    // make it other thread’s turn
    turn = 1- self;
    while ((flag[1-self] == 1) && (turn == 1- self))
        ; // spin-wait while it’s not your turn
}
void unlock() {
    // simply undo your intent
    flag[self] = 0;
}
现在假设两个线程同时进入 lock() ,第一行因为只修改自己的部分所以不会有影响。而 turn = 1 - self; 确保了如果发生了竞态,后一个完成访存操作的进程会把 turn 让给对方,然后进行自旋。
如果要让两个线程一直卡在 while 循环,这就意味着需要满足两个 flag 都是 1 并且 turn == 1 -self ,然而前一个语句表明了这是不可能的,要么 turn == 0 要么 turn == 1。
如果要求两个线程都能通过 lock() 并持有锁,那么第一个完成的判断条件的进程一定满足 flag[self] == 1 && turn == self,然后至少 flag[self] 不会再更改,而另一个线程能做的只有修改自己的 flag 和把 turn 让给对方,无论如何也不会满足结束 while 的条件。
自旋太浪费时间了
假设有两个进程和一个执行 RR 调度的核心,进程 A 拿到了锁,然后触发了中断,进程切换到了进程B,进程B需要拿这个锁,于是自旋,在这段时间内什么都做不了,直到重新切换为进程 A
为了解决这个问题,需要让进程拿不到锁时放弃 CPU 来节省资源。也就是 yield
void init() {
    flag = 0;
}
void lock() {
    while (TestAndSet(&flag, 1) == 1)
        yield(); // give up the CPU
}
void unlock() {
    flag = 0;
}
这个方法的问题也是很明显的,yield 虽然放弃了CPU,但是上下文切换的开销还在,每个进程都要执行一遍 yield()。并且这种方法无法解决饿死的问题,可能会有进程一直拿不到锁。
typedef struct __lock_t {
    int flag;
    int guard;
    queue_t *q;
} lock_t;
void lock_init(lock_t *m) {
    m->flag = 0;
    m->guard = 0;
    queue_init(m->q);
}
void lock(lock_t *m) {
    while (TestAndSet(&m->guard, 1) == 1)
        ; //acquire guard lock by spinning
    if (m->flag == 0) {
        m->flag = 1; // lock is acquired
        m->guard = 0;
    } else {
        queue_add(m->q, gettid());
        m->guard = 0;
        park();     // put a calling thread to sleep,
    }
}
void unlock(lock_t *m) {
    while (TestAndSet(&m->guard, 1) == 1)
        ; //acquire guard lock by spinning
    if (queue_empty(m->q))
        m->flag = 0; // let go of lock; no one wants it
    else    // wake a particular thread as designated by queue_remove(m->q)
        unpark(queue_remove(m->q)); // hold lock
                                    // (for next thread!)
    m->guard = 0;
}
为了避免调度器进行糟糕的调度,这里建立了一个队列,获取锁时先检查 flag 是否等于0,如果是,那么直接获得锁,否则把自己加到队列中,进入睡眠。直到前面获取了锁的进程释放锁,这时就会唤醒等待中的进程,这个期间锁是一直持有着的。
但是这里有一个竞态条件,介于 m->guard=0 和 park() 之间,如果发生了线程切换,比如切换到了一个持有锁的线程,并且准备把锁释放,那么很可能这个 unpark() 会比 park() 先执行,然后前面的线程就会睡死。
对此,Solaris 的解决方案是添加一个 setpark() 放在 m->guard = 0 之前,如果 setpark() 和 park() 之间发生了 unpark() 那么 park() 会立马返回,不会睡死过去。
而 Linux 中引入了 futex (fast user mutex),没有竞争的时候完全在用户态解决,发生竞争了再进入内核睡眠。
void mutex_lock (int *mutex) {
    int v;
    // Bit 31 was clear, we got the mutex (fastpath)
    if (atomic_bit_test_set (mutex, 31) == 0)
        return;
    atomic_increment (mutex);
    while (1) {
        if (atomic_bit_test_set (mutex, 31) == 0) {
            atomic_decrement (mutex);
            return;
        }
        // Have to waitFirst to make sure futex value
        // we are monitoring is negative (locked).
        v = *mutex;
        if (v >= 0)
            continue;
        futex_wait (mutex, v);
    }
}
void mutex_unlock (int *mutex) {
    // Adding 0x80000000 to counter results in 0 if and
    // only if there are not other interested threads
    if (atomic_add_zero (mutex, 0x80000000))
        return;
    // There are other threads waiting for this mutex,
    // wake one of them up.
    futex_wake (mutex);
}
mutex的值是负数说明锁被持有,于是mutex自增,释放锁时,31位变成0,mutex变回正数,获取锁时变回负数,并且mutex减一。当mutex为0时说明没有线程等待锁。
这里 futex_wait() 的作用是检查 mutex 是否发生变化,不等于 v 则立即返回,否则睡眠。 futex_wake() 则是唤醒一个等待锁的线程。
这种做法也被称为 two-phase-lock ,先自旋一段时间,尝试等待锁释放,然后再进入睡眠
在 xv6 中的睡眠锁采用了一个自旋锁用于保护自身的成员变量,使用进程自己的锁保护进程自己的变量。
// Long-term locks for processes
struct sleeplock {
  uint locked;       // Is the lock held?
  struct spinlock lk; // spinlock protecting this sleep lock

  // For debugging:
  char *name;        // Name of lock.
  int pid;           // Process holding lock
};
void initsleeplock(struct sleeplock *lk, char *name) {
  initlock(&lk->lk, "sleep lock");  // locked=0, cpu=0, name="sleep lock"
  lk->name = name;
  lk->locked = 0;
  lk->pid = 0;
}

void acquiresleep(struct sleeplock *lk) {
  acquire(&lk->lk);
  while (lk->locked) {
    sleep(lk, &lk->lk); // 进程的chan成员设置成lk地址,并且释放自旋锁,获得进程锁,并进入睡眠
  }
  lk->locked = 1;
  lk->pid = myproc()->pid;
  release(&lk->lk);
}

void releasesleep(struct sleeplock *lk) {
  acquire(&lk->lk);
  lk->locked = 0;
  lk->pid = 0;
  wakeup(lk);       // 遍历进程数组,唤醒每一个chan成员为lk地址的进程
  release(&lk->lk);
}

int holdingsleep(struct sleeplock *lk) {
  int r;

  acquire(&lk->lk);
  r = lk->locked && (lk->pid == myproc()->pid); // 检查进程是否持有睡眠锁
  release(&lk->lk);
  return r;
}

// Atomically release lock and sleep on chan.
// Reacquires lock when awakened.
void sleep(void *chan, struct spinlock *lk) {
  struct proc *p = myproc();

  if (lk != &p->lock) {  // DOC: sleeplock0
    acquire(&p->lock);   // DOC: sleeplock1
    release(lk);
  }

  // Go to sleep.
  p->chan = chan;
  p->state = SLEEPING;

  sched();

  // Tidy up.
  p->chan = 0;

  // Reacquire original lock.
  if (lk != &p->lock) {
    release(&p->lock);
    acquire(lk);
  }
}

// Wake up all processes sleeping on chan.
// Must be called without any p->lock.
void wakeup(void *chan) {
  struct proc *p;

  for (p = proc; p < &proc[NPROC]; p++) {
    acquire(&p->lock);
    if (p->state == SLEEPING && p->chan == chan) {
      p->state = RUNNABLE;
    }
    release(&p->lock);
  }
}
sleep 时需要放弃原来的锁,然后持有进程锁,如果两个锁相等,那么不会执行这两个操作。
在锁的基础上建立数据结构
OSTEP 取了计数器、链表、队列以及哈希表作为例子建立了并发数据结构
计数器
下面是一个不带锁的简单计数器
typedef struct __counter_t {
    int value;
} counter_t;
void init(counter_t *c) {
    c->value = 0;
}
void increment(counter_t *c) {
    c->value++;
}
void decrement(counter_t *c) {
    c->value--;
}
int get(counter_t *c) {
    return c->value;
}
要解决并发问题,最简单的办法就是每次要加减时,先获得锁
typedef struct __counter_t {
    int
    value;
    pthread_mutex_t lock;
} counter_t;
void init(counter_t *c) {
    c->value = 0;
    Pthread_mutex_init(&c->lock, NULL); // 这里 Pthread_mutex_init() 是 OSTEP 自己包装过的函数
}
void increment(counter_t *c) {
    Pthread_mutex_lock(&c->lock);
    c->value++;
    Pthread_mutex_unlock(&c->lock);
}
void decrement(counter_t *c) {
    Pthread_mutex_lock(&c->lock);
    c->value--;
    Pthread_mutex_unlock(&c->lock);
}
int get(counter_t *c) {
    Pthread_mutex_lock(&c->lock);
    int rc = c->value;
    Pthread_mutex_unlock(&c->lock);
    return rc;
}
但是这种做法是比较慢的,尤其随着线程数量增加,大量的线程需要排队,扩展性比较差
所以有了一个新的做法,每个线程都有自己的计数器,程序还有一个全局计数器,超过了某个阈值之后再把自己的值加到全局计数器上,这也可以称之为细粒度锁的做法。
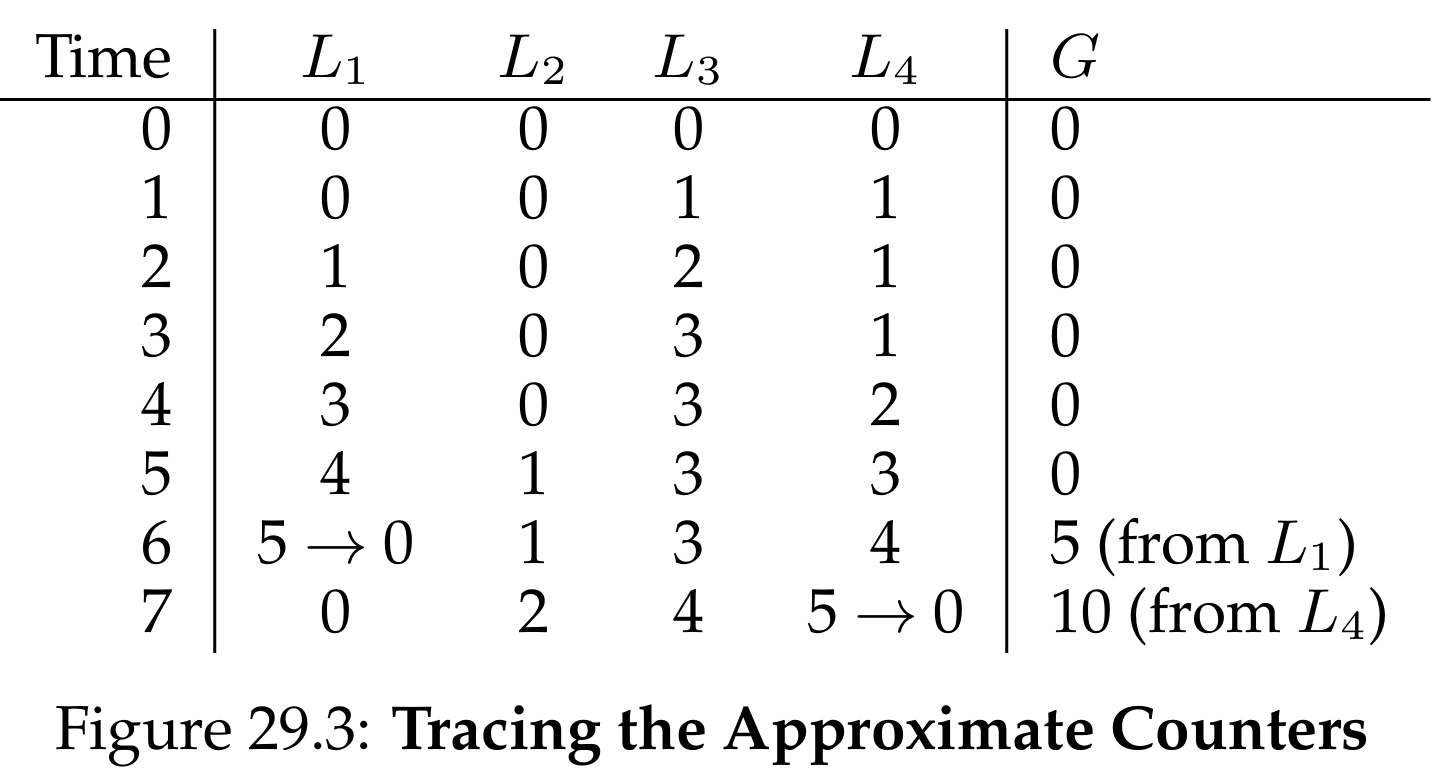
void increment(counter_t *c, int threadID) {
    // pthread_mutex_lock(&c->llock[threadID]);
    c->local[threadID]++;
    if (c->local[threadID] >= c->threshold) {
        pthread_mutex_lock(&c->glock);
        c->global += c->local[threadID];
        pthread_mutex_unlock(&c->glock);
        c->local[threadID] = 0;
    }
    // pthread_mutex_unlock(&c->llock[threadID]);
}
这章的课后作业要求并发实现这章提到的计数器、链表以及一个自选数据类型并且进行时间测量,这里的测量结果如下
sodium@nas-MacBook-Air-13 threads-locks-usage-homework % ./concurrent-counter 10000 8
1686 us
counter = 80000
sodium@nas-MacBook-Air-13 threads-locks-usage-homework % ./approximate-counter 10000 8 10
357 us
counter = 80000
sodium@nas-MacBook-Air-13 threads-locks-usage-homework % ./approximate-counter 10000 8 100
344 us
counter = 80000
sodium@nas-MacBook-Air-13 threads-locks-usage-homework % ./approximate-counter 10000 8 1000
180 us
counter = 80000
可以看到,在线程较多的情况下,近似计数器的速度明显快于原来的计数器,并且阈值越大,锁竞争越少,耗时也更短
链表
并发链表应该如何构建,很容易能想到的两种方法分别是全局锁和每个结点一个锁,其中全局锁是一个比较简单的做法。
typedef struct __node_t {
    int key;
    struct __node_t *next;
} node_t;

typedef struct __list_t {
    node_t *head;
    pthread_mutex_t llock;
} list_t;

void node_init(node_t *node, int key) {
    node->key = key;
    node->next = NULL;
}

void list_init(list_t *list) {
    list->head = NULL;
    pthread_mutex_init(&list->llock, NULL);
}

int list_insert(list_t *list, int key) {
    node_t *new = malloc(sizeof(node_t));
    if (new == NULL) {
        perror("malloc");
        return -1; // fail
    }
    node_init(new, key);
    pthread_mutex_lock(&list->llock);

    if (list->head == NULL) {
        list->head = new;
    } else {
        new->next = list->head;
        list->head = new;
    }
    pthread_mutex_unlock(&list->llock);

    return 0; // success
}

int list_lookup(list_t *list, int key) {
    int rv = -1;
    pthread_mutex_lock(&list->llock);
    node_t *curr = list->head;
    if (curr == NULL) {
        pthread_mutex_unlock(&list->llock);
        return rv;
    }
    while (curr->next) {
        if (curr->key == key) {
            rv = 0;
            break;
        }
        node_t *temp = curr;
        curr = curr->next;
    }
    if (curr != NULL && curr->key == key) {
        rv = 0;
    }
    pthread_mutex_unlock(&list->llock);
    return rv; // now both success and failure
}
而另一种做法就是使用细粒度锁,hand-over-hand locking. 先获取下一个结点的锁,再释放当前结点的锁,OSTEP 没有给出代码,而是作为课后作业。由于频繁地获取和释放锁,这种方法可能并不一定更快。
typedef struct __node_t
{
    int key;
    struct __node_t *next;
    pthread_mutex_t lock;
} node_t;

typedef struct __list_t {
    node_t *head;
    pthread_mutex_t llock;
} list_t;

void node_init(node_t *node, int key) {
    node->key = key;
    node->next = NULL;
    pthread_mutex_init(&node->lock, NULL);
}

void list_init(list_t *list) {
    list->head = NULL;
    pthread_mutex_init(&list->llock, NULL);
}

int list_insert(list_t *list, int key) {
    node_t *new = malloc(sizeof(node_t));
    node_init(new, key);
    if (list->head == NULL)
        list->head = new;
    else {
        pthread_mutex_lock(&list->head->lock);
        new->next = list->head;
        list->head = new;
        pthread_mutex_unlock(&new->next->lock);
    }
    return 0; // success
}

int list_lookup(list_t *list, int key) {
    int rv = -1;
    node_t *curr = list->head;
    if (curr == NULL)
        return rv;
    pthread_mutex_lock(&curr->lock);
    while (curr->next) {
        if (curr->key == key) {
            rv = 0;
            break;
        }
        pthread_mutex_lock(&curr->next->lock);
        node_t *temp = curr;
        curr = curr->next;
        pthread_mutex_unlock(&temp->lock);
    }
    if (curr != NULL && curr->key == key) {
        rv = 0;
    }
    pthread_mutex_unlock(&curr->lock);
    return rv; // now both success and failure
}
即使 hand-over-hand 理论上具有更高的并发度,它也可能在相当大的 workload 下仍然跑不过 coarse-grained list。
sodium@nas-MacBook-Air-13 threads-locks-usage-homework % ./coarse-grained-list 1000 8 10 0
list size: 10
threds number: 8
seed: 0
iteration: 1000
Total look up times: 80000
Elapsed time: 2367 us
Average look up time: 29.59 ns

sodium@nas-MacBook-Air-13 threads-locks-usage-homework % ./coarse-grained-list 1000 8 100 0
list size: 100
threds number: 8
seed: 0
iteration: 1000
Total look up times: 800000
Elapsed time: 101991 us
Average look up time: 127.49 ns

sodium@nas-MacBook-Air-13 threads-locks-usage-homework % ./coarse-grained-list 1000 8 1000 0
list size: 1000
threds number: 8
seed: 0
iteration: 1000
Total look up times: 8000000
Elapsed time: 6987468 us
Average look up time: 873.43 ns

sodium@nas-MacBook-Air-13 threads-locks-usage-homework % ./linked-list 1000 8 10 0 && \
./linked-list 1000 8 100 0 && \
./linked-list 1000 8 1000 0

list size: 10
threds number: 8
seed: 0
iteration: 1000
Total look up times: 80000
Elapsed time: 185440 us
Average look up time: 2318 ns

list size: 100
threds number: 8
seed: 0
iteration: 1000
Total look up times: 800000
Elapsed time: 2357703 us
Average look up time: 2947 ns

list size: 1000
threds number: 8
seed: 0
iteration: 1000
Total look up times: 8000000
Elapsed time: 45988543 us
Average look up time: 5748 ns
我自己写的程序测试结果如下,测试方法为提前建好一个随机链表,然后进行并发查询操作
| List size | Coarse-grained, 8T | Hand-over-hand, 8T | Hand / Coarse |
|---|---|---|---|
| 10 | 29.59 ns | 2318 ns | 78.3× |
| 100 | 127.49 ns | 2947 ns | 23.1× |
| 1000 | 873.43 ns | 5748 ns | 6.58× |
可以看到,细粒度锁惨败,高并发未必等于性能更好。
队列
队列加锁很简单,在头部和尾部分别添加即可
void Queue_Enqueue(queue_t *q,intvalue){
    node_t *tmp= malloc(sizeof(node_t));
    assert(tmp!=NULL);
    tmp->value=value;
    tmp->next =NULL;

    pthread_mutex_lock(&q->tail_lock);
    q->tail->next=tmp;
    q->tail= tmp;
    pthread_mutex_unlock(&q->tail_lock);
}
int Queue_Dequeue(queue_t *q,int *value){
    pthread_mutex_lock(&q->head_lock);
    node_t *tmp= q->head;
    node_t *new_head= tmp->next;
    if (new_head==NULL){
        pthread_mutex_unlock(&q->head_lock);
        return -1;//queuewas empty
    }
    *value=new_head->value;
    q->head= new_head;
    pthread_mutex_unlock(&q->head_lock);
    free(tmp);
    return 0;
}
不过这里需要注意一个问题,head 和 tail 可能是同一个结点,这时应该需要特殊处理
哈希表
#define BUCKETS (101)
typedef struct __hash_t {
    list_t lists[BUCKETS];
} hash_t;
void Hash_Init(hash_t *H) {
    int i;
    for (i = 0; i < BUCKETS; i++)
    List_Init(&H->lists[i]);
}
int Hash_Insert(hash_t *H, int key) {
    return List_Insert(&H->lists[key % BUCKETS], key);
}
int Hash_Lookup(hash_t *H, int key) {
    return List_Lookup(&H->lists[key % BUCKETS], key);
}
并发哈希表的构建很简单,只是需要用到前面的并发链表,但是对于可以改变大小的并发哈希表来说会麻烦许多,因为元素需要重新分布
二叉搜索树
仿照链表的做法,我写了两份并发 BST 代码,分别使用粗粒度锁和HOH,根据种子提前建立好一个随机二叉搜索树,然后进行查找测试
粗粒度锁的做法很简单,在临界区前后添加锁获取释放代码即可,而HOH做法也和链表类似。直接看测试结果
| Threads | Global mutex | Hand-over-hand | HOH / Global |
|---|---|---|---|
| 1 | 23.43 ns | 65.75 ns | 2.81× |
| 2 | 27.98 ns | 239.80 ns | 8.57× |
| 4 | 36.90 ns | 516.42 ns | 13.998× |
| 8 | 56.79 ns | 2555.73 ns | 45.0× |
随着线程数的增多,HOH 的性能急剧恶化,操作 mutex 的代价太高了,而 critical section 本身很短。
条件变量:Condition Variable
基本用法
并发执行的程序有时需要保证执行顺序的正确
volatile int done = 0;
void *child(void *arg) {
    printf("child\n");
    done = 1;
    return NULL;
}
int main(int argc, char *argv[]) {
    printf("parent: begin\n");
    pthread_t c;
    Pthread_create(&c, NULL, child, NULL); // child
    while (done == 0)
        ; // spin
    printf("parent: end\n");
    return 0;
}
这是一种通过自旋实现的等待,但这种方法非常浪费 CPU 资源,通常的方法是使用条件变量
int done = 0;
pthread_mutex_t m = PTHREAD_MUTEX_INITIALIZER;
pthread_cond_t c = PTHREAD_COND_INITIALIZER;
void thr_exit() {
    Pthread_mutex_lock(&m);
    done = 1;
    Pthread_cond_signal(&c);
    Pthread_mutex_unlock(&m);
}
void *child(void *arg) {
    printf("child\n");
    thr_exit();
    return NULL;
}
void thr_join() {
    Pthread_mutex_lock(&m);
    while (done == 0)
        Pthread_cond_wait(&c, &m);
    Pthread_mutex_unlock(&m);
}
int main(int argc, char *argv[]) {
    printf("parent: begin\n");
    pthread_t p;
    Pthread_create(&p, NULL, child, NULL);
    thr_join();
    printf("parent: end\n");
    return 0;
}
当 wait() 被调用时,需要持有传入的锁。wait() 会释放锁并让线程进入睡眠,直到 signal() 被调用,这个时候 wait() 会尝试获得锁,获得之后返回。
如果没有 while ,可能会出现错误唤醒的情况,如果没有 lock:
void thr_exit(){
    done= 1;
    Pthread_cond_signal(&c);
}

void thr_join(){
    if (done==0)
        Pthread_cond_wait(&c);
}
那么可能会出现这种情况,当 join() 即将执行 wait() 时,CPU 切换线程到了 exit() 执行 signal() ,线程会睡死过去。
生产者-消费者问题:Producer/Consumer (Bounded Buffer) Problem
int buffer;
int count = 0; // initially, empty
void put(int value) {
    assert(count == 0);
    count = 1;
    buffer = value;
}
int get() {
    assert(count == 1);
    count = 0;
    return buffer;
}
void *producer(void *arg) {
    int i;
    int loops = (int) arg;
    for (i = 0; i < loops; i++) {
        put(i);
}
}
void *consumer(void *arg) {
    while (1) {
        int tmp = get();
        printf("%d\n", tmp);
    }
}
生产者和消费者共用一个缓冲区,因此就会出现并发问题。上面的代码是一个初始版本,缓冲区只有一个元素。
注意到这里 count 是没有保护的,假设有多个 producer ,如果它们同时发现 count==0 就会出现问题,一个改进的版本如下:
void *producer(void *arg) {
    int i;
    for (i = 0; i < loops; i++) {
        Pthread_mutex_lock(&mutex);             // p1
        if (count == 1)                         // p2
            Pthread_cond_wait(&cond, &mutex);   // p3
        put(i);                                 // p4
        Pthread_cond_signal(&cond);             // p5
        Pthread_mutex_unlock(&mutex);           // p6
    }
}
void *consumer(void *arg) {
    int i;
    for (i = 0; i < loops; i++) {
        Pthread_mutex_lock(&mutex);             // c1
        if (count == 0)                         // c2
            Pthread_cond_wait(&cond, &mutex);   // c3
        int tmp = get();                        // c4
        Pthread_cond_signal(&cond);             // c5
        Pthread_mutex_unlock(&mutex);           // c6
        printf("%d\n", tmp);
    }
}
producer 会尝试获得锁,检查 count ,如果不满足条件就释放锁进入睡眠,而 consumer 同样尝试获得锁,检查 count,如果不满足条件同样释放锁进入睡眠。
注意到这里使用的是 if 条件,这意味着可能会有错误唤醒的情况。
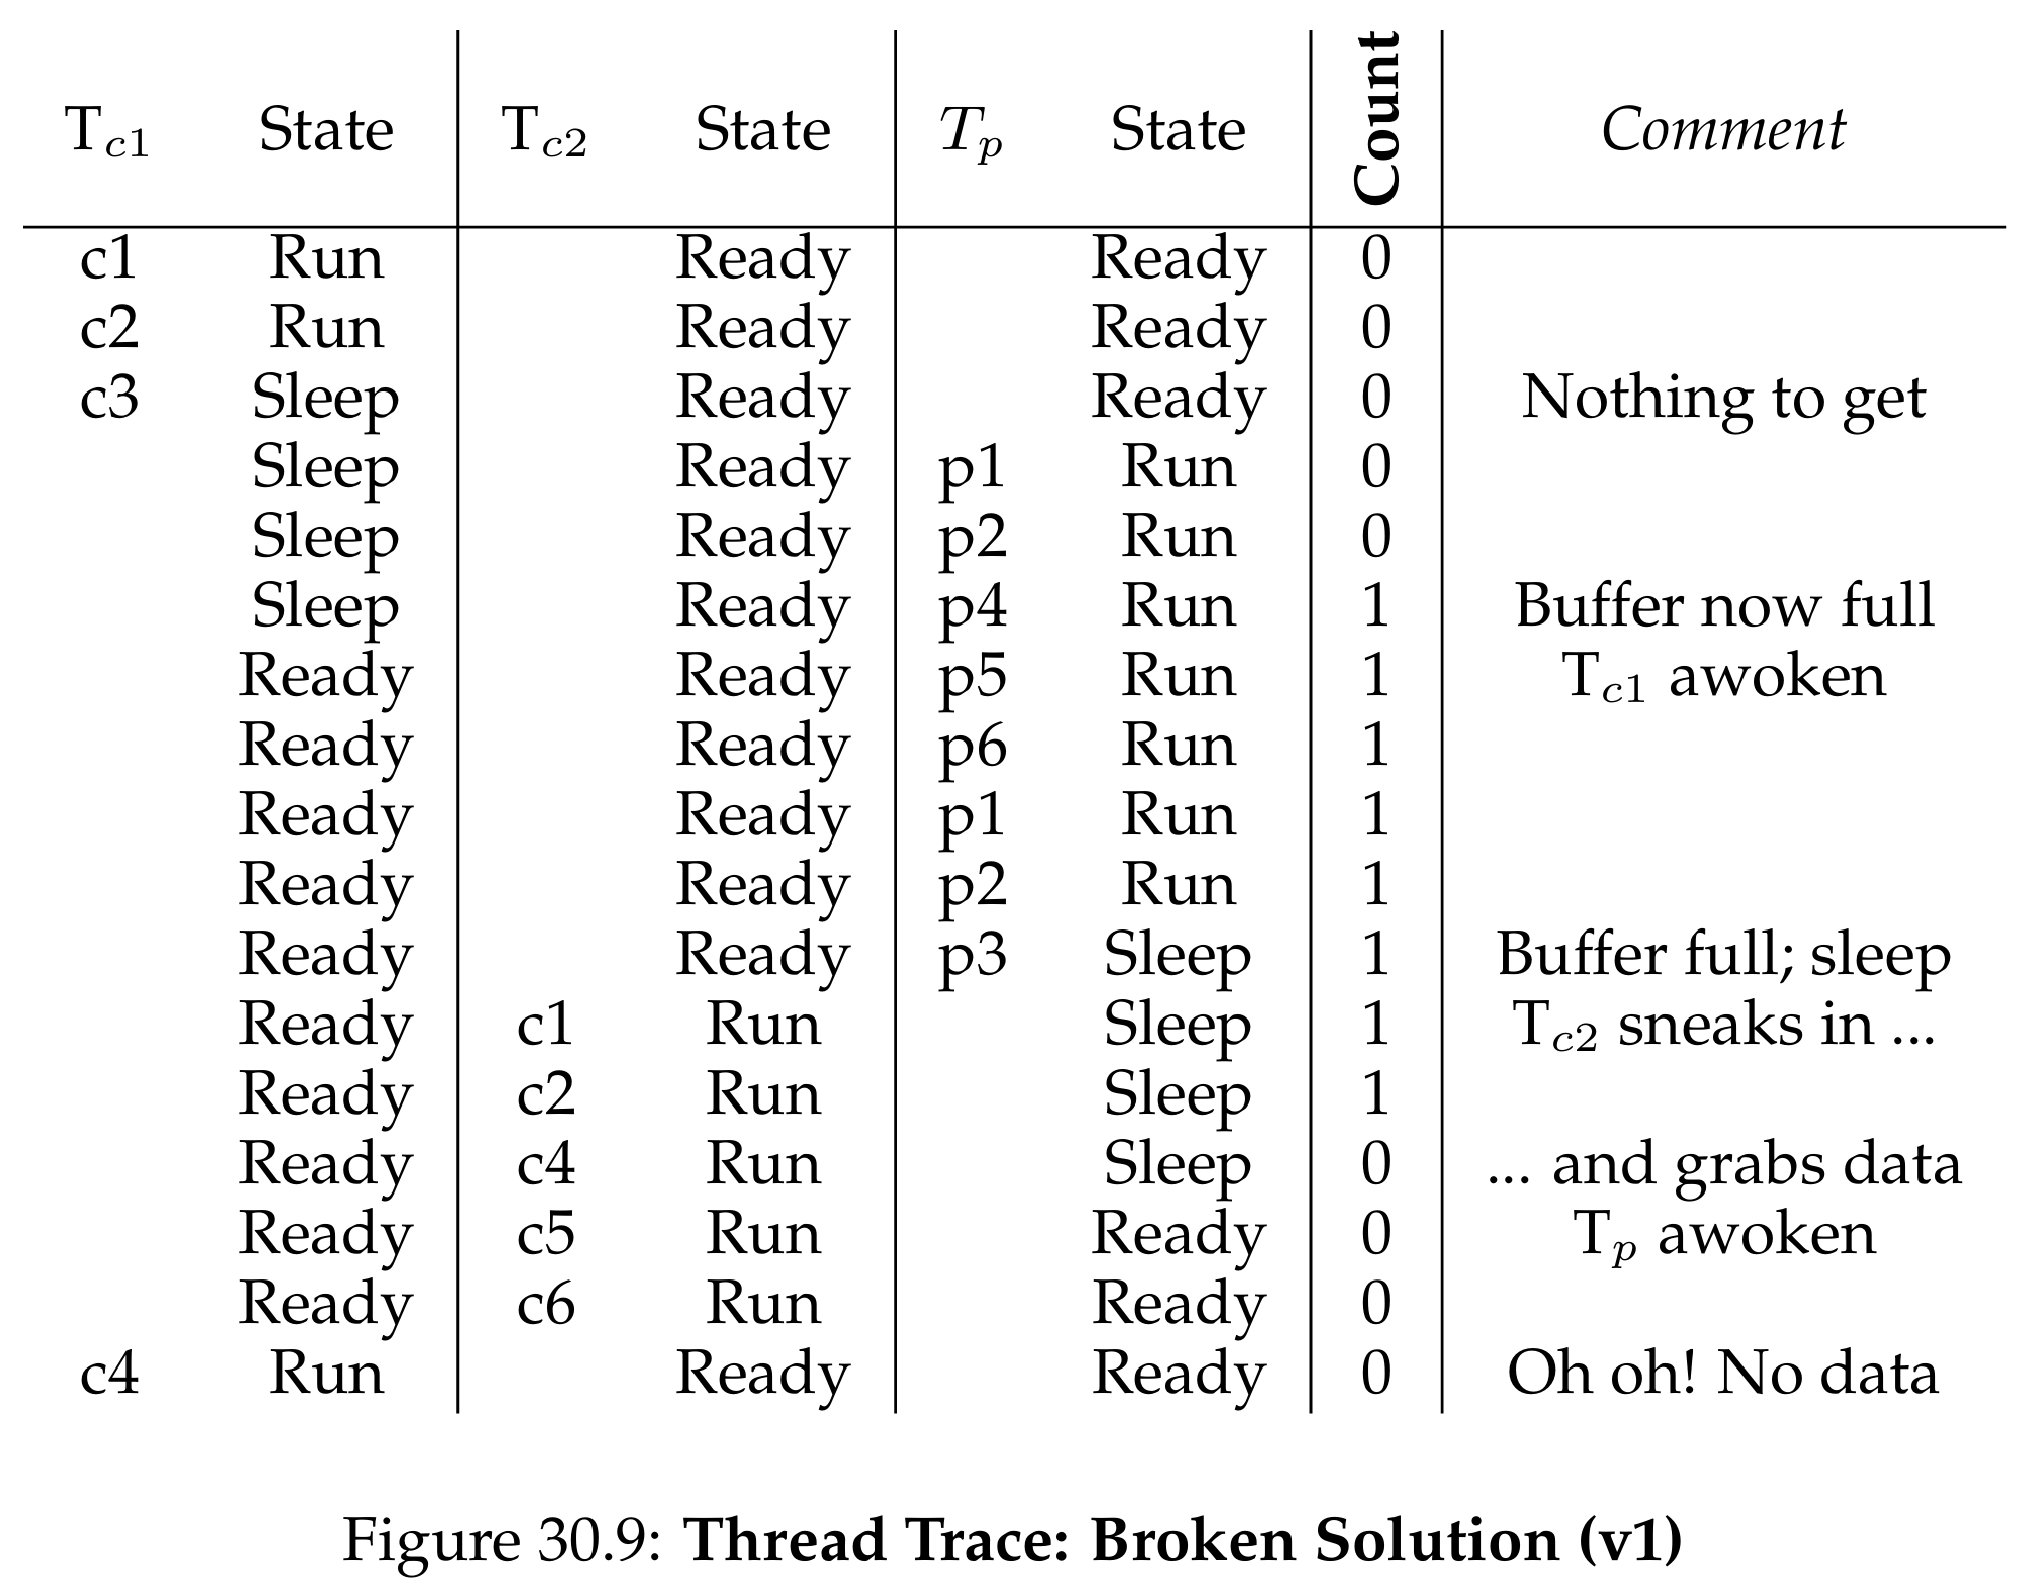
注意到这里消费者二号完成消费操作之后,调度器切换到了消费者一号,而消费者一号在生产者第一次生产的时候就已经被唤醒了,这个时候消费者一号就会执行消费的操作,而缓冲区早已经空了。
所以需要把 if 改成 while 才能避免这种错误消费的情况。但是改成 while 后代码仍然是错误的。
正常情况下,producer 和 consumer 每完成一次操作都会执行一次唤醒操作,这个唤醒操作会唤醒一个线程,这就是这个代码的漏洞所在。假设有两个消费者和一个生产者,在 producer 和其中一个 consumer 同时进入睡眠时,剩下一个 consumer 如果进行了唤醒操作,它有可能唤醒的是 consumer ,然后两个消费者都会睡死过去。
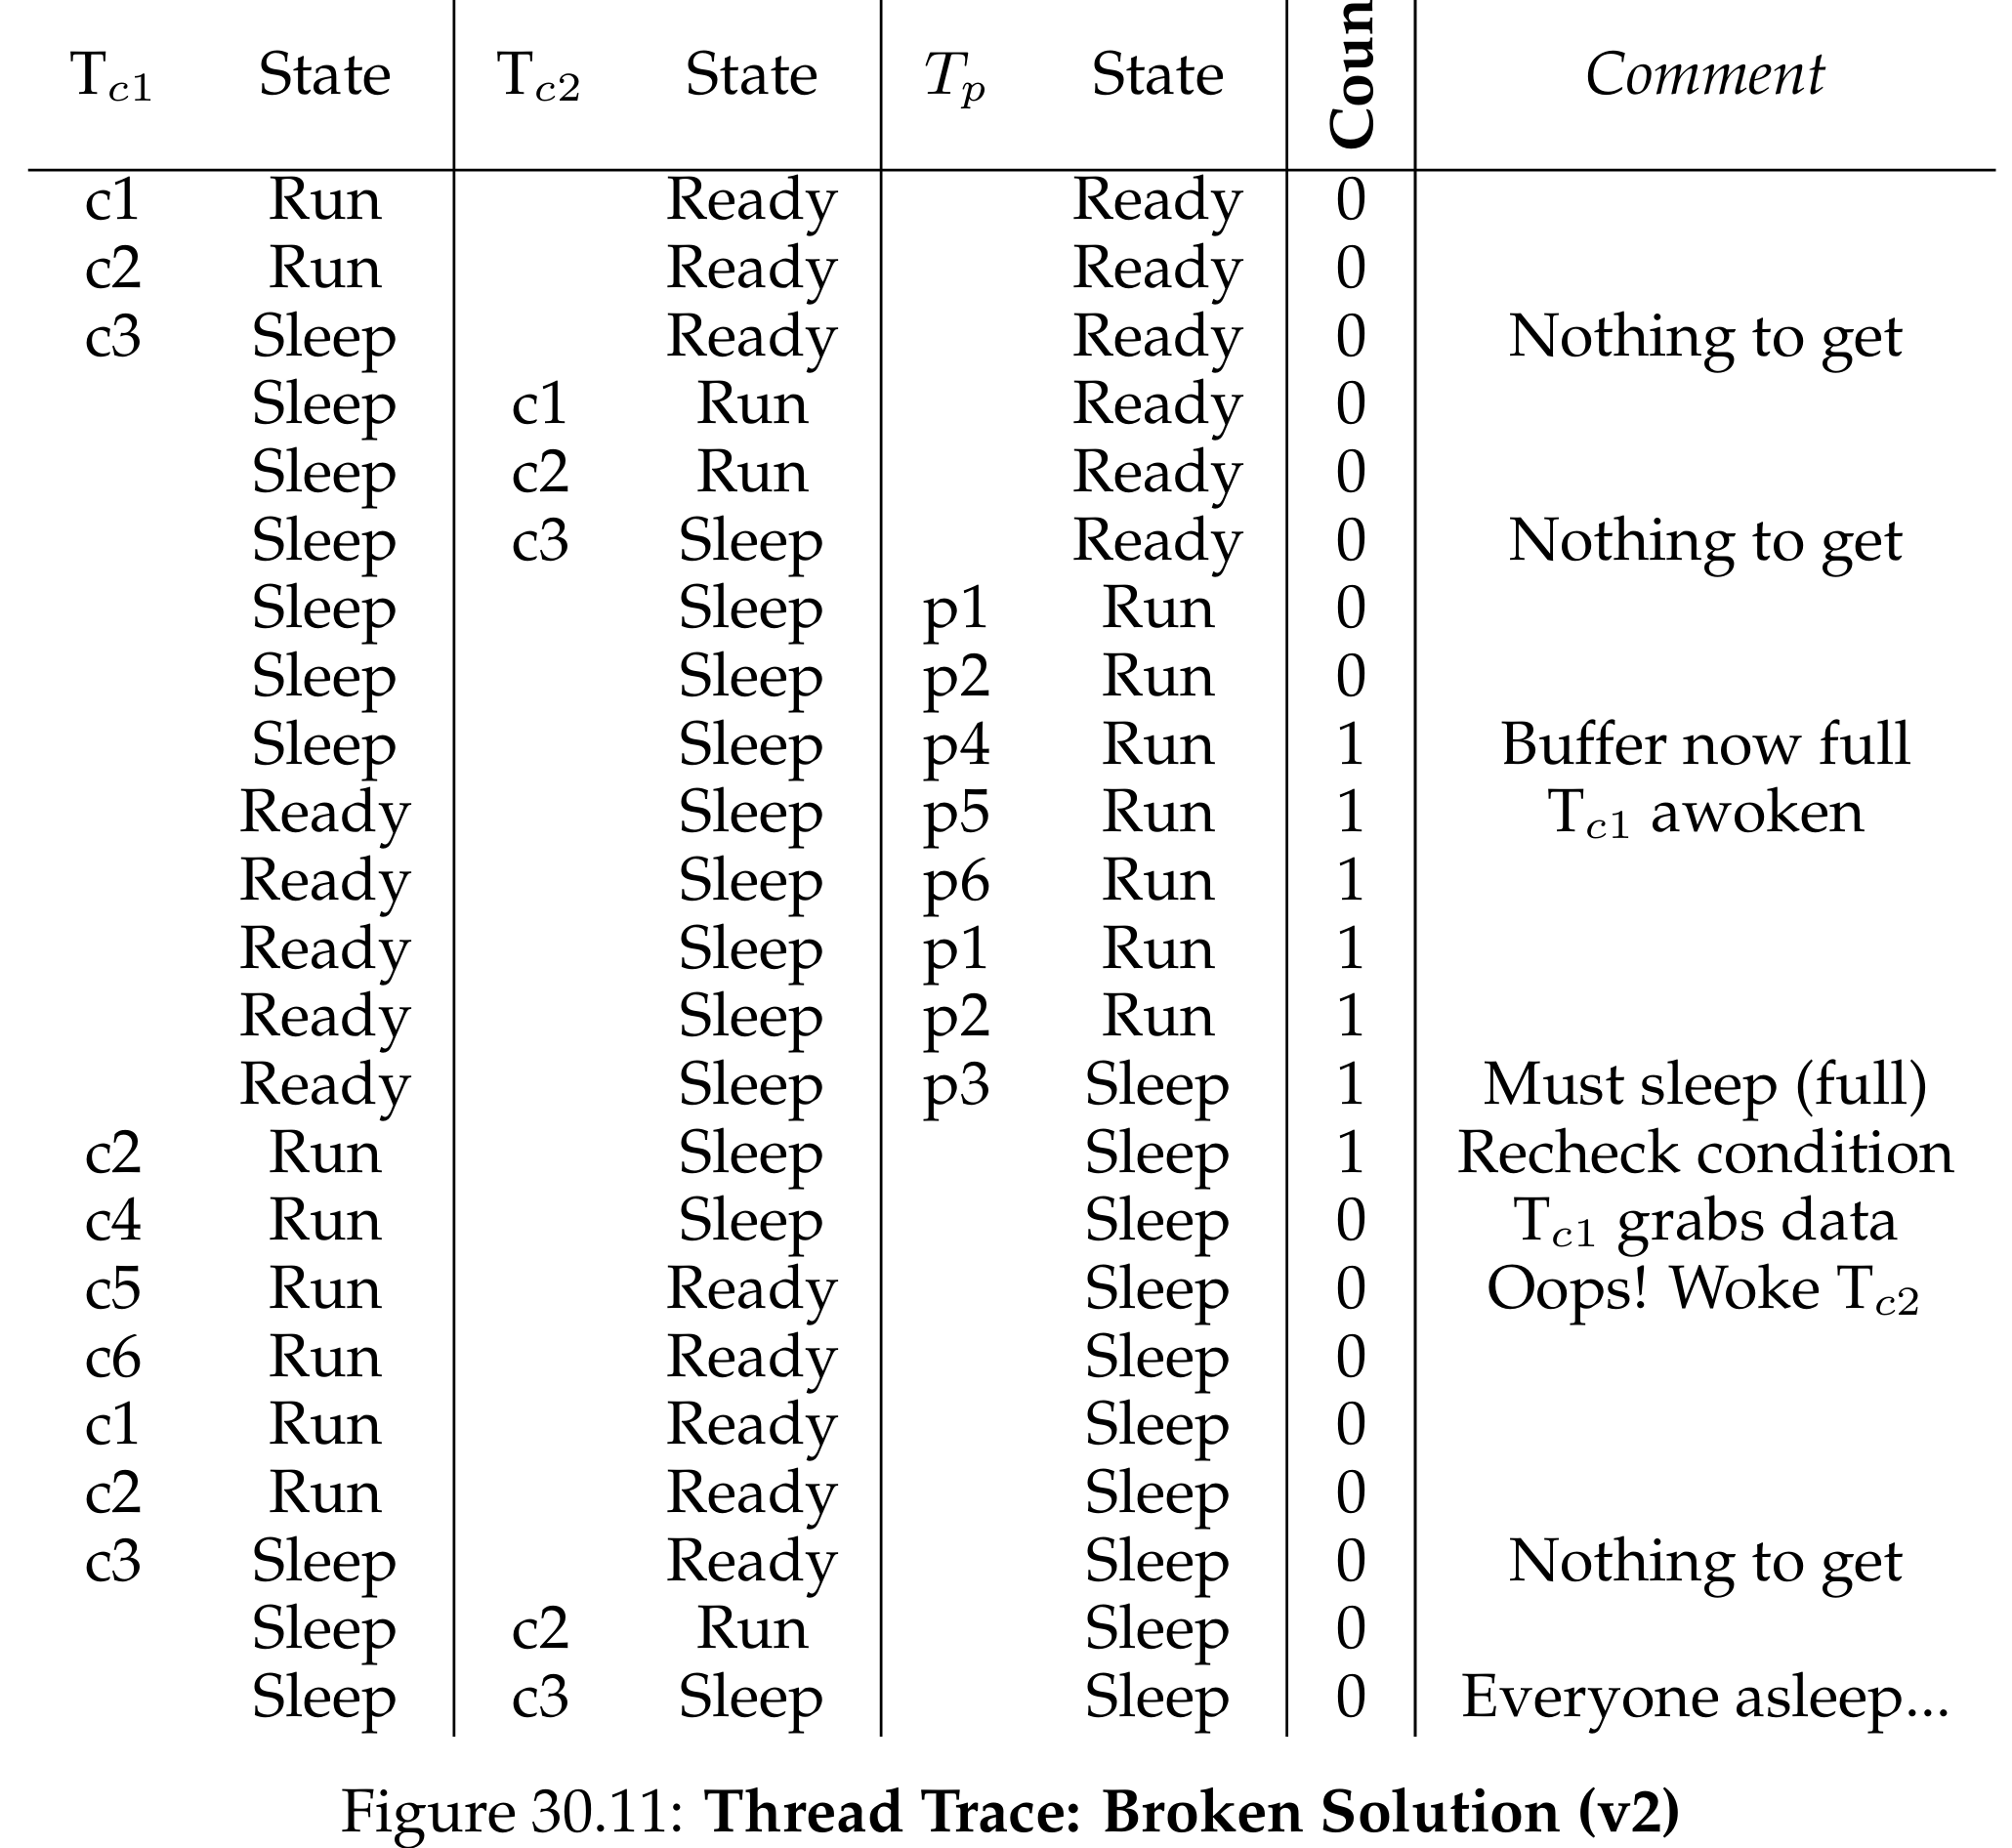
可以看到,消费者一号先被执行,发现缓冲区空之后进入了睡眠,消费者二号也是这样,然后生产者执行生产操作了之后唤醒了其中一个消费者,然后因缓冲区饱和进入了睡眠。消费者一号是被唤醒的那个线程,然后执行了消费之后进入了睡眠,但是唤醒的却是消费者二号,消费者二号发现缓冲区是空的,于是也进入了睡眠,这样三个线程都进入了睡死的状态。
要避免这样的问题,一个最直接的解决方法就是采用两个 CV
cond_t empty, fill;
mutex_t mutex;
void *producer(void *arg) {
    int i;
    for (i = 0; i < loops; i++) {
        Pthread_mutex_lock(&mutex);             // p1
        while (count == 1)                      // p2
            Pthread_cond_wait(&cond, &mutex);   // p3
        put(i);                                 // p4
        Pthread_cond_signal(&cond);             // p5
        Pthread_mutex_unlock(&mutex);           // p6
    }
}
void *consumer(void *arg) {
    int i;
    for (i = 0; i < loops; i++) {
        Pthread_mutex_lock(&mutex);             // c1
        while (count == 0)                      // c2
            Pthread_cond_wait(&cond, &mutex);   // c3
        int tmp = get();                        // c4
        Pthread_cond_signal(&cond);             // c5
        Pthread_mutex_unlock(&mutex);           // c6
        printf("%d\n", tmp);
    }
}
这样消费者每进行一次消费,一定能够保证至少有一个生产者被唤醒,反之同理。
现在扩展缓冲区的大小
int buffer[MAX];
int fill_ptr= 0;
int use_ptr = 0;
int count = 0;
void put(intvalue){
    buffer[fill_ptr]= value;
    fill_ptr= (fill_ptr+ 1)% MAX;
    count++;
}
int get(){
    int tmp= buffer[use_ptr];
    use_ptr= (use_ptr+1)% MAX;
    count--;
    return  tmp;
}
cond_t empty, fill;
mutex_t mutex;
void *producer(void *arg) {
    int i;
    for (i = 0; i < loops; i++) {
        Pthread_mutex_lock(&mutex);             // p1
        while (count == MAX)                    // p2
            Pthread_cond_wait(&cond, &mutex);   // p3
        put(i);                                 // p4
        Pthread_cond_signal(&cond);             // p5
        Pthread_mutex_unlock(&mutex);           // p6
    }
}
void *consumer(void *arg) {
    int i;
    for (i = 0; i < loops; i++) {
        Pthread_mutex_lock(&mutex);             // c1
        while (count == 0)                      // c2
            Pthread_cond_wait(&cond, &mutex);   // c3
        int tmp = get();                        // c4
        Pthread_cond_signal(&cond);             // c5
        Pthread_mutex_unlock(&mutex);           // c6
        printf("%d\n", tmp);
    }
}
上面的操作不仅把缓冲区变大了,而且引入了使用指针和填充指针来分别标记生产的位置和消费的位置,判定条件也发生了更改。
一个线程 signal() 唤醒另一个正在 wait() 的线程后,被唤醒的线程什么时候真正获得 mutex?上面的实现方式属于 Meta semantics
| Mesa semantics | Hoare semantics | |
|---|---|---|
signal() 后 | signaler 继续执行 | waiter 立即执行 |
| waiter 是否立即获得 mutex | 不保证 | 是 |
| waiter 醒来后 | 需要重新检查条件 | 理论上可以直接相信条件 |
| 常见实现 | pthread / Linux 等现代系统 | 较少见 |
由于 signal() 只唤醒一个线程,很可能唤醒的那个线程并不具备执行的条件,而另一个具备条件的线程没有被唤醒,解决的方法是使用 pthread_cond_sigbroadcast() 来唤醒全部相关线程,但是比较浪费性能。这种方法称为 covering condition
信号量:Semaphore
基本操作
信号量相关的基本操作一共是三个,分别对应 POSIX 标准的三个函数
#include <semaphore.h>
int sem_init(sem_t *sem, int pshared, unsigned int value);
int sem_wait(sem_t *sem);       // 也被称为 P(), 源于荷兰语
int sem_post (sem_t *sem);      // 也被称为 V(), 源于荷兰语
历史上,Dijkstra 将 sem_wait() 称为 P(),将 sem_post() 称为 V()。这些缩写形式源自荷兰语;有趣的是,关于它们具体源自哪些荷兰语单词,说法也随时间推移而发生了变化。最初,P() 源自“passering”(通过),V() 源自“vrijgave”(释放);后来,Dijkstra 写道 P() 源自“prolaag”(即“probeer”(荷兰语意为“尝试”)和“verlaag”(意为“减少”) 的缩写),而 V() 则源自“verhoog”(意为“增加”)。
这些函数的含义很简单
int sem_init(sem_t *sem, int pshared, unsigned int value){
    // 将信号量的 value 初始化
    // pshared 参数决定信号量是在进程间共享还是仅限于当前进程的所有线程共享。
    // 当 pshared 的值为0时,信号量将被进程内的线程共享,否则,如果 pshared 是非零值,信号量将在进程之间共享。
}
int sem_wait(sem_t *s) {
    // 将信号量的 value 减一
    // 如果信号量的 value 小于0,wait
}
int sem_post(sem_t *s) {
    // 将信号量的 value 加一
    // 如果有线程正在等待,wake 其中一个
}
用信号量制作锁:Binary Semaphore
用信号量可以构成一个锁,只需要将初始值设定为 1 即可。
sem_t m;
// 0 indicates that the semaphore is shared between threads in the same process
sem_init(&m, 0, 1); // 信号量的 value 初始化为 1

sem_wait(&m);
// critical section here
sem_post(&m);
第一个进行该操作的线程将 value 从1变成了0,然后进入临界区,第二个线程则会将 value 的值变成 -1,然后等待,直到第一个线程将 value 加一,变成0,第二个线程才进入临界区。
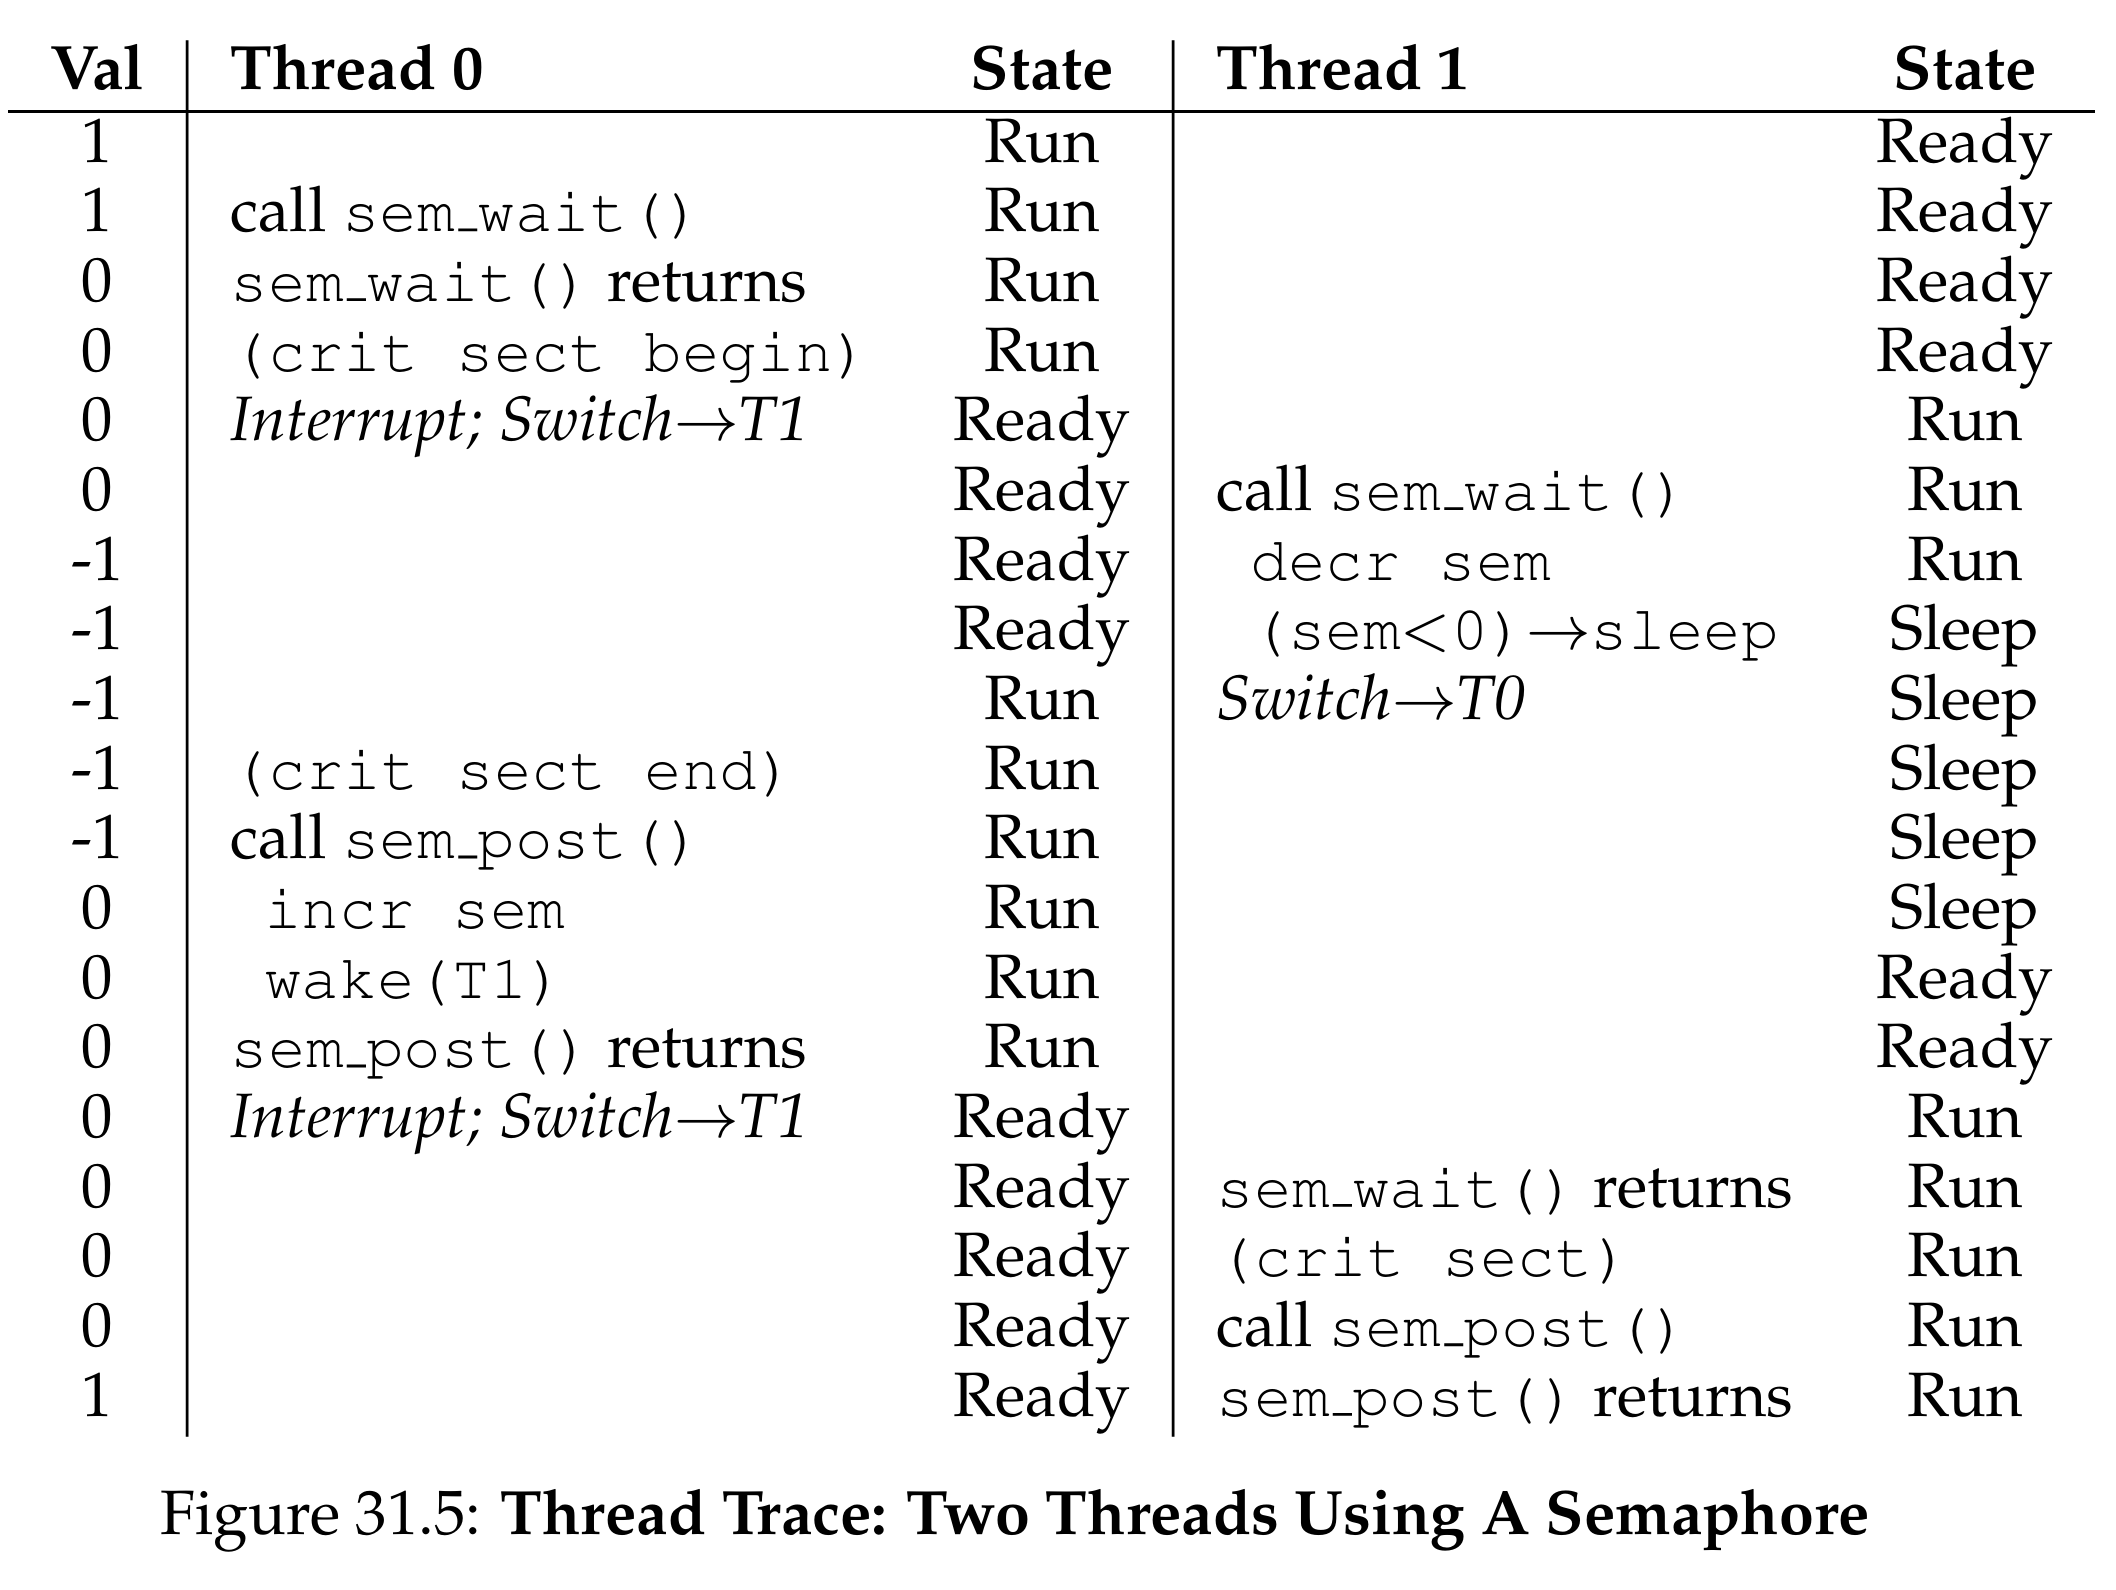
作为锁的信号量称为 Binary Semaphore
用信号量控制执行顺序
sem_t s;
void *child(void *arg) {
    printf("child\n");
    sem_post(&s); // signal here: child is done
    return NULL;
}
int main(int argc, char *argv[]) {
    sem_init(&s, 0, X); // what should X be?
    printf("parent: begin\n");
    pthread_t c;
    Pthread_create(&c, NULL, child, NULL);
    sem_wait(&s); // wait here for child
    printf("parent: end\n");
    return 0;
}
这里将信号量设置为 0 可以起到等待子进程的作用,父进程把信号量从0变成了-1,然后进入睡眠,直到子进程执行完毕后将信号量从-1变成0,父进程恢复。如果反过来,那么子进程会先把信号量从0变成1,父进程把1变成0,不需要进入睡眠,同样可以正常工作。
对于有多个子进程的情况,信号量的初始条件可以改变,让所有子进程都执行 post 之后信号量才变成非负。
用信号量解决生产者消费者问题
int buffer[MAX];
int fill = 0;
int use = 0;
void put(int value){
    buffer[fill] = value;       // Line F1
    fill = (fill + 1) & MAX;    // Line F2
}
int get(){
    int tmp = buffer[use];      // Line G1
    use = (use + 1) : MAX;      // Line G2
    return tmp;
}
sem_t empty;
sem_t full;
void *producer(void *arg) {
    int i;
    for (i = 0; i < loops; i++) {
        sem_wait(&empty);       // Line P1
        put(i);                 // Line P2
        sem_post(&full);        // Line P3
    }
}
void *consumer(void *arg) {
    int tmp = 0;
    while (tmp !=-1) {
        sem_wait(&full);        // Line C1
        tmp = get();            // Line C2
        sem_post(&empty);       // Line C3
        printf("%d\n", tmp);
    }
}
int main(int argc, char *argv[]) {
    // ...
    sem_init(&empty, 0, MAX); // MAX are empty
    sem_init(&full, 0, 0);
    // 0 are full
    // ...
}
上面是一个初步想法,full 的数值代表了已占用的缓冲区槽数,empty 则是未占用的槽数。消费者消费之前要先取一个已占用的缓冲区槽数,完成之后产生一个未占用的槽,生产者反之。
但是这个代码有一个问题,没有对缓冲区进行保护,可能会有多个消费者同时执行 get() 或者多个生产者同时执行 put() 这无疑会产生错误。所以需要添加锁
sem_t empty;
sem_t full;
sem_t mutex;
void *producer(void *arg) {
    int i;
    for (i = 0; i < loops; i++) {
        sem_wait(&mutex);       // Line P0
        sem_wait(&empty);       // Line P1
        put(i);                 // Line P2
        sem_post(&full);        // Line P3
        sem_post(&mutex);       // Line P4
    }
}
void *consumer(void *arg) {
    int tmp = 0;
    while (tmp !=-1) {
        sem_wait(&mutex);       // Line C0
        sem_wait(&full);        // Line C1
        tmp = get();            // Line C2
        sem_post(&empty);       // Line C3
        sem_post(&mutex);       // Line C4
        printf("%d\n", tmp);
    }
}
int main(int argc, char *argv[]) {
    // ...
    sem_init(&mutex, 0, 1);
    sem_init(&empty, 0, MAX); // MAX are empty
    sem_init(&full, 0, 0);
    // 0 are full
    // ...
}
但这还是错误的代码,假设缓冲区已满,那么 producer 会先后执行 wait(mutex), wait(empty) ,然后睡眠,这个时候消费者无法获取锁,同样也会进入睡眠。因此 mutex 的获取和释放必须更加靠近临界区。修改后如下:
void *producer(void *arg) {
    int i;
    for (i = 0; i < loops; i++) {
        sem_wait(&empty);       // Line P1
        sem_wait(&mutex);       // Line P1.5
        put(i);                 // Line P2
        sem_post(&mutex);       // Line P2.5
        sem_post(&full);        // Line P3
    }
}
void *consumer(void *arg) {
    int tmp = 0;
    while (tmp !=-1) {
        sem_wait(&full);        // Line C1
        sem_wait(&mutex);       // Line C1.5
        tmp = get();            // Line C2
        sem_post(&mutex);       // Line C2.5
        sem_post(&empty);       // Line C3
        printf("%d\n", tmp);
    }
}
用信号量实现读写锁:Reader-Writer Lock
考虑一份数据,有许多线程需要读取,但是不需要修改,这个时候如果还是限制一个时刻只能一个线程进行读取除了降低效率没有别的好处。
读写锁允许多个线程进行读取,或者允许单独一个线程进行修改操作。
typedef struct _rwlock_t {
    sem_t lock;         // binary semaphore (basic lock)
    sem_t writelock;    // allow ONE writer/MANY readers
    int readers;        // #readers in critical section
} rwlock_t;
void rwlock_init(rwlock_t *rw) {
    rw->readers = 0;
    sem_init(&rw->lock, 0, 1);
    sem_init(&rw->writelock, 0, 1);
}
void rwlock_acquire_readlock(rwlock_t *rw) {
    sem_wait(&rw->lock);
    rw->readers++;
    if (rw->readers == 1) // first reader gets writelock
    sem_wait(&rw->writelock);
    sem_post(&rw->lock);
}
void rwlock_release_readlock(rwlock_t *rw) {
    sem_wait(&rw->lock);
    rw->readers--;
    if (rw->readers == 0) // last reader lets it go
    sem_post(&rw->writelock);
    sem_post(&rw->lock);
}
void rwlock_acquire_writelock(rwlock_t *rw) {
    sem_wait(&rw->writelock);
}
void rwlock_release_writelock(rwlock_t *rw) {
    sem_post(&rw->writelock);
}
实现思路大致是让第一个读进程或者写进程等待 writelock,直到读进程个数为 0 或者写进程完成时释放 writelock
这里会有一个饿死的问题,如果中途不断有读进程加入,那么写进程无法获得锁,这也是课后作业需要解决的一部分,完成后的代码如下
#include "common_threads.h" // OSTEP 提供的包装过的函数
typedef struct __rwlock_t {
    int reader_count;
    sem_t mutex;    // protect reader_count
    sem_t writelock;
    sem_t turnstile;
} rwlock_t;


void rwlock_init(rwlock_t *rw) {
    rw->reader_count = 0;
    Sem_init(&rw->mutex, 1);
    Sem_init(&rw->writelock, 1);
    Sem_init(&rw->turnstile, 1);
}

void rwlock_acquire_readlock(rwlock_t *rw) {
    Sem_wait(&rw->turnstile);
    Sem_post(&rw->turnstile);
    Sem_wait(&rw->mutex);
    if (rw->reader_count==0)
    Sem_wait(&rw->writelock);
    rw->reader_count++;
    Sem_post(&rw->mutex);
}

void rwlock_release_readlock(rwlock_t *rw) {
    Sem_wait(&rw->mutex);
    if (rw->reader_count==1)
    Sem_post(&rw->writelock);
    rw->reader_count--;
    Sem_post(&rw->mutex);
}

void rwlock_acquire_writelock(rwlock_t *rw) {
    Sem_wait(&rw->turnstile);
    Sem_wait(&rw->writelock);
}

void rwlock_release_writelock(rwlock_t *rw) {
    Sem_post(&rw->turnstile);
    Sem_post(&rw->writelock);
}
除了用来保护 reader 计数的锁之外,还添加了一个闸门,获取读锁时需要先获得 turnstile 然后释放,而获取和释放写锁时需要全程占用 turnstile,这样如果有写进程正在等待,那么新来的读进程都必须排在写进程后面,这样就避免了写进程被饿死的问题。
哲学家进餐问题
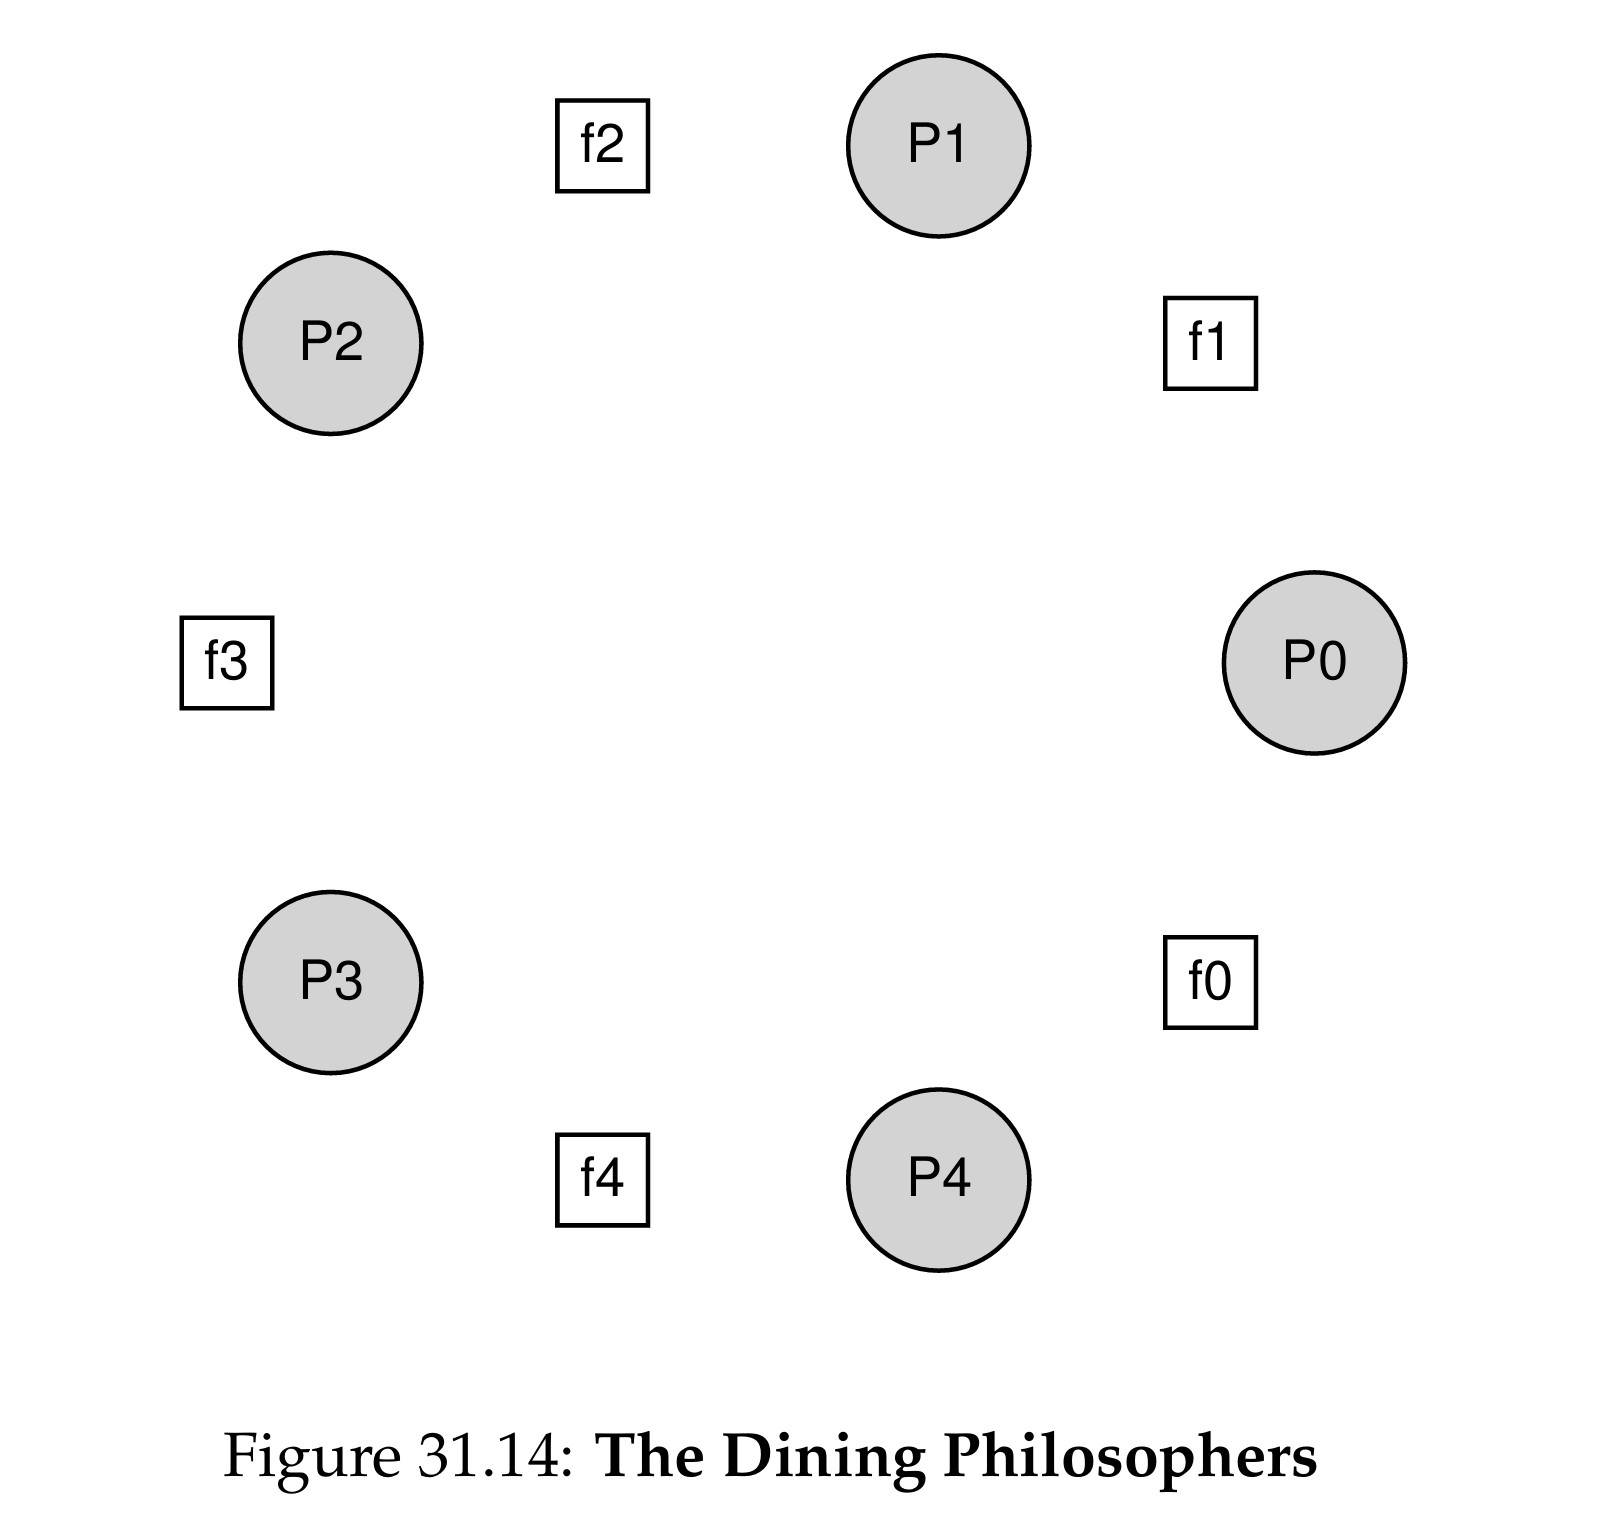
假设有5个哲学家在圆桌上就餐,每个哲学家旁边都有两个叉子,一共5个叉子。每个哲学家进行思考,需要持有左右两个叉子,而一个叉子只能同时被一个人持有,或者进行思考,这个时候不需要持有叉子。那么哲学家应该采取什么样的策略才能保证正常就餐?
while(1){
    think();
    get_forks(p);
    eat();
    put_forks(p);
}
每个哲学家的行为都可以抽象成上面的循环代码,问题是如何实现 get_forks() 和 put_forks()
一个错误的解决方法是所有哲学家统一先拿左手的叉子,再拿右手的叉子,这样会形成死锁
void get_forks(int p) {
    sem_wait(&forks[left(p)]);
    sem_wait(&forks[right(p)]);
}
void put_forks(int p) {
    sem_post(&forks[left(p)]);
    sem_post(&forks[right(p)]);
}
而正确的解法是,让某个哲学家先拿右手的叉子,再拿左手的叉子,其他哲学家还是先拿左手的叉子,再拿右手的叉子。
void get_forks(int p) {
    if (p == 4) {
        sem_wait(&forks[right(p)]);
        sem_wait(&forks[left(p)]);
    } else {
        sem_wait(&forks[left(p)]);
        sem_wait(&forks[right(p)]);
    }
}
这样同一时刻至少有一个哲学家能进餐:在一开始的时候这个先拿右手叉子的哲学家或者它左手边的哲学家能进餐,进餐完成之后,哲学家左手边的哲学家又可以进餐。
一种 OSTEP 上没提到的解法是 Chandy-Misra,初始时叉子分配情况如下
F0(P0,P1) → P0
F1(P1,P2) → P1
F2(P2,P3) → P2
F3(P3,P4) → P3
F4(P4,P0) → P0
每个叉子都有两种状态,dirty 或者 clean,初始时都是 ditry。当哲学家向旁边的已经吃完饭的哲学家请求叉子时,如果叉子是 dirty,把叉子设置成 clean 之后交出,进餐时叉子状态变成 dirty;如果叉子是 clean,不交出。这样,在初始条件不形成环的前提下,总会有哲学家能进餐,并且最大并发度也可以达到2.
实现线程节流:Thread Throttling
代码中可能存在这样的部分,每一个线程都需要分配一大部分内存进行计算,总的内存申请量可能超过物理内存大小,产生 swap,导致运行变显著变慢。一个做法就是用信号量来控制最大进入这块区域的线程,避免同时出现过量的内存分配请求。
实现信号量
OSTEP 展示了一种方法,只用一个锁和一个条件变量实现信号量,这种版本称为 Zemaphores
typedef struct __Zem_t {
int value;
pthread_cond_t cond;
pthread_mutex_t lock;
} Zem_t;
// only one thread can call this
void Zem_init(Zem_t *s, int value) {
    s->value = value;
    Cond_init(&s->cond);
    Mutex_init(&s->lock);
}
void Zem_wait(Zem_t *s) {
    Mutex_lock(&s->lock);
    while (s->value <= 0)
    Cond_wait(&s->cond, &s->lock);
    s->value--;
    Mutex_unlock(&s->lock);
}
void Zem_post(Zem_t *s) {
    Mutex_lock(&s->lock);
    s->value++;
    Cond_signal(&s->cond);
    Mutex_unlock(&s->lock);
}
大致思路是用一个锁来保护信号量的值,用一个CV来实现睡眠和唤醒。
用信号量设计不会饿死的互斥锁
这是课后作业的一部分,信号量唤醒的线程并不是确定的,考虑某个线程正在等待锁释放,在此期间可能会来了很多新的线程进行等待,这个时候这个线程被唤醒的概率就会大大下降,很可能会出现随着线程不断到来,而该线程可能常常不被唤醒,发生饿死的情况。
一个很自然的想法就是划分区域,等待的线程数量超过某个数量之后,把新来的线程隔离在外面,等待里面的线程使用完资源再进入到这个区域中。
#define BATCH_SIZE 5
typedef struct __ns_mutex_t
{
    sem_t resource_lock;
    sem_t queue_lock;
    sem_t count_lock;
    int full_flag;
    int count;
} ns_mutex_t;

void ns_mutex_init(ns_mutex_t *m) {
    Sem_init(&m->resource_lock, 1);
    Sem_init(&m->queue_lock, 1);
    Sem_init(&m->count_lock, 1);
    m->count = 0;
    m->full_flag = 0;
}

void ns_mutex_acquire(ns_mutex_t *m) {
    Sem_wait(&m->queue_lock);
    Sem_wait(&m->count_lock);
    m->count++;
    if (m->count < BATCH_SIZE) {
        Sem_post(&m->queue_lock);
    } else {
        m->full_flag = 1;   // 不释放 queue lock,后来的进程都会卡在 queue lock 获取上
        printf("Queue Full!\n");
    }
    Sem_post(&m->count_lock);
    Sem_wait(&m->resource_lock);
}
void ns_mutex_release(ns_mutex_t *m){
    Sem_wait(&m->count_lock);
    m->count--;
    if (m->count == 0 && m->full_flag) {
        Sem_post(&m->queue_lock);
        m->full_flag = 0;
    }
    Sem_post(&m->resource_lock);
    Sem_post(&m->count_lock);
}
但是当大量线程并发请求锁时,还是难以避免部分锁在队列外面一直无法进入。
官方思路是 Morris no-starve mutex 算法,当出现并发的请求时,把当前请求的所有的线程都转移到 room1,然后关门,暂时不接受新的线程,接下来把放进来的线程转移到新的一片区域room2,挨个获得资源。
semaphore mutex = 1
semaphore t1 = 1
semaphore t2 = 0

int room1 = 0
int room2 = 0

acquire(){
    wait(mutex) // 直接进入 room1
    room1++
    signal(mutex)

    wait(t1)    // 尝试进入 room2
    room2++
    wait(mutex)
        room1-- // 转移到 room2
        if room1 == 0
            signal(mutex)
            signal(t2)  // room1 已经空了,临界区开一个口
        else
            signal(mutex)
            signal(t1)  // 继续放行 room1 的线程进入 room2
    wait(t2)            // 尝试进入临界区
    room2--
}

release(){
    if room2 == 0
        signal(t1)  // room2 空了,room2 放一个线程进来
    else
        signal(t2)  // room2 不是空的,临界区放一个线程进来
}
并发产生的问题
并发问题可以简单分成死锁问题和非死锁问题
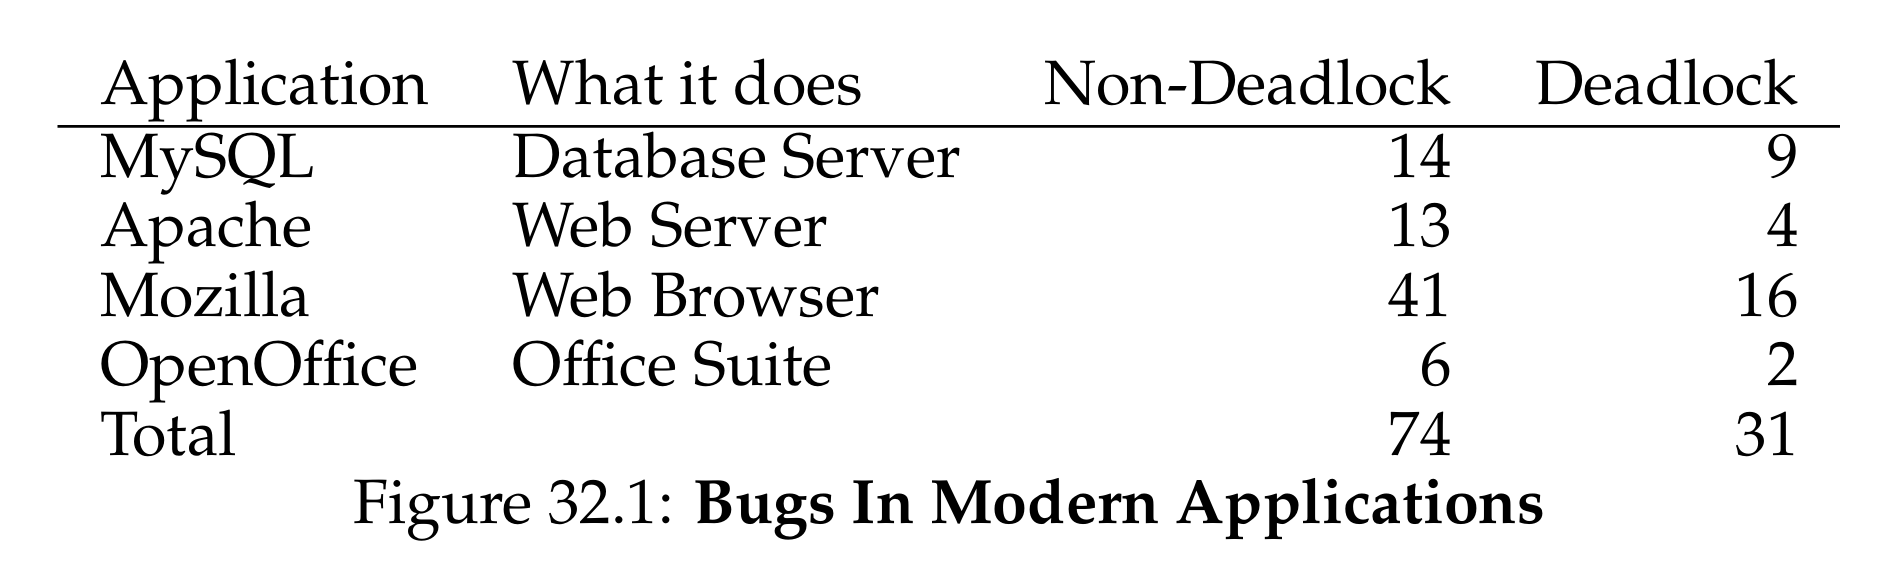
非死锁问题
非死锁问题的两个主要类别是 atomicity violation bugs 和 order violation bugs
Atomicity Violation Bugs
Thread 1::
if (thd->proc_info) {
    fputs(thd->proc_info, ...);
}

Thread 2::
thd->proc_info = NULL;
上面的代码中,两个线程都尝试访问 thd,但是 thd 没有锁保护,可能会出现 if 执行完成之后,CPU切换到线程2将 proc_info 释放,然后切回线程1执行 fputs 发生崩溃。这类代码本来应该是原子的,但是却没有加锁,属于 atomicity violation
修复之后代码如下
pthread_mutex_t proc_info_lock = PTHREAD_MUTEX_INITIALIZER;
Thread 1::
pthread_mutex_lock(&proc_info_lock);
if (thd->proc_info) {
    fputs(thd->proc_info, ...);
}
pthread_mutex_unlock(&proc_info_lock);

Thread 2::
pthread_mutex_lock(&proc_info_lock);
thd->proc_info = NULL;
pthread_mutex_unlock(&proc_info_lock);
Order Violation Bugs
Thread 1::
void init() {
    mThread = PR_CreateThread(mMain, ...);
}
Thread 2::
void mMain(...) {
    mState = mThread->State;
}
上面的代码中,init() 必须在 mMain() 之前执行完成,否则 mState 无法正确执行。修改代码如下:
pthread_mutex_t mtLock  = PTHREAD_MUTEX_INITIALIZER;
pthread_cond_t mtCond   = PTHREAD_COND_INITIALIZER;
int mtInit              = 0;
Thread 1::
void init() {
    ...
    mThread = PR_CreateThread(mMain, ...);
    // signal that the thread has been created...
    pthread_mutex_lock(&mtLock);
    mtInit = 1;
    pthread_cond_signal(&mtCond);
    pthread_mutex_unlock(&mtLock);
    ...
}
Thread 2::
void mMain(...) {
    ...
    // wait for the thread to be initialized...
    pthread_mutex_lock(&mtLock);
    while (mtInit == 0)
        pthread_cond_wait(&mtCond, &mtLock);
    pthread_mutex_unlock(&mtLock);
    mState = mThread->State;
...
}
死锁问题
一个线程拿到了锁1,等待锁2,但是另一个线程拿到了锁2,正在等待锁1释放,两个线程都不释放锁,这种情况称为死锁(Deadlock)。
Thread 1:
pthread_mutex_lock(L1);
pthread_mutex_lock(L2);

Thread 2:
pthread_mutex_lock(L2);
pthread_mutex_lock(L1);
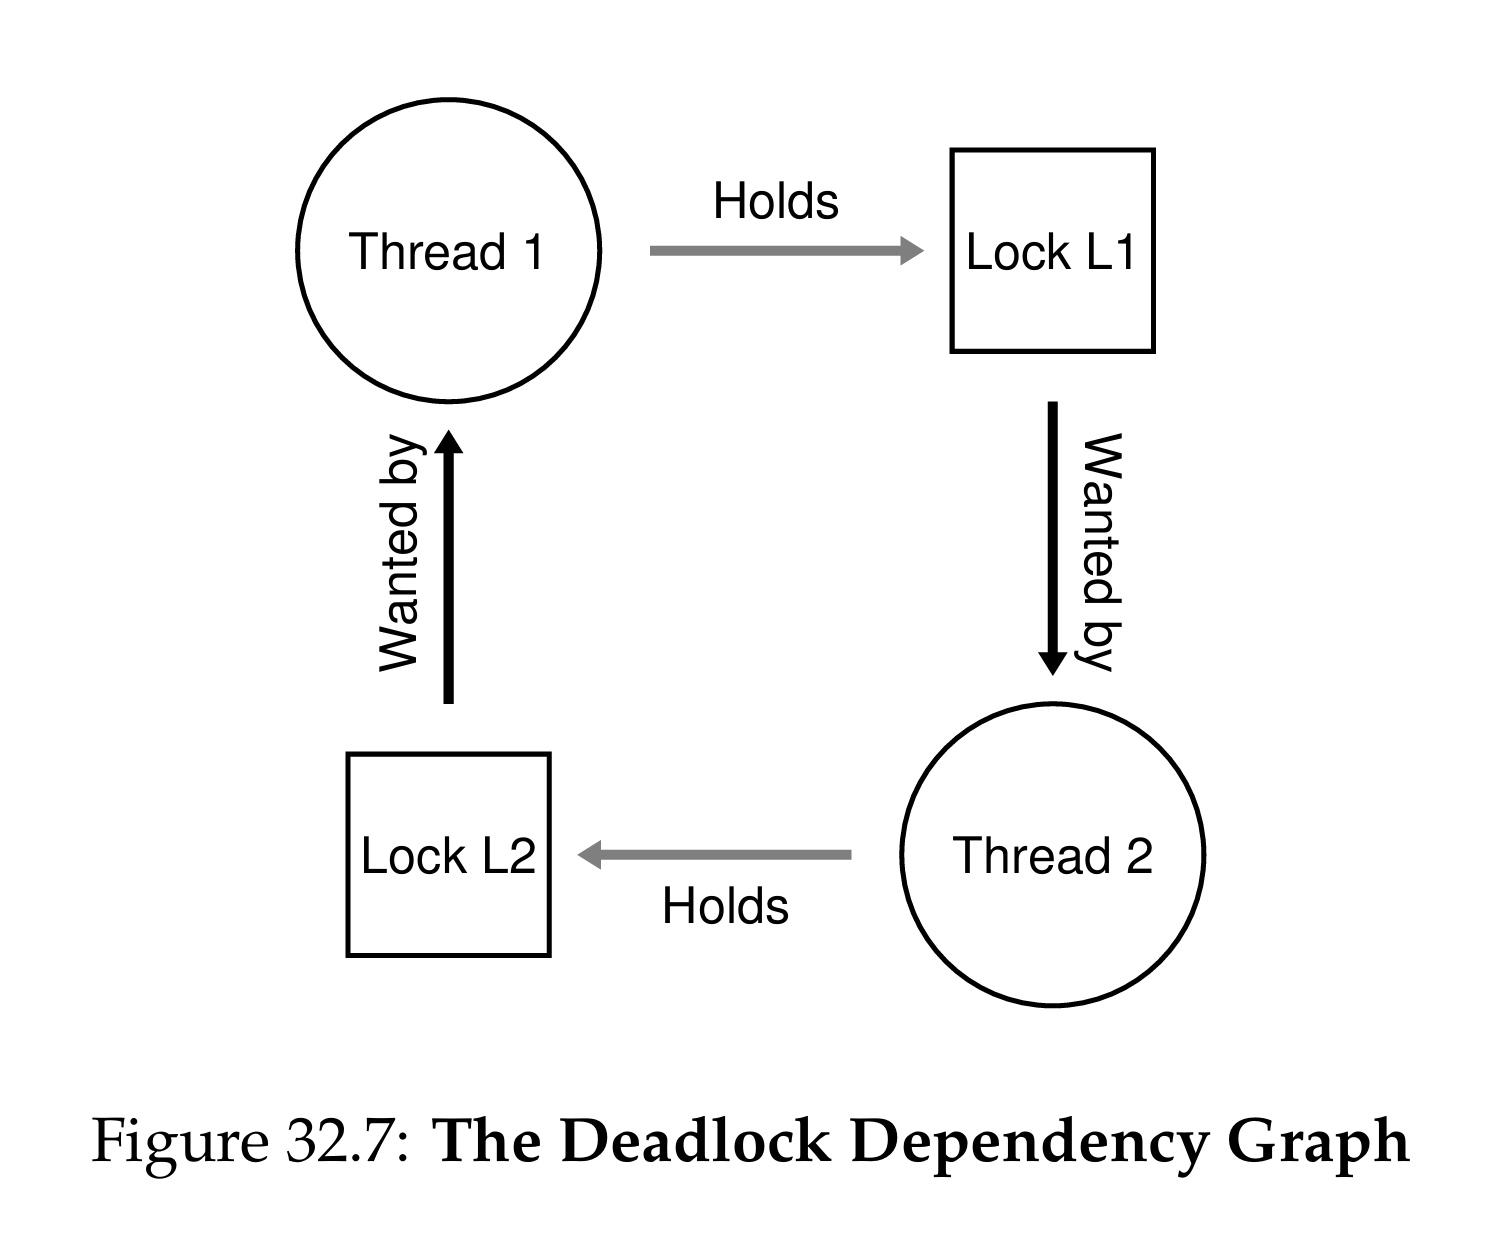
OSTEP 提到了死锁的两种来源,一种是复杂的依赖关系,比如操作系统需要按一定顺序访问资源,在这个过程中会获得各种锁,而锁的获取顺序不同可能引发死锁,而另一种是封装,虽然调用接口的时候看起来很正常,但是实际上函数内部可能会引发死锁。
Thread 1:
vector_add(&v[0], &v[1]);

Thread 2:
vector_add(&v[1], &v[0]);
虽然这里看起来只是正常调用函数,但是这个函数内部可能是这样的。
void vector_add(vector_t *v_dst, vector_t *v_src) {
    Pthread_mutex_lock(&v_dst->lock);
    Pthread_mutex_lock(&v_src->lock);
    int i;
    for (i = 0; i < VECTOR_SIZE; i++)
        v_dst->values[i] = v_dst->values[i] + v_src->values[i];
    Pthread_mutex_unlock(&v_dst->lock);
    Pthread_mutex_unlock(&v_src->lock);
}
为了操作的原子性,函数内部可能会用锁来保护资源,而这就带来了死锁的可能。上面的代码中锁的获取顺序不同,因此可能造成死锁。
如何预防死锁
死锁形成的四个条件如下
- 互斥:锁同时只能被一个线程持有
- 持有并等待:锁被持有时,线程只能进行等待
- 非抢占式:锁等资源被持有时,不能被强制夺走
- 循环等待:存在一个环形等待链条
只有四个条件同时满足,死锁才会发生,因此可以针对四个条件进行预防
Circular Wait
为了避免环形等待链条的形成,一个解决方法是提供一个全序的锁获取顺序 (total ordering)。所有锁之间都规定一个全局的先后顺序,比如锁1永远先于锁2获取。但是这样难以实现并且有时候也没有必要,所以有了偏序 partial ording ,将锁获取顺序分成组,比如 i_mutex 先于 i_mmap_rwsen, i_mmap_rwsen 先于 private_lock 先于 swap_lock 等,只规定有依赖关系的锁之间的顺序。
Hold-and-Wait
这个问题可以通过一次性提前获取锁并且原子化锁的获取来解决
pthread_mutex_lock(prevention); // begin acquisition
pthread_mutex_lock(L1);
pthread_mutex_lock(L2);
...
pthread_mutex_unlock(prevention); // end
这样就可以避免获取 L1 之后切换到其他线程获取了 L2 ,从而发生死锁的可能。但是这个解决方法不仅需要知道哪些锁需要提前获取,而且还会降低并发度。
No Preemption
当线程1获取锁1之后,线程2获取了锁2,此时线程1,线程2互相等待对方释放锁,如果有什么机制能够避免这种互相等待就能解决死锁。
top:
    pthread_mutex_lock(L1);
    if (pthread_mutex_trylock(L2) != 0) {
        pthread_mutex_unlock(L1);
        goto top;
    }
上面的代码中,如果无法获取锁2,那么就会释放锁1,然后从头开始,这样,总有一个时候线程2可以获取锁2然后获取锁1.
但是这带来了一个新的问题,线程可能会反复的获取和释放锁,浪费资源,称之为活锁(livelock),解决方法是在释放锁和重新获取锁之间添加一个随机延迟。
如果涉及到资源的获取和释放,这种做法会变得更加复杂
lock(L1);
do_something();

if (trylock(L2)失败) {
    // 撤销 do_something() 的影响
    // 释放所有资源
    // 回到起点
}
Mutual Exclusion
怎么样不使用互斥锁并且又能保证临界区能够正常运行?一个想法是使用硬件支持
先前提到了一个原子指令的逻辑如下
int CompareAndSwap(int *address, int expected, int new) {
    if (*address == expected) {
        *address = new;
        return 1; // success
    }
    return 0; // failure
}
这个指令可以用来实现下面的操作
void AtomicIncrement(int *value, int amount) {
    do {
        int old = *value;
    } while (CompareAndSwap(value, old, old + amount) == 0)
        ;
}
这样就可以在不借助互斥锁的情况下完成加法操作,避免了前面提到的死锁、活锁等一系列问题。
void insert(int value) {
    node_t *n = malloc(sizeof(node_t));
    assert(n != NULL);
    n->value = value;
    pthread_mutex_lock(listlock); // begin critical section
    n->next = head;
    head = n;
    pthread_mutex_unlock(listlock); // end critical section
}
上面是链表操作的传统做法,而使用原子指令可以变成下面的样子
void insert(int value) {
    node_t *n = malloc(sizeof(node_t));
    assert(n != NULL);
    n->value = value;
    do {
        n->next = head;
    } while (CompareAndSwap(&head, n->next, n) == 0);
}
通过调度预防死锁
考虑有四个线程和两个锁,它们的持有情况如下
| T1 | T2 | T3 | T4 | |
|---|---|---|---|---|
| L1 | yes | yes | no | no |
| L2 | yes | yes | yes | no |
只要能够避免T1和T2不同时进行,就可以避免死锁问题。
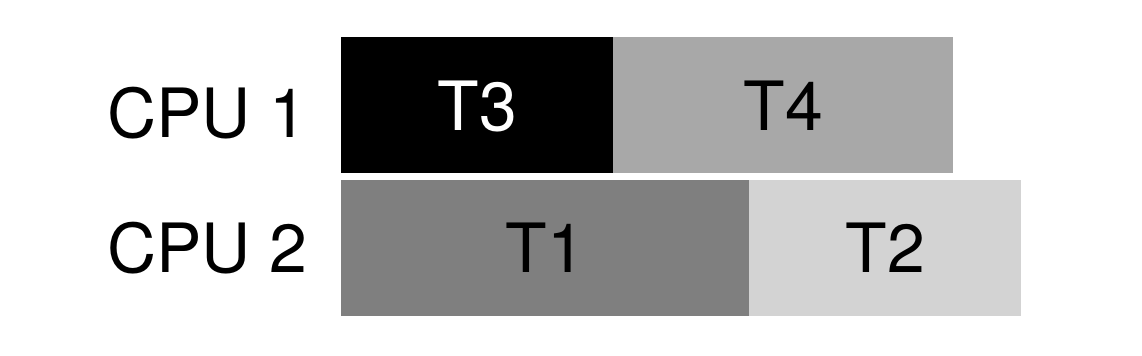
换一种情况,T3也持有两个锁了:
| T1 | T2 | T3 | T4 | |
|---|---|---|---|---|
| L1 | yes | yes | yes | no |
| L2 | yes | yes | yes | no |
这样可以把T1,T2,T3都放到同一个CPU上避免同时执行:
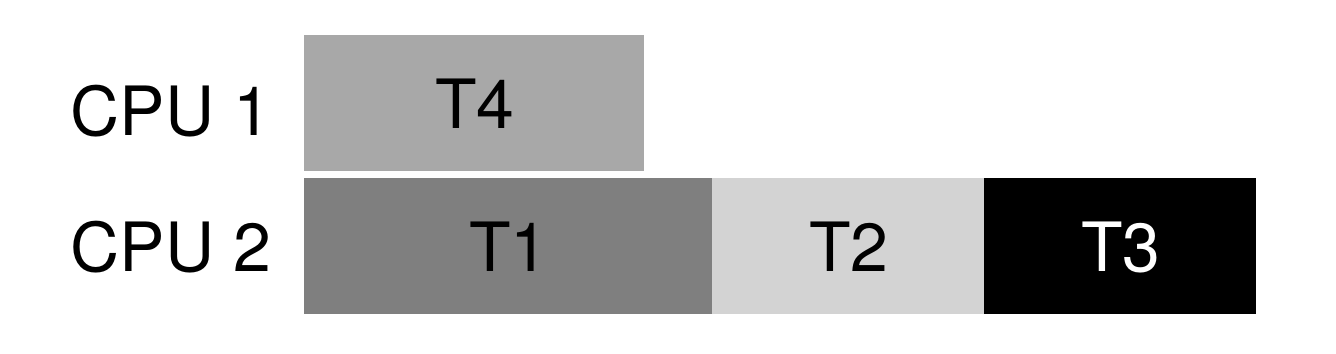
这么做的代价很显然是性能。
银行家算法
Dijkstra 的银行家算法是上面思路的一个实际例子,把线程想象成“客户”,锁/资源想象成“银行里的钱”。资源分配之前,先判断“给了这批资源以后,系统还能不能保证所有进程最终都完成”。如果能给,就分配;如果不能,就让进程等待。
假设系统有进程P1,P2,P3,资源类型A,B,C,每个资源有若干实例,银行家算法需要维护四类数据
Available: 当前系统还剩多少资源:
Available = [3, 3, 2]
表示:A 剩 3 个,B 剩 3 个,C 剩 2 个
Max: 每个进程最多需要多少资源。
例如:
| A | B | C | |
|---|---|---|---|
| P1 | 7 | 5 | 3 |
| P2 | 3 | 2 | 2 |
| P3 | 9 | 0 | 2 |
Allocation:当前已经分配给每个进程多少:
| A | B | C | |
|---|---|---|---|
| P1 | 0 | 1 | 0 |
| P2 | 2 | 0 | 0 |
| P3 | 3 | 0 | 2 |
Need: 还需要多少资源才能完成:
$$ Need[i][j]=Max[i][j]−Allocation[i][j] $$
所以:
| A | B | C | |
|---|---|---|---|
| P1 | 7 | 4 | 3 |
| P2 | 1 | 2 | 2 |
| P3 | 6 | 0 | 0 |
假设 P1 突然提出请求: Request1 = [1, 0, 2],银行家需要先模拟:“如果我现在把 [1,0,2] 给 P1,会不会导致系统进入不安全状态?”。这就是安全性检查(Safety Algorithm)。
安全性检查的流程如下
- $ Work = Available $,寻找一个进程 $P_i$,满足: $Need_i \le Work$
- 比如 $ Need_1 = [1,2,2] \le Work = [3,3,2]$
- $ Work = Work + Allocation_i = [0,1,0] $
- P1 完成以后,会把自己占有的资源全部释放,因此需要增加 $ Work $
- 继续寻找下一个可以完成的进程,直到所有进程都能被找到,此时称系统处于安全状态(Safe State),这个序列叫安全序列(Safe Sequence)
- 或者没找到安全序列,算法就会拒绝这次请求
安全序列的存在说明存在这样一个完成顺序,使得所有进程都能够最终获得所需资源并完成。安全序列不存在不保证一定死锁,但是也无法保证一定不死锁,所以算法拒绝资源请求。
需要注意的一点是,在分配资源前,除了安全性检查,还需要检查 Request ≤ Need 和 Request ≤ Available
          Pi 请求 Request
                 │
                 ↓
       Request ≤ Need ?
          │             │
         否             是
          ↓             ↓
        拒绝      Request ≤ Available ?
                         │
                    ┌────┴────┐
                   否         是
                   ↓           ↓
                  等待     假设分配
                              │
                              ↓
                         安全性算法
                              │
                    ┌─────────┴─────────┐
                   安全                 不安全
                    ↓                     ↓
                  分配                   回滚
不过银行家算法这类方法的使用场景都比较有限,因为调度器要求预先知道进程的最大资源需求,因此主要适用于任务和资源需求可预知的受控环境,比如一些嵌入式设备。
检测死锁并恢复
最后一个对付死锁的办法就是允许它偶尔发生,如果监测到发生了,那么采取一些措施:比如重启。一些数据库会周期性地检测死锁,如果发生了,系统就会重启,如果需要的话,修复数据结构。
基于事件的并发:Event-based Concurrency
既然多线程带来了这么多问题,那么能不能不用它?实际上并发不一定必须使用多线程。事件并发在GUI、互联网服务器等领域都有广泛应用。
线程并发的缺点有两点
- 正确管理并发很困难,容易产生死锁等问题
- 开发者难以控制线程的调度,因为这是操作系统的工作
事件并发的思路很简单,等待某个事件的发生,如果发生了,那么做对应的操作。事件循环的代码如下
while (1) {
    events = getEvents();
    for (e in events)
        processEvent(e);
}
Select API
关于如何接收事件,绝大部分系统都会提供基本的 API 包括 select() 和 poll(),比如在 Mac 上的 select()
int select(int nfds,
           fd_set *restrict readfds,
           fd_set *restrict writefds,
           fd_set *restrict errorfds,
           struct timeval *restrict timeout);
manual 中的介绍如下:
select() examines the I/O descriptor sets whose addresses are passed in readfds, writefds, and errorfds to see if some of their descriptors are ready for reading, are ready for writing, or have an exceptional condition pending, respectively. The first nfds descriptors are checked in each set, i.e.,the descriptors from 0 through nfds-1 in the descriptor sets are examined. On return, select() replaces the given descriptor sets with subsets consisting of those descriptors that are ready for the requested operation. select() returns the total number of ready descriptors in all the sets.
select() | poll() | |
|---|---|---|
| fd 集合表示 | fd_set 位图 | struct pollfd[] 数组 |
| fd 数量限制 | 通常受 FD_SETSIZE 限制,Linux 常见为 1024 | 没有 FD_SETSIZE 这种固定限制,受进程资源限制 |
| 事件类型 | readfds / writefds / exceptfds | events / revents |
| 调用后集合 | 会被修改 | revents 单独记录结果 |
| 遍历 fd | 通常扫描 0 ~ maxfd | 扫描传入的数组 |
| 接口设计 | 较老、比较麻烦 | 更现代、更加灵活 |
Select API 的基本用法如下
#include <stdio.h>
#include <stdlib.h>
#include <sys/time.h>
#include <sys/types.h>
#include <unistd.h>
int main(void) {
    // open and set up a bunch of sockets (not shown)
    // main loop
    while (1) {
        // initialize the fd_set to all zero
        fd_set readFDs;
        FD_ZERO(&readFDs);
        // now set the bits for the descriptors
        // this server is interested in
        // (for simplicity, all of them from min to max)
        int fd;
        for (fd = minFD; fd < maxFD; fd++)
            FD_SET(fd, &readFDs);
        // do the select
        int rc = select(maxFD+1, &readFDs, NULL, NULL, NULL);
        // check which actually have data using FD_ISSET()
        int fd;
        for (fd = minFD; fd < maxFD; fd++)
            if (FD_ISSET(fd, &readFDs))
        processFD(fd);
    }
}
异步I/O,阻塞和非阻塞:Blocking and Non-Blocking
阻塞接口或者同步接口会完成所有工作之后再返回,而非阻塞接口或者异步接口则是立即返回,在事件并发中非阻塞非常重要。在事件循环中,阻塞只会浪费时间,如果发生阻塞,整个程序都无法进行别的操作。所以事件并发编程中,一般不使用阻塞接口。
因为不使用阻塞接口,所以原本的 read(), open() 这类阻塞 I/O 接口不能使用了。取而代之的是异步 I/O (asynchronous I/O),Mac上的 AIO Control Block 涉及到下面的数据类型
struct aiocb {
    int             aio_fildes; // File descriptor
    off_t           aio_offset; // File offset
    volatile void   *aio_buf;   // Location of buffer
    size_t          aio_nbytes; // Length of transfer
};
为了异步读取文件,数据类型中的成员变量需要填充,填充完成之后,就可以调用异步接口。下面是异步版本的 read()
int aio_read(struct aiocb *aiocbp);
调用成功后,函数会立即返回,应用程序可以继续进行其他工作,但是还需要知道什么时候异步工作完成。
int aio_error(const struct aiocb *aiocbp);
上面的函数用于检查 AIOCB 是否处于完成状态,如果是的话,会返回0,否则返回 EINPROGRESS,所以程序可以通过这个接口轮询,判断工作是否完成。
除了轮询,异步 I/O(asynchronous I/O)完成后还可以通过 signal 通知进程,实现一种类似于中断的机制。
当 signal 被传递到应用程序中,应用程序就会进入 signal handler 进行处理,处理完成后继续原来的工作,每个 signal 都有自己的名字:
- HUP: Hang up
- INT: interrupt
- SEGV:segmentation violation
void handle(int arg) {
    printf("stop wakin’ me up...\n");
}
int main(int argc, char *argv[]) {
    signal(SIGHUP, handle);
    while (1)
        ; // doin’ nothin’ except catchin’ some sigs
    return 0;
}
当程序收到 HUP 信号时,就会跳转到 handle() 运行
prompt> ./main &
[3] 36705
prompt> kill -HUP 36705
stop wakin’ me up...
prompt> kill -HUP 36705
stop wakin’ me up...
一些困难
考虑下面的代码
int rc = read(fd, buffer, size);
rc = write(sd, buffer, size);
对于多线程来说,上面的代码非常简单,而对于事件并发程序来说就不是这样了,当等待完 read 操作之后,程序怎么知道自己下一步要做什么呢?一个简单的思路称之为 continuation,需要提前保存一些必要信息,等待完成之后,查询这部分信息来进行接下来的操作。比如在上面的例子中,需要提前保存下来 sd ,read 完成之后,查询 sd,然后继续 write。
事件并发的另外一个问题是如何使用多个CPU,如果将 handlers 并行运行,那么还是会出现前面的问题——临界区,锁的使用不可避免。
并且,虽然事件并发可以不调用阻塞接口,但是总会有一些事情是阻塞的,比如 page fault,这类阻塞称之为 implicit blocking,它们通常难以避免,并且带来性能损失。
还有一个问题是接口语义发生的变化,如果接口从非阻塞变成了阻塞,那么程序的其他部分也要进行相应的调整,这意味着程序员必须清楚地知道这类改变。
异步网络 I/O 和异步磁盘 I/O 虽然概念上都叫 asynchronous I/O,但在传统 Unix/Linux API 中,它们并没有被统一成一个接口。所以服务器可能不得不将两者结合,同时使用
                 ┌── 网络 socket
                 │
                 ↓
             select()
                 │
                 ↓
          网络 I/O 就绪

                 +

                 ┌── 磁盘文件
                 │
                 ↓
              AIO API
                 │
                 ↓
          磁盘 I/O 完成
附录:Thread API
创建线程
在 POSIX 里面,创建线程的函数如下
#include <pthread.h>
// thread: 即将被初始化的线程
// attr:   指定这个线程初始化的参数,一般传 NULL 使用默认参数即可
// start_routine: 线程入口的函数指针,返回类型和参数类型都是 void*
// arg:    传入函数的参数
int pthread_create(pthread_t            *thread,
                   const pthread_attr_t *attr,
                   void                 *(*start_routine)(void*),
                   void                 *arg);
使用的方法大致如下
#include <stdio.h>
#include <pthread.h>
typedef struct {
    int a;
    int b;
} myarg_t;
void *mythread(void *arg) {
    myarg_t *args = (myarg_t *) arg;
    printf("%d %d\n", args->a, args->b);
    return NULL;
}
int main(int argc, char *argv[]) {
    pthread_t p;
    myarg_t args = { 10, 20 };
    int rc = pthread_create(&p, NULL, mythread, &args);
    ...
}
线程完成
线程完成之后,我们需要等待它的结果,所以有了这样的接口
int pthread_join(pthread_t thread, void **value_ptr);
返回值会通过 value_ptr 传递,示例如下
typedef struct { int a; int b; } myarg_t;
typedef struct { int x; int y; } myret_t;
void *mythread(void *arg) {
    myret_t *rvals = Malloc(sizeof(myret_t));   // Wrapped malloc
    rvals->x = 1;
    rvals->y = 2;
    return (void *) rvals;
}
int main(int argc, char *argv[]) {
    pthread_t p;
    myret_t *rvals;
    myarg_t args = { 10, 20 };
    Pthread_create(&p, NULL, mythread, &args);
    Pthread_join(p, (void **) &rvals);
    printf("returned %d %d\n", rvals->x, rvals->y);
    free(rvals);
    return 0;
}
如果不需要返回值,直接传NULL即可,pthread_join(p, NULL)
如果需要返回的数据不需要包装,可以不使用 myret_t
void *mythread(void *arg) {
    long long int value = (long long int) arg;
    printf("%lld\n", value);
    return (void *) (value + 1);
}
int main(int argc, char *argv[]) {
    pthread_t p;
    long long int rvalue;
    Pthread_create(&p, NULL, mythread, (void *) 100);
    Pthread_join(p, (void **) &rvalue);
    printf("returned %lld\n", rvalue);
    return 0;
}
值得注意的是,要返回的数据必须是堆数据。
锁
POSIX 标准下,锁的获得与释放接口如下
int pthread_mutex_lock(pthread_mutex_t *mutex);
int pthread_mutex_unlock(pthread_mutex_t *mutex);
基本用法
pthread_mutex_t lock;
pthread_mutex_lock(&lock);
x = x + 1; // or whatever your critical section is
pthread_mutex_unlock(&lock);
锁的初始化方法有两种
使用宏定义
pthread_mutex_t lock = PTHREAD_MUTEX_INITIALIZER;
使用函数
int rc = pthread_mutex_init(&lock, NULL);
assert(rc == 0); // always check success!
锁的销毁
pthread_mutex_destroy()
条件变量
初始化
pthread_cond_t cond = PTHREAD_COND_INITIALIZER;
基本函数
int pthread_cond_wait(pthread_cond_t *cond, pthread_mutex_t *mutex);
int pthread_cond_signal(pthread_cond_t *cond);
基本用法
// 其中一个线程
pthread_mutex_t lock = PTHREAD_MUTEX_INITIALIZER;
pthread_cond_t cond = PTHREAD_COND_INITIALIZER;
Pthread_mutex_lock(&lock);
while (ready == 0)
    Pthread_cond_wait(&cond, &lock);
Pthread_mutex_unlock(&lock);
// 另一个线程
Pthread_mutex_lock(&lock);
ready = 1;
Pthread_cond_signal(&cond);
Pthread_mutex_unlock(&lock);
编译条件
使用上面的函数需要 #include <pthread.h>,并且在编译时指定 -pthread
prompt> gcc -o main main.c -Wall -pthread