Introduction
本文旨在记录作者完成课程任务 Computer Architecture Lab 1~3 的过程,可供参考。
本实验需要完成的内容包括
- 实验一:编写矩阵乘法
- 编写一个简单的程序打印一个整数,以验证汇编环境。
- 使用提供的汇编代码实现矩阵乘法,并调整代码以处理不同大小的矩阵
- 通过操作系统提供的命令、文件和评估工具获取系统目标处理器的缓存信息。
- 通过perf观察程序性能。
- 实验二:使用Cache优化矩阵乘法
- 利用性能分析工具
perf分析性能瓶颈 - 利用预取优化性能
- (选做):利用循环和分块提升计算性能
- 利用性能分析工具
- 实验三:使用指令级并行、向量指令和并行优化矩阵乘法
- 利用处理器中的x87 FPU(浮点计算单元)中更多的寄存器对矩阵乘法计算的循环进行展开以提升性能。
- 利用AVX指令实现性能更好的矩阵乘法计算内核。
- 利用OpenMP库将练习2实现的单线程高性能矩阵乘法内核扩展到多核以实现计算更大规模的矩阵乘法的目标。
实验包链接如下(需校内网)
指导书链接如下(需校内网)
仓库内有多个 lab 分支,本文所提的 lab1 对应的分支切换方法如下
环境配置
实验要求使用 x86_64 Linux 实体机/物理机 完成
基础环境配置
sudo apt update
sudo apt install -y build-essential net-tools git vim cmake gdb make gfortran libnuma-dev libtirpc-dev
测试环境是否安装成功
cmake -version
gcc --version
gdb --version
perf 安装
uname -r
先查看 Linux 内核版本号,可能会出现类似下面的结果
$ uname -r
6.8.0-137-generic
然后通过 apt 命令安装对应版本的工具
sudo apt install linux-tools-6.8.0-137-generic
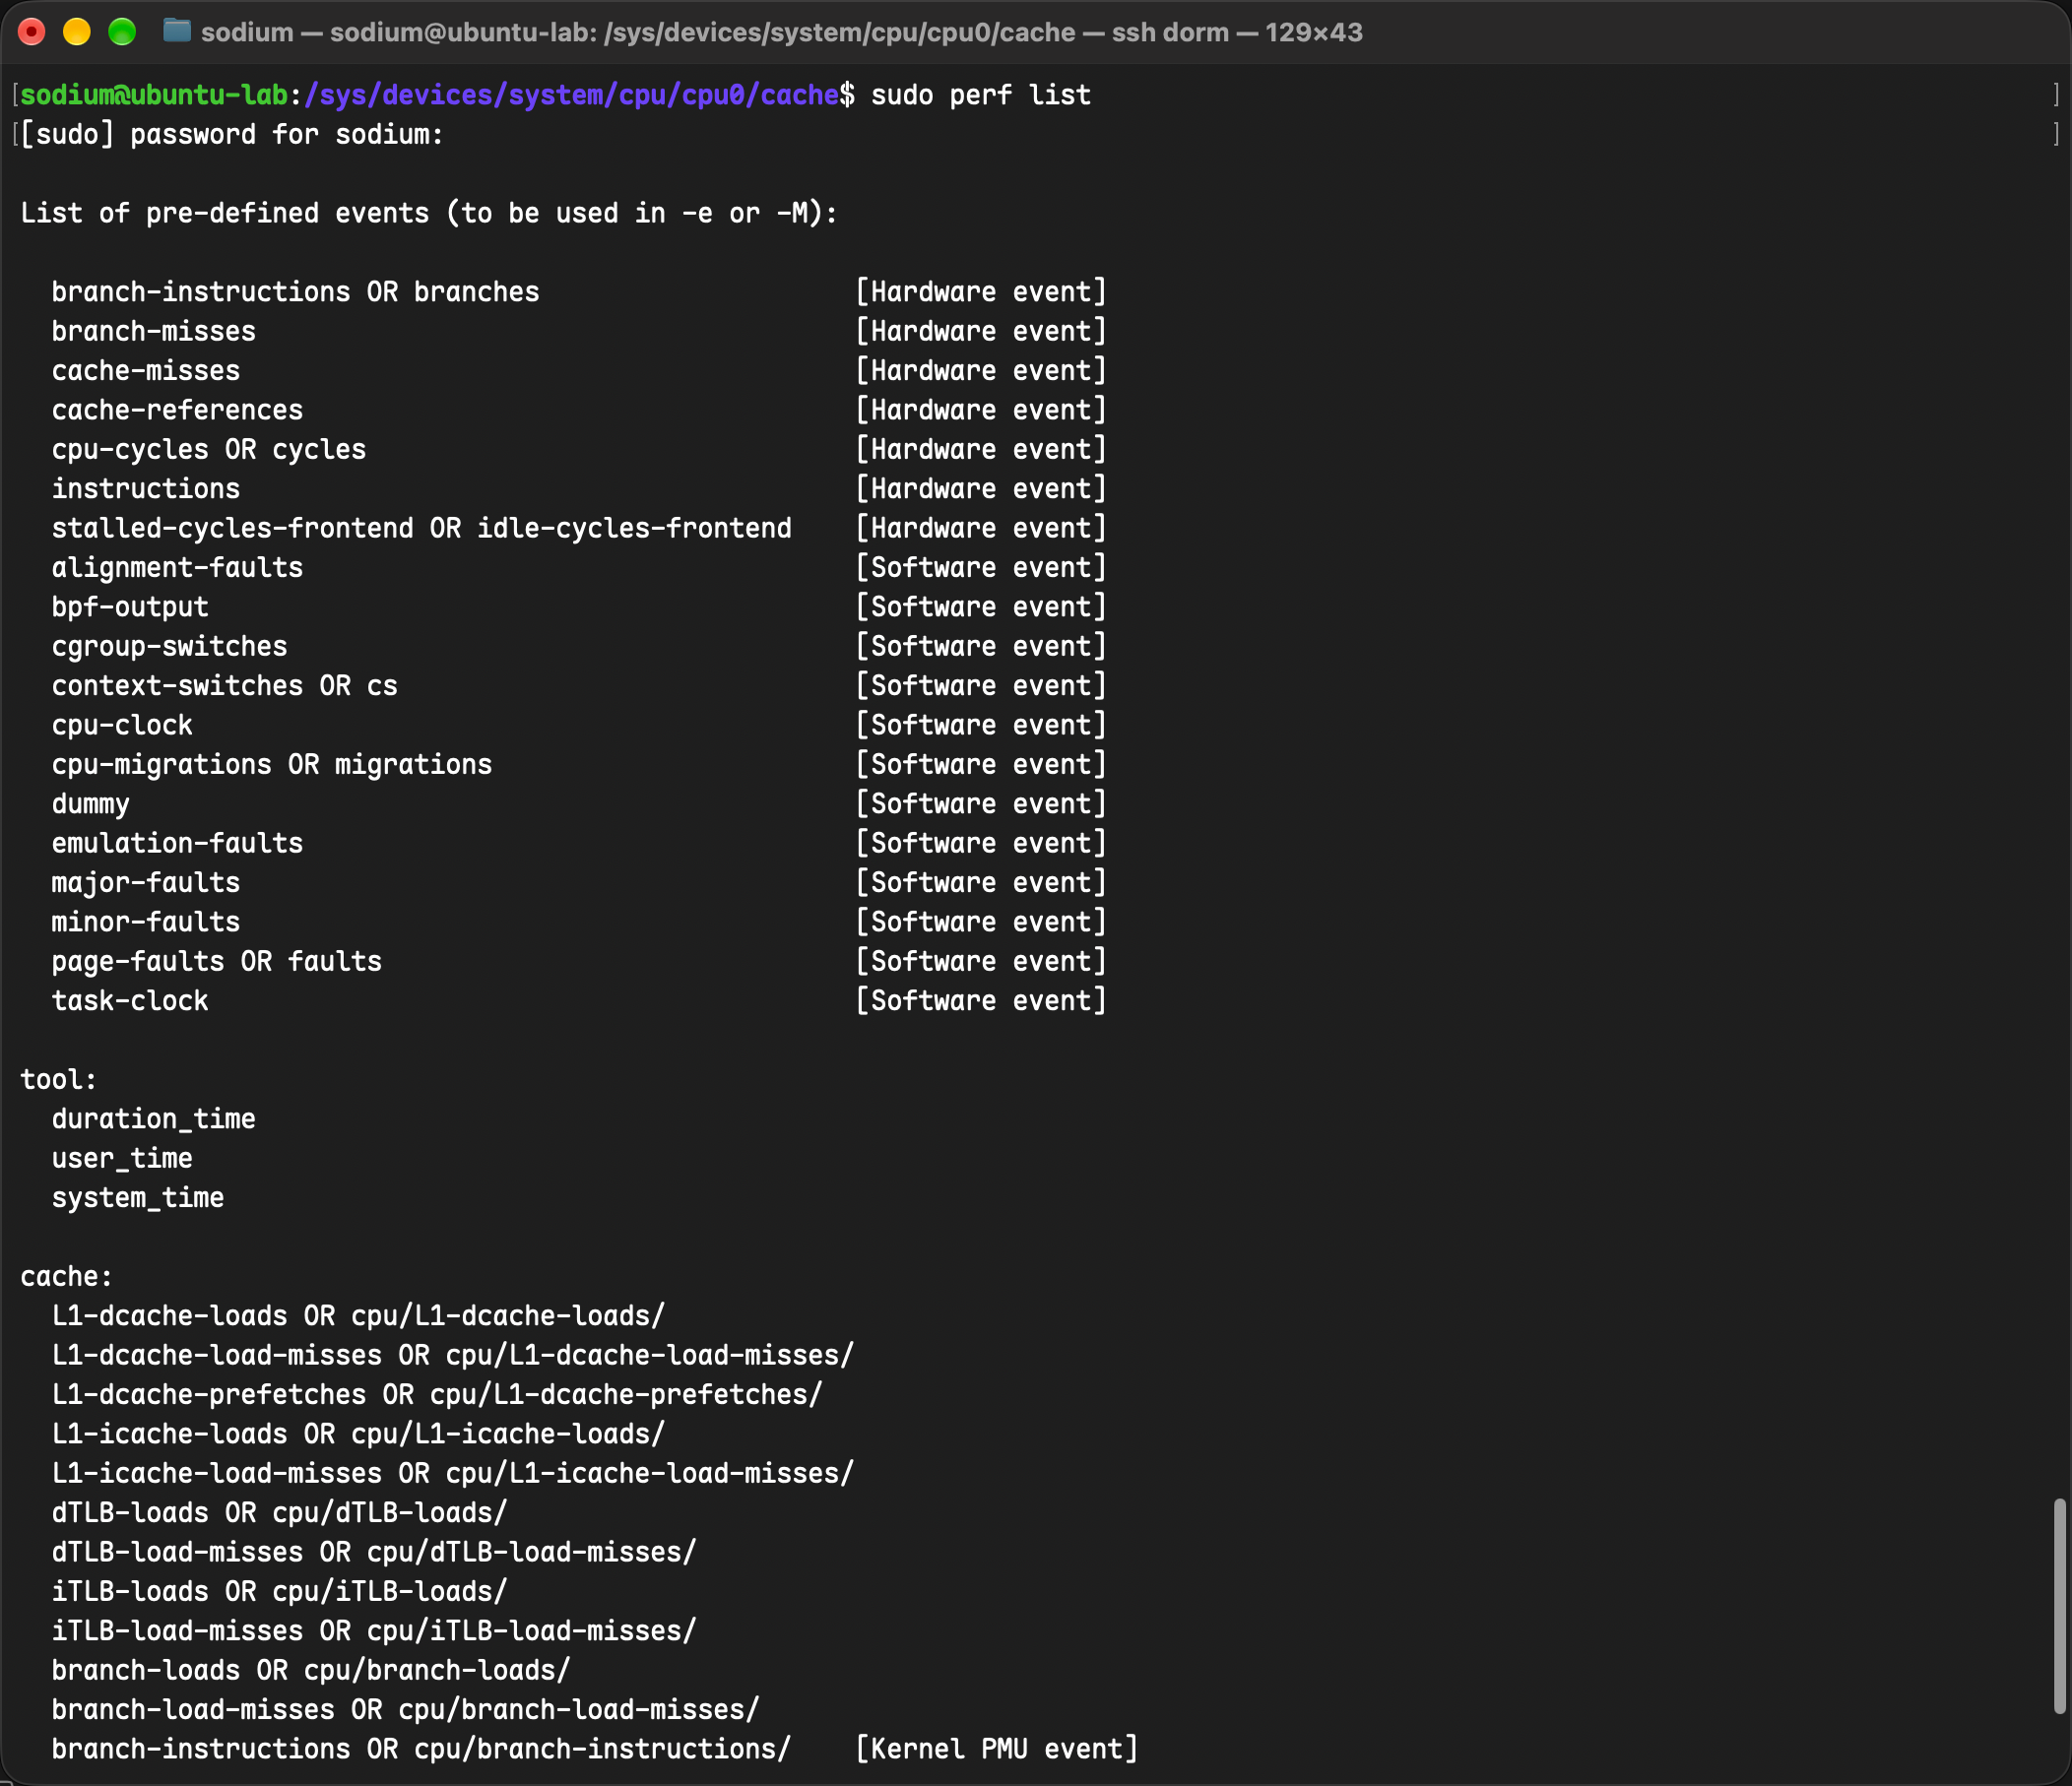
安装完成后可以查看 perf 支持的性能事件
sudo perf list
实验一:编写矩阵乘法
实验一内容如下
- 编写一个简单的程序打印一个整数,以验证汇编环境。
- 使用提供的汇编代码实现矩阵乘法,并调整代码以处理不同大小的矩阵
- 通过操作系统提供的命令
lscpu、文件和评估工具获取系统目标处理器的缓存信息。 - 通过
perf观察程序性能。
练习1:环境搭建与初步测试
本实验要求补全 lab1/src/lab1/print_integer.S 中的代码并通过测试,x86汇编相关内容可以查看附录
[x86汇编](#x86 汇编相关知识)
这份程序是一个打印程序,将数字 1234567890123456789 通过系统调用打印到命令行。删去注释掉的代码后如下:
/**
 *  向标准输出打印1个64位整数
 * */

.section .bss
    .lcomm buffer, 21   // 20个数字 + 1个空字符 作为输出的缓冲区

.section .data
    newline: .byte 0xA      // 换行符

.section .text
    .globl _start

_start:
    // 初始化要打印的数字
    mov $1234567890123456789, %rax

    // 将整数转换为字符串
    lea buffer+20(%rip), %rdi   // 将输出字符串的最后一个字符地址放入rdi寄存器
    movb $0, (%rdi)             // 给取后一个字符赋'\0'标志结束

convert_loop:                   // 将整数转换为字符串等待输出
    xor %rdx, %rdx
    mov $10, %rcx
    div %rcx                    // rdx = rax % 10, rax = rax / 10
    add $'0', %dl              // 计算对应的ascii码, rdx寄存器的低8位叫dl寄存器
    dec %rdi
    mov %dl, (%rdi)             // 结果写内存
                                // 判断是否结束, TODO: 请添加判断结束的指令
    jnz convert_loop

find_start:                     // 转换结束,跳过字符串前的所有0
    cmpb $'0', (%rdi)
    jne print_string
    inc %rdi
    jmp find_start

print_string:                   // 开始输出字符串
                                // 计算字符串长度
    lea buffer+20(%rip), %rax
    sub %rdi, %rax              // 计算存储的字节数
    mov %rax, %rdx              // 待输出的字节数放入rdx中

    // 系统调用号 (sys_write)     // TODO: 请修复此处的系统调用以正常输出字符串
    mov $1, %rax
    // 文件描述符 (stdout)
    mov $1, %rdi
    // 指向字符串的指针
    mov %rdi, %rsi
    // 要写入的字节数
    mov %rdx, %rdx
    // 执行系统调用
    syscall

    // 打印换行符
    mov $1, %rax
    mov $1, %rdi
    lea newline(%rip), %rsi
    mov $1, %rdx
    syscall

    // 退出程序
    mov $60, %rax  // 系统调用号 (sys_exit)
    xor %rdi, %rdi // 退出状态码
    syscall
_start 内容
_start:
    // 初始化要打印的数字
    mov $1234567890123456789, %rax

    // 将整数转换为字符串
    lea buffer+20(%rip), %rdi   // 将输出字符串的最后一个字符地址放入rdi寄存器
    movb $0, (%rdi)             // 给取后一个字符赋'\0'标志结束
程序先是将立即数 $1234567890123456789 写入到寄存器 rax 然后将 buffer 中最后一个数字的地址(buffer+20)载入到了寄存器 rdi,并且将最后一个数字的地址的值赋值为 \0
convert_loop 内容及 TODO 补全
convert_loop:                   // 将整数转换为字符串等待输出
    xor %rdx, %rdx
    mov $10, %rcx
    div %rcx                    // rdx = rax % 10, rax = rax / 10
    add $'0', %dl              // 计算对应的ascii码, rdx寄存器的低8位叫dl寄存器
    dec %rdi
    mov %dl, (%rdi)             // 结果写内存
                                // 判断是否结束, TODO: 请添加判断结束的指令
    jnz convert_loop
随后在 convert_loop 中,首先使用 xor 将 rdx 清零,然后使用 div %rcx 让 rax 除以 rcx,得到的余数会放到 rdx 中,然后 rdx 寄存器的低8位 dl 寄存器加上 '0' 来得到对应的 ASCII 码,这样就得到了 1234567890123456789 的个位数的 ASCII 码存储在 dl 中。
随后将这个 ASCII 码写回内存,那么 rdi 就要减一,得到个位的地址,然后把 dl 写进去。
每个寄存器在这里含义如下
rax: 不断除以10的立即数1234567890123456789rdx: 用来存储每次除以10得到的余数dl:rdx的低八位(一个字节长度),用来计算出 ASCII 码并写入到内存rdi: 用于指向待写入的内存区域
所以终止条件应该是所有的内存区域都写完,也就是 rdi 刚好是 buffer 的第一位或者 rax 变成了 0 ,从 jnz 可以确定应该是采取后一种判断,补充代码如下
test %rax, %rax     // 新插入的指令
jnz convert_loop
convert_loop 完成之后,buffer~buffer+20 这块区域中每个字节应该都是立即数各个位对应的 ASCII 码了
find_start 内容
find_start:                     // 转换结束,跳过字符串前的所有0
    cmpb $'0', (%rdi)
    jne print_string
    inc %rdi
    jmp find_start
通过 cmp 和 jne 来检查当前 rdi 指向的 ASCII 字符是否不为 \0,如果不为 \0,说明找到了开始处,否则需要将 rdi 加一(inc %rdi),然后继续检查
执行完成之后 rdi 会指向第一个字符
print_string 内容
这一部分的内容主要是调用系统调用 sys_write,需要知道调用格式
rax: 相当于 Risc-V 中的a7,记录系统调用号rdi: 相当于 Risc-V 中的a0,对应第一个参数fd,表示文件描述符rsi:相当于 Risc-V 中的a1,对应第二个参数addr,表示要写入的数据的起始地址rdx:相当于 Risc-V 中的a2,对应第三个参数size,表示要写入的数据的长度
然后使用指令 syscall 就能执行系统调用,相当于 Risc-V 的 ecall
而在执行 print_string 之前,已有的数据是起始地址,但是却保存在了 rdi 而非 rsi 中
print_string:                   // 开始输出字符串
                                // 计算字符串长度
    lea buffer+20(%rip), %rax
    sub %rdi, %rax              // 计算存储的字节数
    mov %rax, %rdx              // 待输出的字节数放入rdx中

    // 系统调用号 (sys_write)     // TODO: 请修复此处的系统调用以正常输出字符串
    mov $1, %rax
    // 文件描述符 (stdout)
    mov $1, %rdi
    // 指向字符串的指针
    mov %rdi, %rsi
    // 要写入的字节数
    mov %rdx, %rdx
    // 执行系统调用
    syscall

    // 打印换行符
    mov $1, %rax
    mov $1, %rdi
    lea newline(%rip), %rsi
    mov $1, %rdx
    syscall

    // 退出程序
    mov $60, %rax  // 系统调用号 (sys_exit)
    xor %rdi, %rdi // 退出状态码
    syscall
原程序中通过 lea 将末尾地址载入 rax ,并通过 sub 指令来计算总共的字节数到 rax ,并且保存到了 rdx 寄存器中
通过 mov 指令,系统调用号载入了 rax 寄存器中,文件描述符 1 载入到了 rdi 中,这正是出问题的地方,还没来得及保存起始地址就已经被覆盖掉了
至于后面打印换行符没有问题,因为只需要获得 rsi 需要 newline 的地址即可。
所以修改如下,将 mov %rdi, %rsi 放到 mov $1, %rdi 的前面即可
    // 指向字符串的指针
    mov %rdi, %rsi
    // 系统调用号 (sys_write)
    mov $1, %rax
    // 文件描述符 (stdout)
    mov $1, %rdi
    // 要写入的字节数
    mov %rdx, %rdx
    // 执行系统调用
    syscall
运行
进入项目根目录并编译源码
cd lab1
mkdir -p build && cd build
cmake -B . -S ../ && cmake --build ./ --target lab1_print_integer
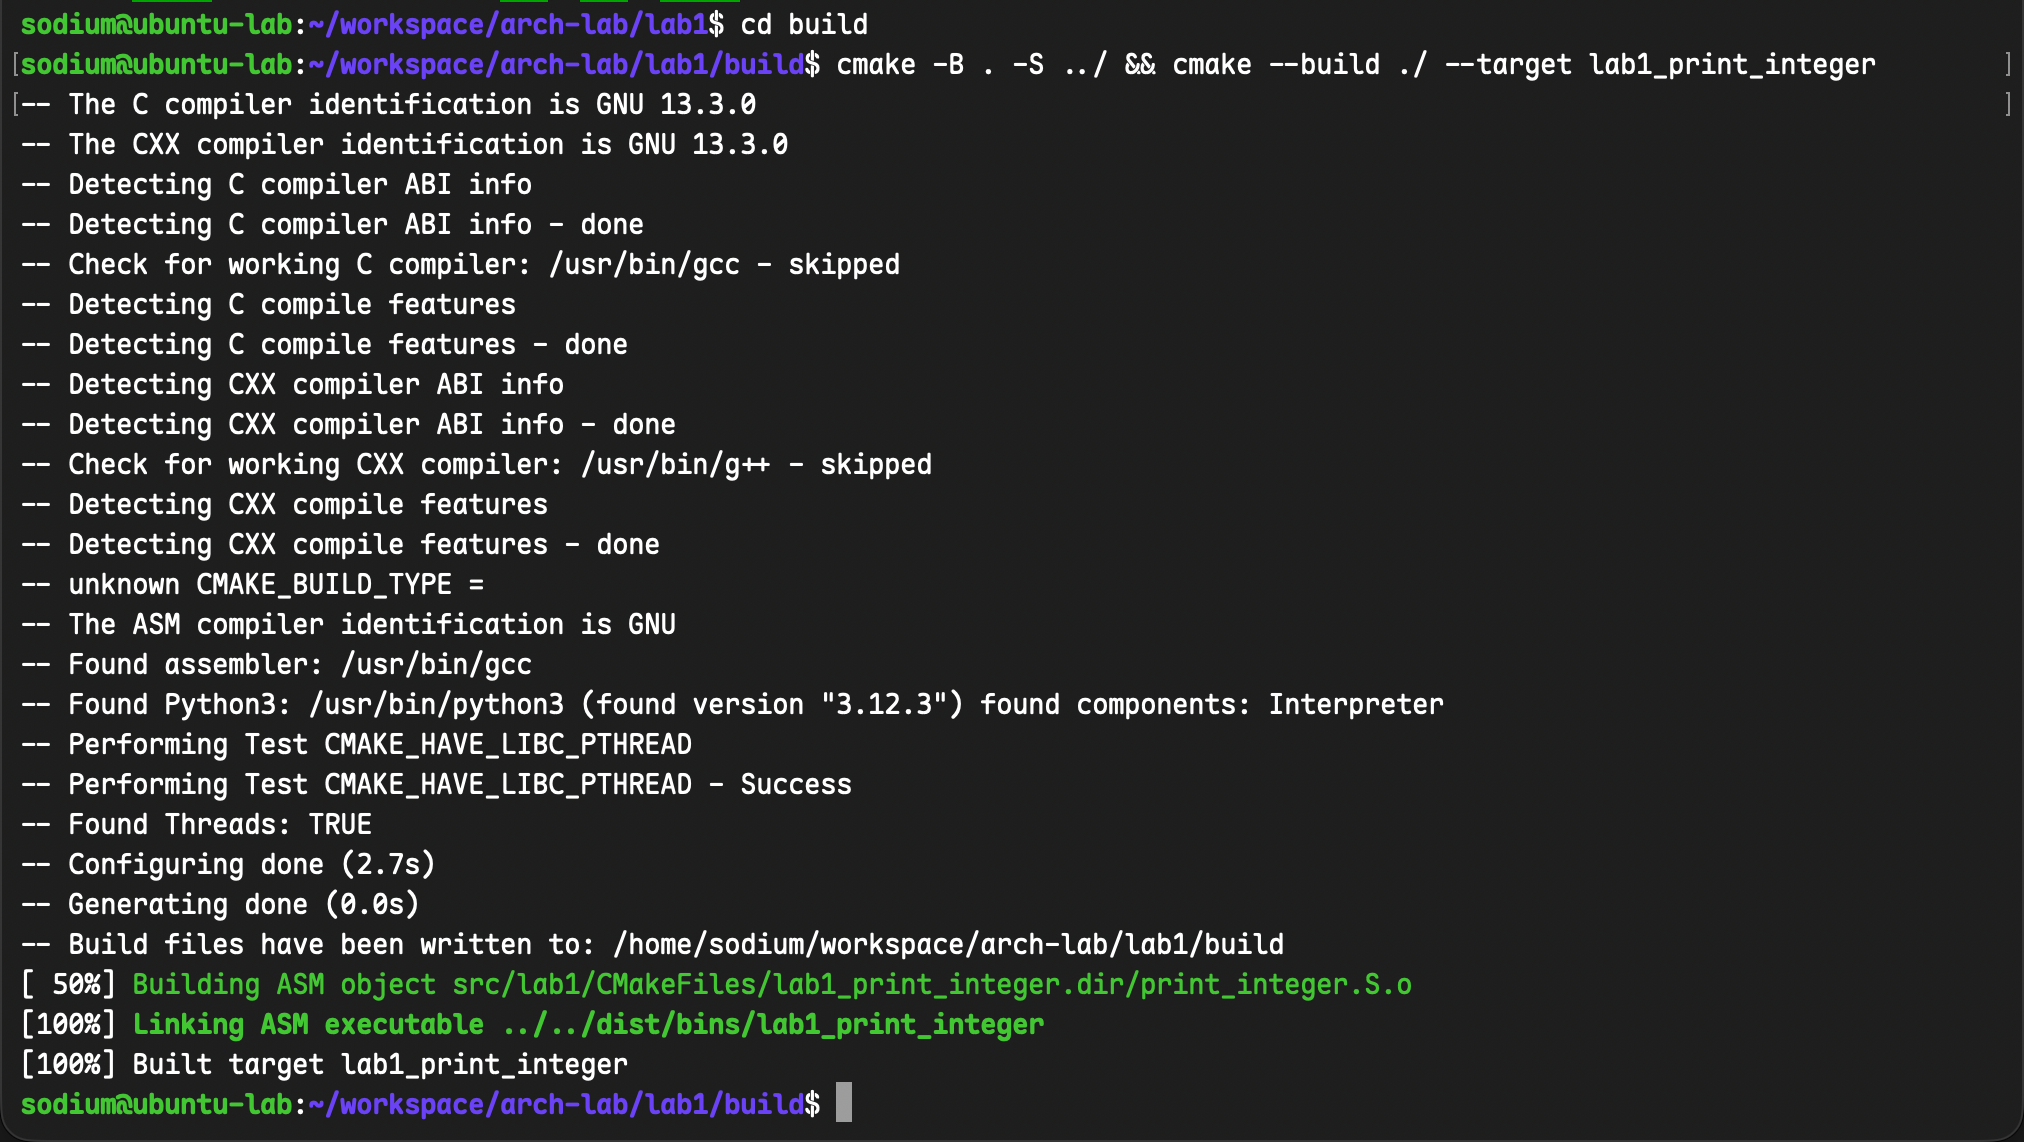
其中第3条命令需从校内网克隆git仓库,因此请确保计算机能正常访问校园网
然后运行
./dist/bins/lab1_print_integer
应该会输出
1234567890123456789

练习2:实现矩阵乘法
本实验要求补全 lab1/src/lab1/gemm_kernel.S 中的代码并通过测试,x87相关内容可以查看附录
[x87 FPU](#x87 FPU 相关知识)
其中 GEMM 的全称是 General Matrix Multiply ,通用矩阵乘法
原代码如下
.text;
.p2align 2;
.global gemm_kernel;
.type gemm_kernel, %function;

// 以下是宏定义,方便按逻辑梳理
#define     MAT_C               %rdi
#define     MAT_A               %rsi
#define     MAT_B               %r14
#define     DIM_M               %rcx
#define     DIM_N               %r8
#define     DIM_K               %r9
#define     loop_m              %r10
#define     loop_k              %r11
#define     loop_n              %r12
#define     mat_elem_idx        %r13


.macro PUSHD                                        // 保存原通用寄存器值
    push %rax
    push %rbx
    push %rcx
    push %rdx
    push %rsi
    push %rdi
    push %rbp
    push %r8
    push %r9
    push %r10
    push %r11
    push %r12
    push %r13
    push %r14
    push %r15
.endm

.macro POPD                                        // 恢复原通用寄存器值
    pop %r15
    pop %r14
    pop %r13
    pop %r12
    pop %r11
    pop %r10
    pop %r9
    pop %r8
    pop %rbp
    pop %rdi
    pop %rsi
    pop %rdx
    pop %rcx
    pop %rbx
    pop %rax
.endm

.macro GEMM_INIT                                   // 初始化
    // TODO: 将矩阵B的地址存入MAT_B宏对应的寄存器

    xor loop_m, loop_m
    xor loop_k, loop_k
    xor loop_n, loop_n
.endm

.macro DO_GEMM                                      // 使用kij遍历方式计算矩阵乘法
DO_LOOP_K:                                          // 最外层的K维度的循环
    xor loop_m, loop_m                              // 清空M维度的循环计数器

DO_LOOP_M:                                          // M维度的循环
    xor loop_n, loop_n                              // 清空M维度的循环计数器

    // TODO: 加载A[m][k]


    flds (MAT_A, mat_elem_idx, 4)                   // 加载 A[m][k]到st(0),flds只能将数据加载到栈顶即st(0), 原st(0)的数据存入st(1),若栈满则会压栈失败

DO_LOOP_N:
    // TODO: 加载B[k][n]


    flds (MAT_B, mat_elem_idx, 4)                   // 加载 B[k][n]

    fmul %st(1), %st(0)                             // 计算A[m][k] * B[k][n]

    // TODO: 加载C[m][n]


    flds (MAT_C, mat_elem_idx, 4)                   // 加载 C[m][n]

    faddp %st(1), %st(0)                            // 计算 C[m][n] + A[m][k] * B[k][n]
    fstps (MAT_C, mat_elem_idx, 4)                  // 写回 C[m][n]

    add $1, loop_n                                  // N维度的循环计数器加1
    cmp DIM_N, loop_n
    jl DO_LOOP_N

    fstp %st(0)                                     // 清空st(0),此时矩阵A的元素不再使用
    add $1, loop_m                                  // M维度的循环计数器加1
    cmp DIM_M, loop_m
    jl DO_LOOP_M

    add $1, loop_k                                  // K维度的循环计数器加1
    cmp DIM_K, loop_k
    jl DO_LOOP_K
.endm

gemm_kernel:
    PUSHD
    GEMM_INIT
    DO_GEMM
    POPD
    ret
程序的执行入口就在 gemm_kernel 这里,调用时,参数会载入到寄存器中,按照 ABI,六个寄存器应该分别是
gemm_kernel(matrix_c, matrix_a, matrix_b, m, n, k);
#define     MAT_C               %rdi
#define     MAT_A               %rsi
#define     MAT_B               %r14
#define     DIM_M               %rcx
#define     DIM_N               %r8
#define     DIM_K               %r9
%rdi1st argument 保存了matrix_c%rsi2nd argument 保存了matrix_a%rdx3rd argument 保存了matrix_b%rcx4th argument 保存了m%r85th argument 保存了n%r96th argument 保存了k
gemm_kernel:
    PUSHD
    GEMM_INIT
    DO_GEMM
    POPD
    ret
上面的代码揭示了实际调用时执行的顺序,或者其实更准确地说其实是代码排布的顺序。
本实验不需要考虑 PUSHD 和 POPD 的部分,只关注 GEMM_INIT 和 DO_GEMM
GEMM_INIT
.macro GEMM_INIT                                   // 初始化
    // TODO: 将矩阵B的地址存入MAT_B宏对应的寄存器

    xor loop_m, loop_m
    xor loop_k, loop_k
    xor loop_n, loop_n
.endm
根据前面的 ABI 可以发现,matrix_b 实际上保存在了 %rdx,但是宏定义里面 MAT_B 却是 %r14,而后续的操作都是使用宏定义的 %r14 寄存器,所以需要将矩阵移动到 MAT_B 对应的寄存器中。
.macro GEMM_INIT                                   // 初始化
    // TODO: 将矩阵B的地址存入MAT_B宏对应的寄存器
    mov %rdx, MAT_B
    xor loop_m, loop_m
    xor loop_k, loop_k
    xor loop_n, loop_n
.endm
剩下的 loop_* 这些是循环内变量,类似于 i,j,k ,这里清零了
DO_GEMM
.macro DO_GEMM                                      // 使用kij遍历方式计算矩阵乘法
DO_LOOP_K:                                          // 最外层的K维度的循环
    xor loop_m, loop_m                              // 清空M维度的循环计数器
DO_LOOP_M:                                          // M维度的循环
    xor loop_n, loop_n                              // 清空M维度的循环计数器
    // TODO: 加载A[m][k]

    flds (MAT_A, mat_elem_idx, 4)                   // 加载 A[m][k]到st(0),flds只能将数据加载到栈顶即st(0), 原st(0)的数据存入st(1),若栈满则会压栈失败
DO_LOOP_N:
    // TODO: 加载B[k][n]

    flds (MAT_B, mat_elem_idx, 4)                   // 加载 B[k][n]
    fmul %st(1), %st(0)                             // 计算A[m][k] * B[k][n]

    // TODO: 加载C[m][n]

    flds (MAT_C, mat_elem_idx, 4)                   // 加载 C[m][n]
    faddp %st(1), %st(0)                            // 计算 C[m][n] + A[m][k] * B[k][n]
    fstps (MAT_C, mat_elem_idx, 4)                  // 写回 C[m][n]

    add $1, loop_n                                  // N维度的循环计数器加1
    cmp DIM_N, loop_n
    jl DO_LOOP_N

    fstp %st(0)                                     // 清空st(0),此时矩阵A的元素不再使用
    add $1, loop_m                                  // M维度的循环计数器加1
    cmp DIM_M, loop_m
    jl DO_LOOP_M

    add $1, loop_k                                  // K维度的循环计数器加1
    cmp DIM_K, loop_k
    jl DO_LOOP_K
.endm
虽然有三个 TODO,但它们实际上原理是一样的,都是计算出类似于 mat_elem_idx = DIM_K * loop_m + loop_k 的结果,下面是矩阵 A 的例子,其他同理,在此省略。
矩阵 A 是 DIM_M 行,DIM_K 列,所以 A[m][k] 是 A[DIM_K*m + k]
    // TODO: 加载A[m][k]
    mov loop_m, mat_elem_idx
    imul DIM_K, mat_elem_idx
    add loop_k, mat_elem_idx
这里 imul src, dst 含义是 dst *= src,而后面的 (MAT_A, mat_elem_idx, 4) 则是计算出 A[m][k] 的字节地址:MAT_A + mat_elem_idx * 4, 4 是一个 float 的长度(32位)
翻译成 C 语言大致如下
int loop_k = loop_m = loop_n = 0;
unsigned int mat_elem_idx;
for (loop_k; loop_k < DIM_K, lopp_k++){
    for (loop_m; loop_m < DIM_M, loop_m++){
        mat_elem_idx = DIM_K * loop_m + loop_k;
        flds(A[mat_elem_idx]);                          // A[m][k]
        for (loop_n; loop_n < DIM_N; loop_n++){
            mat_elem_idx = DIM_N * loop_k + loop_n;     // B[k][n]
            flds(B[mat_elem_idx]);
            fmul(%st(1), %st(0));                       // A[m][k] * B[k][n]
            mat_elem_idx = DIM_N * loop_m + loop_n;     // C[m][n]
            flds(C[mat_elem_idx]);
            faddp(%st(1), %st(0));                      // A[m][k] * B[k][n] + C[m][n]
            fstps(C[mat_elem_idx]);
        }
        fstp(%st(0));
    }
}
测试运行
编译测试程序并运行
cd lab1/build
cmake -B . -S ../ && cmake --build ./ --target lab1_test_gemm_kernel.unittest
./dist/bins/lab1_test_gemm_kernel.unittest --gtest_filter=gemm_kernel.test0
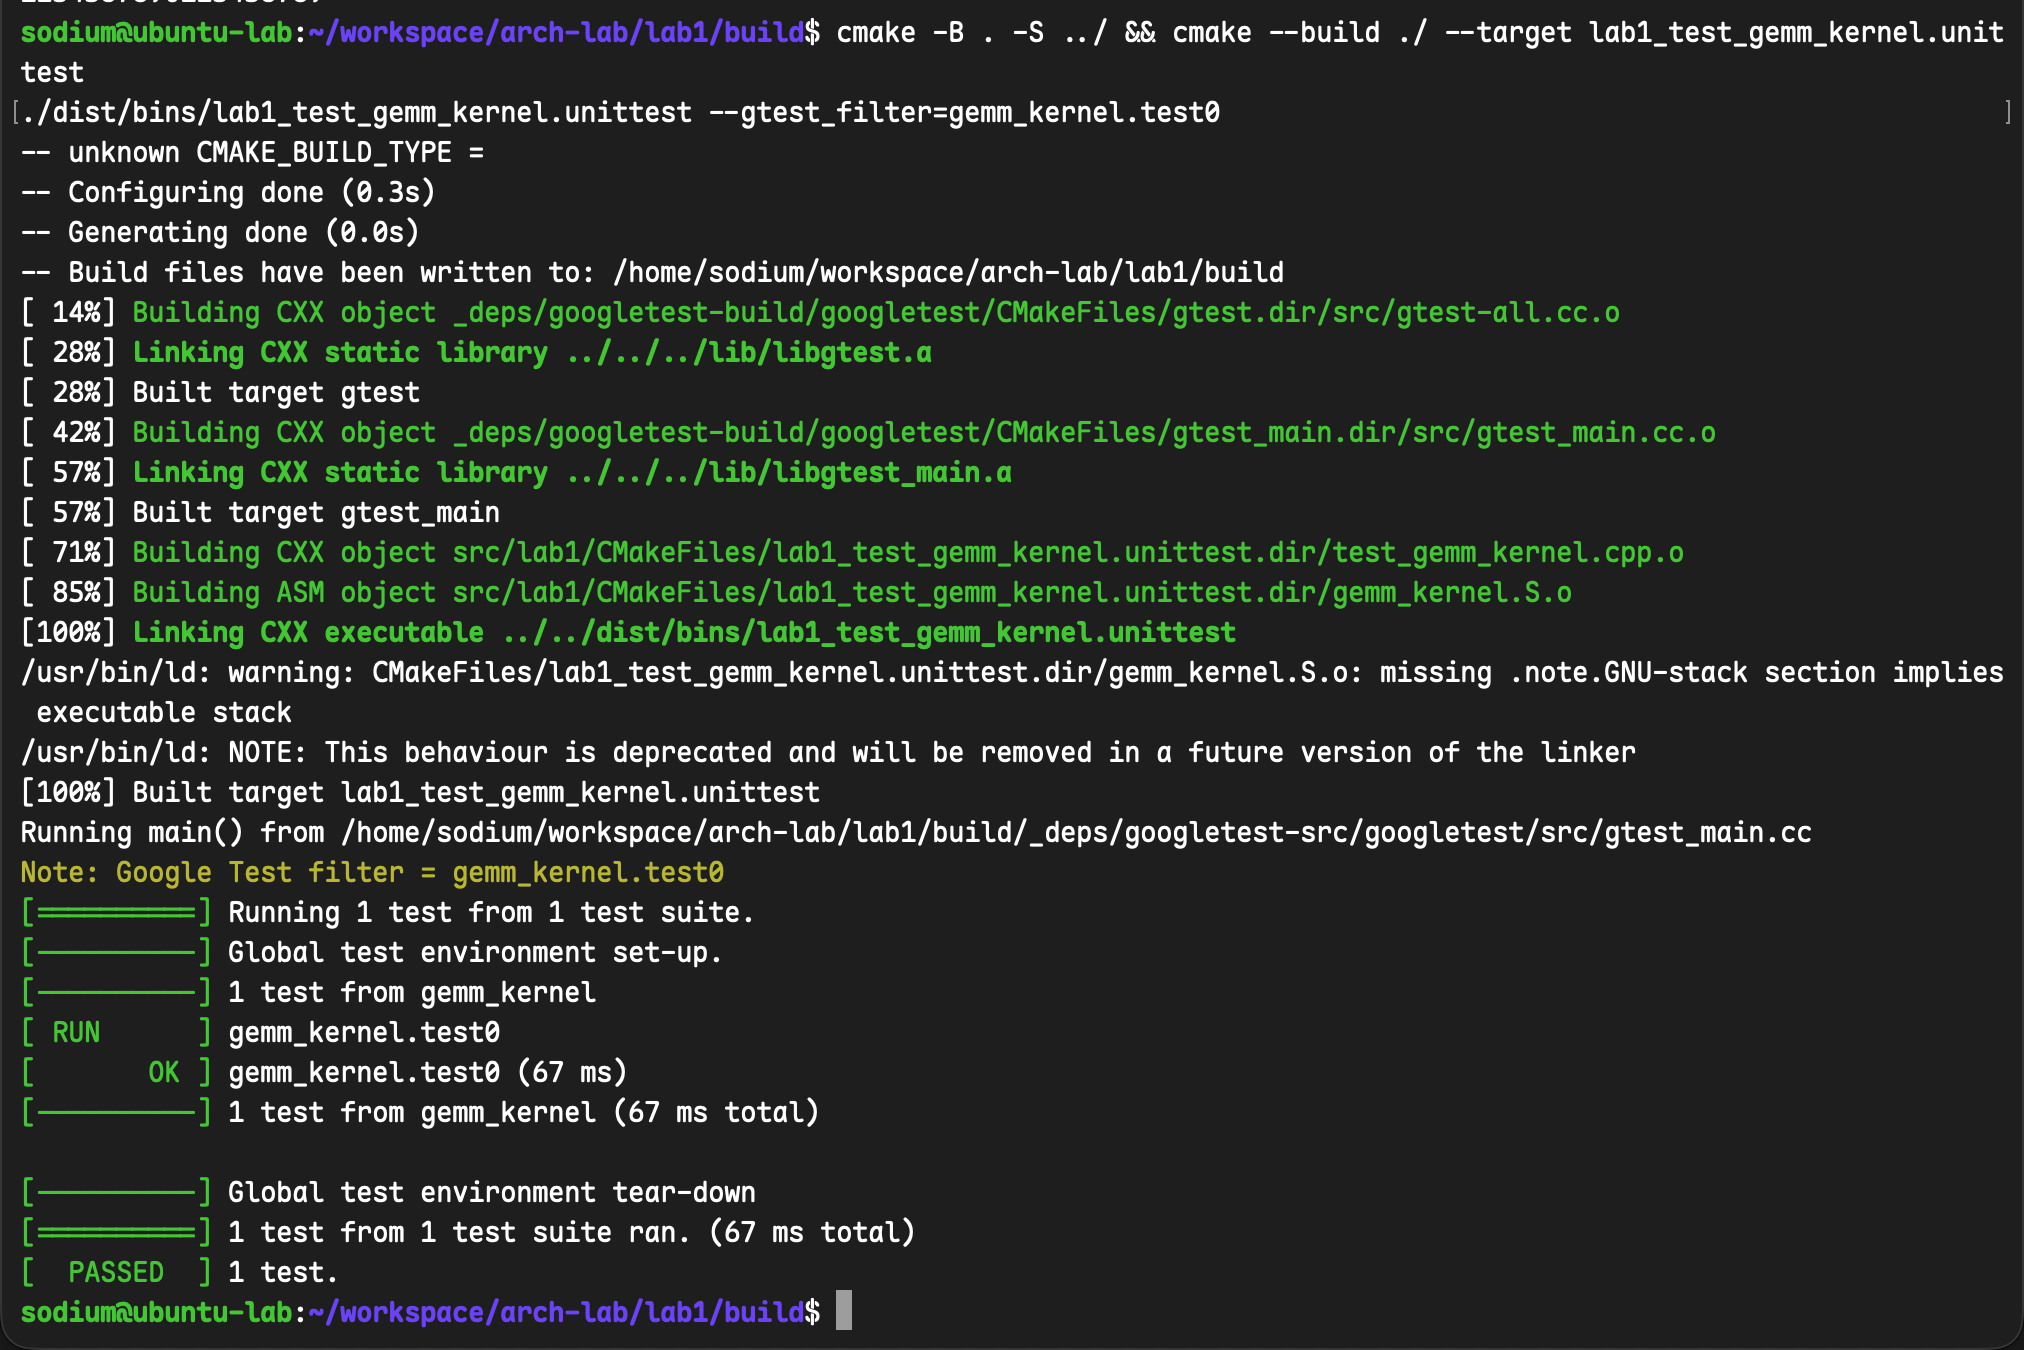
矩阵乘法结果正确无误后,编译并进行 Benchmark
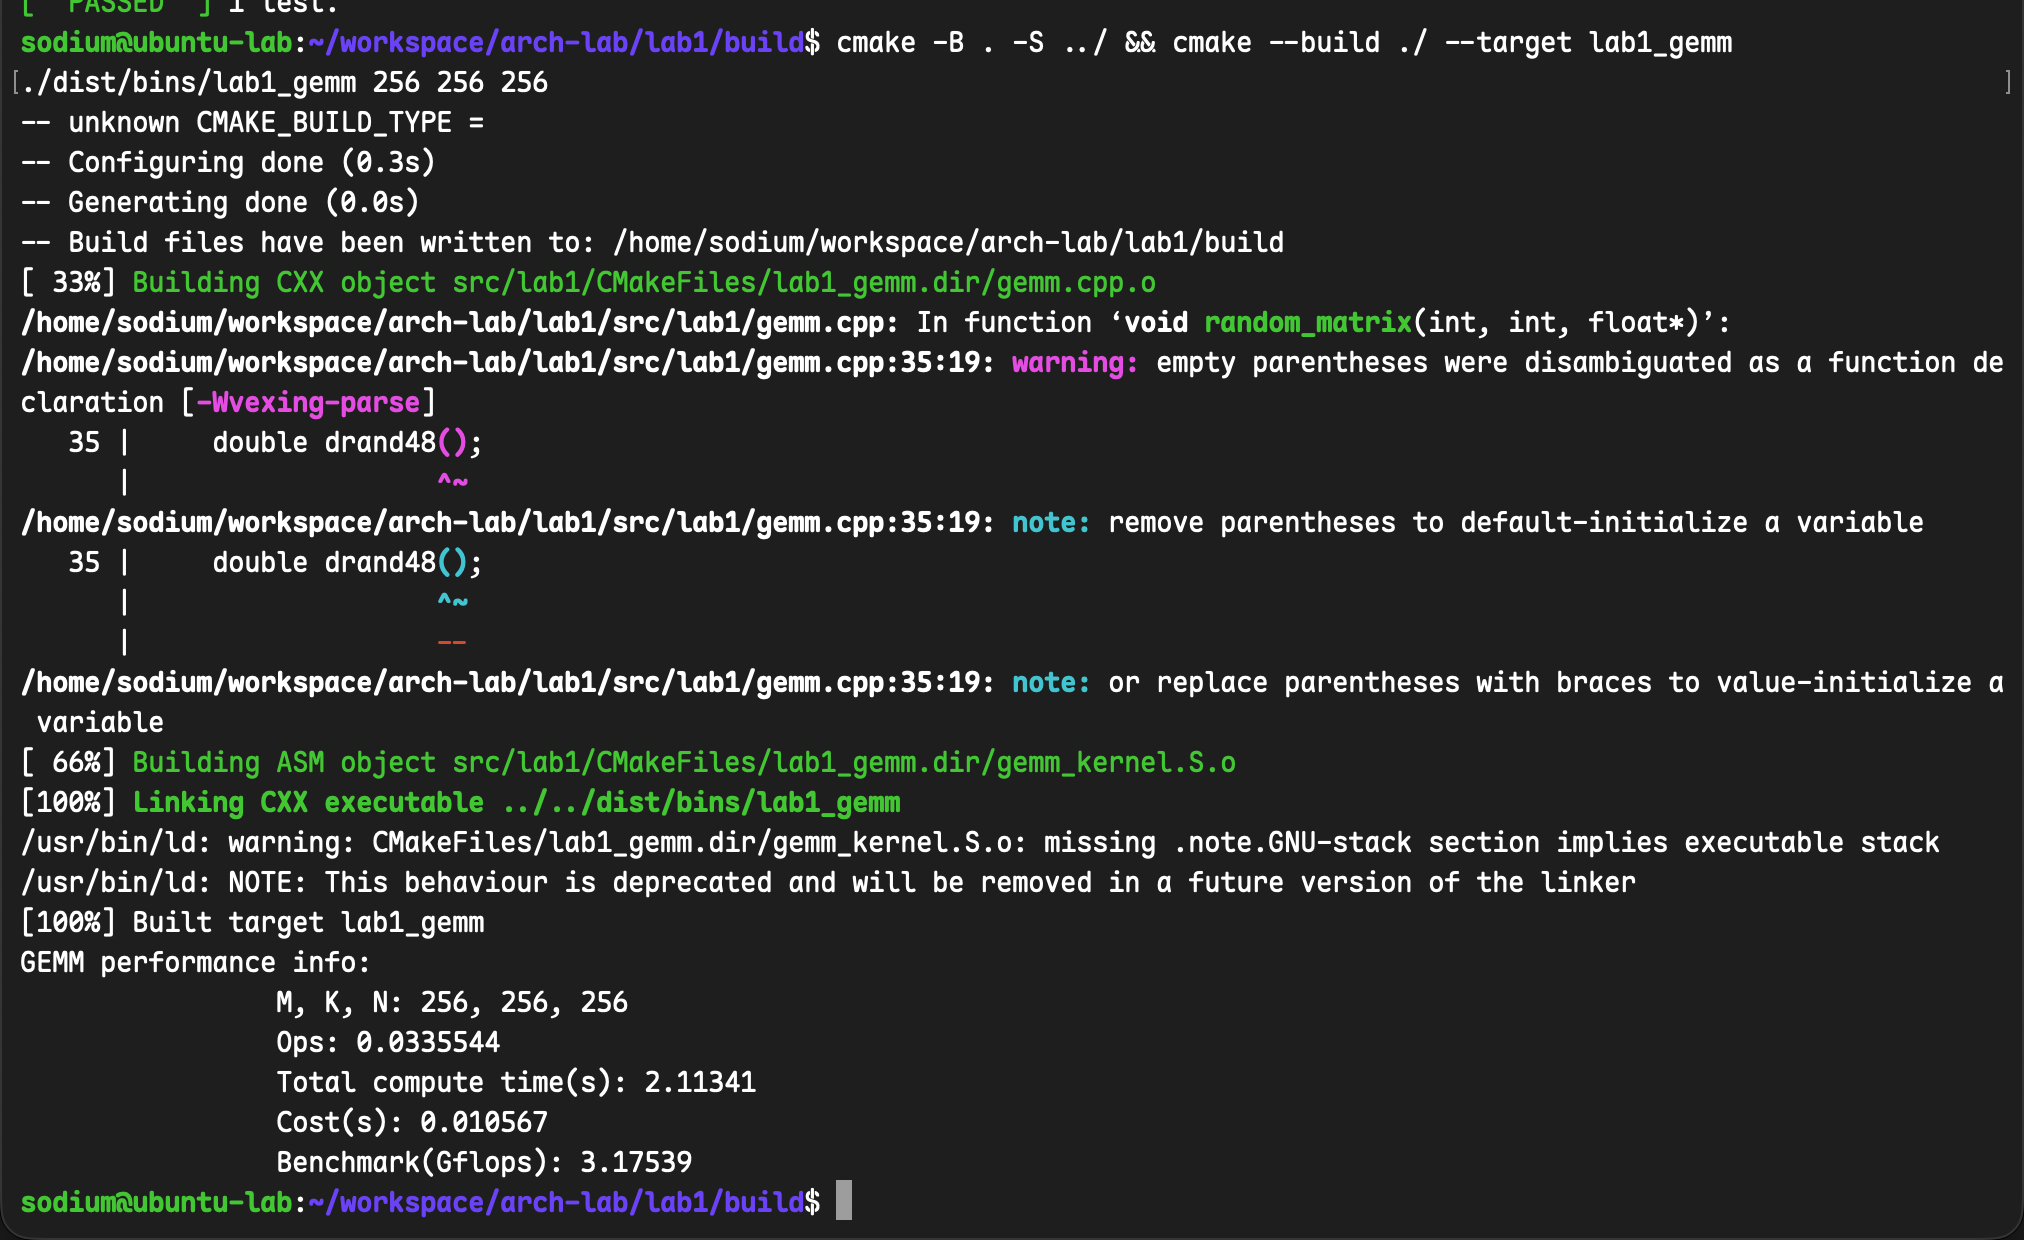
cmake -B . -S ../ && cmake --build ./ --target lab1_gemm
./dist/bins/lab1_gemm 256 256 256
练习3:获取目标处理器的缓存信息
通过 lscpu 查看处理器型号、缓存层级信息
lscpu
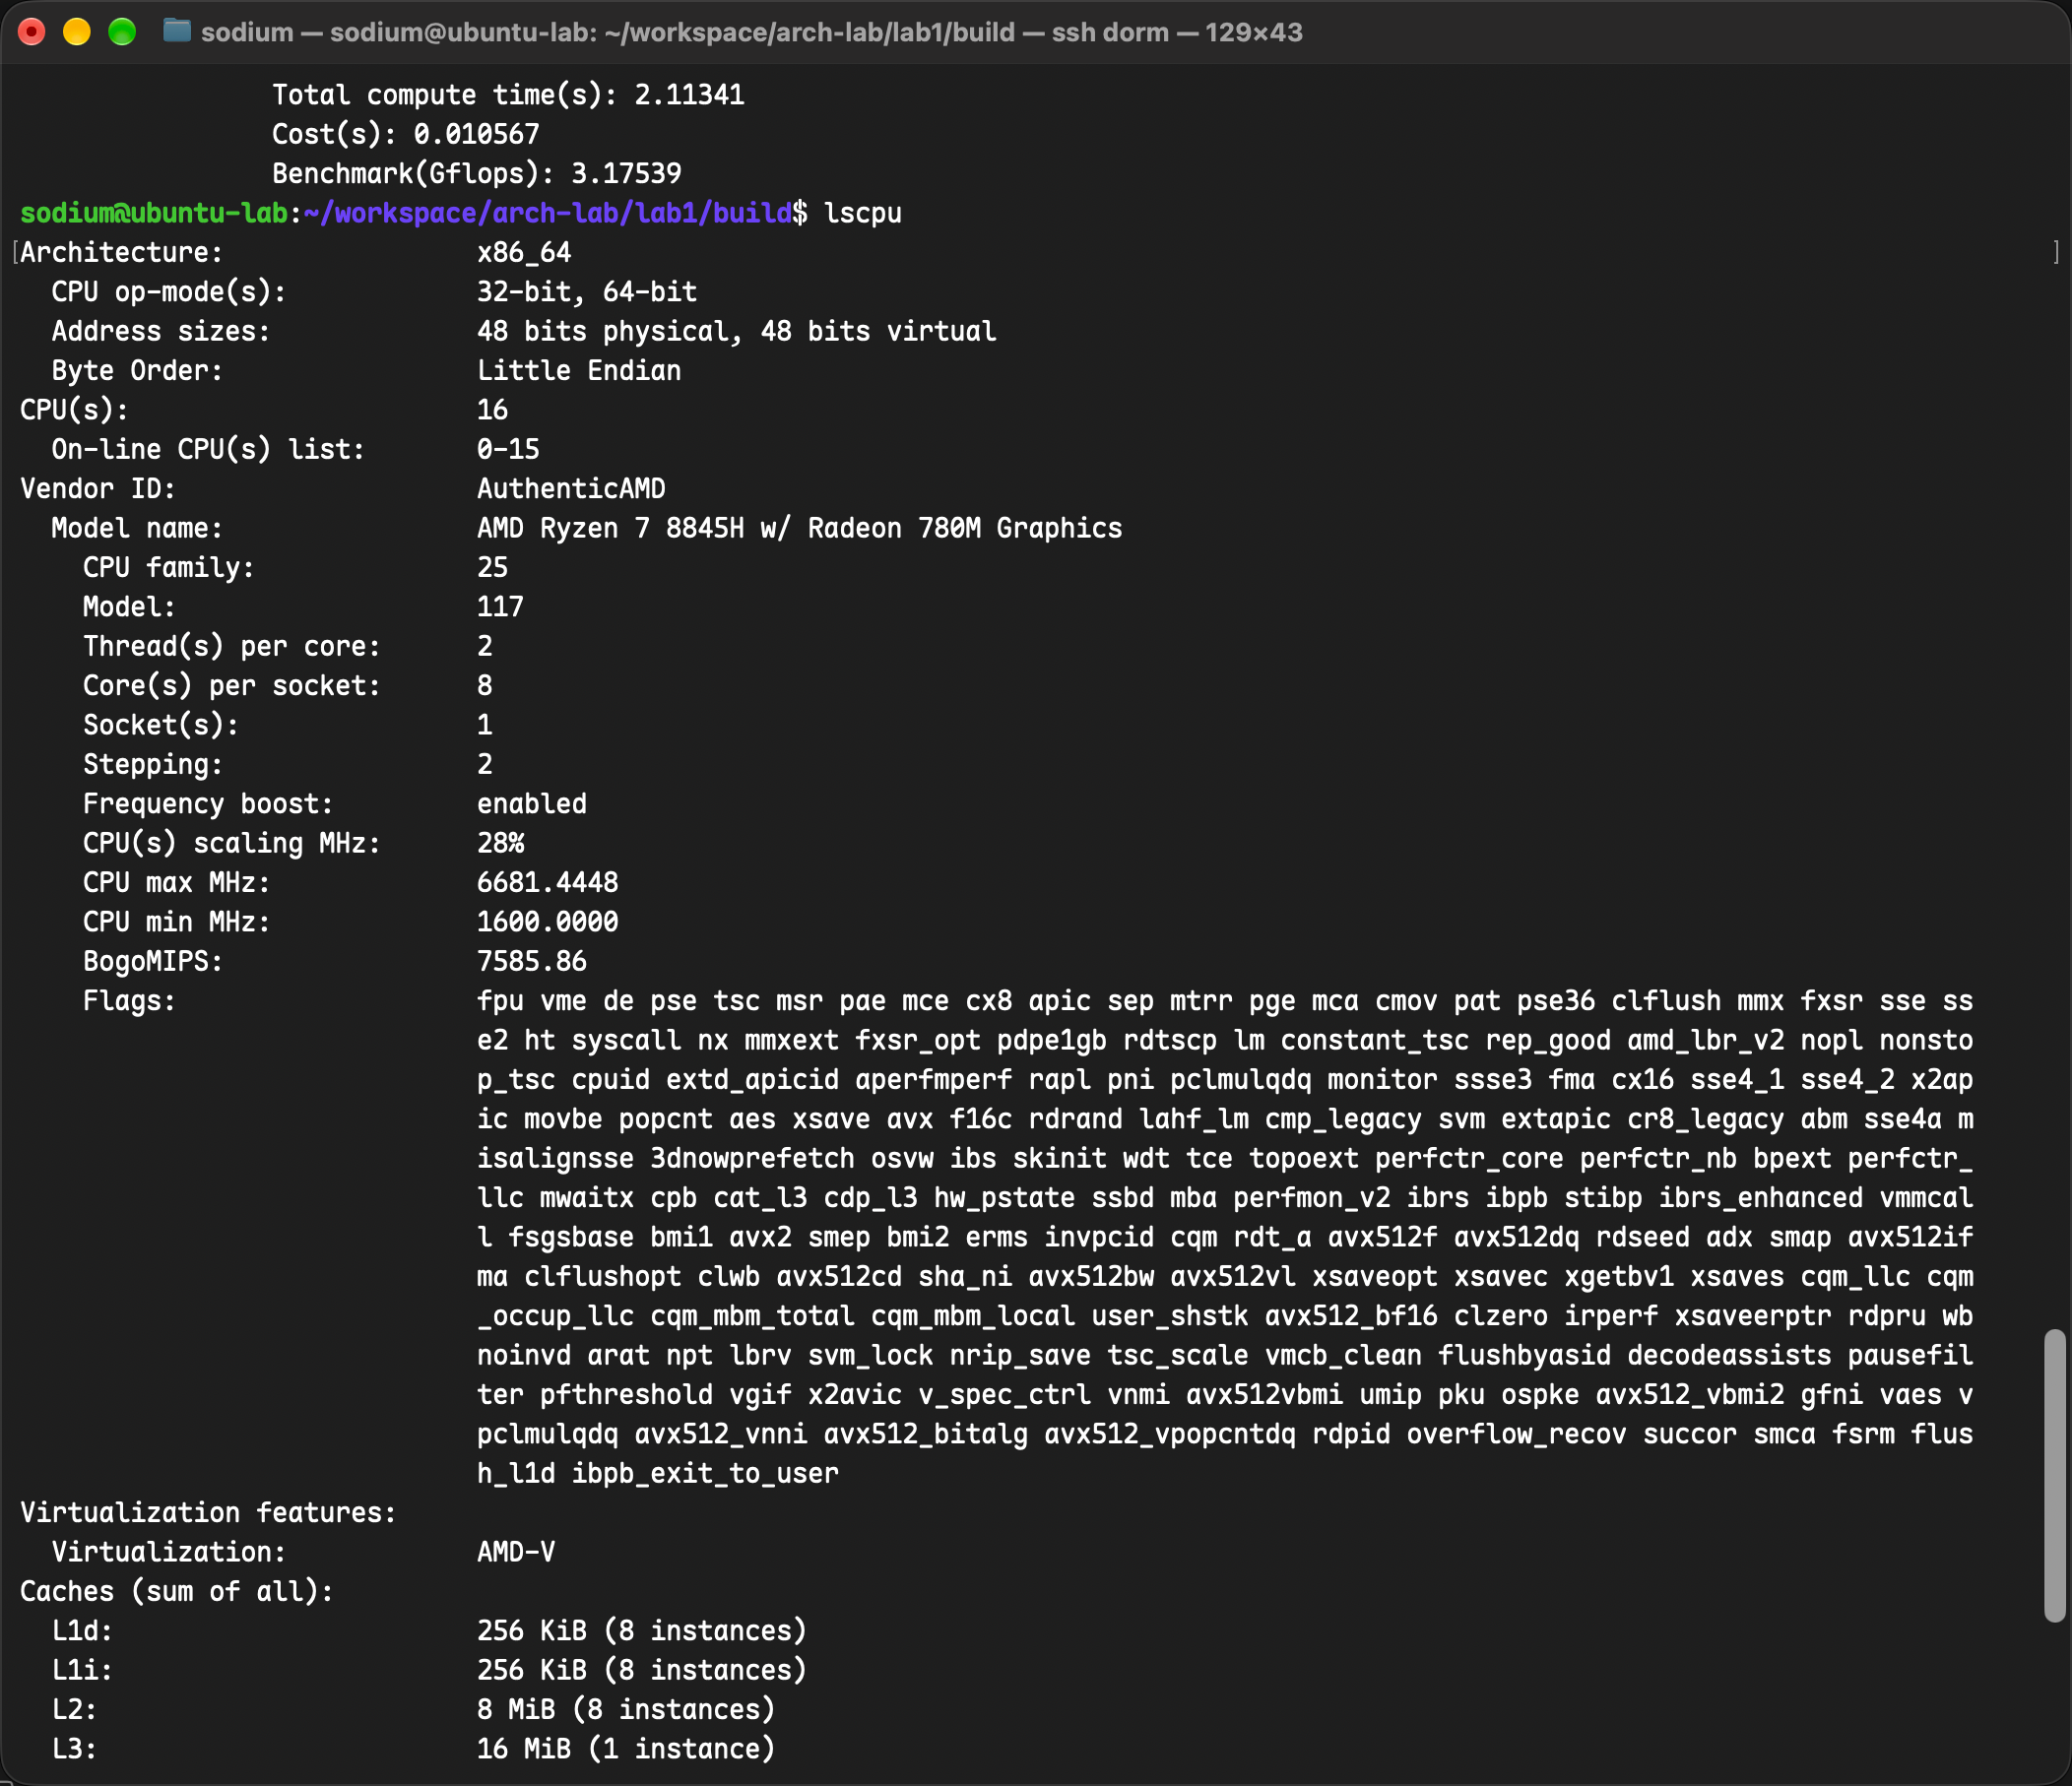
全部信息放在附录了,这里可以查看到 CPU 信息和缓存信息
- CPU 信息:型号 Ryzen7 8845H,8 核心 16 线程
- 缓存信息:L1D 和 L1I 都是 256KiB,L2 8MiB,L3 共享 16MiB
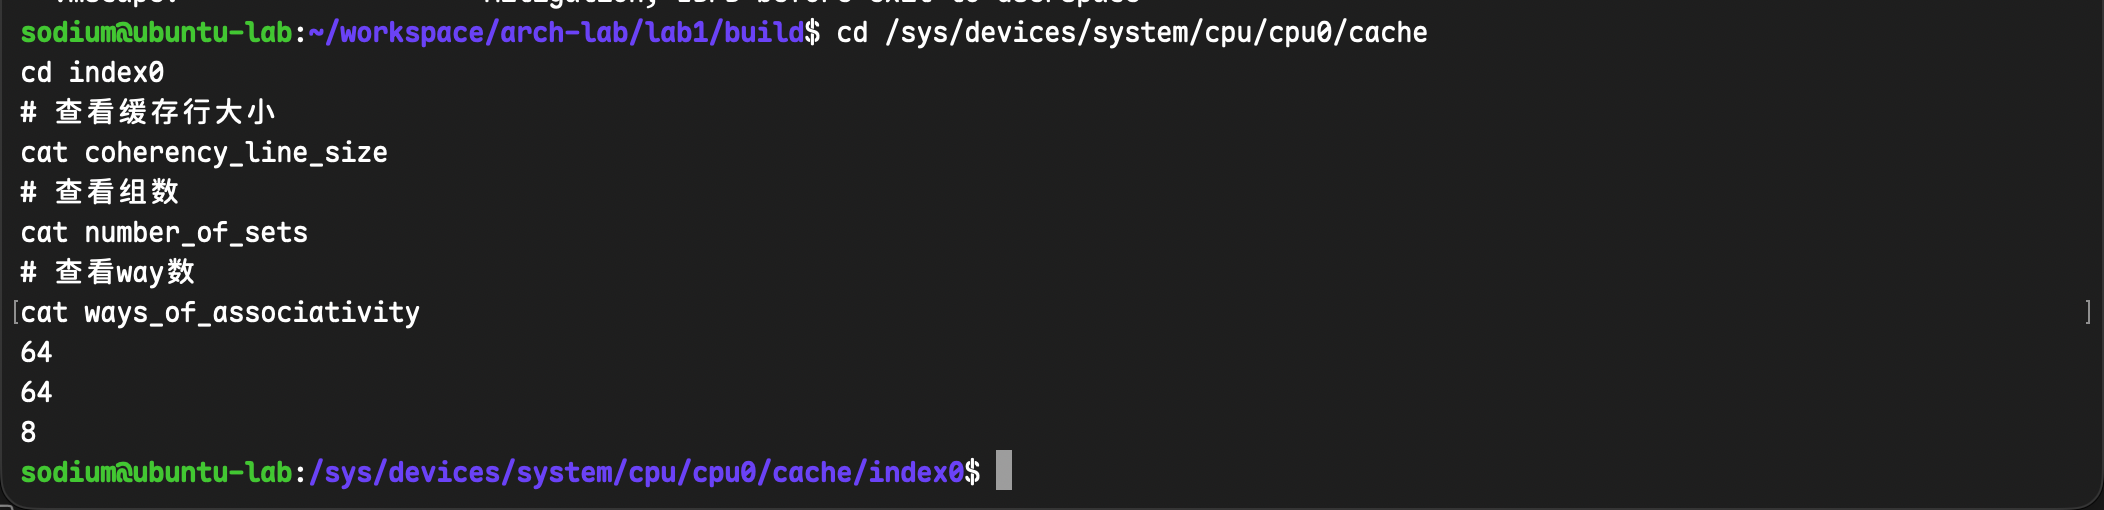
查看cpu0的L1D缓存的组数、组相联数和缓存行大小
cd /sys/devices/system/cpu/cpu0/cache
cd index0
# 查看缓存行大小
cat coherency_line_size
# 查看组数
cat number_of_sets
# 查看way数
cat ways_of_associativity
/sys/devices/system/cpu/cpu0/cache/index0$ ls
coherency_line_size  physical_line_partition  type
id                   shared_cpu_list          uevent
level                shared_cpu_map           ways_of_associativity
number_of_sets       size
可以看到 index0 下有很多东西可以查询,它们的含义如下
| 文件 | 含义 | 典型值 |
|---|---|---|
level | 缓存层级 | 1 / 2 / 3 |
type | 缓存类型 | Data / Instruction / Unified |
size | 缓存大小 | 32K / 256K / 8M |
coherency_line_size | 缓存行大小 | 64 |
ways_of_associativity | 相联度 | 8 |
number_of_sets | 组数 | 64 |
shared_cpu_list | 共享该缓存的 CPU 列表 | 0 或 0-3 |
shared_cpu_map | 共享 CPU 位图 | 1 或 f |
id | 缓存实例 ID | 0 |
physical_line_partition | 物理行分区 | 1 |
uevent | 内核 uevent 接口 | 一般忽略 |
使用相同的方法查看L2, L3缓存的组数、组相联数和缓存行大小
cd /sys/devices/system/cpu/cpu0/cache
cd index0 && cat level && cat type && cat coherency_line_size && cat number_of_sets && cat ways_of_associativity && cd ..
cd index1 && cat level && cat type && cat coherency_line_size && cat number_of_sets && cat ways_of_associativity && cd ..
cd index2 && cat level && cat type && cat coherency_line_size && cat number_of_sets && cat ways_of_associativity && cd ..
cd index3 && cat level && cat type && cat coherency_line_size && cat number_of_sets && cat ways_of_associativity && cd ..
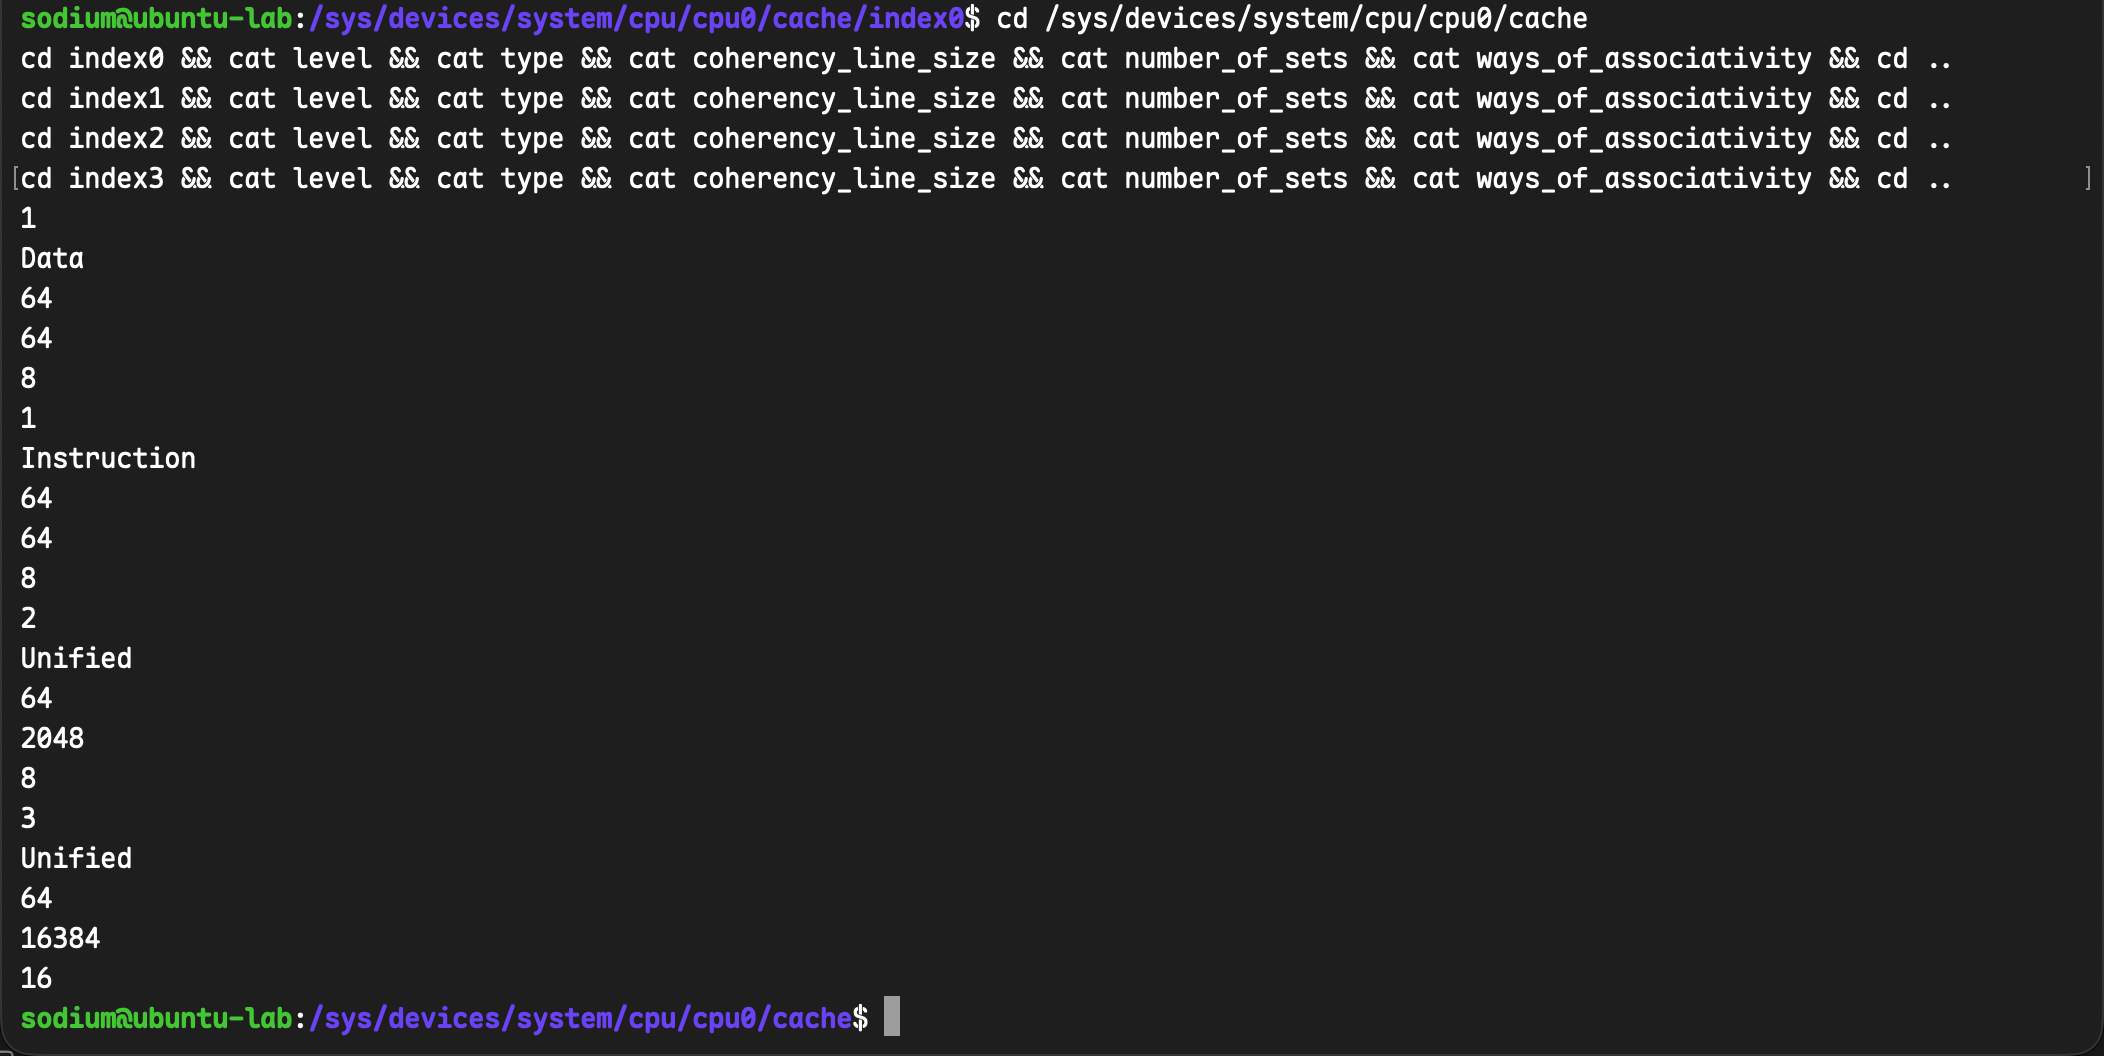
可以看到 cacheline 大小都是 64 Bytes
| Cache Index | Level | Type | Coherency Line Size | Number of Sets | Ways of Associativity |
|---|---|---|---|---|---|
| index0 | 1 | Data | 64 | 64 | 8 |
| index1 | 1 | Instruction | 64 | 64 | 8 |
| index2 | 2 | Unified | 64 | 2048 | 8 |
| index3 | 3 | Unified | 64 | 16384 | 16 |
练习4:perf 查看程序性能
查看 perf 支持的性能事件
sudo perf list
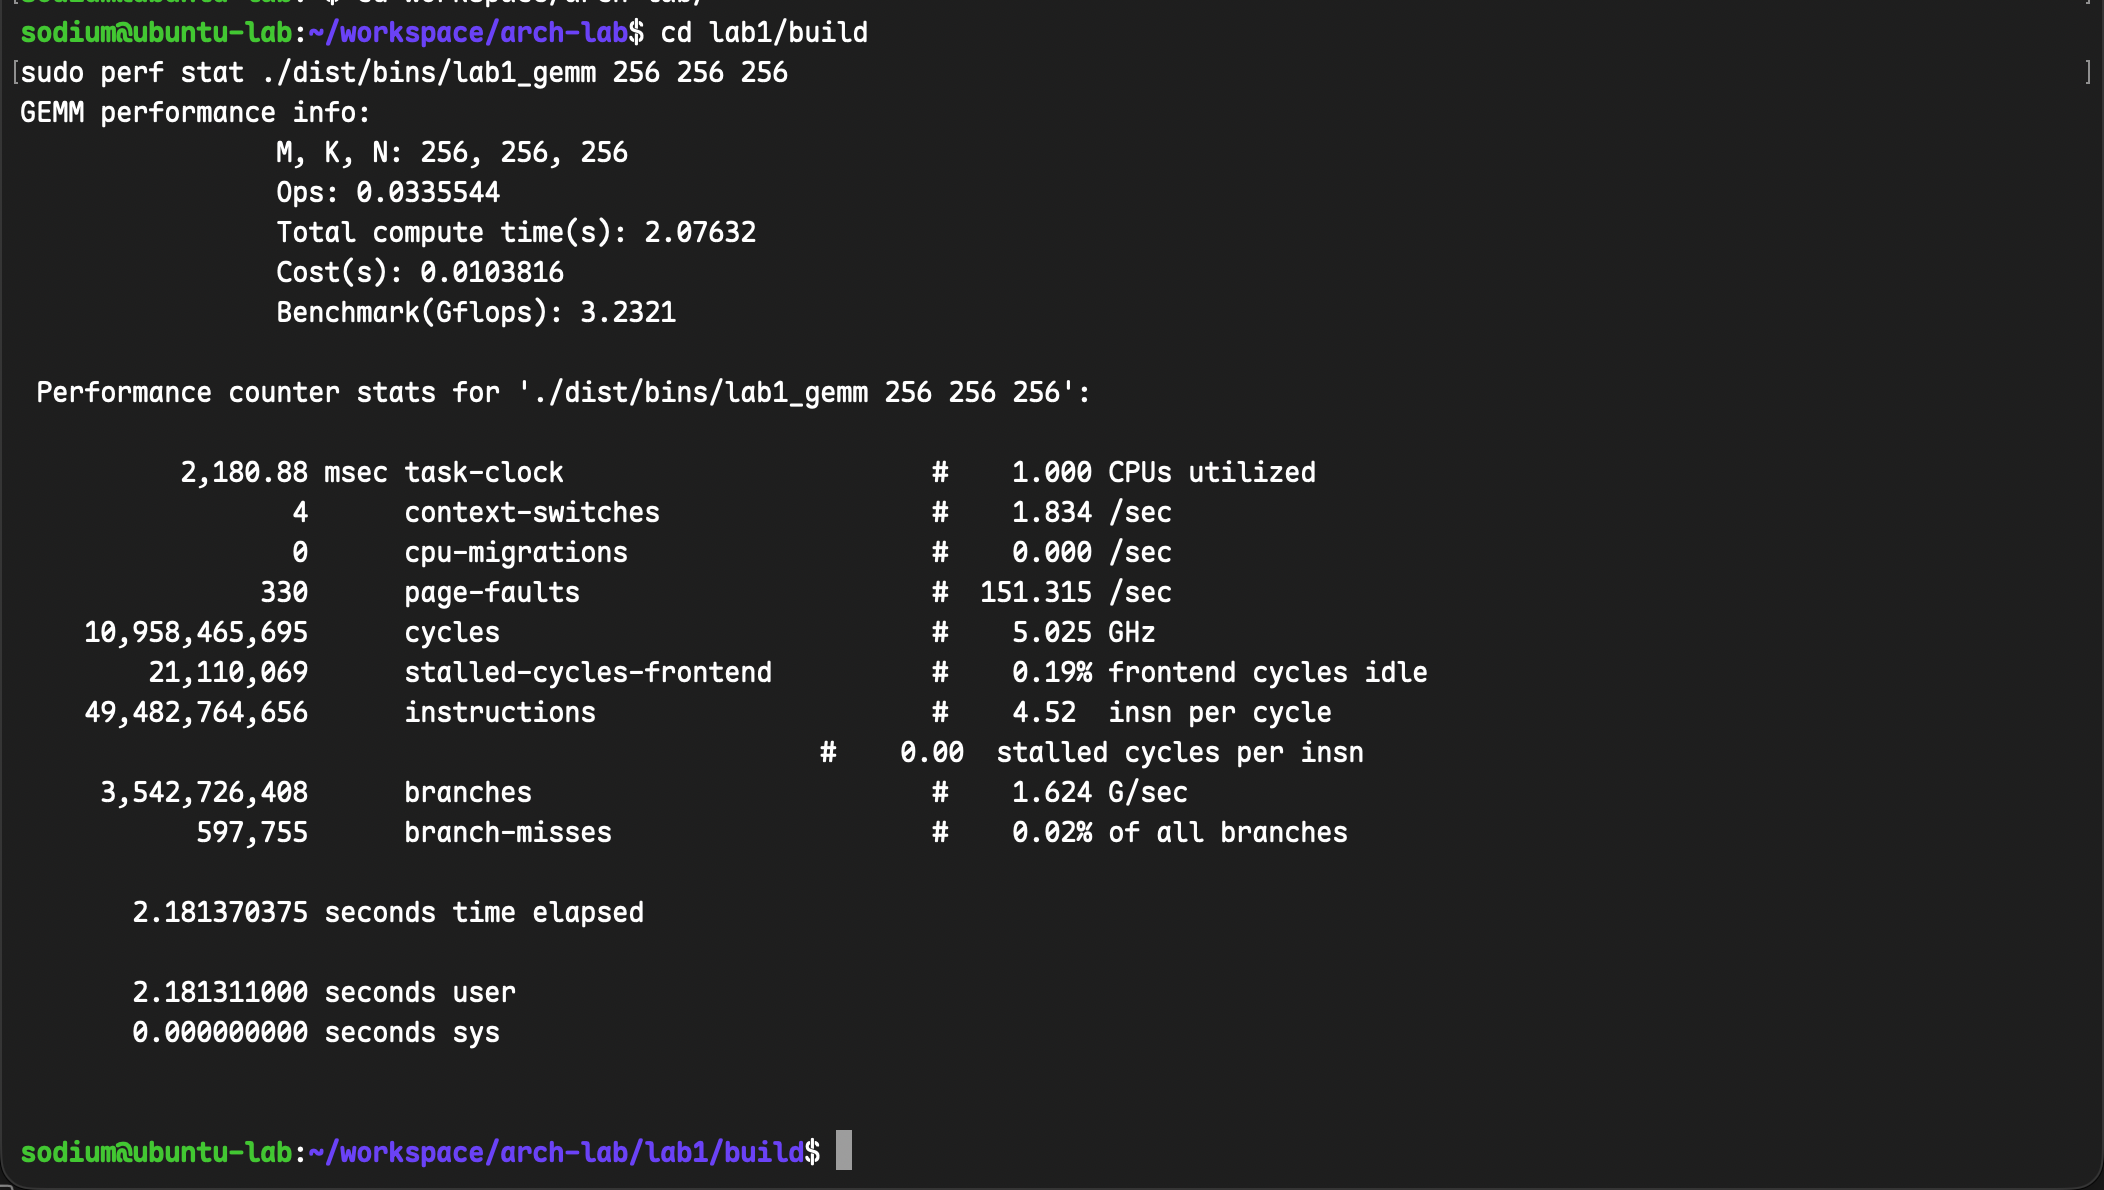
查看刚刚写的程序的基本性能事件
cd lab1/build
sudo perf stat ./dist/bins/lab1_gemm 256 256 256
查看指定的性能事件
sudo perf stat -e L1-dcache-loads,L1-dcache-load-misses,dTLB-loads,dTLB-load-misses ./dist/bins/lab1_gemm 256 256 256
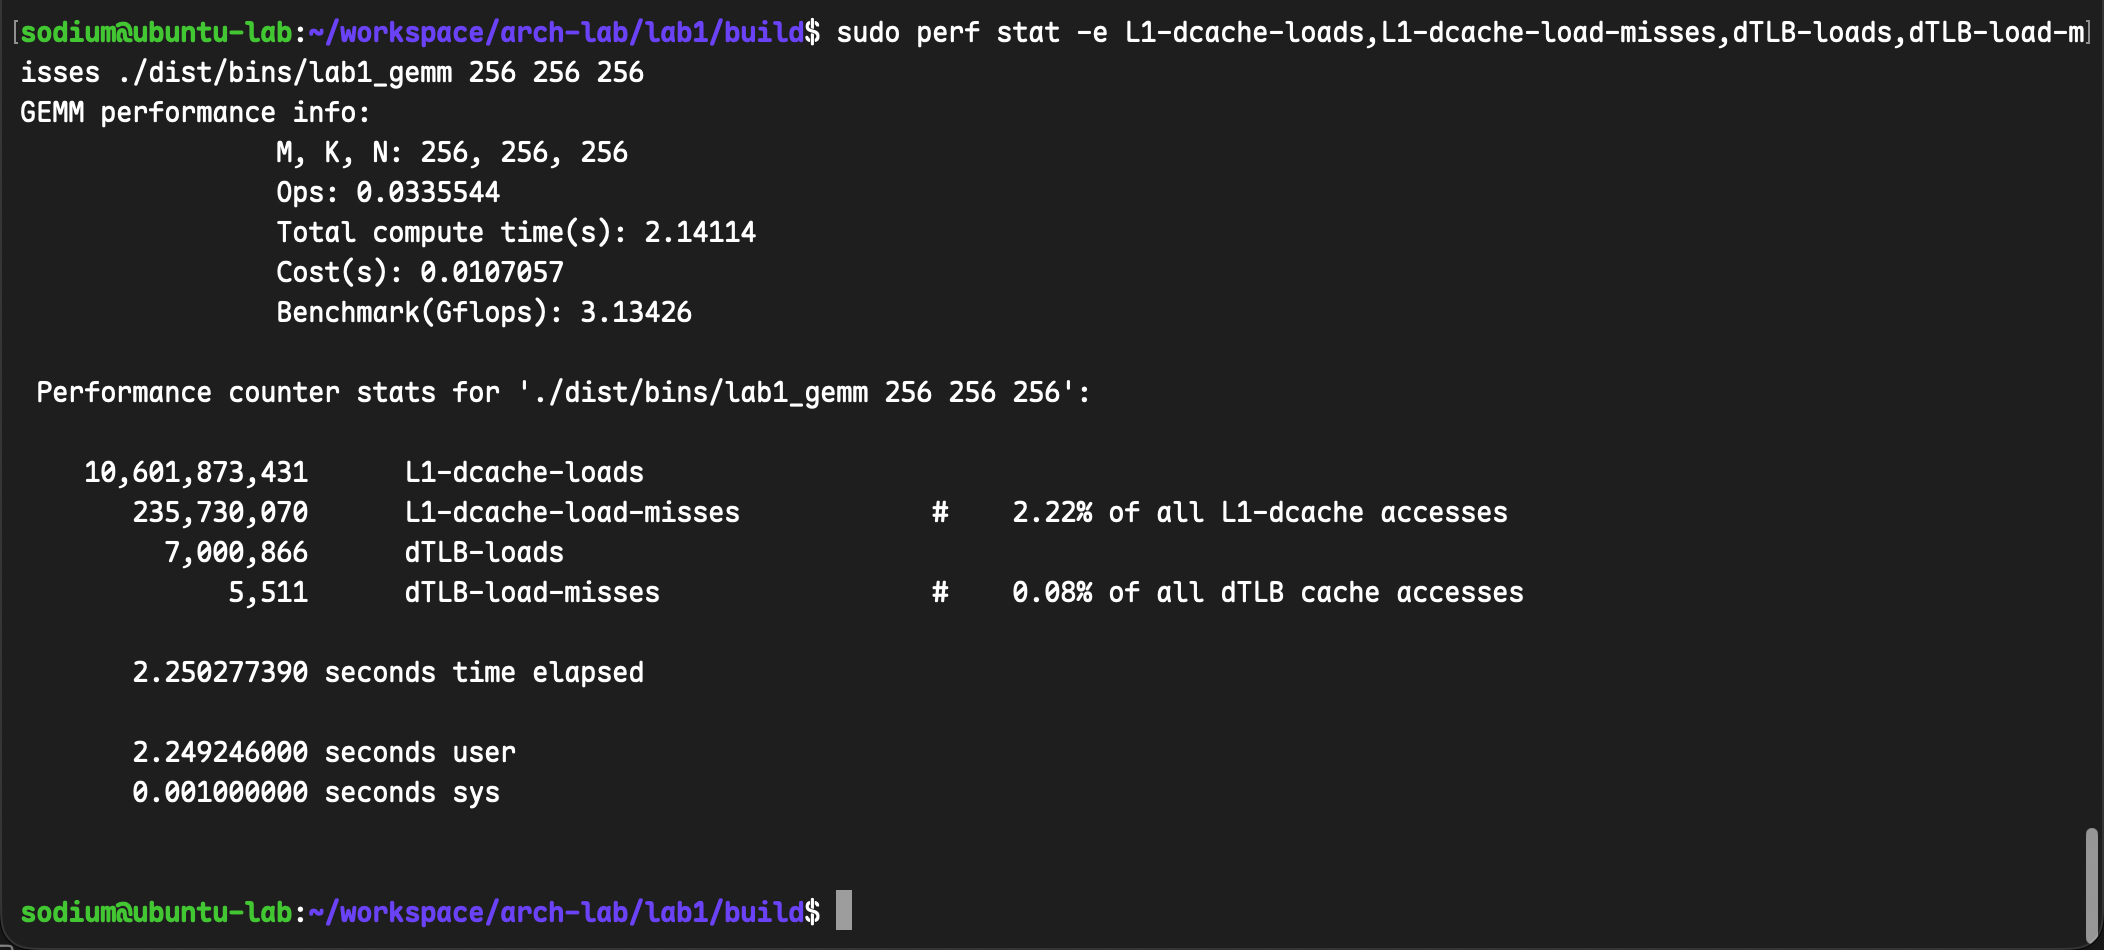
这里查看的是 L1D 和 dTLB 的总加载次数和未命中次数,可以看到 L1D 命中率低于 dTLB
实验二:使用Cache优化矩阵乘法
实验二内容如下
- 利用性能分析工具
perf分析基线程序的性能瓶颈 - 利用预取优化性能
- (选做):利用循环和分块提升计算性能
练习一:利用 perf 分析 lab2_gemm_baseline.S 的性能瓶颈
编译基线程序并进行分析
cd lab2
mkdir -p build && cd build
cmake -B . -S ../ && cmake --build ./ --target lab2_gemm_baseline
sudo perf stat -e L1-dcache-loads,L1-dcache-load-misses ./dist/bins/lab2_gemm_baseline 256 1024 256
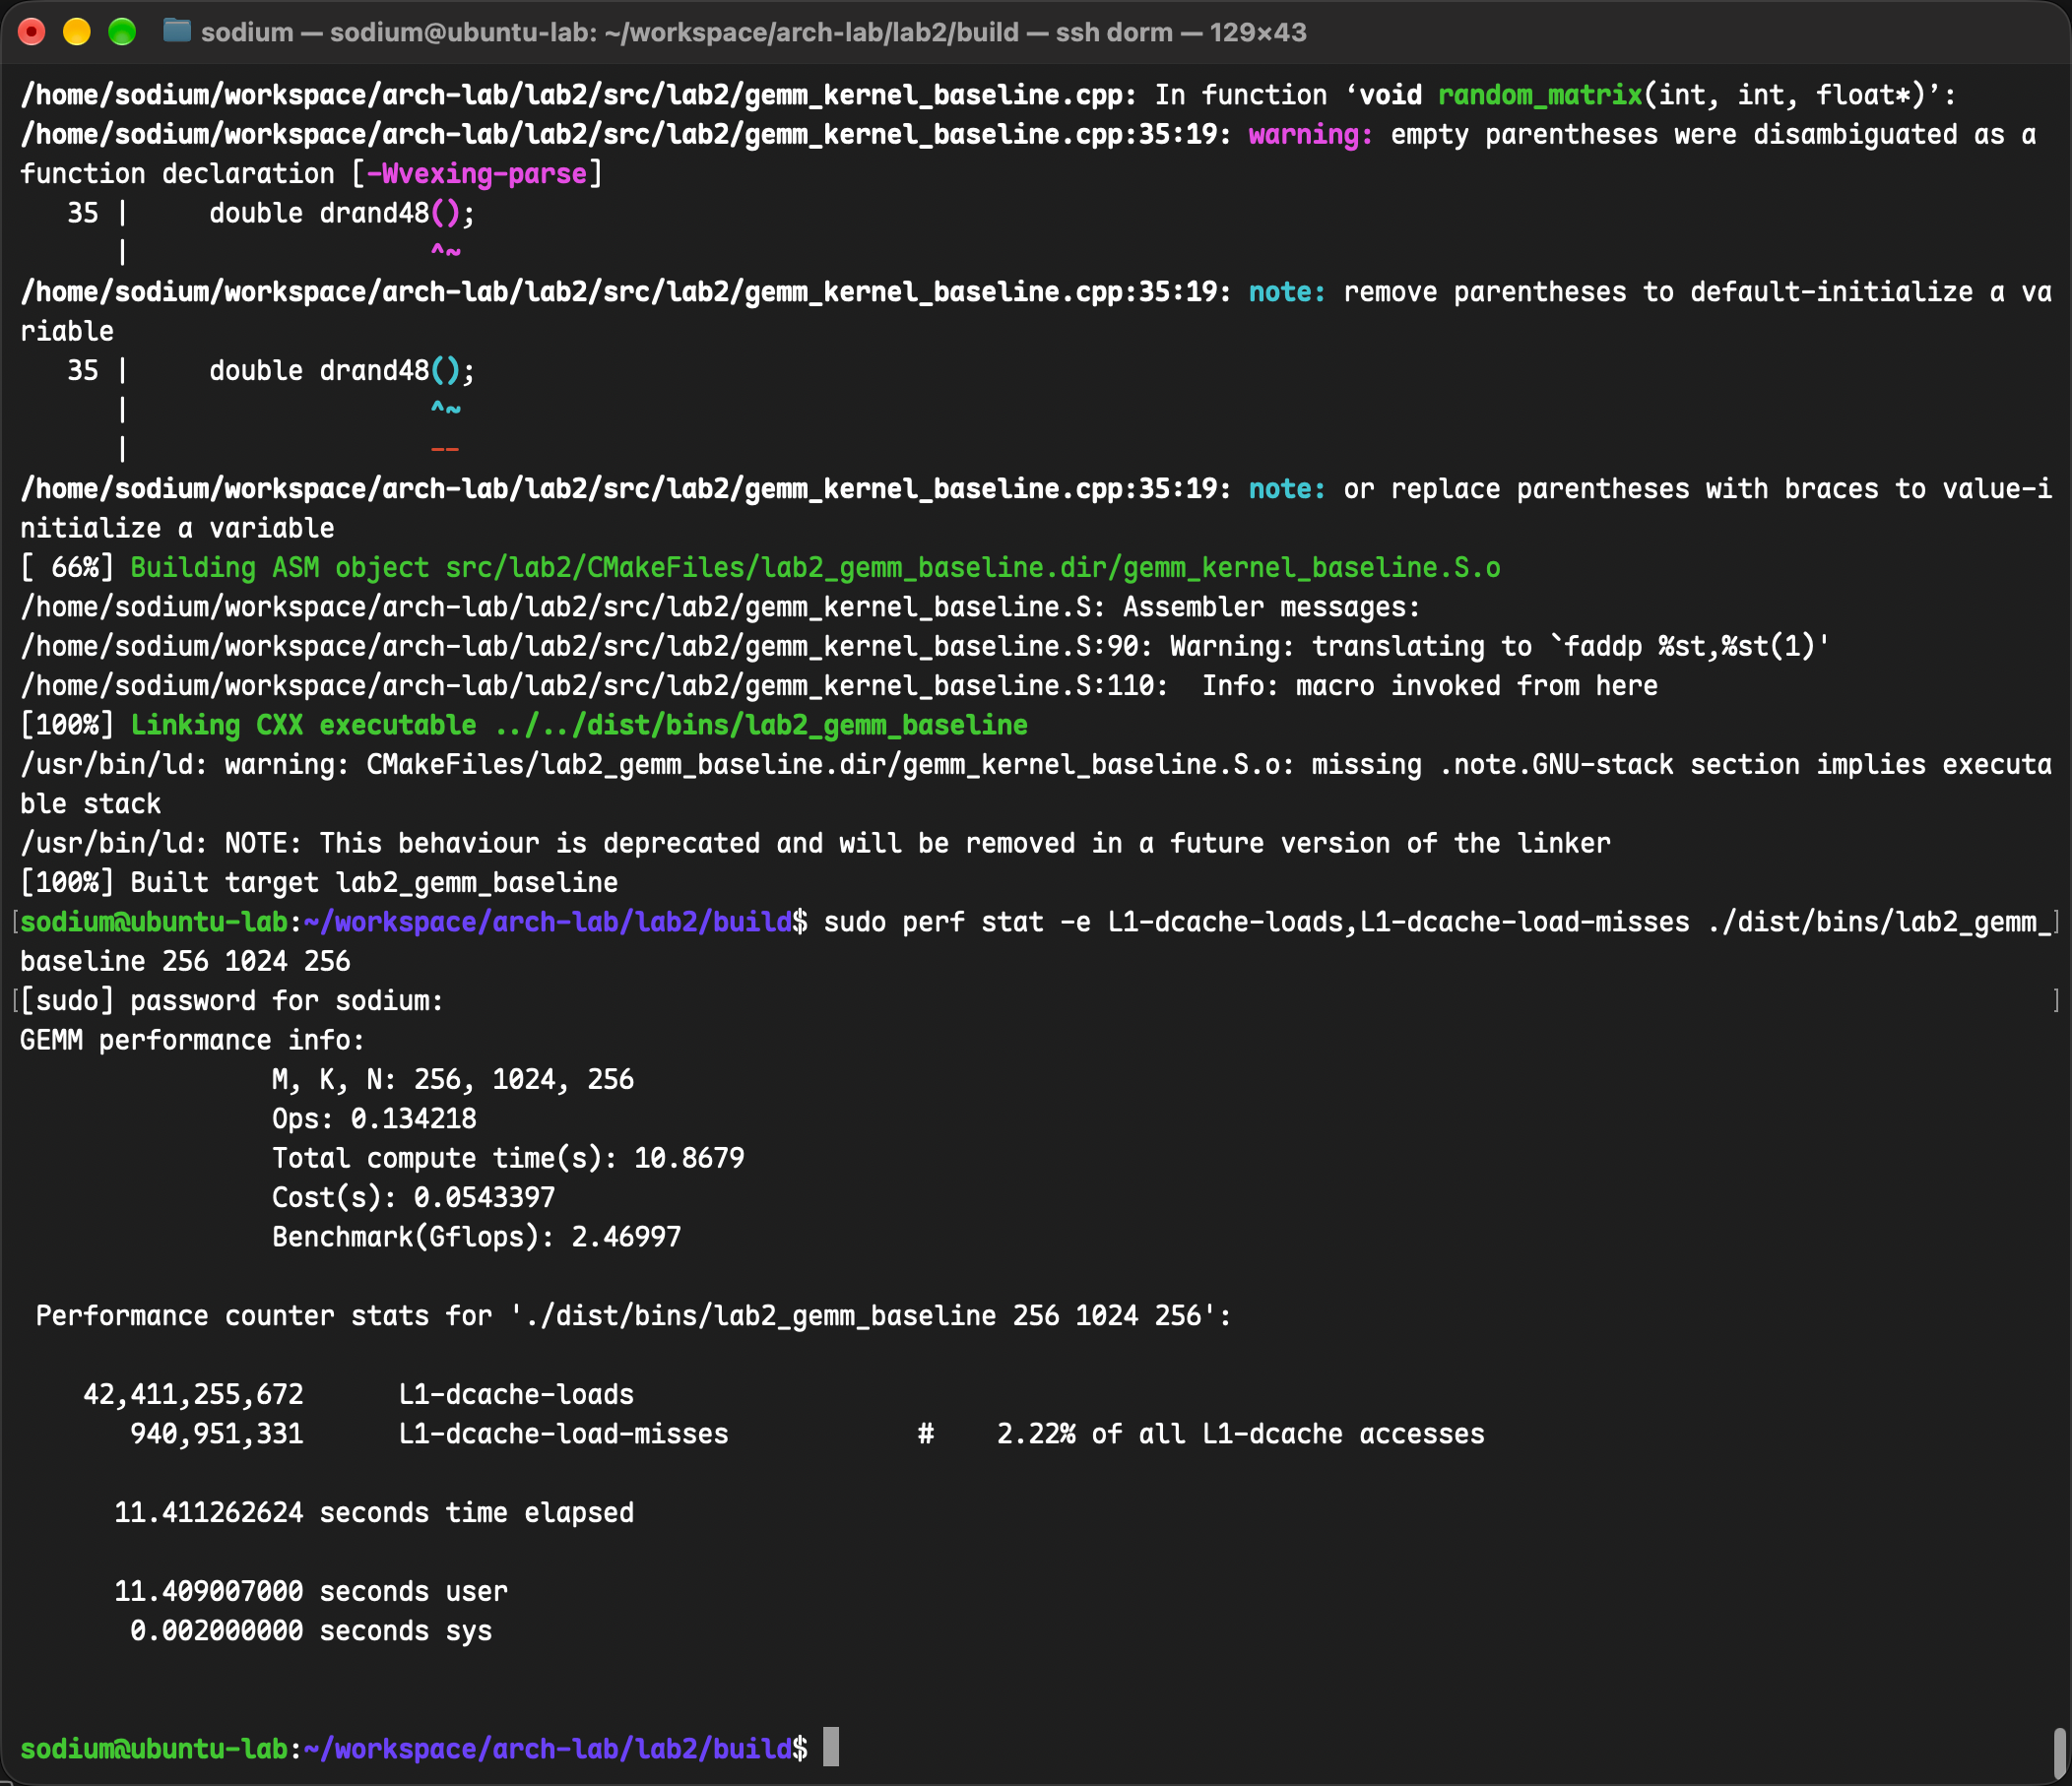
可以查看其中的性能事件来判断什么地方造成了瓶颈,这里 L1-dcache 命中率稍微低了一点
练习二:利用预取优化性能
利用 lmbench3 获取各级缓存的访问延迟
cd lab2/tools && tar xf lmbench.tgz && cd lmbench
make results
# 涉及的参数选择
# MULTIPLE COPIES [default 1] 回车
# Job placement selection: 4
# MB [default 10956] 默认值会运行很久,可输入较小值后回车,如8192、4096等
# SUBSET (ALL|HARWARE|OS|DEVELOPMENT) [default all] HARWARE
# FASTMEM [default no] 回车
# SLOWFS [default no] yes
# DISKS [default none] 回车
# REMOTE [default none] 回车
# Processor mhz [default 2688 MHz, 0.3720 nanosec clock] 回车
# FSDIR [default /var/tmp] 回车
# Status output file [default /dev/tty] /tmp/lmbench.test
# Mail results [default yes] no

# 因为LMBENCH3对新系统的兼容问题,选择完后很快会失败,按下面的步骤继续操作即可
cp -a results ./bin/
make rerun

# 等待运行结束
mv results results.bak
cp -a ./bin/results ./
# 查看延迟信息(如果不够详细可以自行调整make results参数再进行测试)
cd results && make LIST=$(../scripts/os)/*
在 lab2/tools 目录下可以找到“10.251.137.194.0”文件,这是 make results 指令的输出文件,根据上述的指令将其放入正确位置并执行 make rerun 之后的步骤即可。
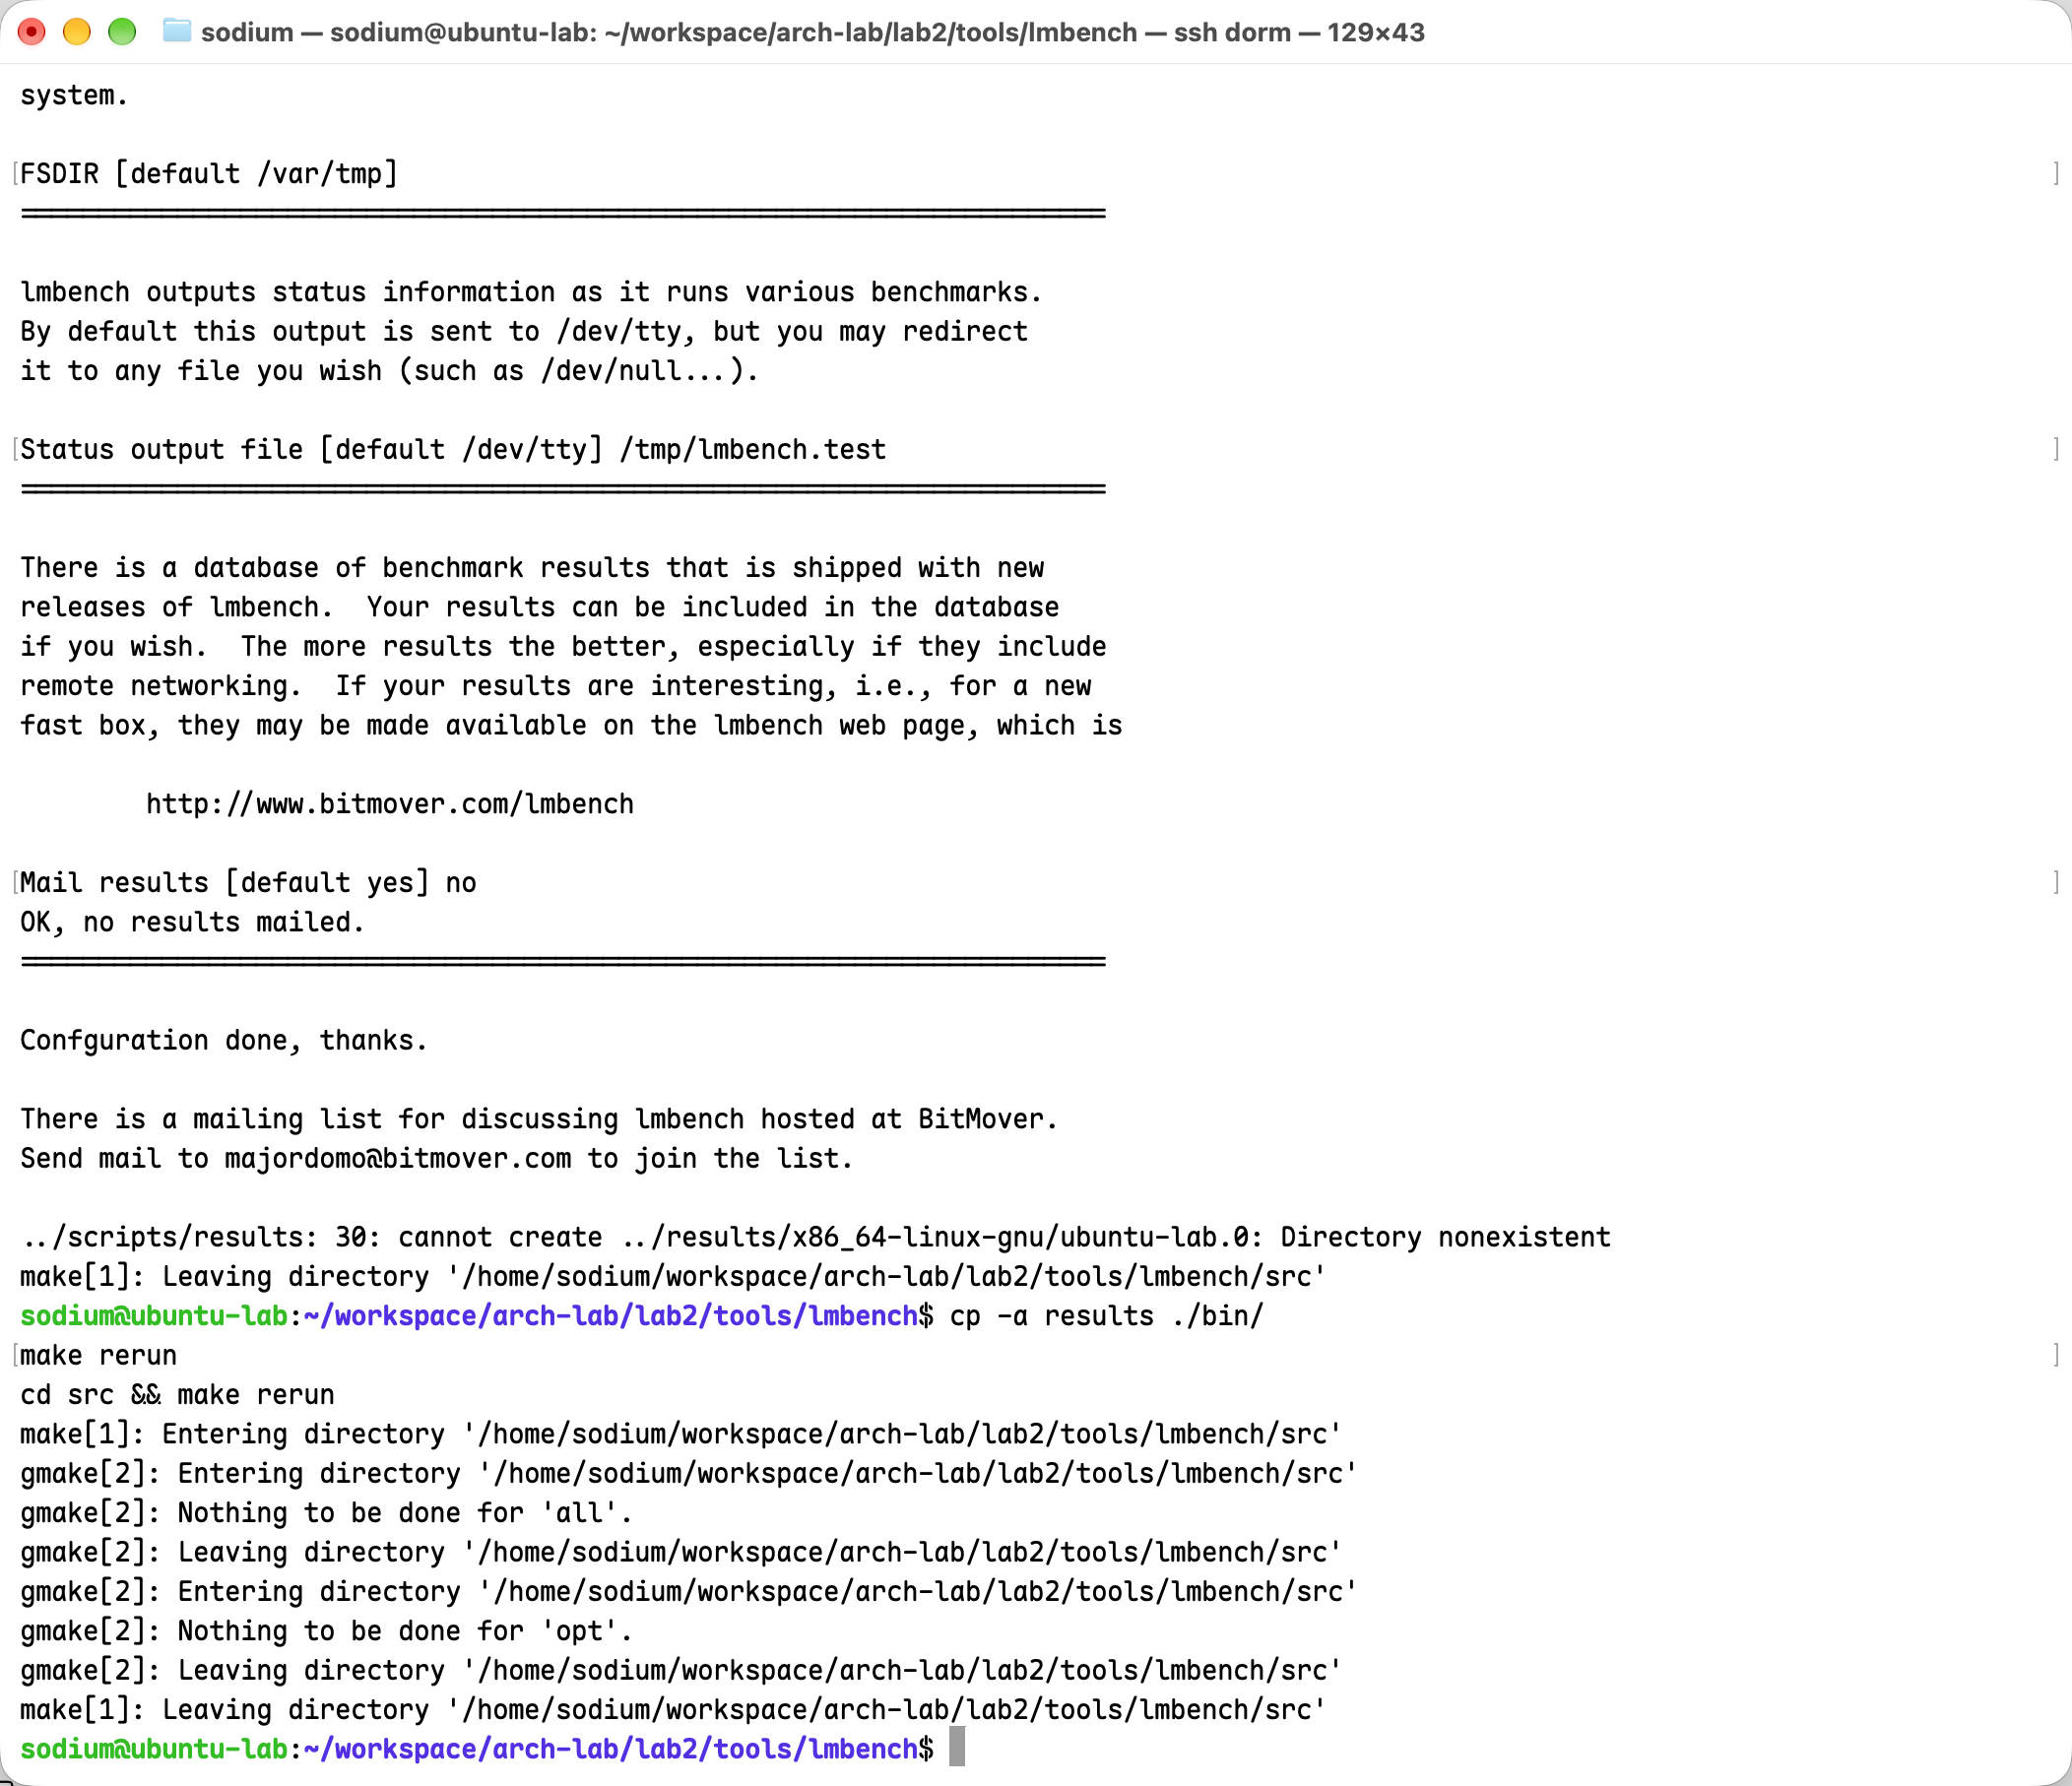
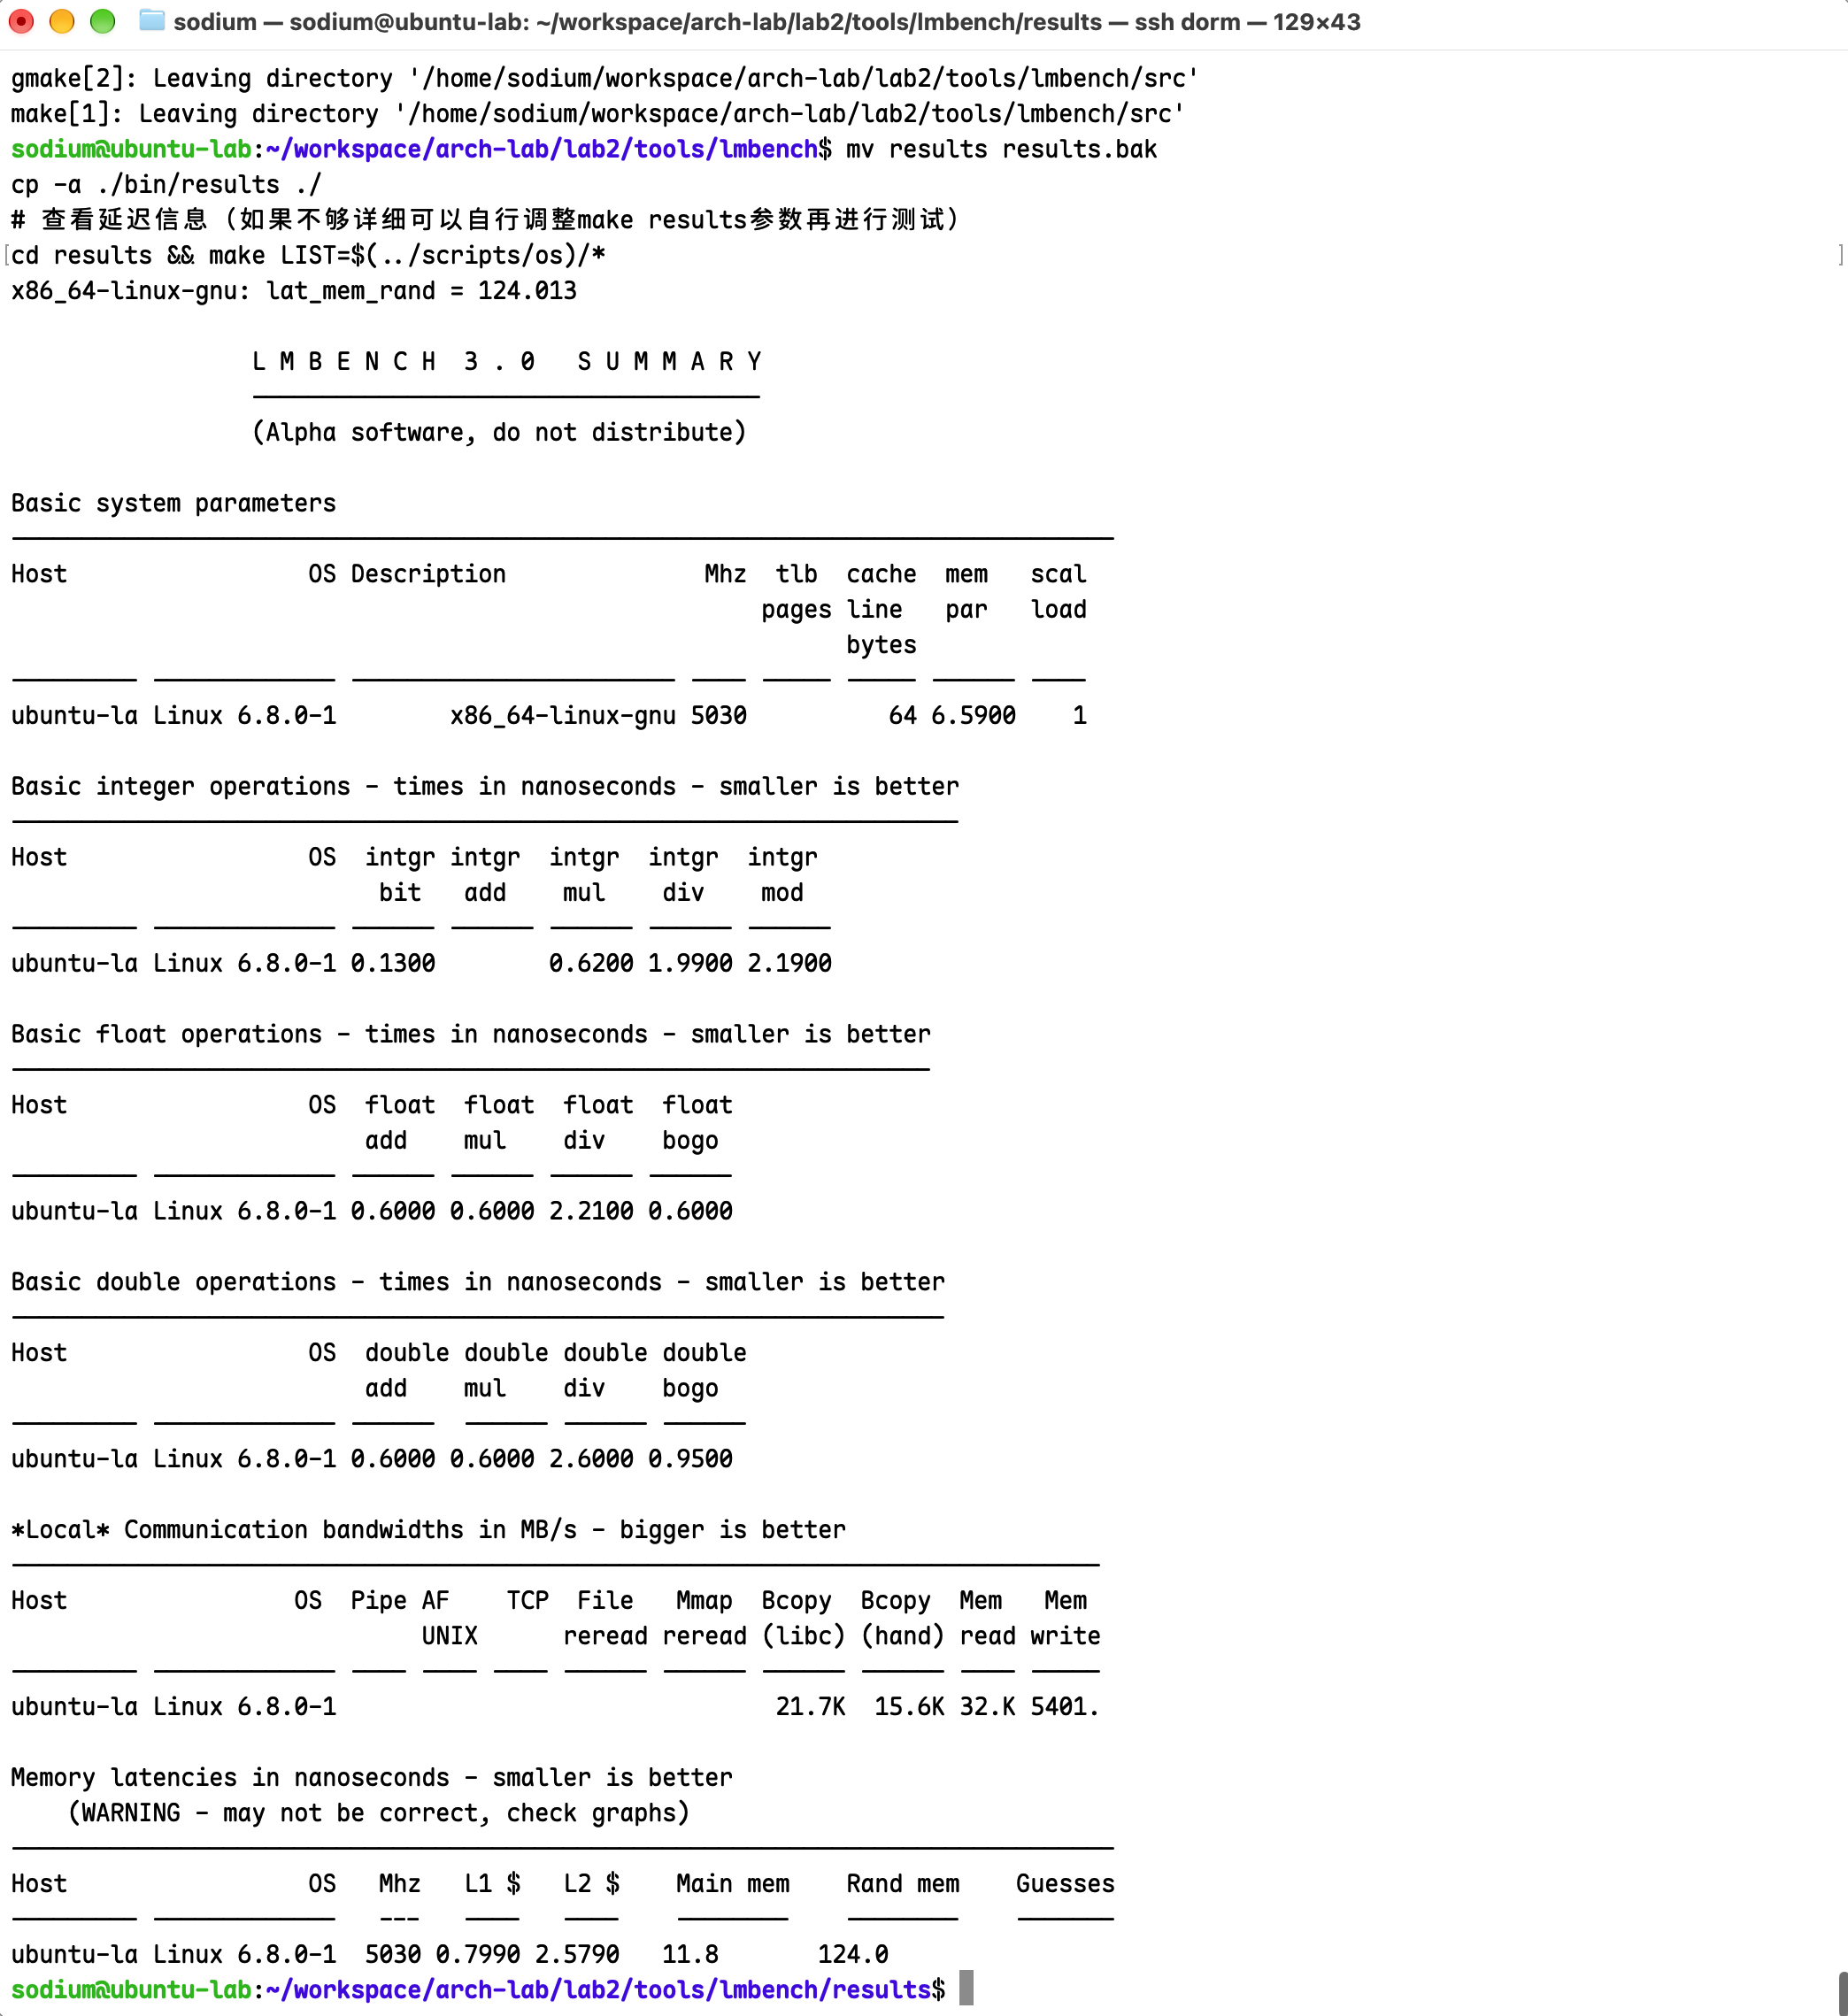
使用预取为练习1的代码增加数据预取优化
找到 lab2/src/lab2/gemm_kernel_opt_prefetch.S
.macro DO_GEMM
    // TODO
.endm
将 lab2/src/lab2/gemm_kernel_opt_baseline.S 的这部分代码复制过来然后进行修改即可
实际上 baseline 的代码就是实验一的答案,比如下面加载 A[m][k]
DO_LOOP_M:
    xor loop_n, loop_n
    mov loop_m, %rax
    mul DIM_K
    mov %rax, mat_elem_idx
    add loop_k, mat_elem_idx          // 计算 m*K+k
    flds (MAT_A, mat_elem_idx, 4)     // 加载 A[m][k]
int loop_k = loop_m = loop_n = 0;
unsigned int mat_elem_idx;
for (loop_k; loop_k < DIM_K, lopp_k++){
    for (loop_m; loop_m < DIM_M, loop_m++){
        mat_elem_idx = DIM_K * loop_m + loop_k;
        flds(A[mat_elem_idx]);                          // A[m][k]
        for (loop_n; loop_n < DIM_N; loop_n++){
            mat_elem_idx = DIM_N * loop_k + loop_n;     // B[k][n]
            flds(B[mat_elem_idx]);
            fmul(%st(1), %st(0));                       // A[m][k] * B[k][n]
            mat_elem_idx = DIM_N * loop_m + loop_n;     // C[m][n]
            flds(C[mat_elem_idx]);
            faddp(%st(1), %st(0));                      // A[m][k] * B[k][n] + C[m][n]
            fstps(C[mat_elem_idx]);
        }
        fstp(%st(0));
    }
}
分析循环的访存特征可以发现,矩阵 B 是顺序访问的(B[k][n], B[k][n+1],...),C也是同理(C[m][n],C[m][n+1],...),而矩阵 A 的访问则是跨行的,A[m][k], A[m+1][k],...
所以矩阵 A 的访存特征无法利用 Cacheline 的 Spatial Locality,考虑对其进行预取
DO_LOOP_M:
    xor loop_n, loop_n

    mov loop_m, %rax
    mul DIM_K
    mov %rax, mat_elem_idx
    add loop_k, mat_elem_idx                    // 计算 m*K+k

    prefetcht0 512(MAT_A, mat_elem_idx,4)       // prefetch A[mat_elem_idx*4 + 512]

    flds (MAT_A, mat_elem_idx, 4)               // 加载 A[m][k]
针对 m=1024 k=128 n=16 的输入进行优化,矩阵 A 是 1024 行,128列的,如果要预取 A[m+1][k] 就要在原地址上加 128 * 4,也就是 512.
参考 L1D Cacheline 大小是 64 字节
编译运行
cd lab2/build
cmake -B . -S ../ && cmake --build ./ --target lab2_gemm_kernel_opt_prefetch.unittest
./dist/bins/lab2_gemm_kernel_opt_prefetch.unittest
cmake -B . -S ../ && cmake --build ./ --target lab2_gemm_opt_prefetch
./dist/bins/lab2_gemm_opt_prefetch 1024 128 16
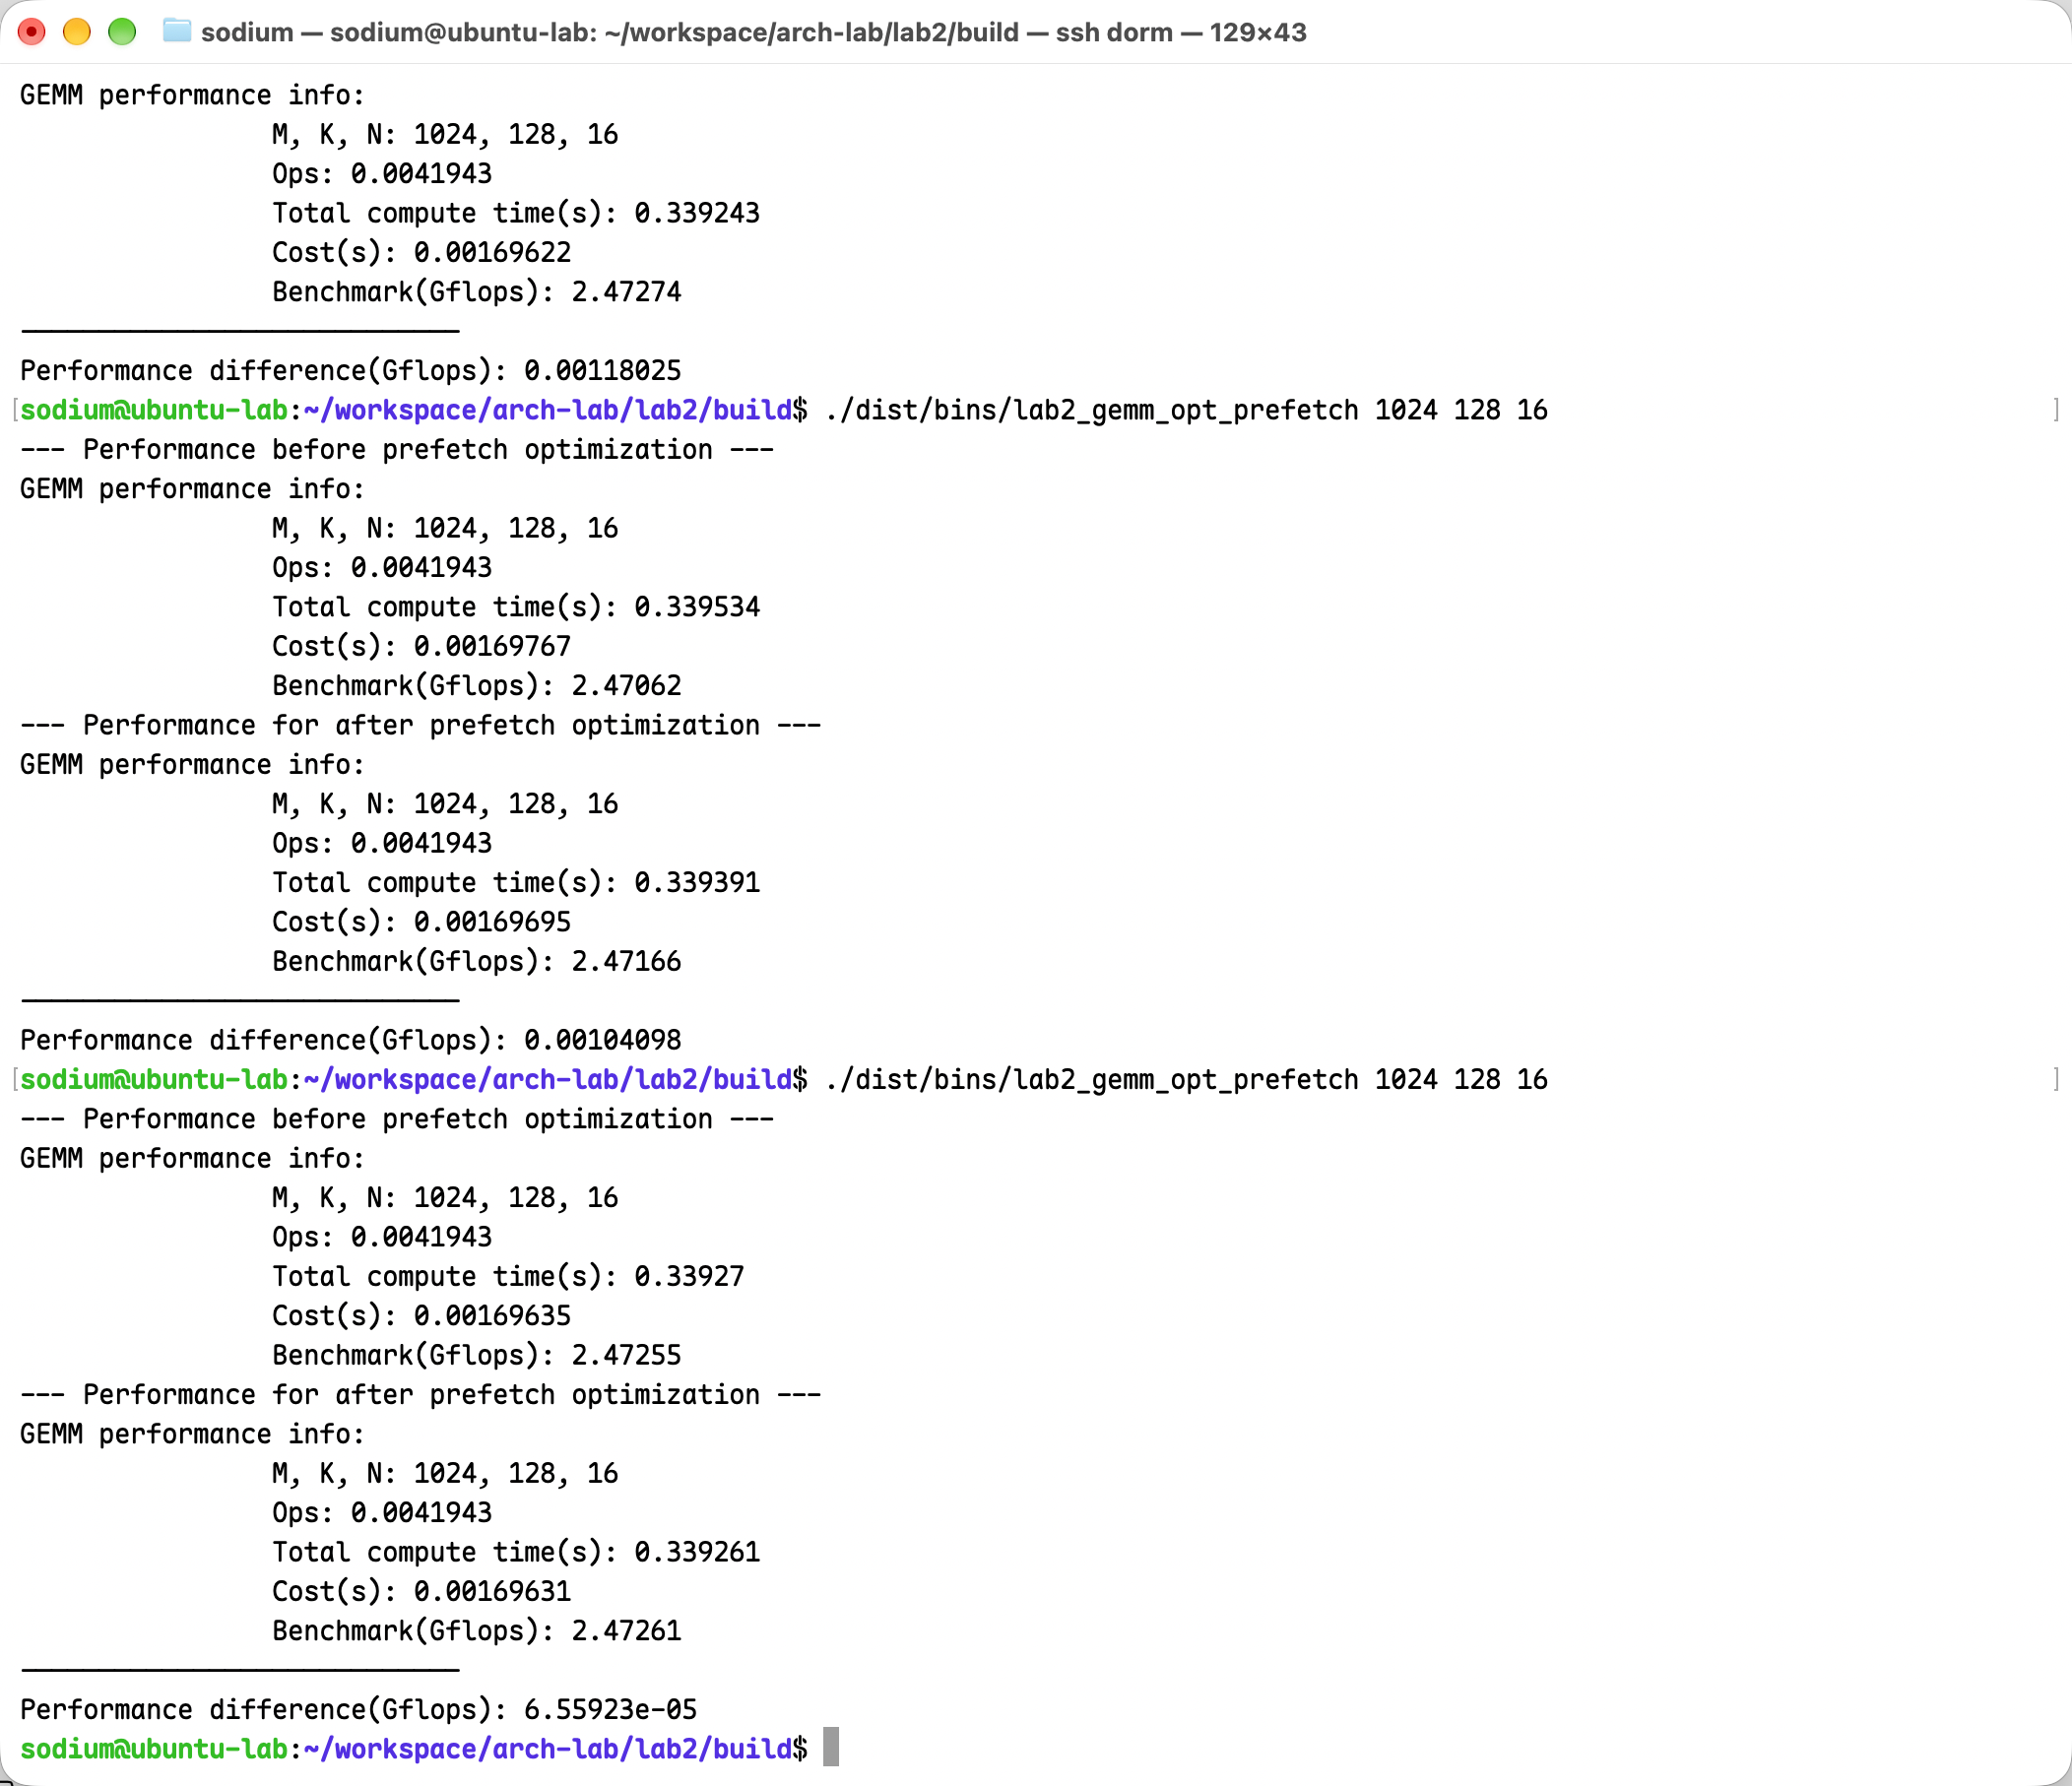
结果存在一定波动,不能证明有明显的优化
考虑预取 A[m+2][k]
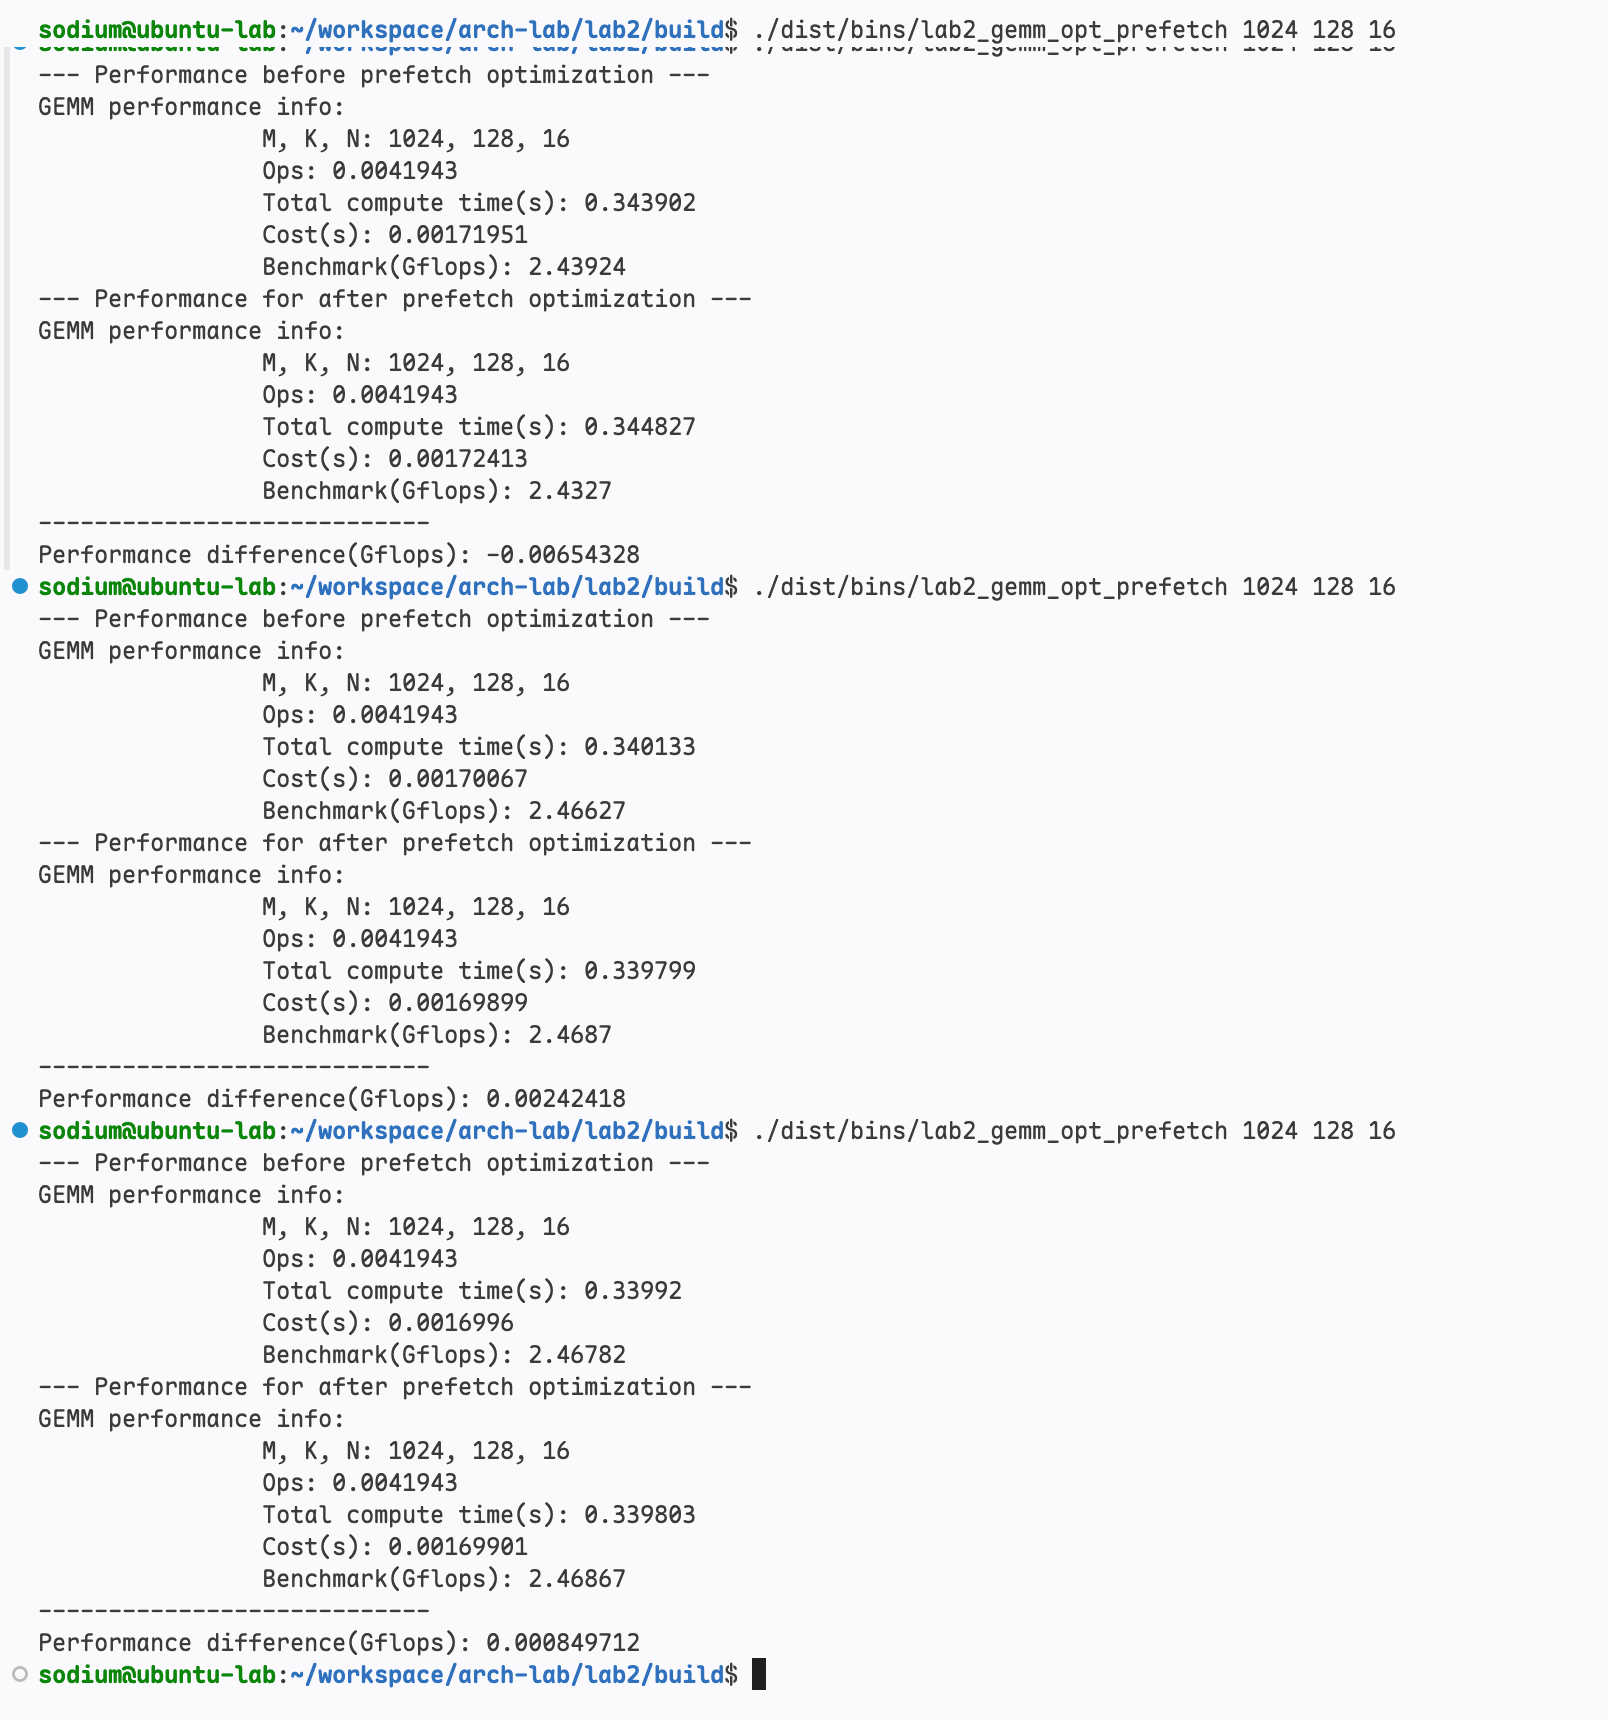
尝试使用 perf 检查预取是否提高了命中率
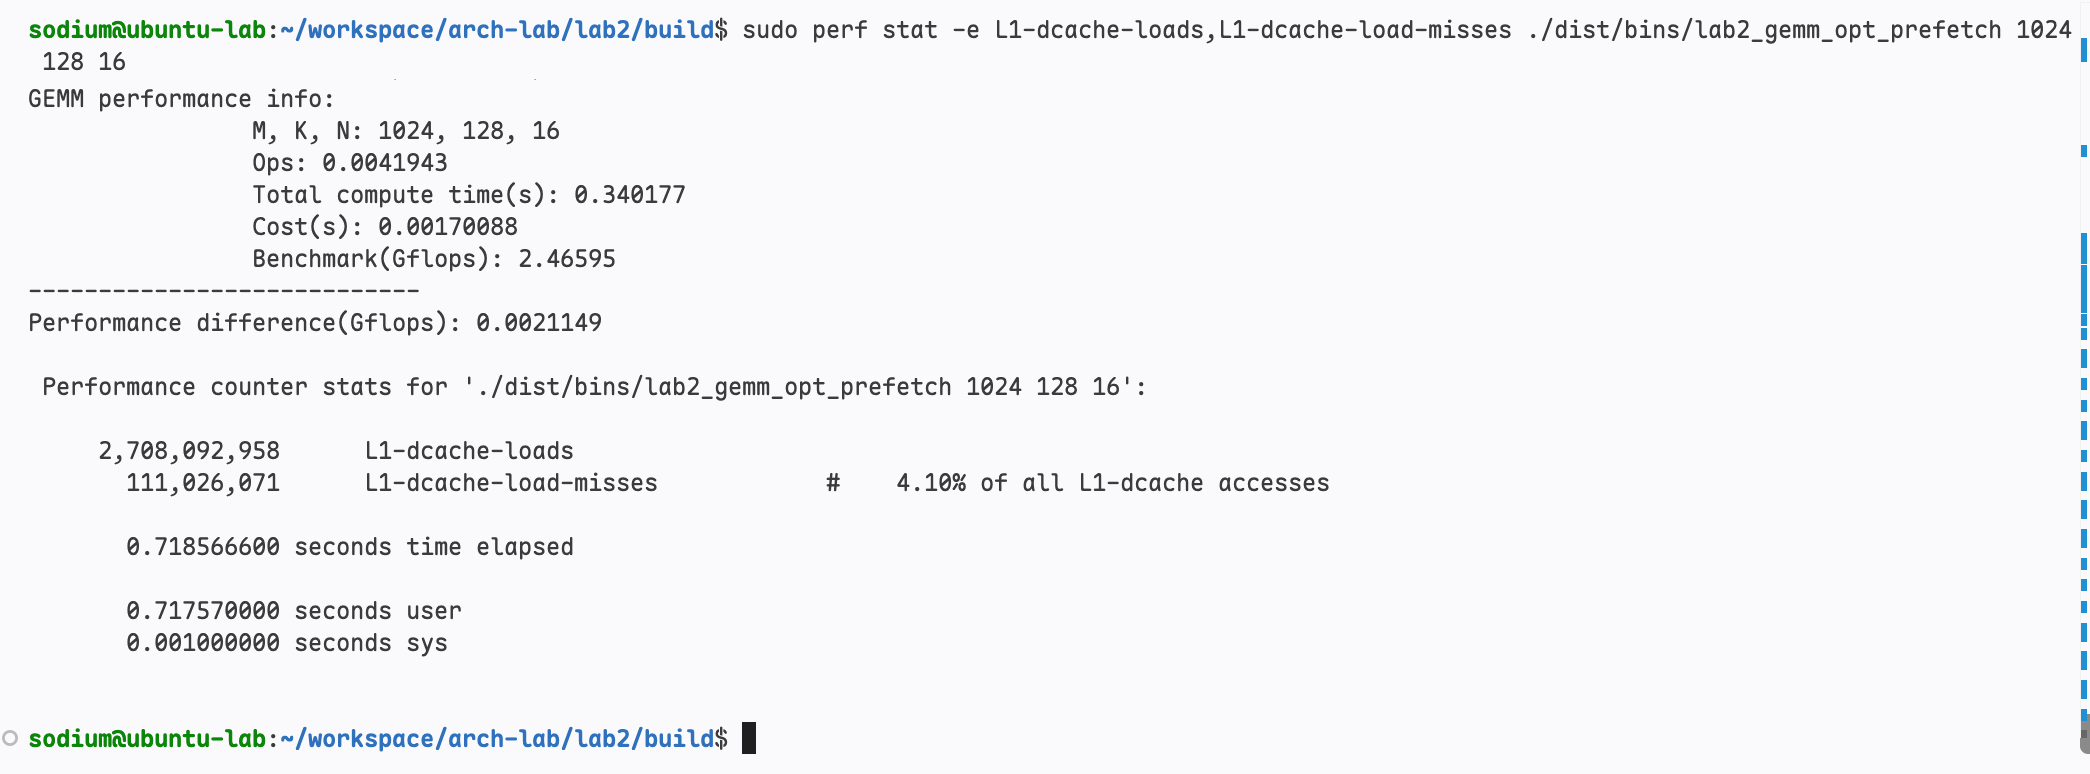
sudo perf stat -e L1-dcache-loads,L1-dcache-load-misses ./dist/bins/lab2_gemm_baseline 1024 128 16
sudo perf stat -e L1-dcache-loads,L1-dcache-load-misses ./dist/bins/lab2_gemm_opt_prefetch 1024 128 16
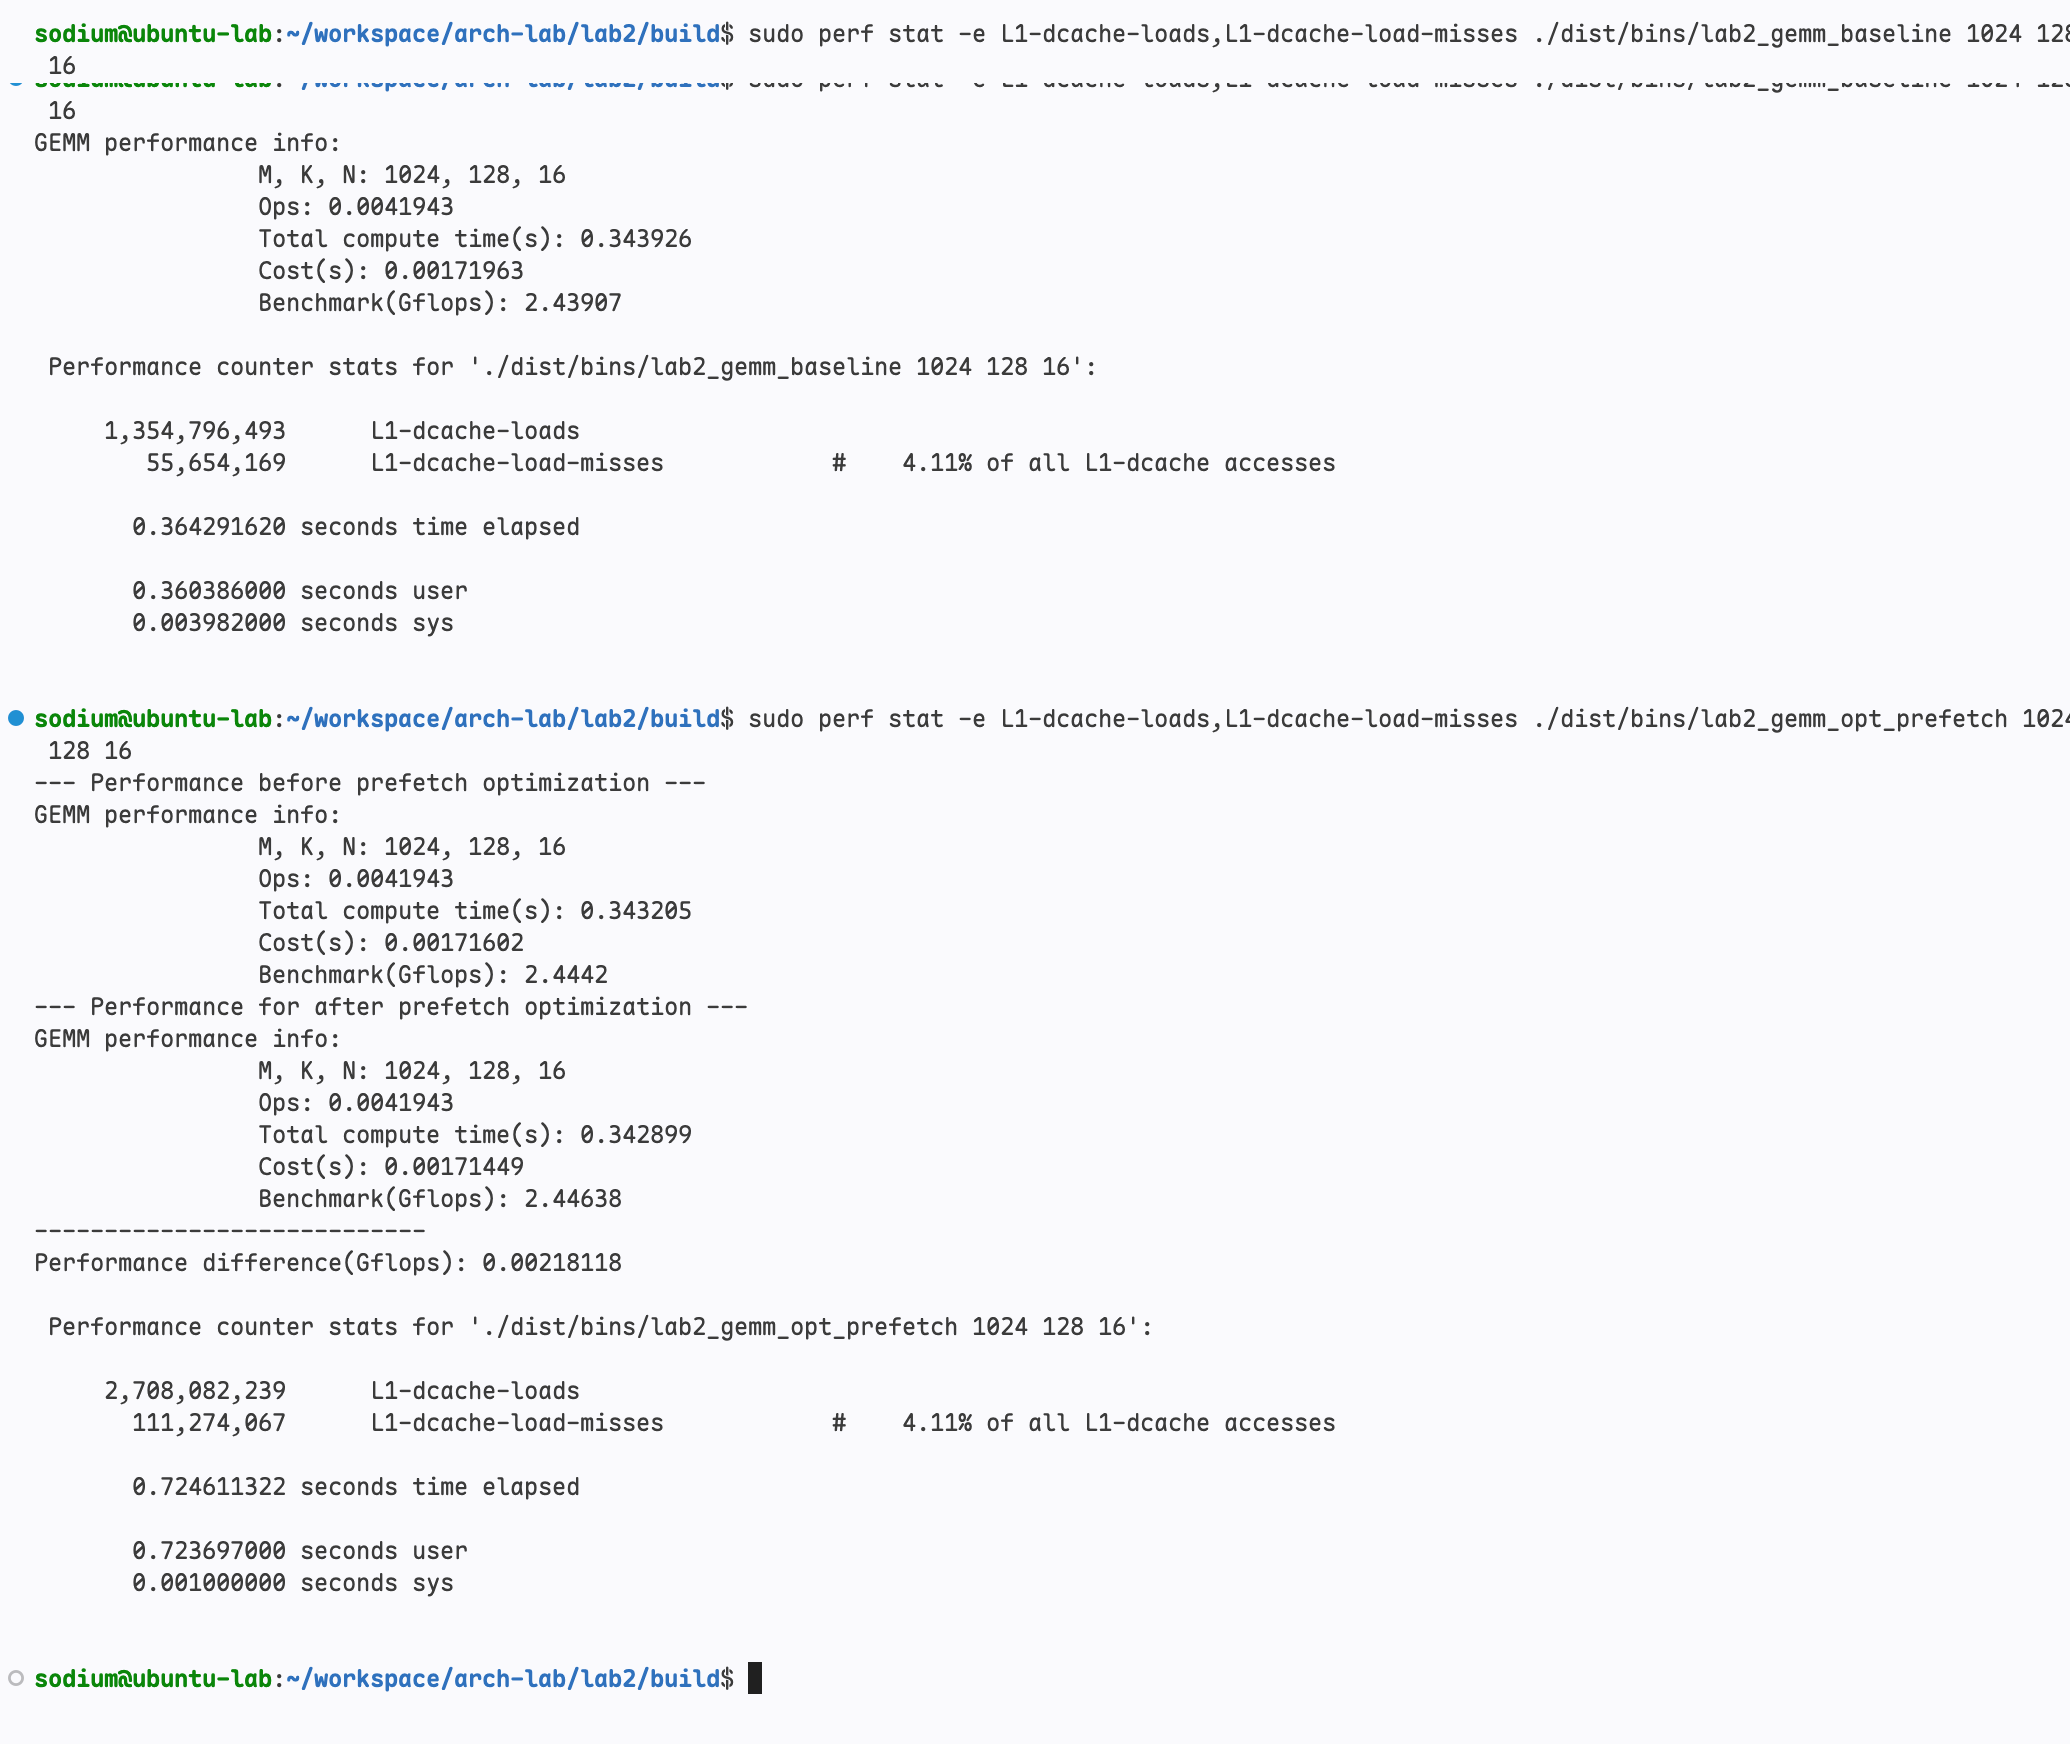
A[m+2][k] 的情况,L1D 的命中率基本没有变化
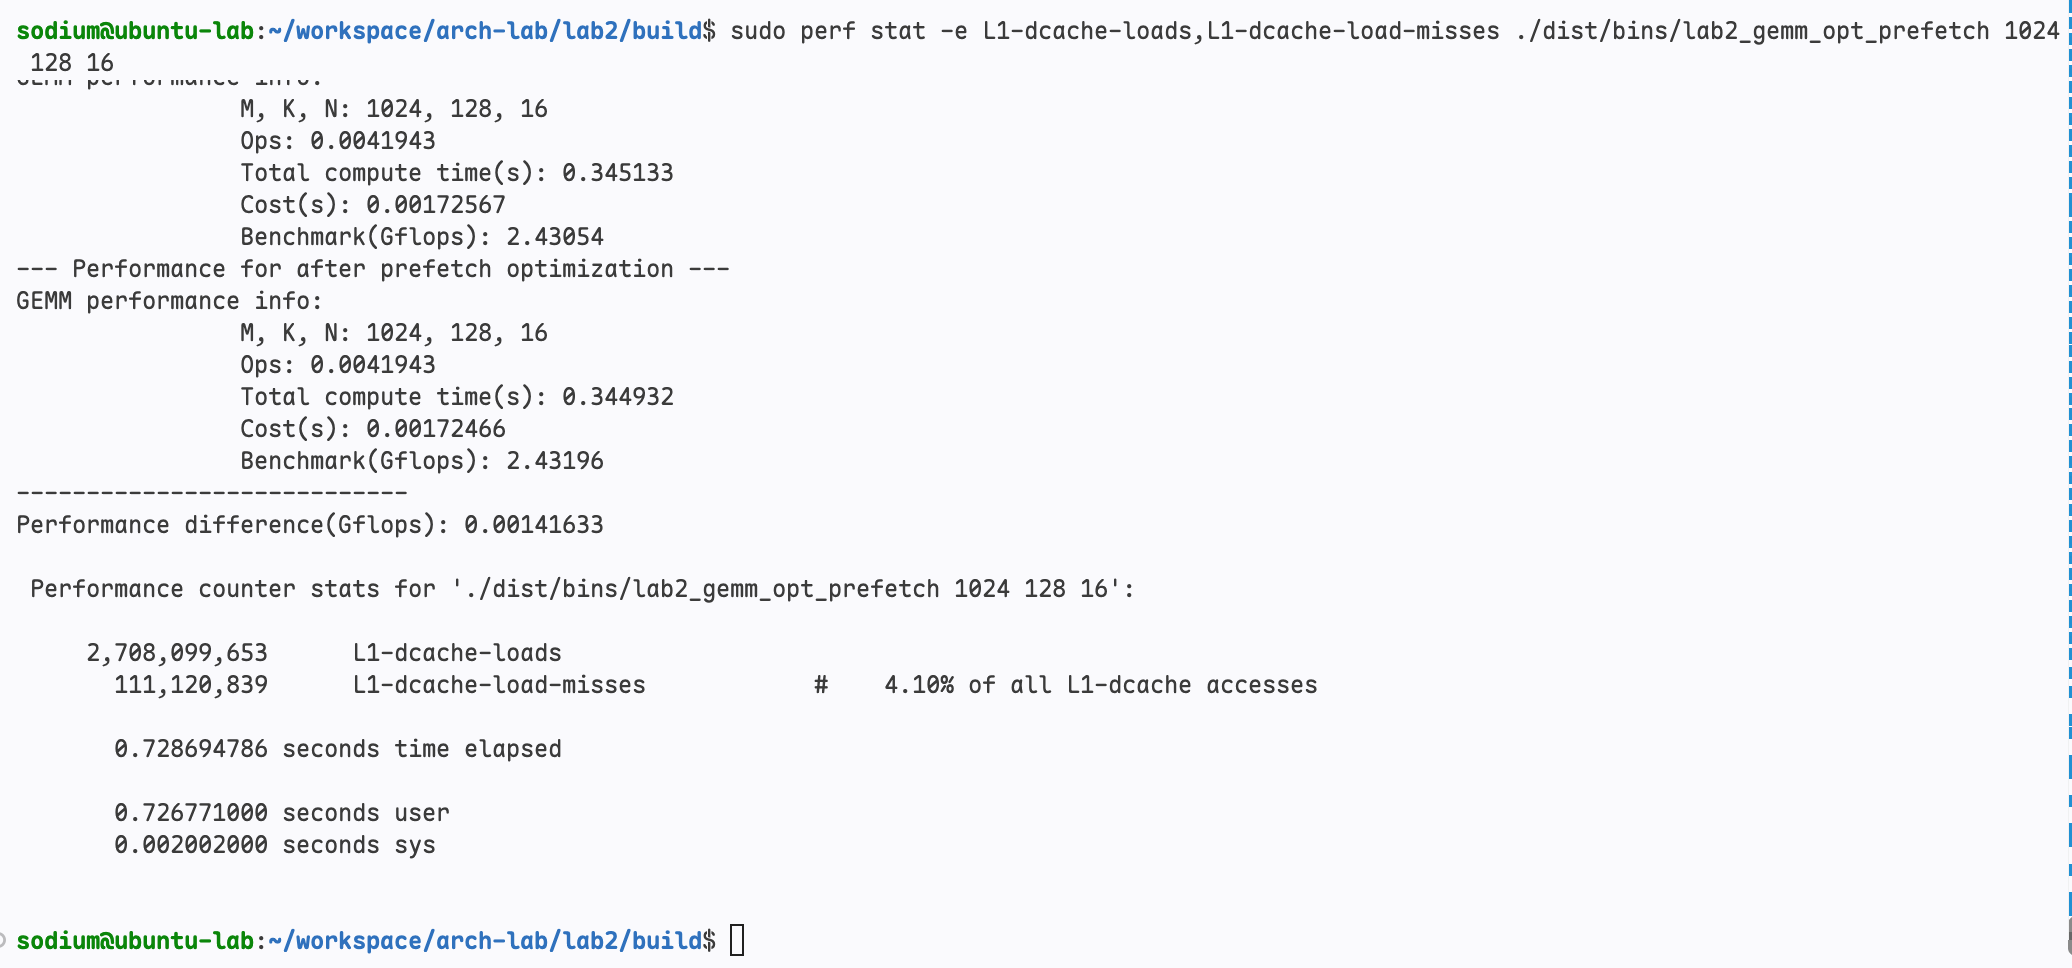
上面是预取 A[m+1][k] 的情况,L1D 的 miss/loads 比基线低了 0.01%
实际发现无论是预取 A[m+1][k] 还是 A[m+2][k] 都没有明显提高 L1D 的命中率
但是如果查看全部级别的 cache miss 情况可以推断 L2, L3 的命中率其实提升了
sudo perf stat -e cycles,instructions,cache-references,cache-misses ./dist/bins/lab2_gemm_baseline 1024 128 64
sudo perf stat -e cycles,instructions,cache-references,cache-misses ./dist/bins/lab2_gemm_opt_p
refetch 1024 128 64
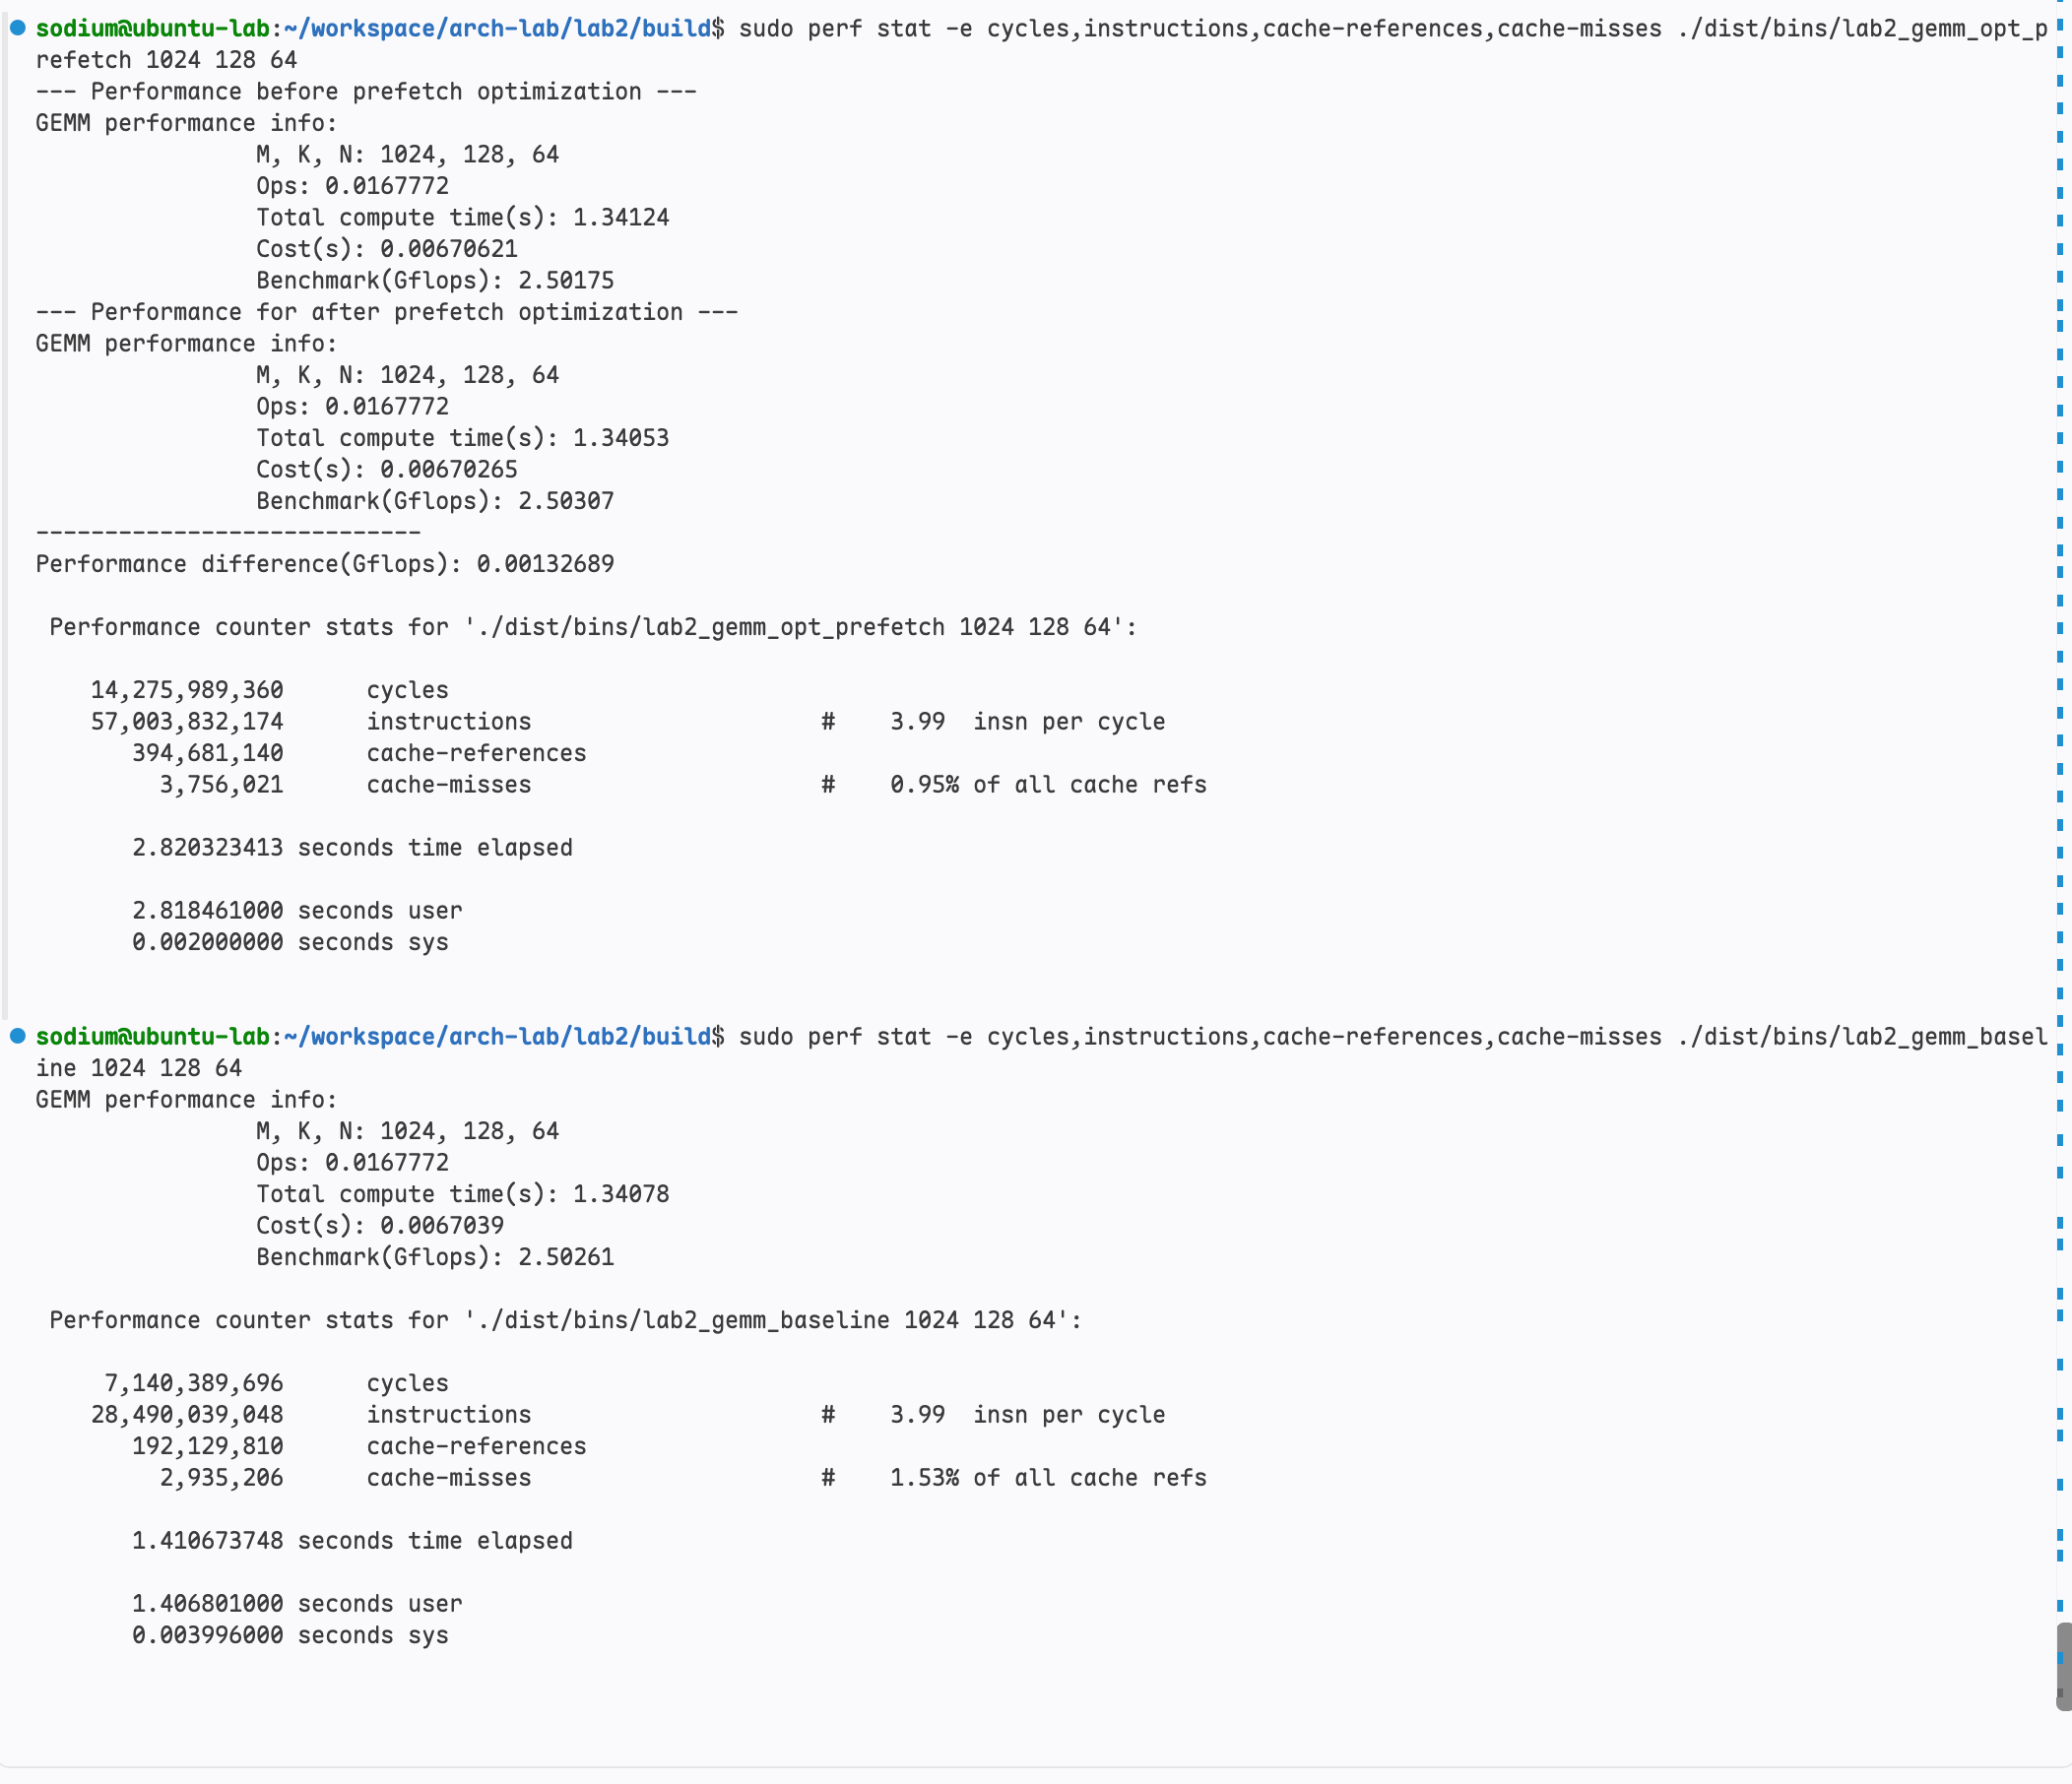
但这个提升范围实际上在正常波动范围内,缓存在测试过程中可能会起到预热的作用,但对分数影响不大。
可能是因为 L1D 命中率没有明显提升,性能也没有明显提升,L1D 可能才是这里影响性能的关键要素。
而在机房中的电脑,同样的预取是可以带来稳定的性能提升的。
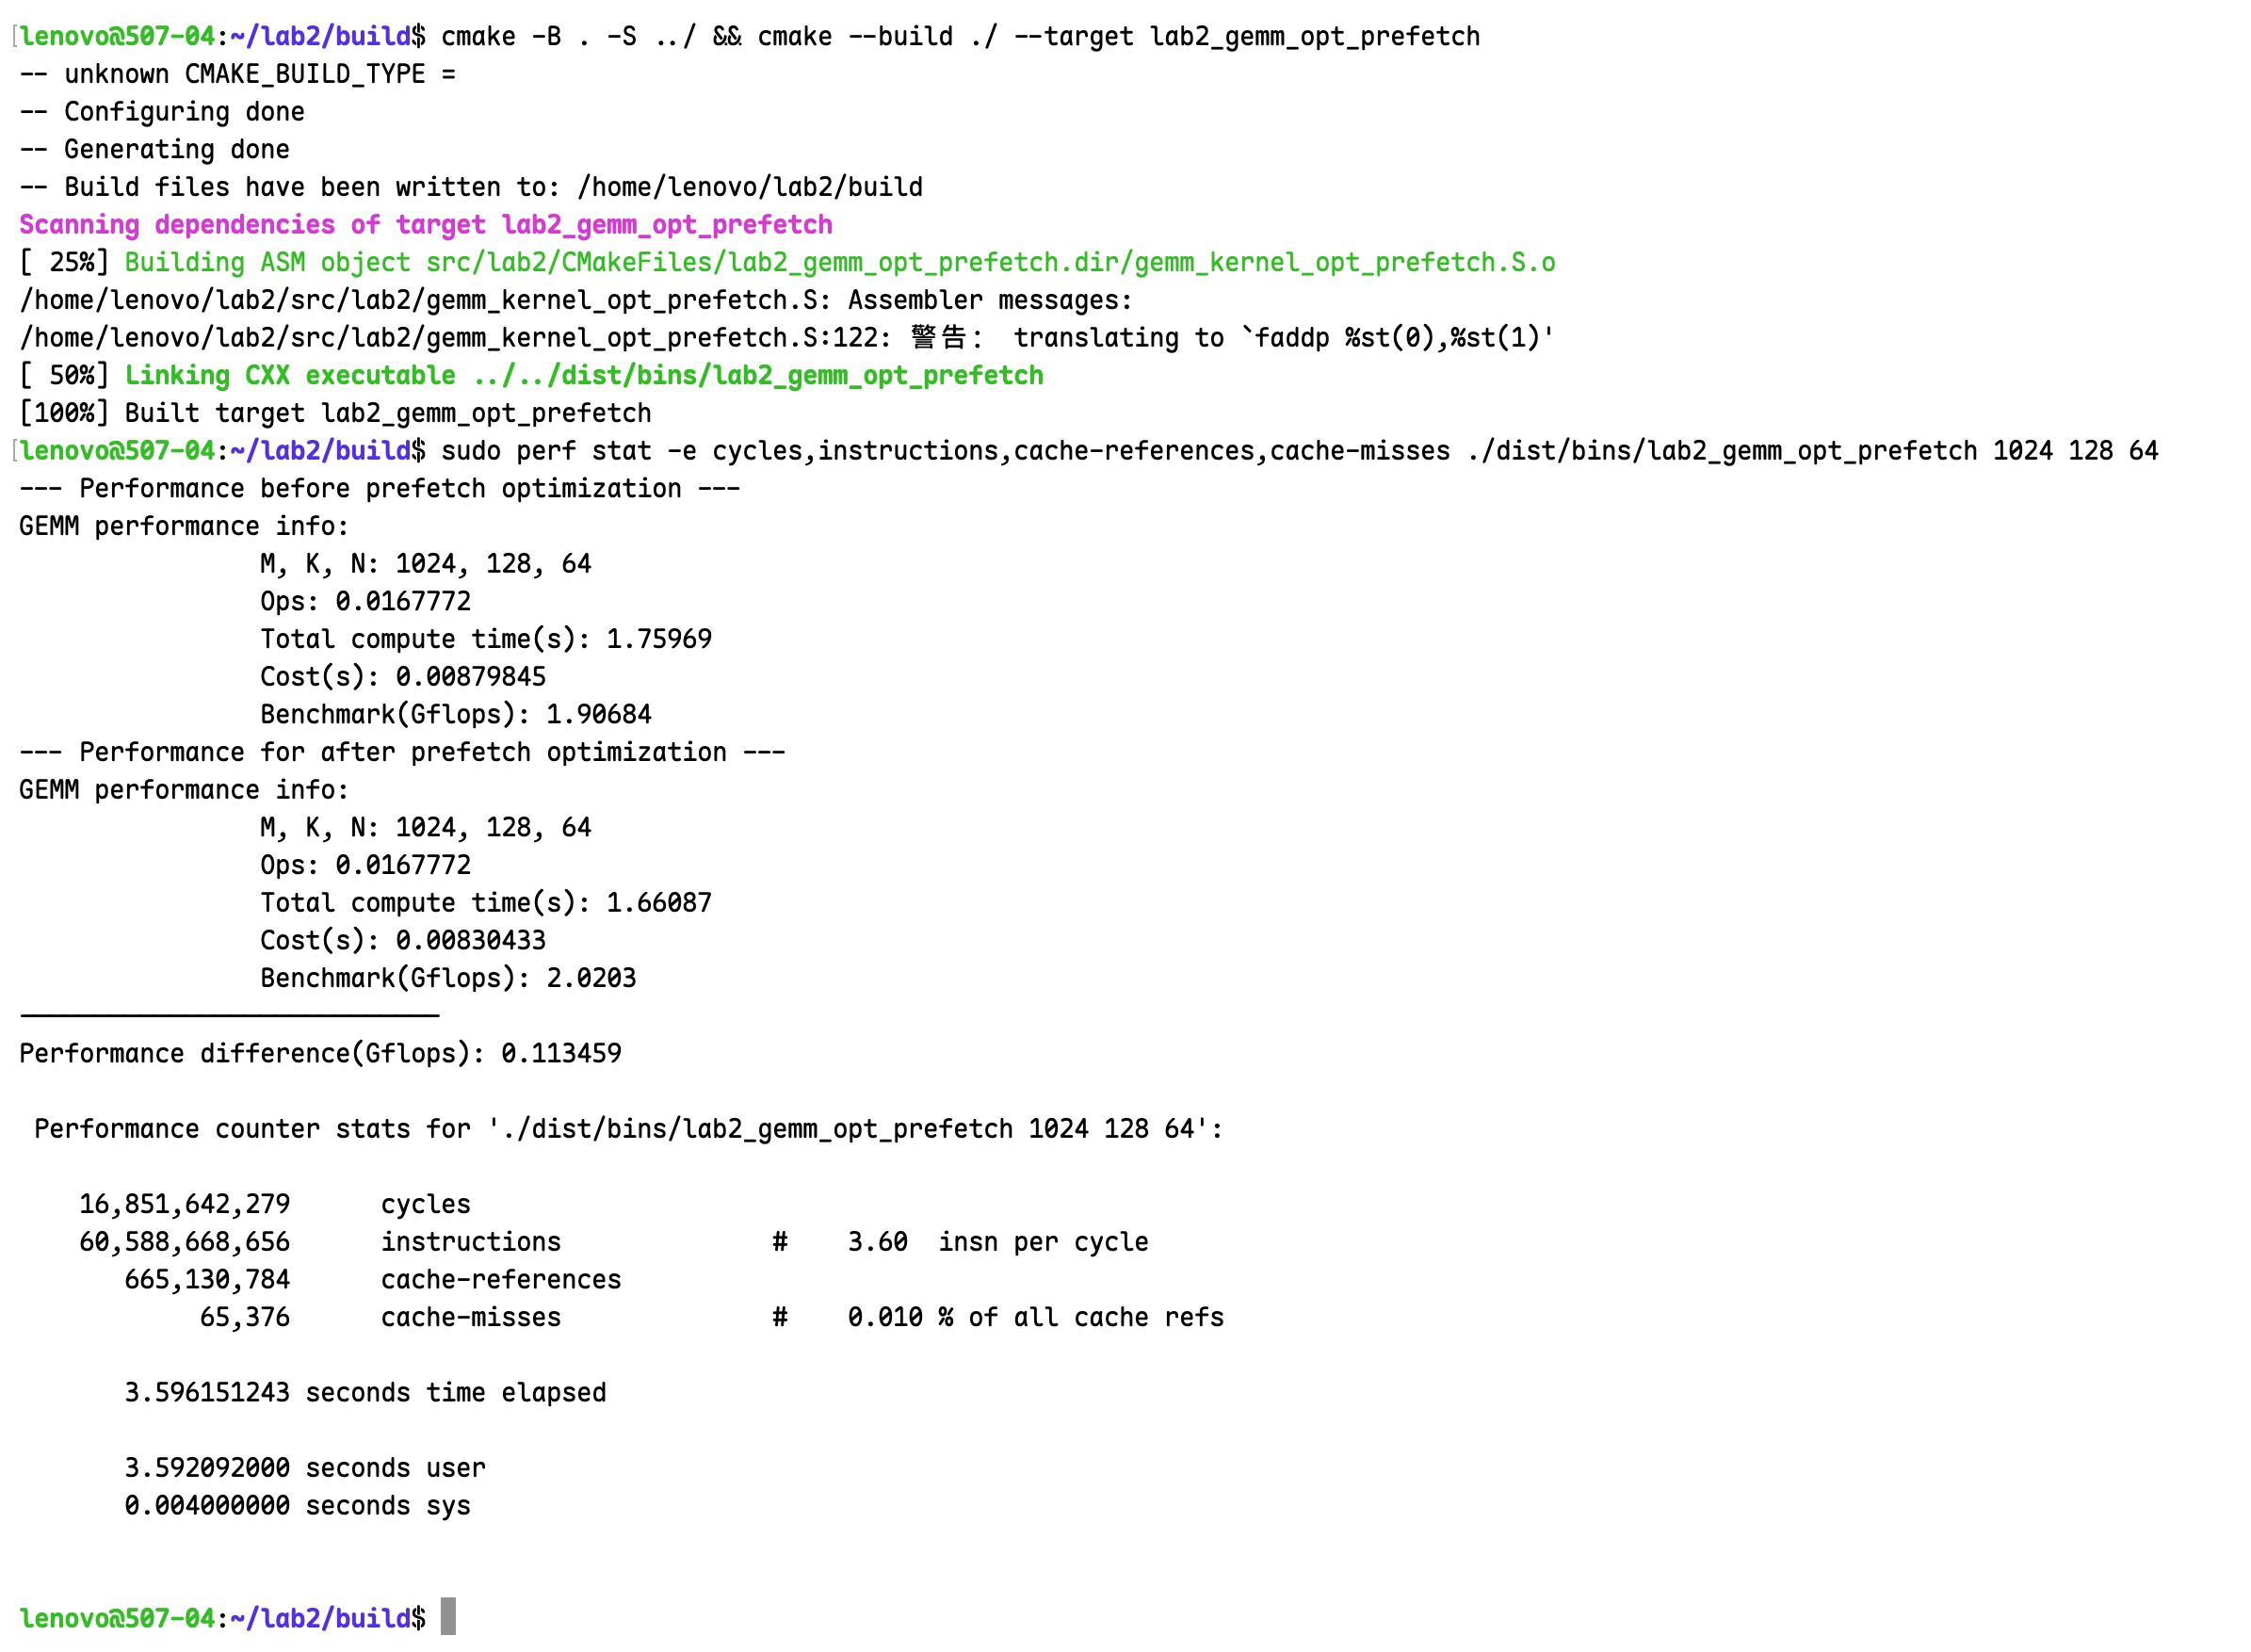
继续检查命中缺失的来源
sudo perf stat -r 5 \
  -e cycles,instructions,L1-dcache-loads,L1-dcache-load-misses \
  -- ./dist/bins/lab2_gemm_baseline 1024 128 16
sudo perf report
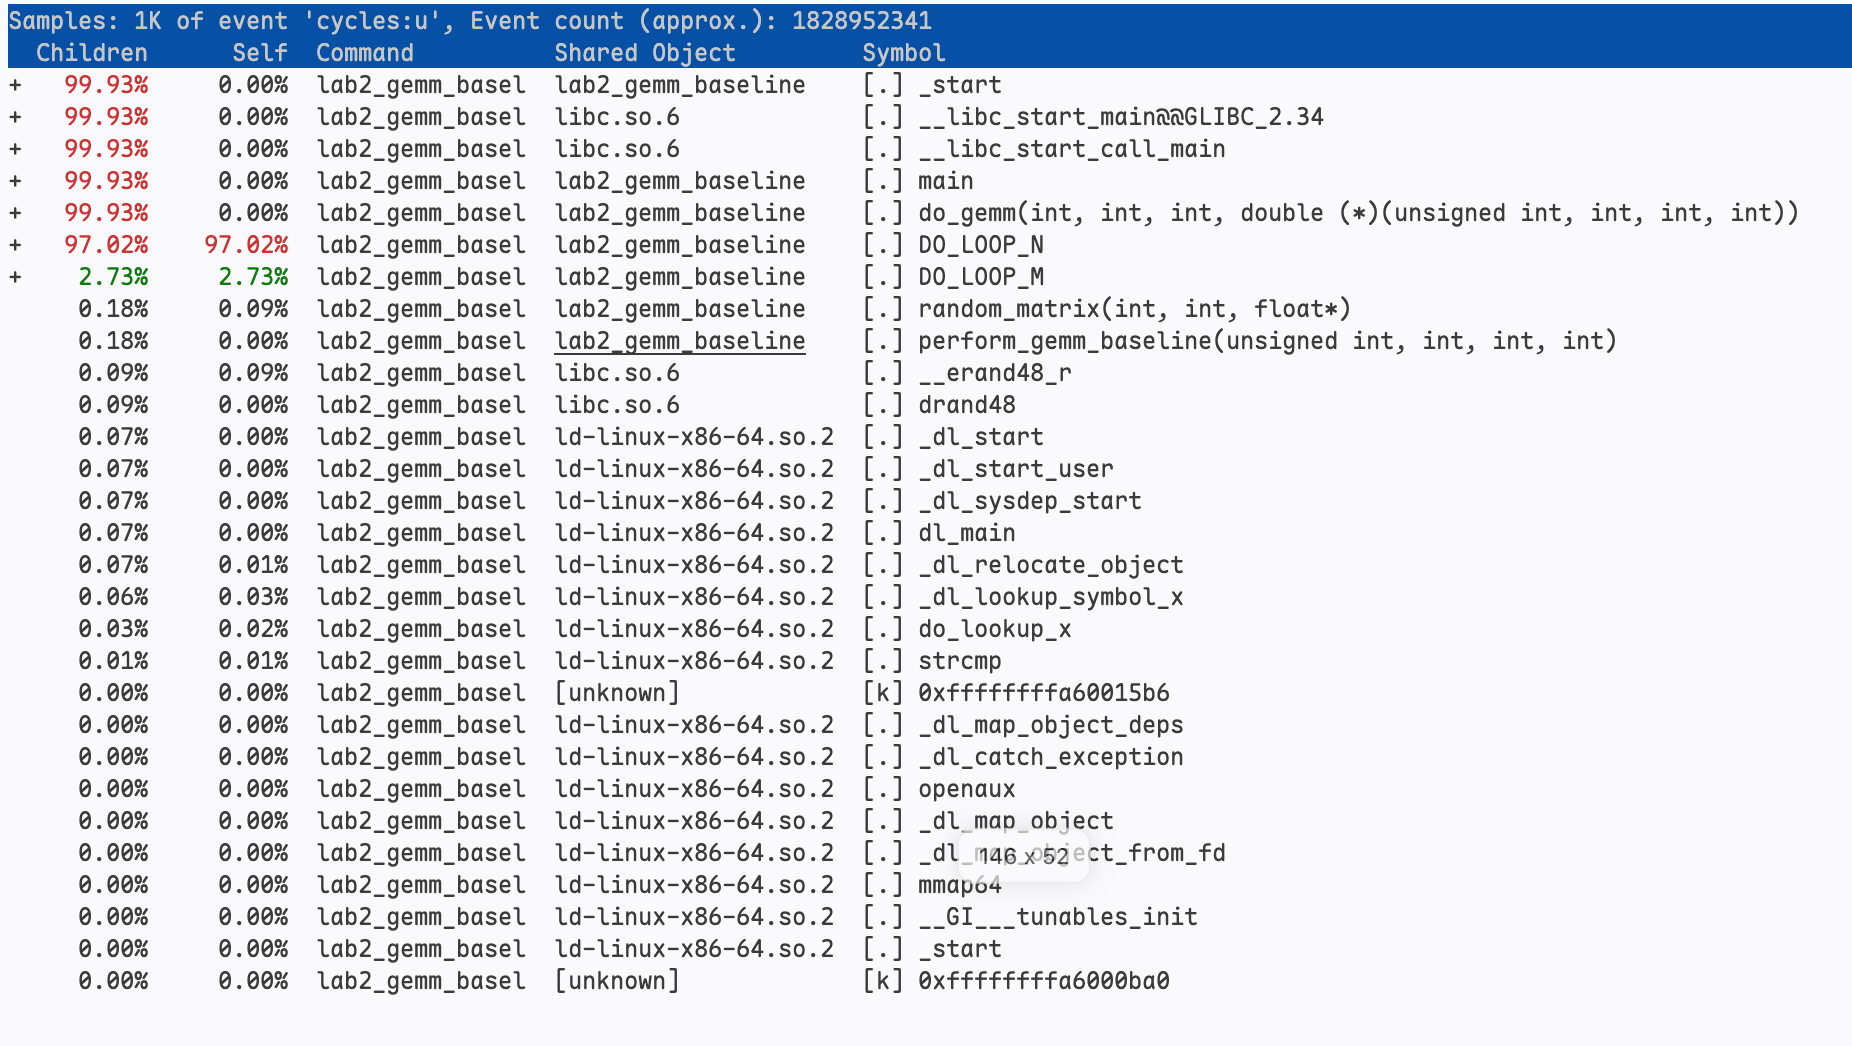
do_gemm()的 Children 为 99.95%,说明几乎所有采样都发生在它的调用链之下。DO_LOOP_N的 Self 为 98.24%,说明绝大多数采样直接落在这个循环对应的代码位置。DO_LOOP_M的 Self 只有 1.44%,说明直接落在 M 循环自身指令上的采样很少。
同样可以查看预取版本的
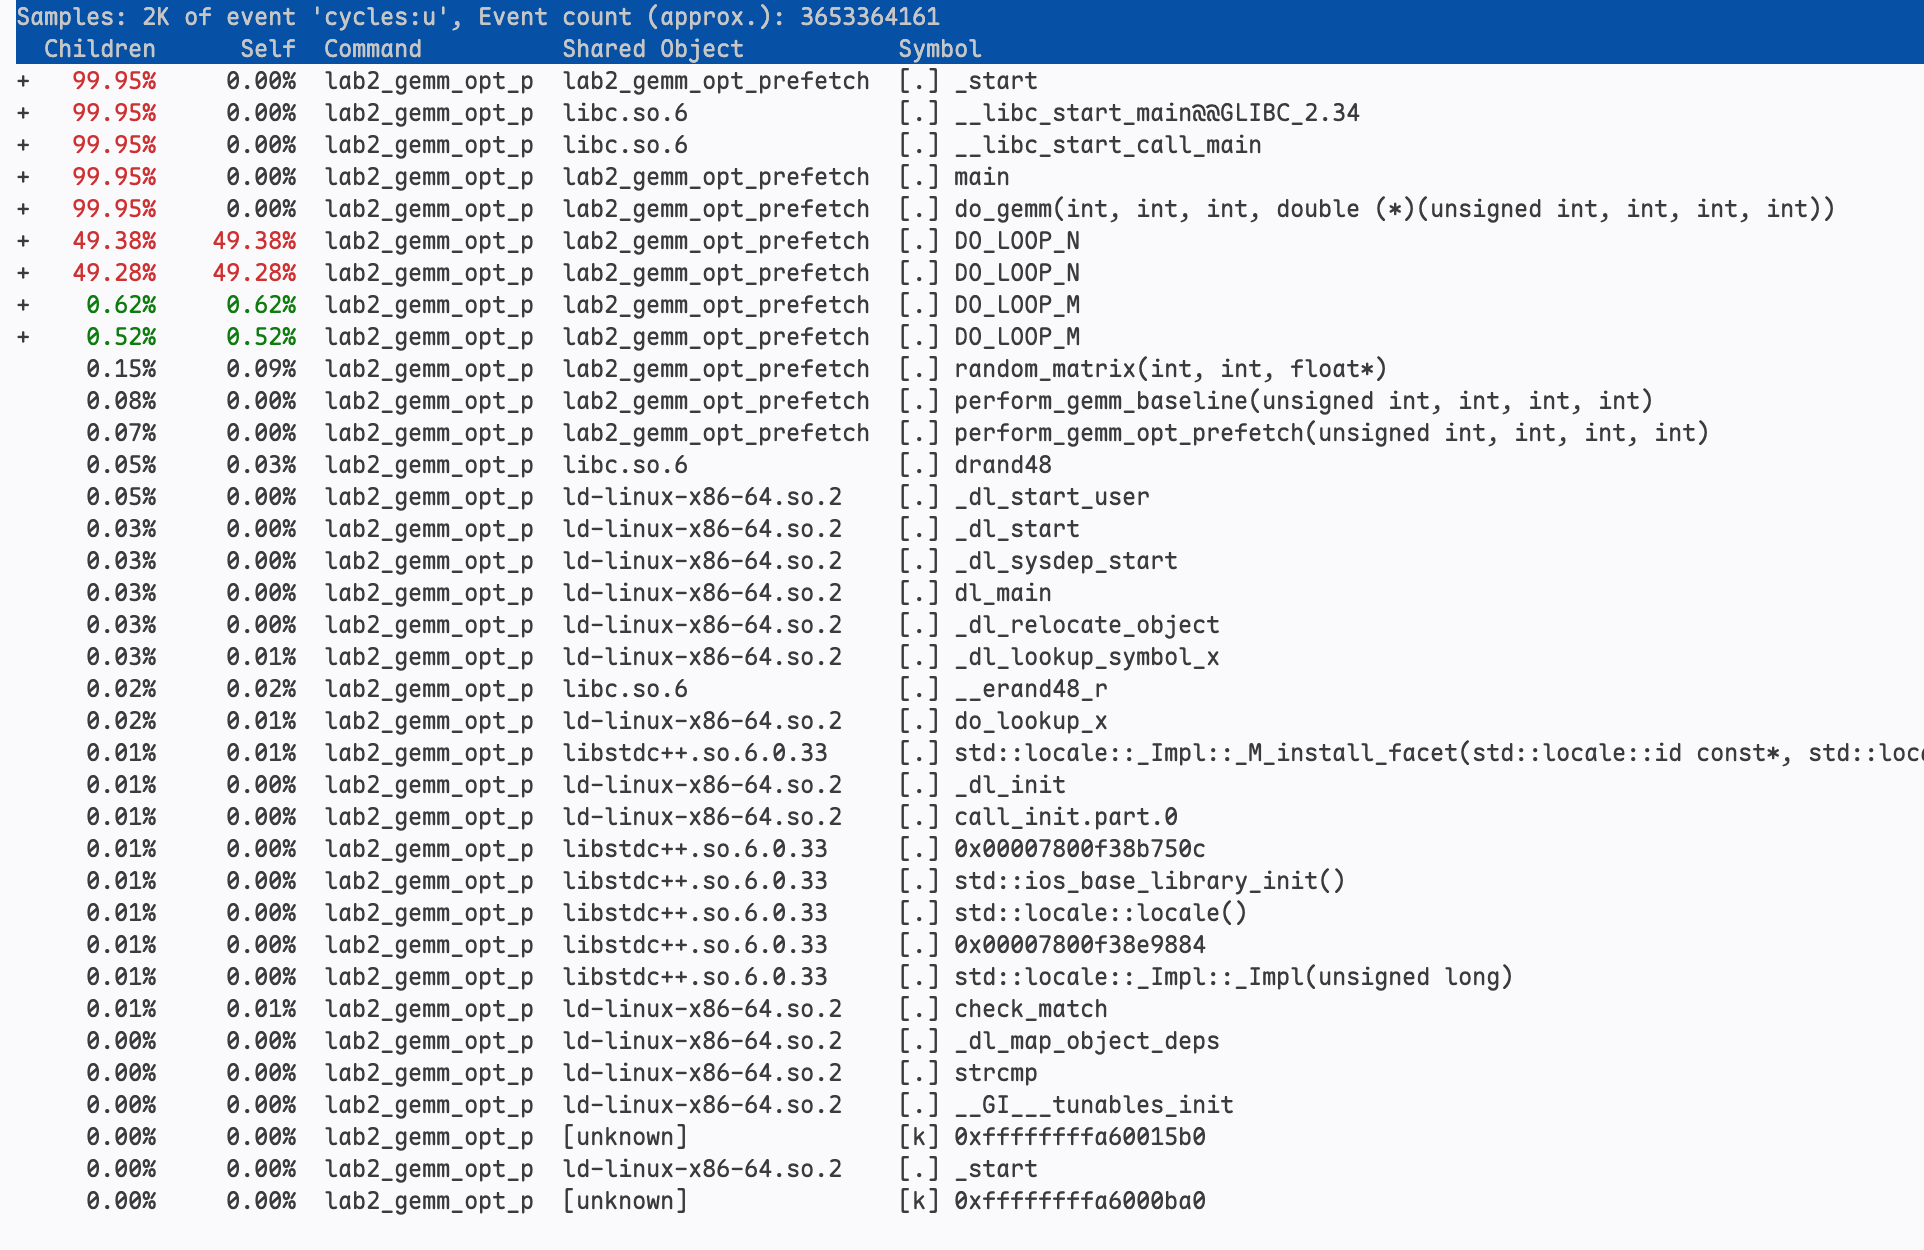
尝试在 DO_LOOP_N 这里也进行预取,主要是对 B 进行预取
DO_LOOP_N:

    mov DIM_N, %rax
    mul loop_k
    mov %rax, mat_elem_idx
    add loop_n, mat_elem_idx                    // 计算 k*N+n

    flds (MAT_B, mat_elem_idx, 4)     // 加载 B[k][n]
    prefetcht0 512(MAT_B, mat_elem_idx,4)   // prefetch B[k+2][n]
实测发现对 L1D 命中率基本没有影响。
预取矩阵 C 实测会发现对 L1D 命中率同样没有什么影响
补充:指导书的要求与本机预取无效的根因
这里补充两点:一是指导书对本练习的明确要求,二是预取在本机无效的根本原因。
指导书的要求:gemm_kernel_opt_prefetch.S 里的 TODO 并不需要自行编写 DO_GEMM,只需先把 gemm_kernel_baseline.S 第 62至105 行的 DO_GEMM 整体替换掉 gemm_kernel_opt_prefetch.S 第 63至65 行的 TODO,然后在此基础上添加预取指令即可。也就是说,练习二考查的是「在 baseline 循环结构不变的前提下,通过 prefetch 优化访存」,并不涉及改写循环结构——消除冗余 mul 之类的循环优化是练习三的内容。
预取在本机为什么无效:前面看到无论预取 A、B 还是 C,L1D 命中率与性能都没有明显变化。进一步分析会发现,本机的瓶颈其实不在 cache miss,而在内层 DO_LOOP_N 里每次迭代都用 mul 重算 B、C 的地址(k*N+n 与 m*N+n 在 n 循环内都不变,本应提到循环外)。perf report 也印证了这一点:DO_LOOP_N 的 Self 占 98.24%,热点集中在内层循环的指令本身而非访存 stall;同时 Zen4 的硬件预取器已经自动覆盖了 A 的 stride-512 访问与 B/C 的顺序访问,软件 prefetch 基本没有发挥空间。
作为旁证,如果把 B/C 地址改成增量维护(去掉内层 2 次 mul,这属于循环优化而非预取),针对 1024 128 16 能从约 2.44 Gflops 提升到约 4.24 Gflops(约 +73%,其他尺寸 +46%~+93%),说明真正的瓶颈确实在冗余的地址计算上。这解释了为何纯预取在本机收效甚微,也顺带说明了「机房里同样的预取能稳定提速」这一差异的来源——不同机器的硬件预取器与瓶颈各不相同。
练习三(选做):利用循环和分块提升计算性能
类似于练习二,这里需要完善 src/lab2/gemm_kernel_opt_loop.S 中 DO_GEMM 过程(第55行)的矩阵计算逻辑,设计恰当循环顺序和数量进一步提升矩阵乘法性能
cd lab2/build
cmake -B . -S ../ && cmake --build ./ --target lab2_gemm_kernel_opt_loop.unittest
./dist/bins/lab2_gemm_kernel_opt_loop.unittest
cmake -B . -S ../ && cmake --build ./ --target lab2_gemm_opt_loop
./dist/bins/lab2_gemm_opt_loop 4 32768 4
针对 m=4 k=32768 n=4 的输入进行优化
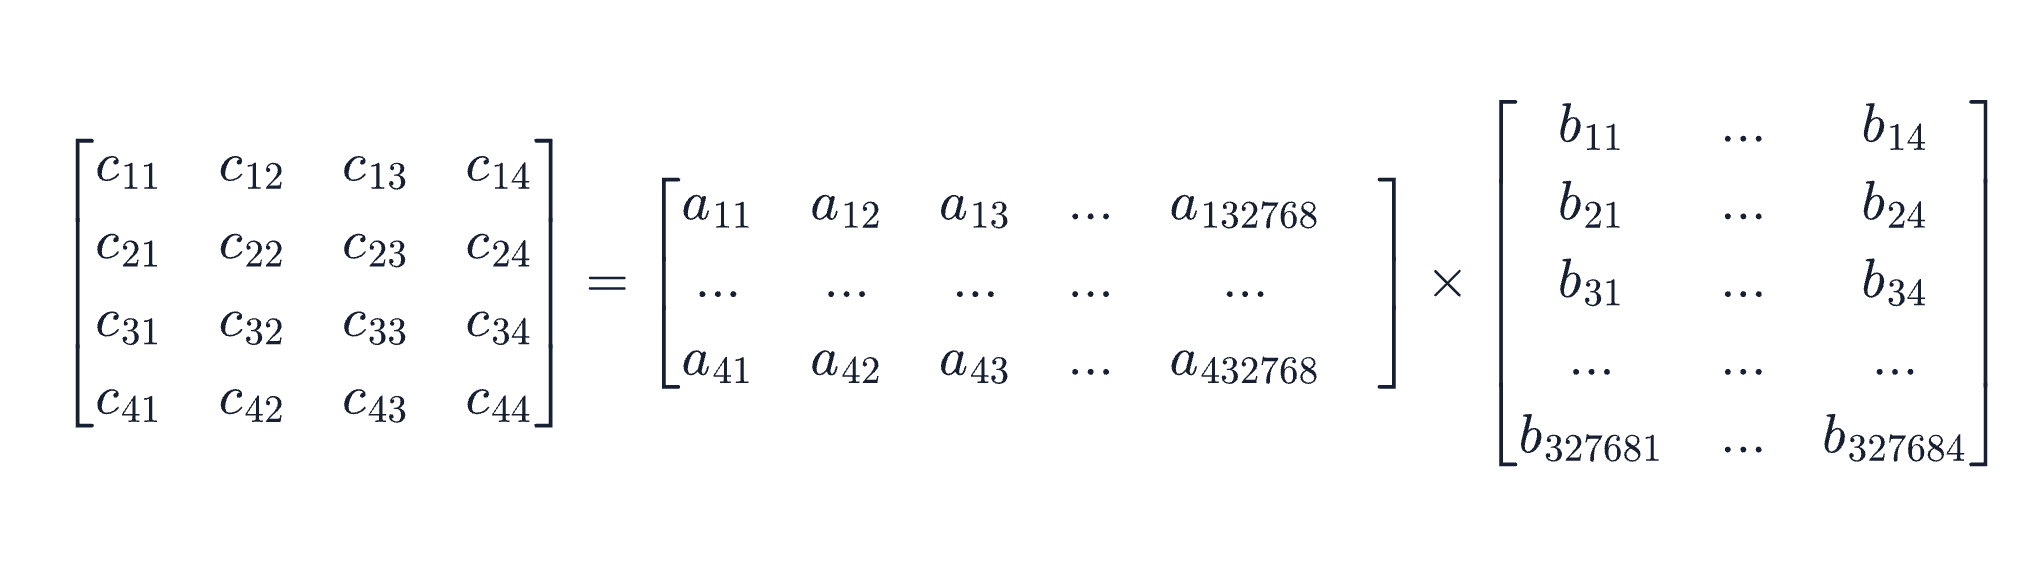
矩阵分块的原理加速的原理是把矩阵拆分成多个部分进行计算,而不同大小层次的块就可以留在不同层次的缓存中,最大程度利用缓存。
这里的输入特点是 k 很大,作为结果的矩阵 C 反而只有 4*4,那么直接考虑将 k 进行拆分
原本的循环结构如下
int loop_k = loop_m = loop_n = 0;
unsigned int mat_elem_idx;
for (loop_k; loop_k < DIM_K, lopp_k++){
    for (loop_m; loop_m < DIM_M, loop_m++){
        flds(A[DIM_K * loop_m + loop_k]);                          // A[m][k]
        for (loop_n; loop_n < DIM_N; loop_n++){
            flds(B[DIM_N * loop_k + loop_n]);
            fmul(%st(1), %st(0));                       // A[m][k] * B[k][n]
            flds(C[DIM_N * loop_m + loop_n]);
            faddp(%st(1), %st(0));                      // A[m][k] * B[k][n] + C[m][n]
            fstps(C[DIM_N * loop_m + loop_n]);
        }
        fstp(%st(0));
    }
}
将 $ 4\times 4$ 矩阵作为一个分块,那么上面的算式可以变成下面的样子
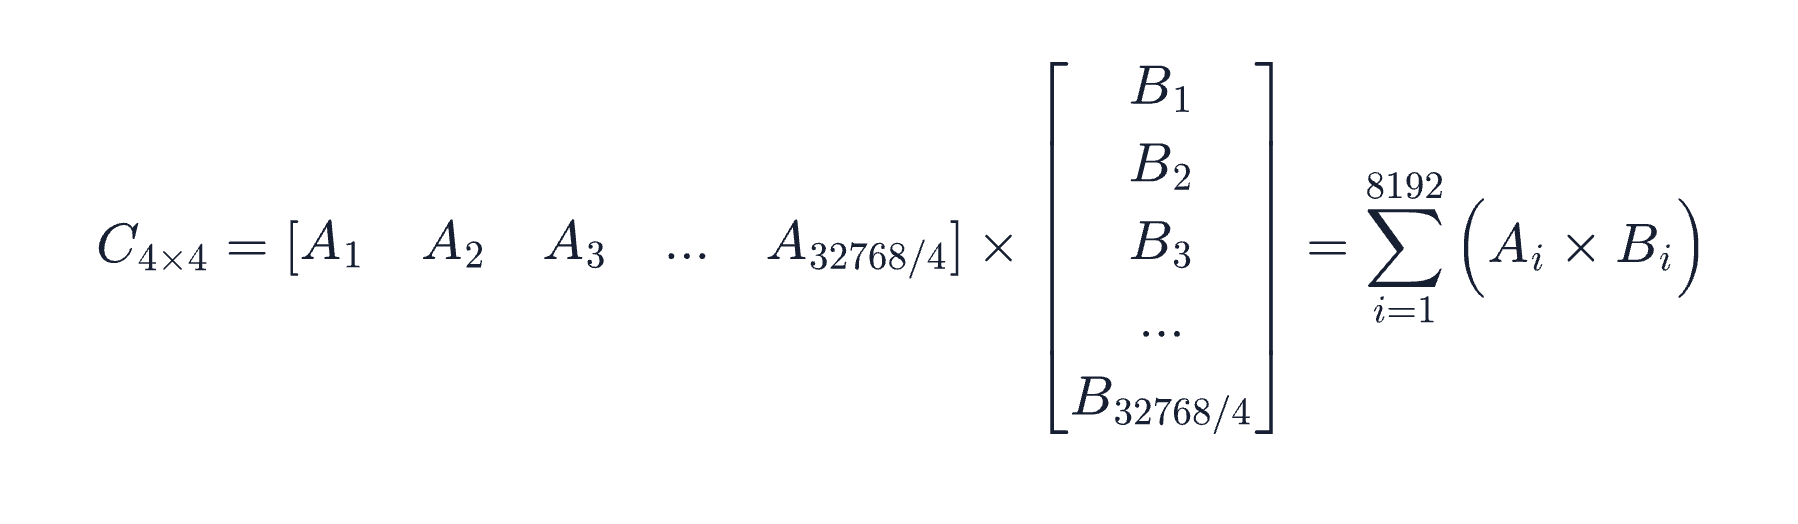
显然
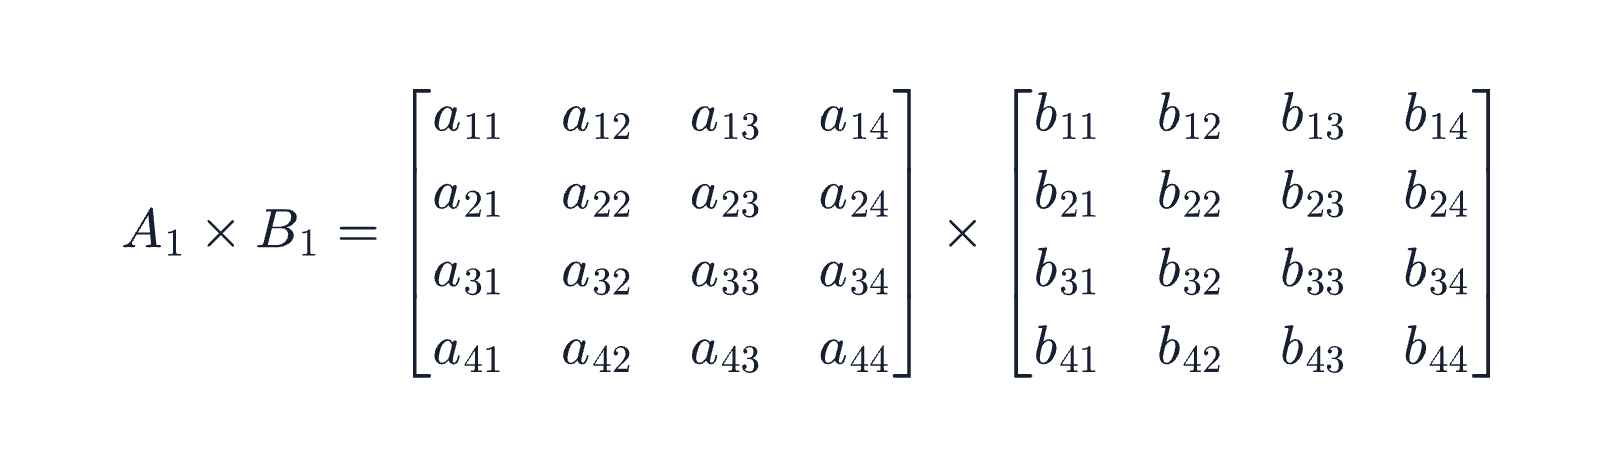
推广到一般情况
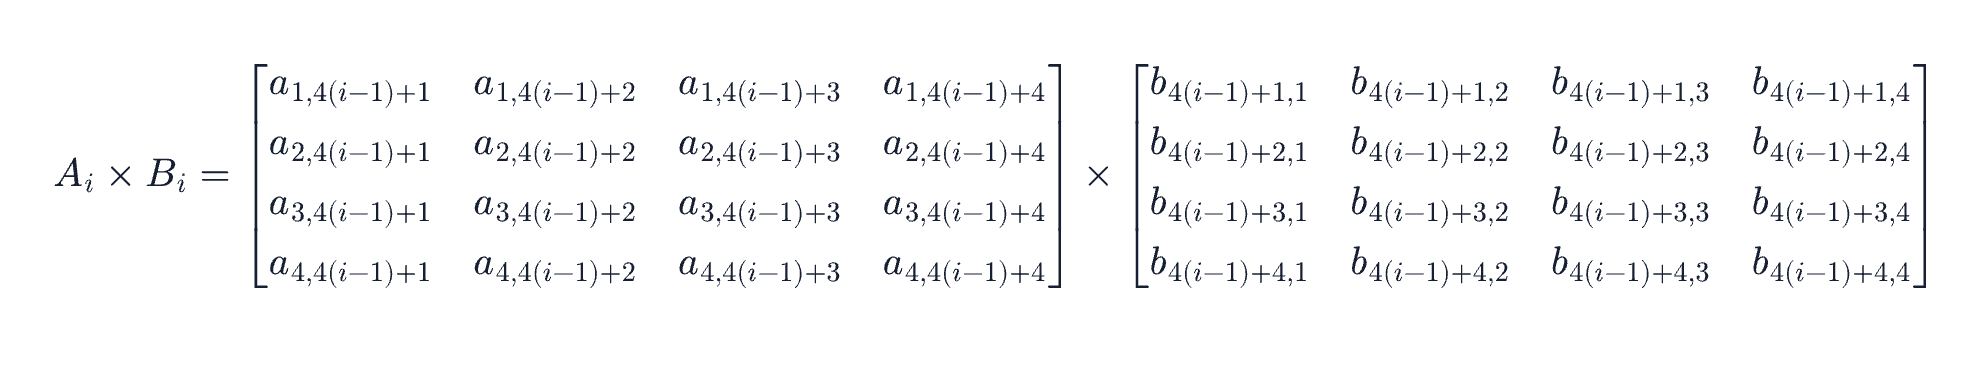
改进后,逻辑如下
C[4][4] = 0;

for (K = 1; K <= 32768; K += 4) {   // K 方向分块
    // 取K方向的 A_K, B_K,都是4*4矩阵
    for (k = 0; k < 4; k++) {
        for (m = 1; m <= 4; m++) {
            for (n = 1; n <= 4; n++) {
                C[m][n] += A[m][K+k] * B[K+k][n];
            }
        }
    }
}
实际上分块的大小不一定非得是 4*4,这里尝试让一行的大小刚好是一个 cacheline 的大小,也就是 64/4 = 16 个元素
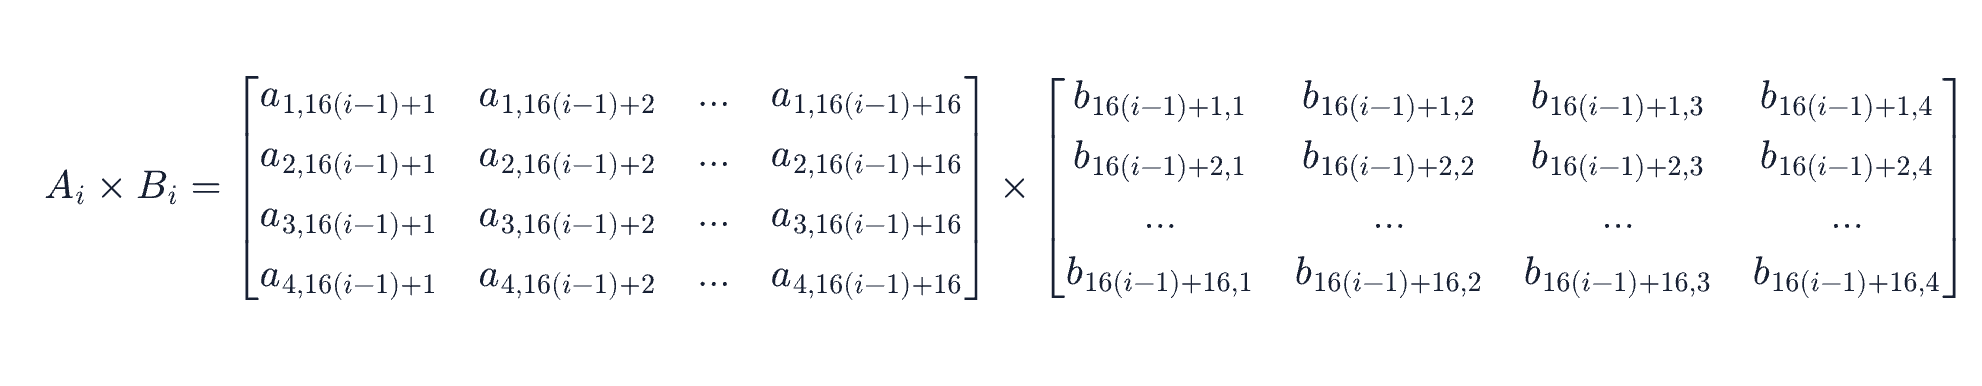
补上另外两个方向循环后
for (mm = 0; mm < M; mm += 4) {
    for (nn = 0; nn < N; nn += 4) {
        for (kk = 0; kk < K; kk += 16) {
            // 4*16 * 16*4
            for (k = kk; k < kk + 16; ++k) {
                for (m = mm; m < mm + 4; ++m) {
                    for (n = nn; n < nn + 4; ++n) {
                        C[m][n] += A[m][k] * B[k][n];
                    }
                }
            }
        }
    }
}
初步采用三层分块(M-N-K 外层、k→m→n 内层)实现后,运行 test3(M=8, N=64, K=128)会精度失败:
The difference between C[m * N + n] and C_check[m * N + n] is 1.1444091796875e-05, which exceeds 1e-5
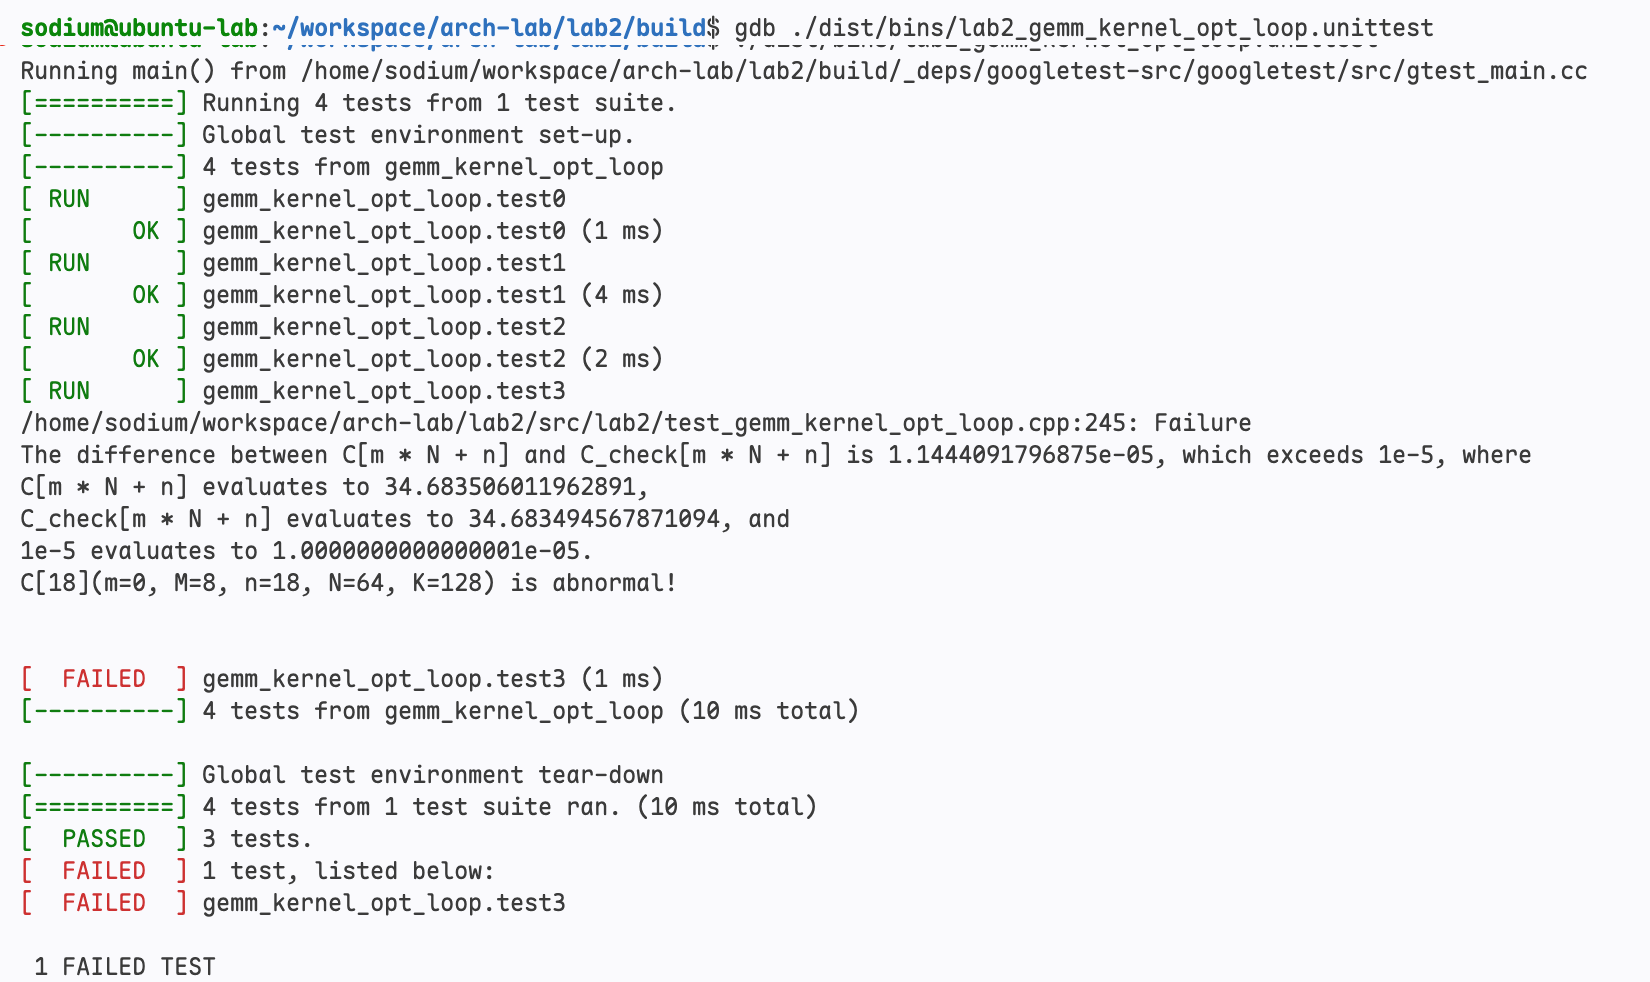
问题出在循环顺序上:这一版最内层依然和 baseline 一样是 k 在外、m/n 在内,每个 k 迭代都要执行 flds C(把 C 以 32 位载入)→ faddp → fstps C(把 C 以 32 位写回),也就是 C 每累加一次就被舍入回 float 一次,K 越大累积舍入误差越大(K=128 时已超过 1e-5);而测试的参考实现 C_check 是用 double 全程累加、最后才转 float,精度远高于这种反复舍入的写法。
正确的做法是让 C 的累加全程停留在 x87 的 80 位扩展精度寄存器中,直到最后才写回内存一次。具体设计:
- 把 C 的一行 4 个元素
C[m][0..3]放进 x87 的st(0)..st(3)四个寄存器作为累加器; k作为最内层循环全程累加(80 位精度),循环结束后一次性fstps写回 4 个元素;- A 通过
fmuls的内存操作数直接读取,不额外占用寄存器槽;B 顺序flds; - A、B 地址用增量维护(A 每 k 步进 1 元素、B 每 k 步进 N 元素),内层不再出现
mul。
这样既解决了精度(80 位累加、只舍入一次),也解决了性能(C 每个元素只写回一次,原先 524288 次 load+store 降到 16 次 store)。
#define     MAT_C               %rdi
#define     MAT_A               %rsi
#define     MAT_B               %r14
#define     DIM_M               %rcx
#define     DIM_N               %r8
#define     DIM_K               %r9
#define     loop_m              %r10
#define     loop_k              %r11
#define     loop_n              %r12
#define     mat_elem_idx        %r13
#define     a_idx               %rbx
#define     b_idx               %rbp
#define     block_n             %r15

#define     BS_N                4

.macro DO_GEMM
    xor loop_m, loop_m
DO_M:
    xor block_n, block_n

    // guard:N < 4 时没有完整的 4 列块,直接处理余数
    mov DIM_N, %rax
    sub $BS_N, %rax
    cmp %rax, block_n
    jg DO_REM

DO_N:
    fldz                        // st0 = acc0
    fldz                        // st1 = acc1
    fldz                        // st2 = acc2
    fldz                        // st3 = acc3

    mov loop_m, %rax
    mul DIM_K
    mov %rax, a_idx             // A 基址 = m*K
    mov block_n, b_idx          // B 基址 = n(k=0 处)

    xor loop_k, loop_k
DO_K:
    flds (MAT_B, b_idx, 4)      // B[k][n+0]
    fmuls (MAT_A, a_idx, 4)     // * A[m][k]
    faddp %st(0), %st(1)        // acc0 += A*B

    flds 4(MAT_B, b_idx, 4)     // B[k][n+1]
    fmuls (MAT_A, a_idx, 4)
    faddp %st(0), %st(2)        // acc1 += A*B

    flds 8(MAT_B, b_idx, 4)     // B[k][n+2]
    fmuls (MAT_A, a_idx, 4)
    faddp %st(0), %st(3)        // acc2 += A*B

    flds 12(MAT_B, b_idx, 4)    // B[k][n+3]
    fmuls (MAT_A, a_idx, 4)
    faddp %st(0), %st(4)        // acc3 += A*B

    add $1, a_idx               // A:下一个 k
    add DIM_N, b_idx            // B:下一个 k(跨 N 列)
    add $1, loop_k
    cmp DIM_K, loop_k
    jl DO_K

    // 写回 C[m][n .. n+3]
    mov loop_m, %rax
    mul DIM_N
    mov %rax, mat_elem_idx
    add block_n, mat_elem_idx   // m*N + n
    fstps (MAT_C, mat_elem_idx, 4)
    add $1, mat_elem_idx
    fstps (MAT_C, mat_elem_idx, 4)
    add $1, mat_elem_idx
    fstps (MAT_C, mat_elem_idx, 4)
    add $1, mat_elem_idx
    fstps (MAT_C, mat_elem_idx, 4)

    add $BS_N, block_n
    mov DIM_N, %rax
    sub $BS_N, %rax
    cmp %rax, block_n
    jle DO_N                    // block_n <= N-4 时继续

DO_REM:
    // 余数列(N % 4 != 0 或 N < 4):单元素 80 位累加
    cmp DIM_N, block_n
    jge DO_N_DONE
    mov block_n, loop_n
DO_REM_N:
    fldz                        // acc = 0
    mov loop_m, %rax
    mul DIM_K
    mov %rax, a_idx
    mov loop_n, b_idx
    xor loop_k, loop_k
DO_REM_K:
    flds (MAT_B, b_idx, 4)
    fmuls (MAT_A, a_idx, 4)
    faddp %st(0), %st(1)
    add $1, a_idx
    add DIM_N, b_idx
    add $1, loop_k
    cmp DIM_K, loop_k
    jl DO_REM_K
    mov loop_m, %rax
    mul DIM_N
    mov %rax, mat_elem_idx
    add loop_n, mat_elem_idx
    fstps (MAT_C, mat_elem_idx, 4)
    add $1, loop_n
    cmp DIM_N, loop_n
    jl DO_REM_N
DO_N_DONE:

    add $1, loop_m
    cmp DIM_M, loop_m
    jl DO_M
.endm

gemm_kernel_opt_loop:
    PUSHD
    mov %rdx, %r14
    DO_GEMM
    POPD
    ret
其中 PUSHD/POPD 与 baseline 一致(保存/恢复 15 个通用寄存器),gemm_kernel_opt_loop 入口用 mov %rdx, %r14 把矩阵 B 搬到 MAT_B 寄存器。
编译运行:
cd lab2/build
cmake -B . -S ../ && cmake --build ./ --target lab2_gemm_kernel_opt_loop.unittest
./dist/bins/lab2_gemm_kernel_opt_loop.unittest
cmake -B . -S ../ && cmake --build ./ --target lab2_gemm_opt_loop
./dist/bins/lab2_gemm_opt_loop 4 32768 4
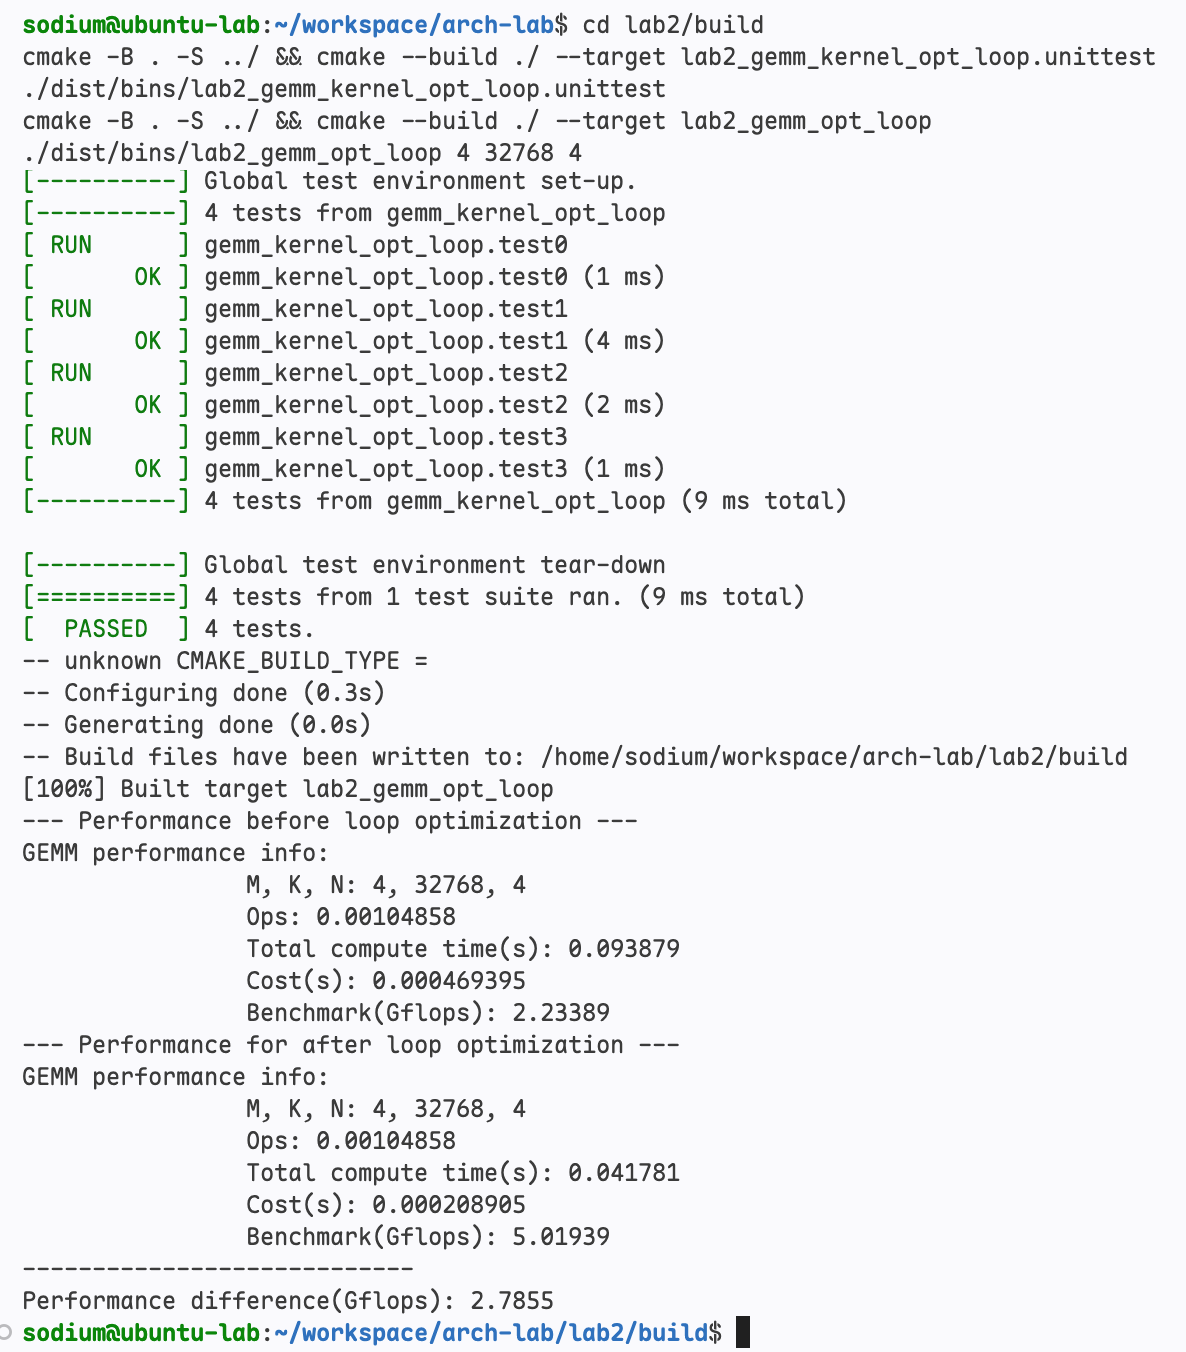
4 个单元测试全部通过(包括之前失败的 test3)。针对 m=4 k=32768 n=4 的 Benchmark:
实验三:使用指令级并行、向量指令和并行优化矩阵乘法
练习一:基于x87 FPU优化矩阵乘法性能
从首页链接下载 lab3.tar.gz,将其拷贝至用户目录,并执行命令解压
tar -zxvf lab3.tar.gz
补充代码没什么好说的
.macro DO_GEMM
DO_LOOP_K:
    xor loop_m, loop_m

DO_LOOP_M:
    xor loop_n, loop_n

    mov loop_m, %rax
    mul DIM_K
    mov %rax, mat_elem_idx
    add loop_k, mat_elem_idx                    // 计算 m*K+k
    flds (MAT_A, mat_elem_idx, 4)               // 加载 A[m][k]

DO_LOOP_N:
    mov DIM_N, %rax
    mul loop_k
    mov %rax, mat_elem_idx
    add loop_n, mat_elem_idx            // k*N + n
    flds (MAT_B, mat_elem_idx, 4)       // 加载 B[k][n]
    fmul %st(1), %st(0)                 // 计算A[m][k] * B[k][n]  --> st(0)

    // TODO  练习1: 添加计算A[m][k] * B[k][n+1] --> st(0)的逻辑
    add $1, mat_elem_idx
    flds (MAT_B, mat_elem_idx, 4)
    fmul %st(2), %st(0)

    mov DIM_N, %rax
    mul loop_m
    mov %rax, mat_elem_idx
    add loop_n, mat_elem_idx                    // 计算 m*N+n

    // TODO 练习1: 请添加加载C[m][n] --> st(1) 和 C[m][n+1] --> st(0)的逻辑
    flds (MAT_C, mat_elem_idx, 4)
    add $1, mat_elem_idx
    flds (MAT_C, mat_elem_idx, 4)

    // TODO 练习1: 请添加部分和累加逻辑: C[m][n+1] + A[m][k] * B[k][n+1] 和 C[m][n] + A[m][k] * B[k][n]
    faddp %st(2), %st(0)
    faddp %st(2), %st(0)                // after, st(0)=C[m][n+1] + A[m][k] * B[k][n+1], st(1) = C[m][n] + A[m][k] * B[k][n]

    fstps (MAT_C, mat_elem_idx, 4)      // 保存C[m][n+1]

    // TODO 练习1: 请添加保存C[m][n]的逻辑
    sub $1, mat_elem_idx
    fstps (MAT_C, mat_elem_idx, 4)      // after, st(0)=A[m][k]
    // TODO 练习1: 请添加N维度的循环更新逻辑
    add $2, loop_n
    cmp DIM_N, loop_n
    jl DO_LOOP_N

    fstp %st(0)                         // 仅弹出元素
    add $1, loop_m
    cmp DIM_M, loop_m
    jl DO_LOOP_M

    add $1, loop_k
    cmp DIM_K, loop_k
    jl DO_LOOP_K
.endm
大部分代码都在前面的基线中能找到答案,新的循环结构如下
int loop_k = loop_m = loop_n = 0;
unsigned int mat_elem_idx;
for (loop_k; loop_k < DIM_K, lopp_k++){
    for (loop_m; loop_m < DIM_M, loop_m++){
        flds(A[DIM_K * loop_m + loop_k]);                          // A[m][k]
        for (loop_n; loop_n < DIM_N; loop_n++){
            flds(B[DIM_N * loop_k + loop_n]);
            fmul(%st(1), %st(0));                       // A[m][k] * B[k][n]
            flds(B[DIM_N * loop_k + loop_n+1]);
            fmul(%st(2), %st(0));                       // A[m][k] * B[k][n+1]
            flds(C[DIM_N * loop_m + loop_n]);
            flds(C[DIM_N * loop_m + loop_n+1]);
            faddp(%st, %st(2));
            faddp(%st, %st(2));
            // 保存 st(0)=C[m][n+1] + A[m][k] * B[k][n+1], st(1) = C[m][n] + A[m][k] * B[k][n]
            fstps(C[DIM_N * loop_m + loop_n+1]);
            fstps(C[DIM_N * loop_m + loop_n]);
        }
        fstp(%st(0));
    }
}
# 项目根目录下执行
mkdir -p build && cd build
cmake -B . -S ../ && cmake --build ./ --target lab3_gemm_opt_loop_unrolling.unittest
./dist/bins/lab3_gemm_opt_loop_unrolling.unittest
# build目录下执行
cmake -B . -S ../ && cmake --build ./ --target lab3_gemm_opt_loop_unrolling
./dist/bins/lab3_gemm_opt_loop_unrolling 256 256 256
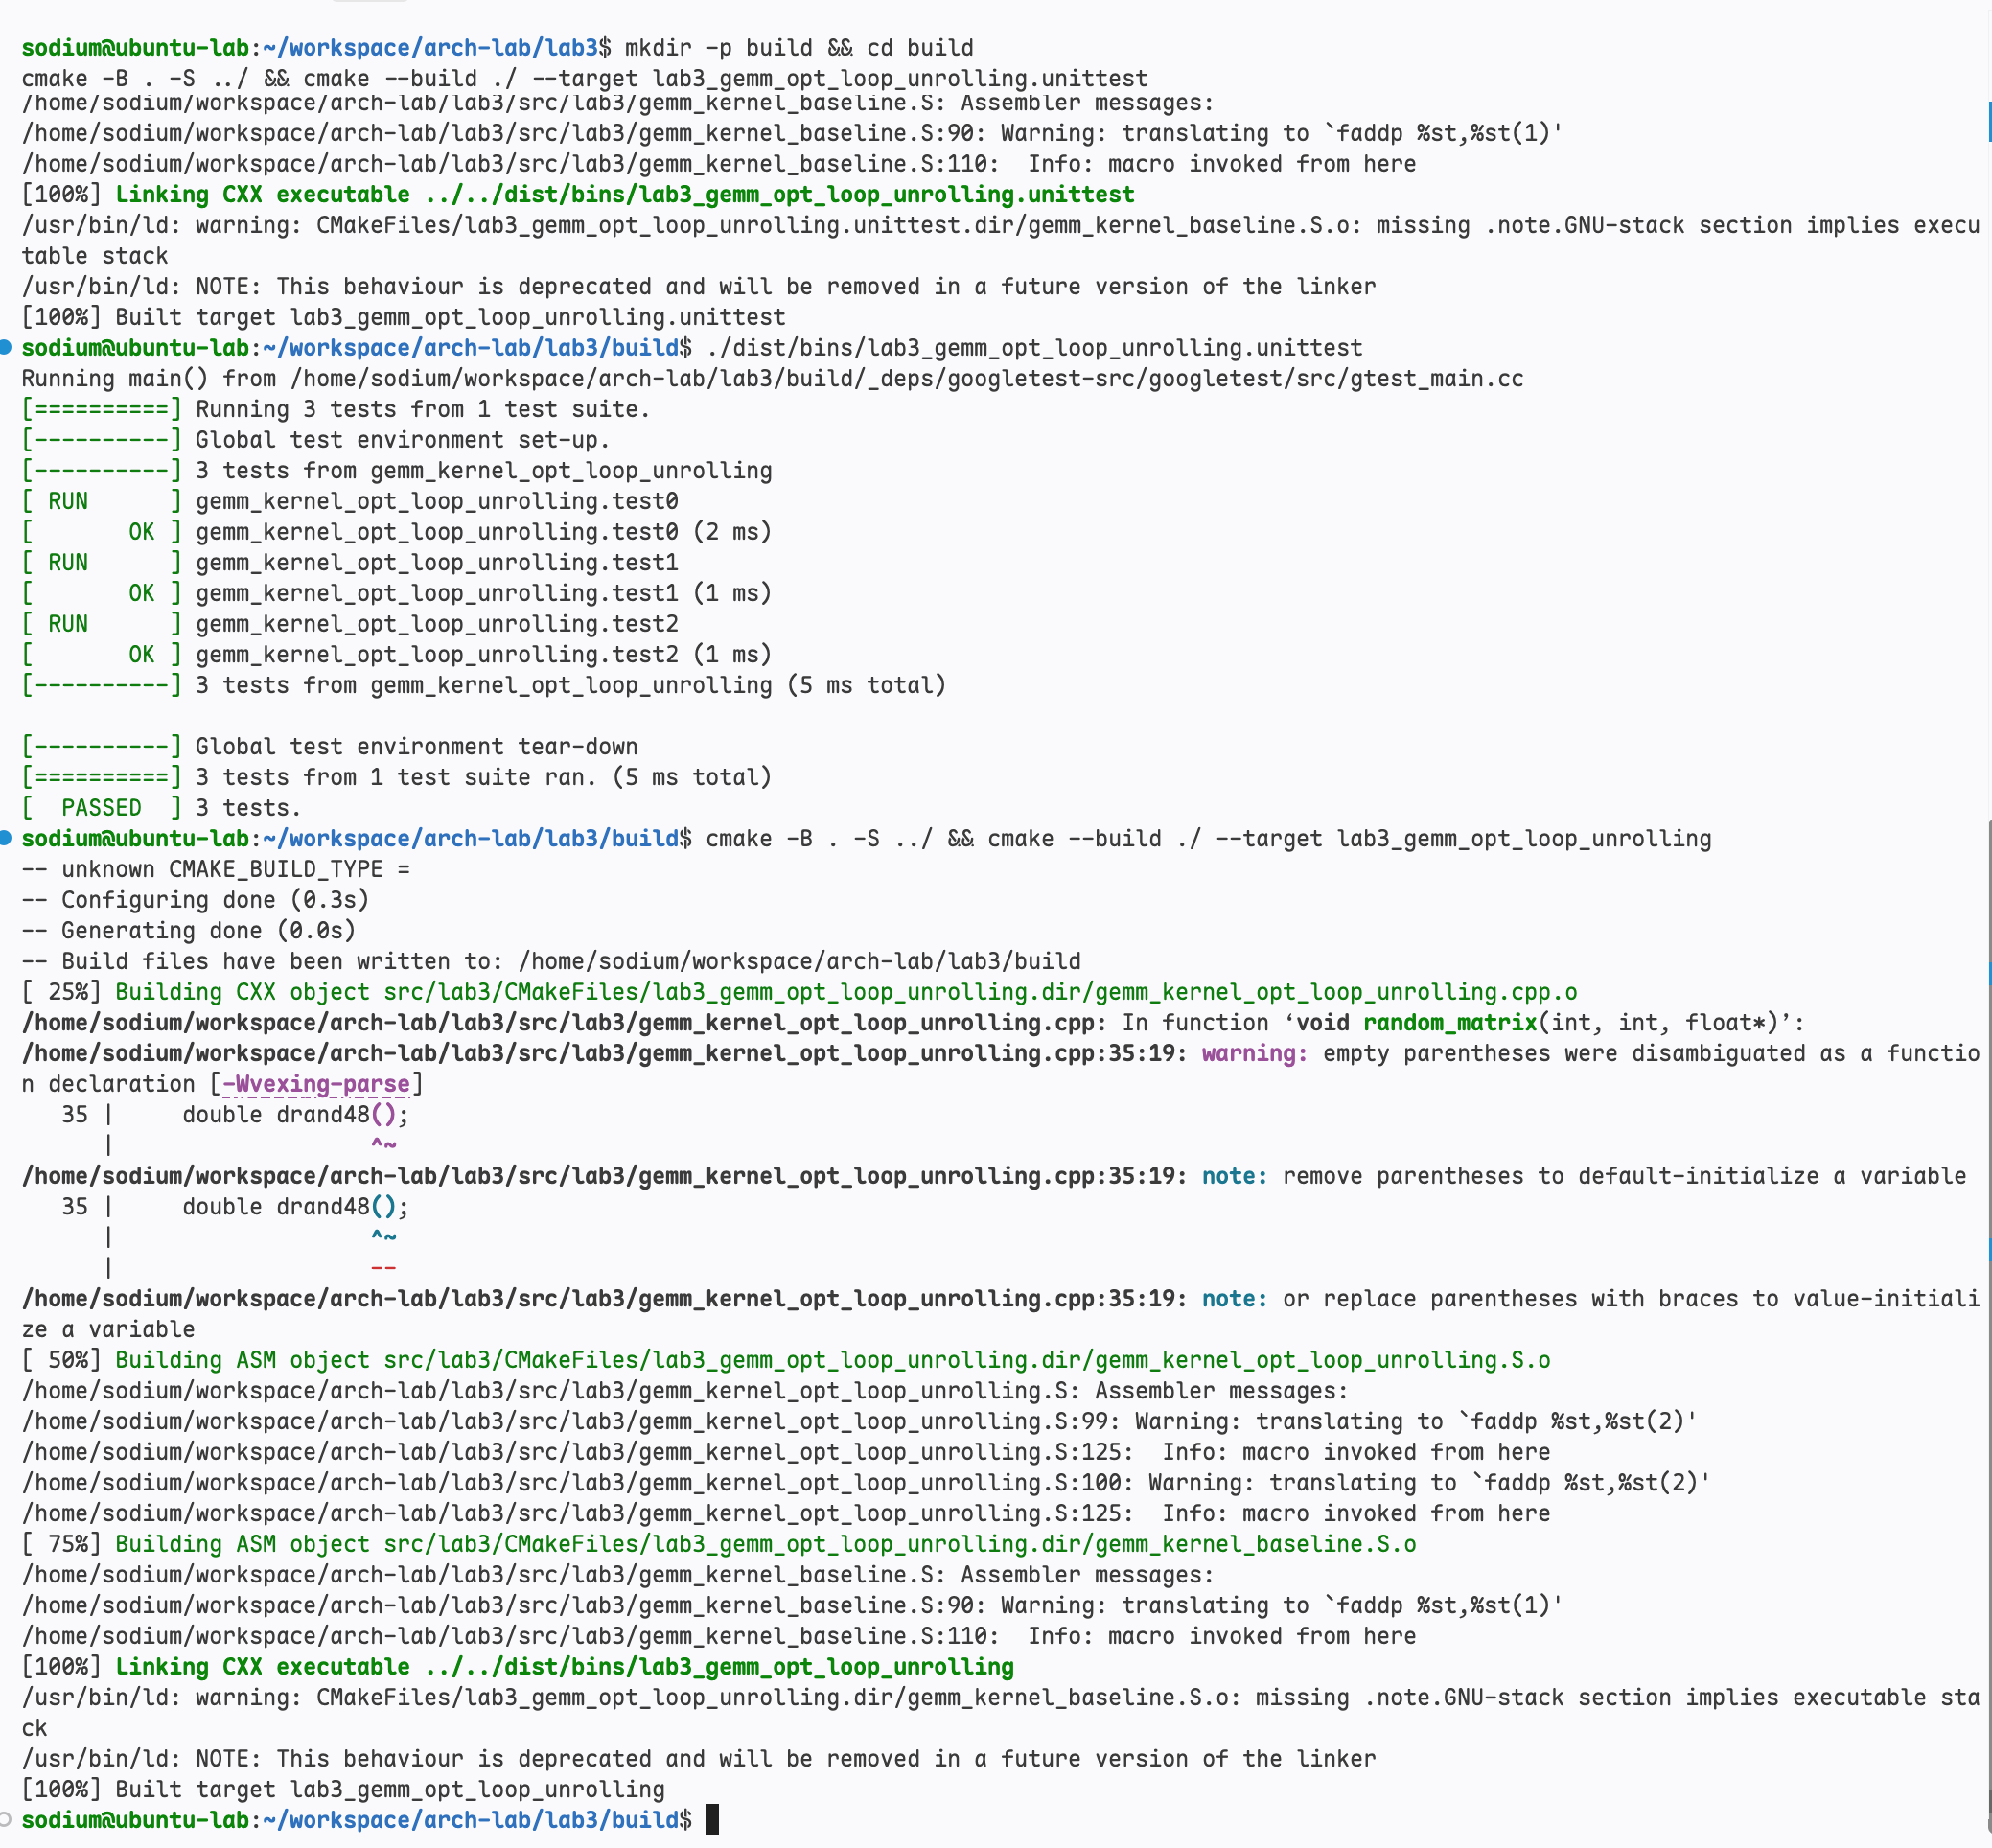
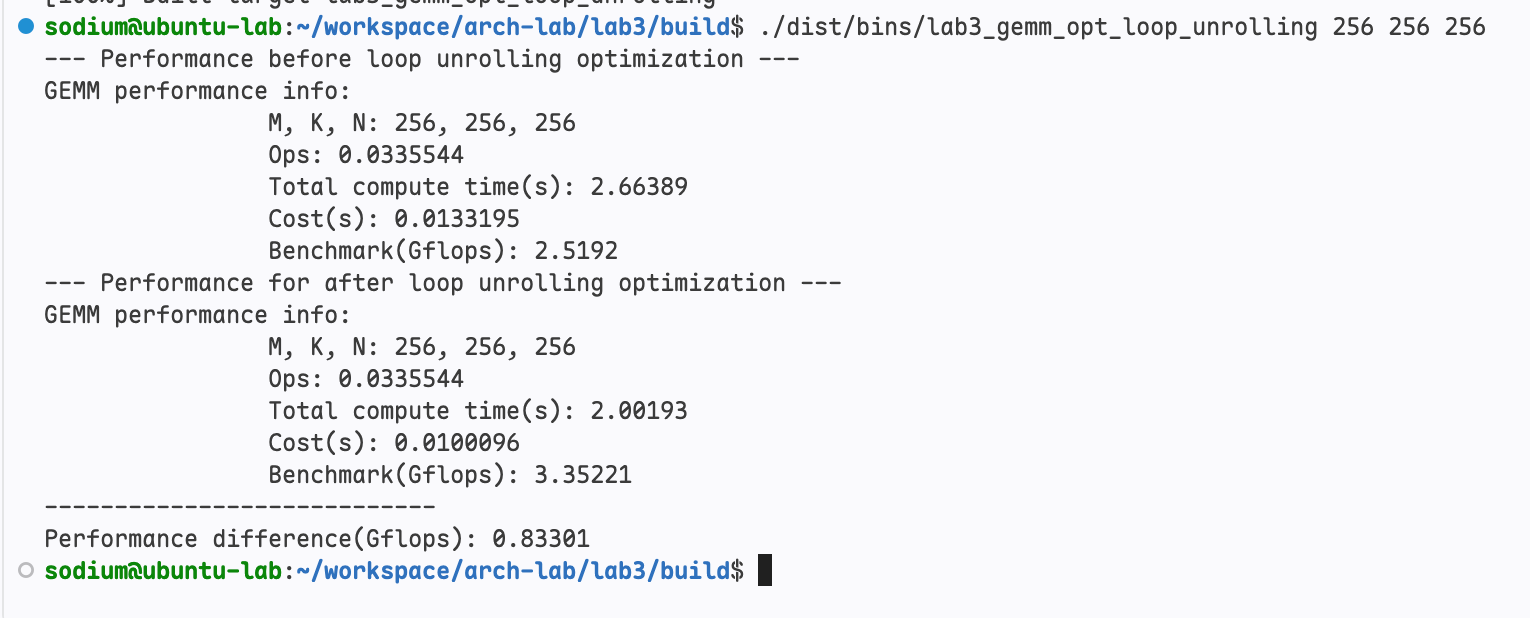
可以看到循环展开之后有明显提升
实验还要求测试不同循环展开度的性能差异。把展开度分别设为 1(即 baseline,不展开)、2(上文 TODO 完成的情况)、4,在 128 / 256 / 512 三种规模下对比 Gflops:
| 展开度 | 128 | 256 | 512 |
|---|---|---|---|
| 1 (baseline) | 2.50 | 2.51 | 2.47 |
| 2 | 3.35 | 3.33 | 3.31 |
| 4 | 4.67 | 4.76 | 4.74 |
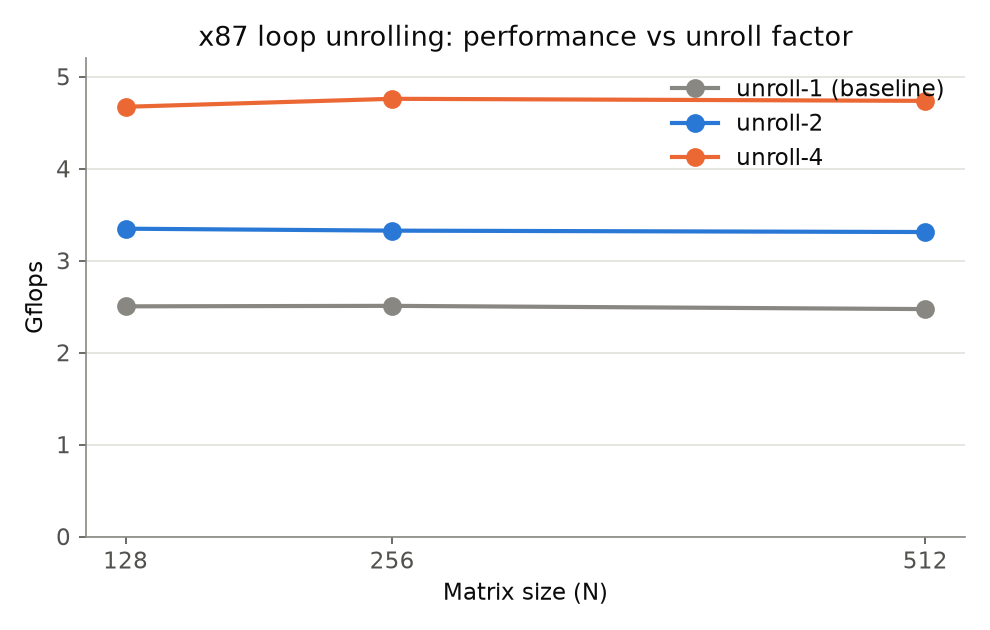
展开度 2 相对 baseline 约提升 33%,展开度 4 约提升 87%。由于 x87 只有 8 个栈寄存器,展开度 4 时需要用 fmuls 的内存操作数直接读取 A(4 个乘积 + 4 个 C 恰好占满 8 个寄存器),这已经是 x87 展开的极限,再增加到展开度 8 会超出寄存器数量而不可行。
练习二:基于AVX指令设计并实现高性能矩阵乘法计算内核
本实验要求补全 src/lab3/gemm_kernel_opt_avx.S,利用AVX指令实现性能更好的矩阵乘法计算内核。
这里需要用到的指令有
vbroadcastss <addr> <avx register>将该地址的数据广播到 avx 寄存器的八个单元vmovups <addr>, <avx register>将该地址起始的8个单精度浮点数按顺序加载到 avx 寄存器中vmovups <avx register>, <addr>将 avx 寄存器内容保存vfmadd231ps <avx register1>, <avx register2>, <avx register3>r1 += r2*r3
    // 计算A[m][k]的字节地址
    mov temp_reg, mat_elem_idx
    shl $2, mat_elem_idx        // 左移,相当于乘4

    vbroadcastss (MAT_A, mat_elem_idx), mat_a0_0_8    // 将A[m][k]广播到AVX寄存器的8个单元

    // TODO 练习3: 请添加加载并广播A[m+1][k]-->mat_a1_0_8的逻辑
    add DIM_K, temp_reg
    mov temp_reg, mat_elem_idx
    shl $2, mat_elem_idx
    vbroadcastss (MAT_A, mat_elem_idx), mat_a1_0_8
其他的类似,下面是一部分代码
    // TODO 练习3: 请添加加载B[k][n:n+32]-->mat_b0_0_8, mat_b0_8_16, mat_b0_16_24, mat_b0_24_32的逻辑
    mov loop_k, %rax
    mul DIM_N
    mov %rax, temp_reg
    add loop_n, temp_reg
    mov temp_reg, mat_elem_idx
    shl $2, mat_elem_idx
    vmovups (MAT_B, mat_elem_idx), mat_b0_0_8
    add $32, mat_elem_idx           // 8*4
    vmovups (MAT_B, mat_elem_idx), mat_b0_8_16
    add $32, mat_elem_idx
    vmovups (MAT_B, mat_elem_idx), mat_b0_16_24
    add $32, mat_elem_idx
    vmovups (MAT_B, mat_elem_idx), mat_b0_24_32
    // TODO 练习3: 请添加保存mat_c1_0_8, mat_c1_8_16, mat_c1_16_24, mat_c1_24_32 --> C[m+1][n:n+32]的逻辑
    mov temp_reg, mat_elem_idx
    add DIM_N, mat_elem_idx
    shl $2, mat_elem_idx        // 左移,相当于乘4
    vmovups mat_c1_0_8,   (MAT_C, mat_elem_idx)
    add $32, mat_elem_idx   // 8*4
    vmovups mat_c1_8_16,  (MAT_C, mat_elem_idx)
    add $32, mat_elem_idx
    vmovups mat_c1_16_24, (MAT_C, mat_elem_idx)
    add $32, mat_elem_idx
    vmovups mat_c1_24_32, (MAT_C, mat_elem_idx)
.macro DO_COMPUTE      // 计算 C[m:m+2][n:n+32] += A[m:m+2][k] * B[k:k+8][n:n+32]
    // TODO 练习3: 请添加计算C[m:m+2][n:n+32] += A[m:m+2][k] * B[k:k+8][n:n+32]的逻辑
    vfmadd231ps mat_a0_0_8, mat_b0_0_8, mat_c0_0_8
    vfmadd231ps mat_a0_0_8, mat_b0_8_16, mat_c0_8_16
    vfmadd231ps mat_a0_0_8, mat_b0_16_24, mat_c0_16_24
    vfmadd231ps mat_a0_0_8, mat_b0_24_32, mat_c0_24_32
    vfmadd231ps mat_a1_0_8, mat_b0_0_8, mat_c1_0_8
    vfmadd231ps mat_a1_0_8, mat_b0_8_16, mat_c1_8_16
    vfmadd231ps mat_a1_0_8, mat_b0_16_24, mat_c1_16_24
    vfmadd231ps mat_a1_0_8, mat_b0_24_32, mat_c1_24_32
.endm
# build目录下执行
cmake -B . -S ../ && cmake --build ./ --target lab3_gemm_opt_avx.unittest
./dist/bins/lab3_gemm_opt_avx.unittest

cmake -B . -S ../ && cmake --build ./ --target lab3_gemm_opt_avx
./dist/bins/lab3_gemm_opt_avx 256 256 256
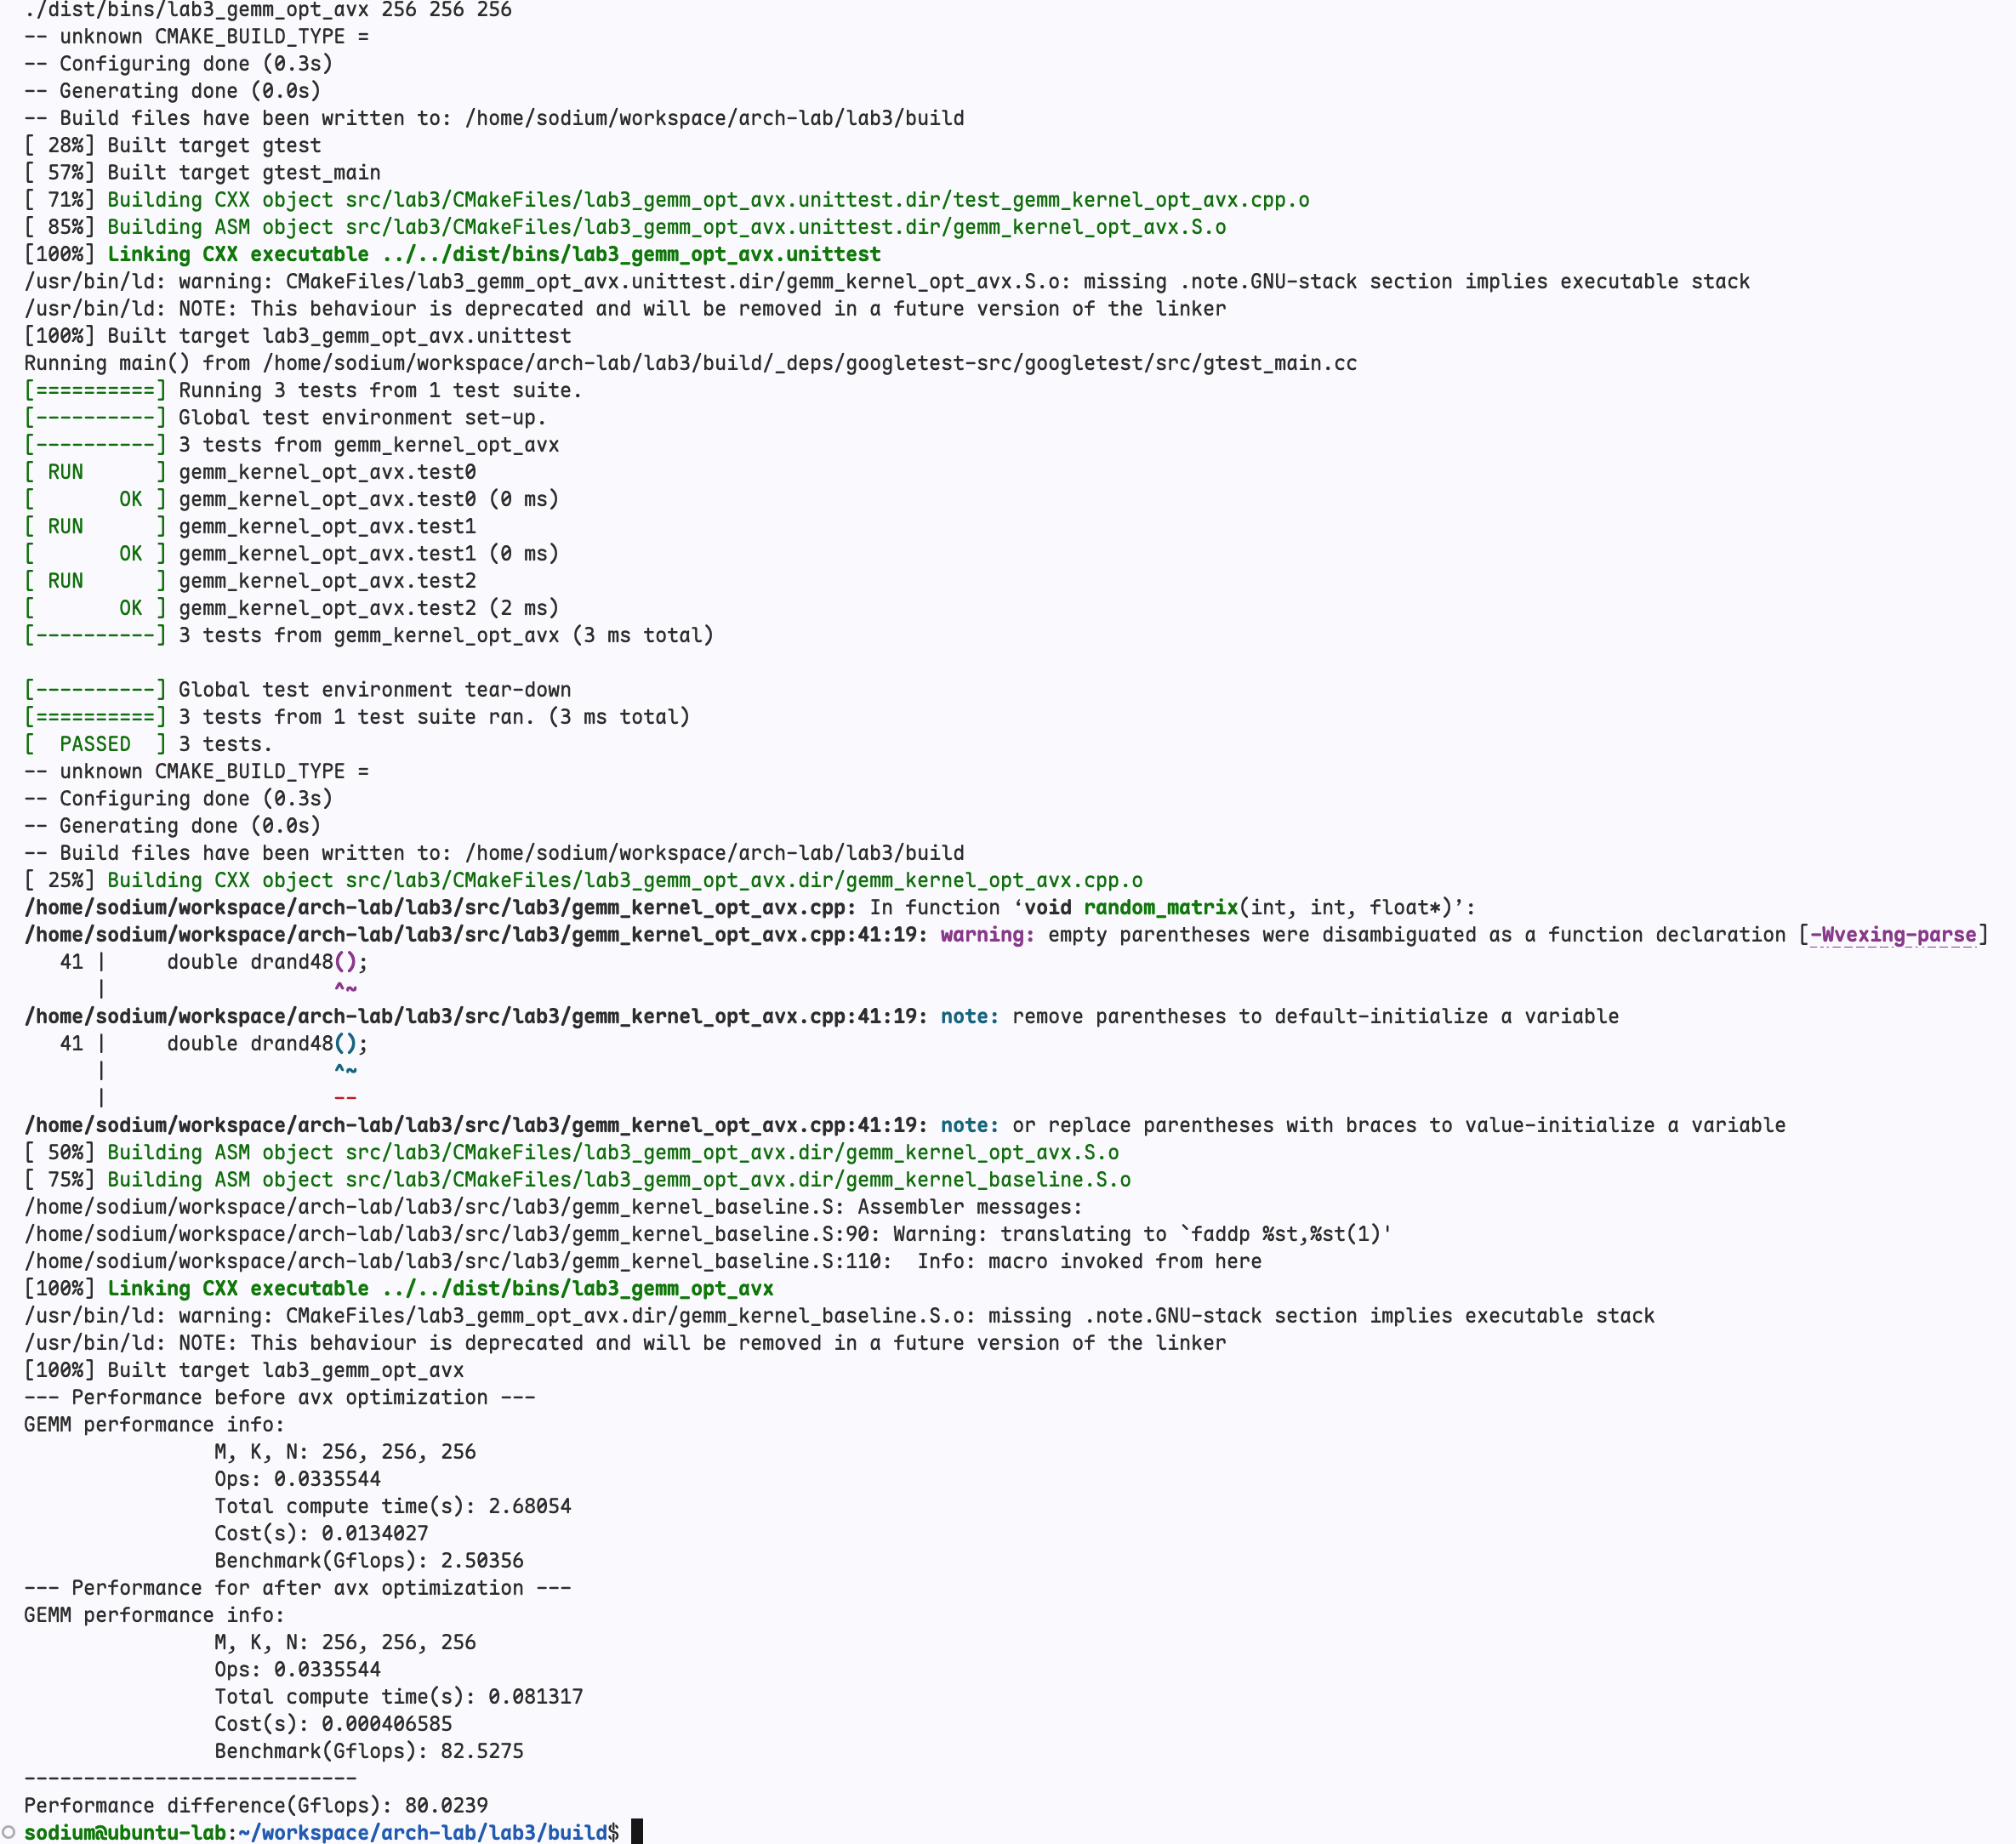
可以看到性能提升巨大
现在改变输入矩阵的数据规模(比如边长为32、64、128等),测试AVX矩阵乘法内核的性能数据,并绘制性能变化曲线图。
结果如下
sodium@ubuntu-lab:~/workspace/arch-lab/lab3/build$ ./dist/bins/lab3_gemm_opt_avx 32 32 32
--- Performance before avx optimization ---
GEMM performance info:
                M, K, N: 32, 32, 32
                Ops: 6.5536e-05
                Total compute time(s): 0.005304
                Cost(s): 2.652e-05
                Benchmark(Gflops): 2.47119
--- Performance for after avx optimization ---
GEMM performance info:
                M, K, N: 32, 32, 32
                Ops: 6.5536e-05
                Total compute time(s): 0.000127
                Cost(s): 6.35e-07
                Benchmark(Gflops): 103.206
----------------------------
Performance difference(Gflops): 100.735
sodium@ubuntu-lab:~/workspace/arch-lab/lab3/build$ ./dist/bins/lab3_gemm_opt_avx 64 64 64
--- Performance before avx optimization ---
GEMM performance info:
                M, K, N: 64, 64, 64
                Ops: 0.000524288
                Total compute time(s): 0.041527
                Cost(s): 0.000207635
                Benchmark(Gflops): 2.52505
--- Performance for after avx optimization ---
GEMM performance info:
                M, K, N: 64, 64, 64
                Ops: 0.000524288
                Total compute time(s): 0.00099
                Cost(s): 4.95e-06
                Benchmark(Gflops): 105.917
----------------------------
Performance difference(Gflops): 103.392
sodium@ubuntu-lab:~/workspace/arch-lab/lab3/build$ ./dist/bins/lab3_gemm_opt_avx 128 128 128
--- Performance before avx optimization ---
GEMM performance info:
                M, K, N: 128, 128, 128
                Ops: 0.0041943
                Total compute time(s): 0.333643
                Cost(s): 0.00166822
                Benchmark(Gflops): 2.51425
--- Performance for after avx optimization ---
GEMM performance info:
                M, K, N: 128, 128, 128
                Ops: 0.0041943
                Total compute time(s): 0.008903
                Cost(s): 4.4515e-05
                Benchmark(Gflops): 94.2223
----------------------------
Performance difference(Gflops): 91.708
sodium@ubuntu-lab:~/workspace/arch-lab/lab3/build$ ./dist/bins/lab3_gemm_opt_avx 256 256 256
--- Performance before avx optimization ---
GEMM performance info:
                M, K, N: 256, 256, 256
                Ops: 0.0335544
                Total compute time(s): 2.6793
                Cost(s): 0.0133965
                Benchmark(Gflops): 2.50472
--- Performance for after avx optimization ---
GEMM performance info:
                M, K, N: 256, 256, 256
                Ops: 0.0335544
                Total compute time(s): 0.08141
                Cost(s): 0.00040705
                Benchmark(Gflops): 82.4332
----------------------------
Performance difference(Gflops): 79.9285
sodium@ubuntu-lab:~/workspace/arch-lab/lab3/build$ ./dist/bins/lab3_gemm_opt_avx 512 512 512
--- Performance before avx optimization ---
GEMM performance info:
                M, K, N: 512, 512, 512
                Ops: 0.268435
                Total compute time(s): 21.73
                Cost(s): 0.10865
                Benchmark(Gflops): 2.47064
--- Performance for after avx optimization ---
GEMM performance info:
                M, K, N: 512, 512, 512
                Ops: 0.268435
                Total compute time(s): 0.930874
                Cost(s): 0.00465437
                Benchmark(Gflops): 57.6739
----------------------------
Performance difference(Gflops): 55.2032
sodium@ubuntu-lab:~/workspace/arch-lab/lab3/build$
可以绘制性能变化曲线图如下
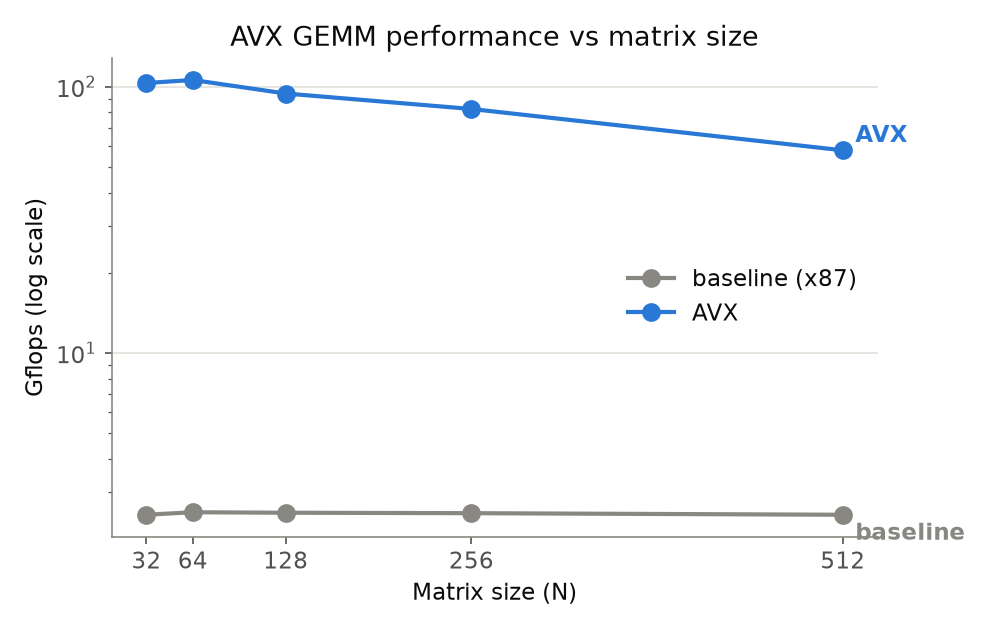
不难发现随着矩阵规模的增大,性能差异正在缩小,但仍然有巨大的优势
练习三 (选做):基于OpenMP库和练习2实现的高性能计算内核实现任意形状的矩阵乘法计算
- 任务:利用OpenMP库将练习2实现的单线程高性能矩阵乘法内核扩展到多核以实现计算更大规模的矩阵乘法的目标。
- 子任务:
- 矩阵乘法能够利用多线程实现对 M>2, K>8, N>8 形状的计算;
- 切分后不满足练习2内核要求大小的数据块允许采用Padding或另行设计内核的方式进行计算;
- 自行设计各个维度的并行策略但线程总数不能超过函数参数中指定的线程总数;
- 计算性能需超过基线。
参考 src/lab3/openmp_gemm_baseline.cpp,利用OpenMP库设计基于多核的支持更大规模的矩阵乘法计算的算法,并将逻辑填入 src/lab3/openmp_gemm_opt.cpp
原本的 baseline 程序部分内容如下
inline int get_parallel_thread_num(uint64_t M, uint64_t K, uint64_t N, int kernel_mr, int kernel_nr, int max_threads, int& m_thread, int& n_thread) {
    m_thread = 2;
    if (m_thread > max_threads) {
        m_thread = max_threads;
    }
    n_thread = max_threads / m_thread;
    return m_thread * n_thread;
}

void openmp_gemm_opt(int thread_num, float *C, float *A, float *B, uint64_t M, uint64_t N, uint64_t K){
    // TODO: 练习3的性能优化任务
    // 定义常量
    const int KERNEL_MR = 2, KERNEL_NR = 32;    // TODO: 取值请根据AVX内核实际情况修改
    int m_thread = 1, n_thread = 1;
    // 计算并行线程
    int real_thread_num = get_parallel_thread_num(M, K, N, KERNEL_MR, KERNEL_NR, thread_num, m_thread, n_thread);

#pragma omp parallel num_threads(real_thread_num) \
            default(none) \
            shared(C) \
            firstprivate(A, B, M, N, K, KERNEL_MR, KERNEL_NR, \
                m_thread, n_thread)
    {
        const int kernel_size = KERNEL_MR * KERNEL_NR;
        int thread_id = omp_get_thread_num();  // 线程分配依然采用行主序,即从一行来看,线程序号为 0, 1, 2, 3, ...,
        /* 计算三个维度的子索引 */
        int thread_id_m = thread_id / n_thread;  // M 维度的索引
        int thread_id_n = thread_id % n_thread;  // N维度的索引
        /* 开始计算三个维度计算起始的索引 */
        ...
        // 将目标分块其拷贝到新的内存区域中
        // 然后调用内核计算
        gemm_kernel_opt_avx(C_padding, A_padding, B_padding, (dim_m_per_thread + m_padding),
                                 (dim_n_per_thread + n_padding), K);
    }
        // 拷回计算结果数据
        for (int m = thread_m_start; m < thread_m_end; m++) {
            memcpy(C + m * N + thread_n_start,
                   C_padding + (m - thread_m_start) * (dim_n_per_thread + n_padding),
                   (thread_n_end - thread_n_start) * sizeof(float));
        }
        // 释放原本申请的内存
        delete[] A_padding;
        delete[] B_padding;
        delete[] C_padding;
}
在上面的代码中
real_thread_num指定线程数。- 目标矩阵
C被所有线程共享,因为每个线程实际写入的区域不一样,所以不用担心并发问题 A, B, M, N, K, KERNEL_MR, KERNEL_NR, m_thread, n_thread在每个线程中都有私有副本,初始值来自进入并行区域前的主线程。这样每个线程可以安全地读取这些值,而不会因为共享导致意外修改或缓存不一致。default(none)确保没有遗漏声明,所有用到的变量都已明确属性。
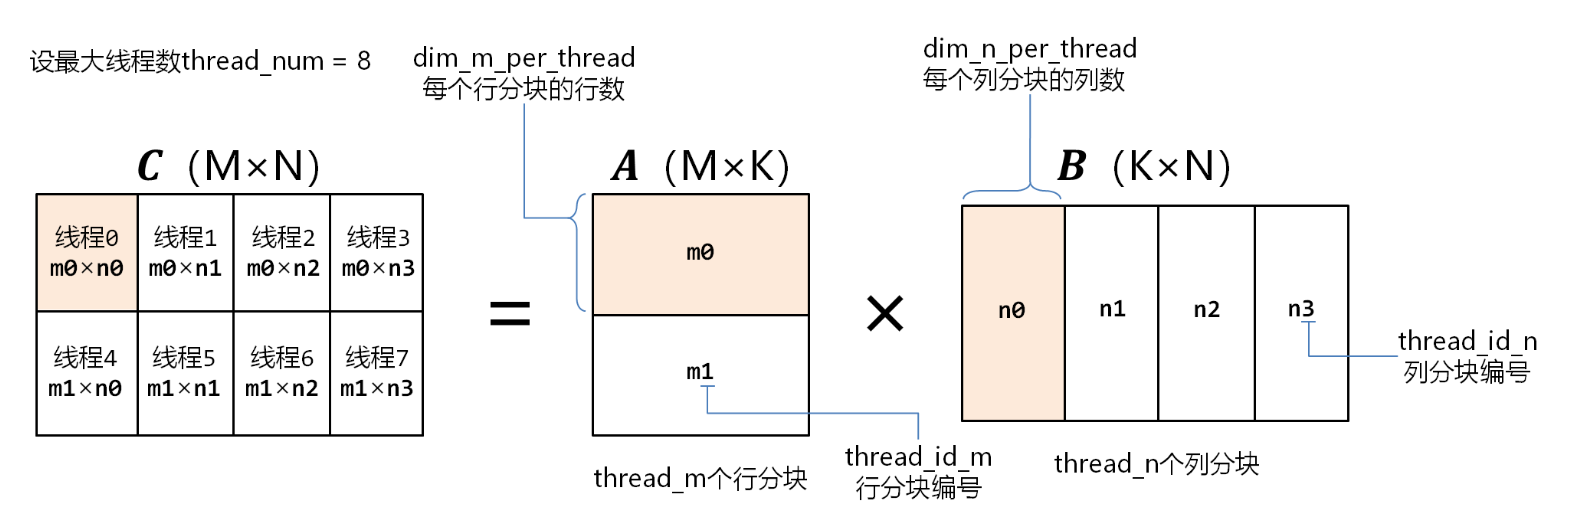
下面是 GPT 根据 baseline 生成的示意图
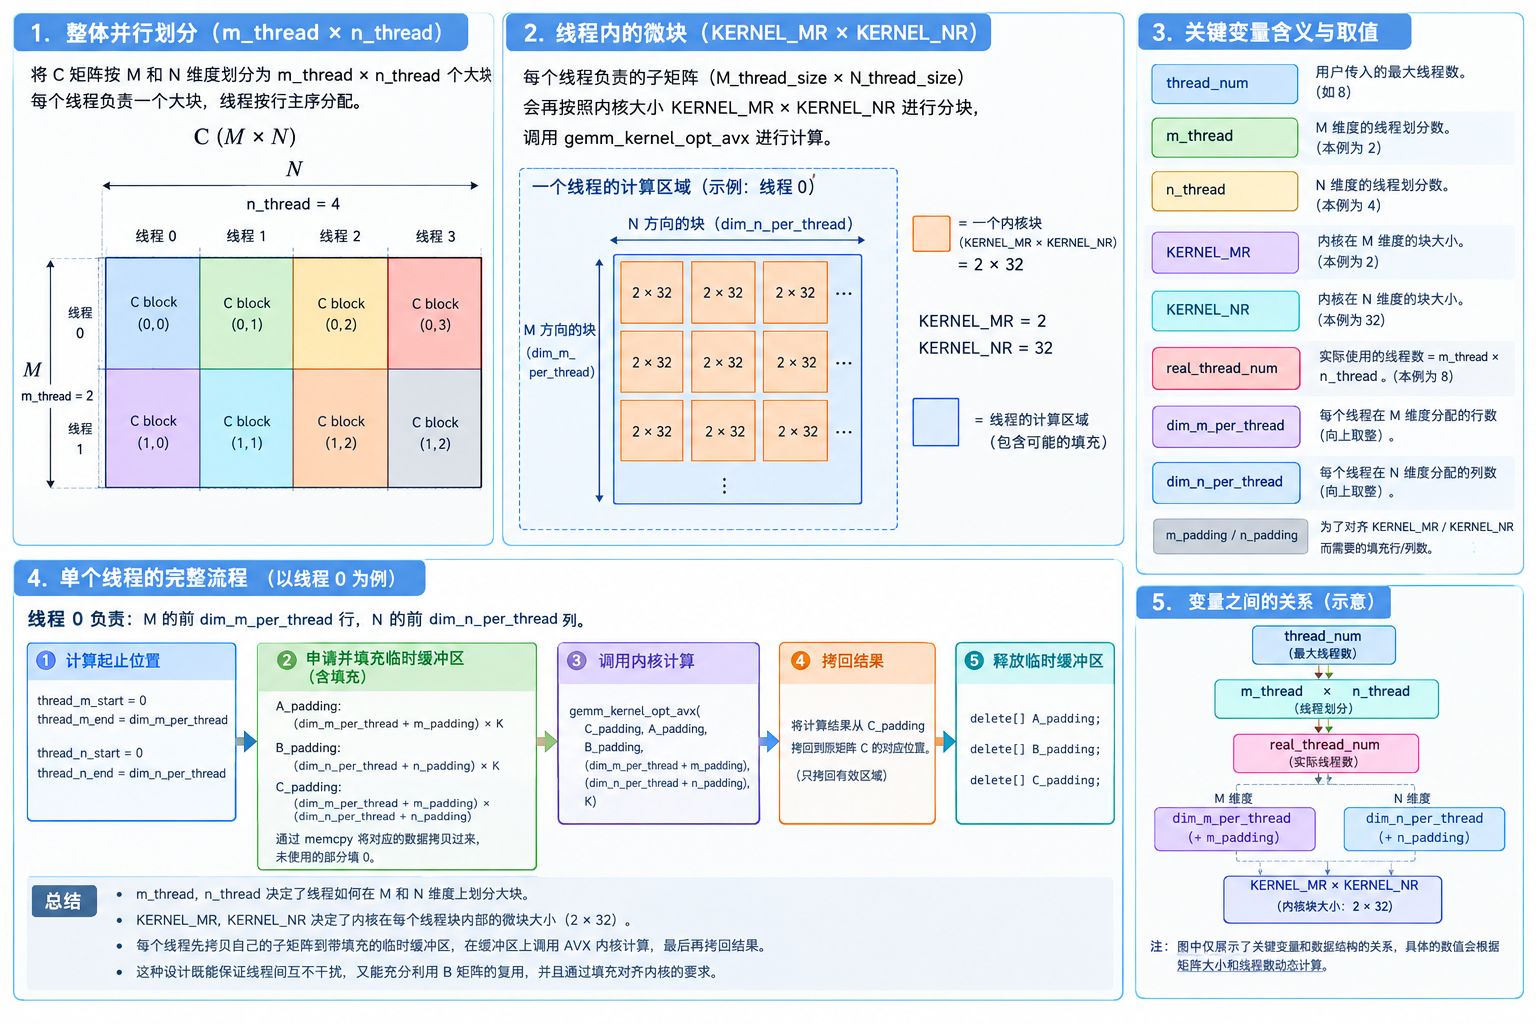
const int KERNEL_MR = 2, KERNEL_NR = 32; // TODO: 取值请根据AVX内核实际情况修改
这里 MR=2, NR=32 刚好是前面 avx 一次循环的规模
这是直接拷贝代码进行运行的结果
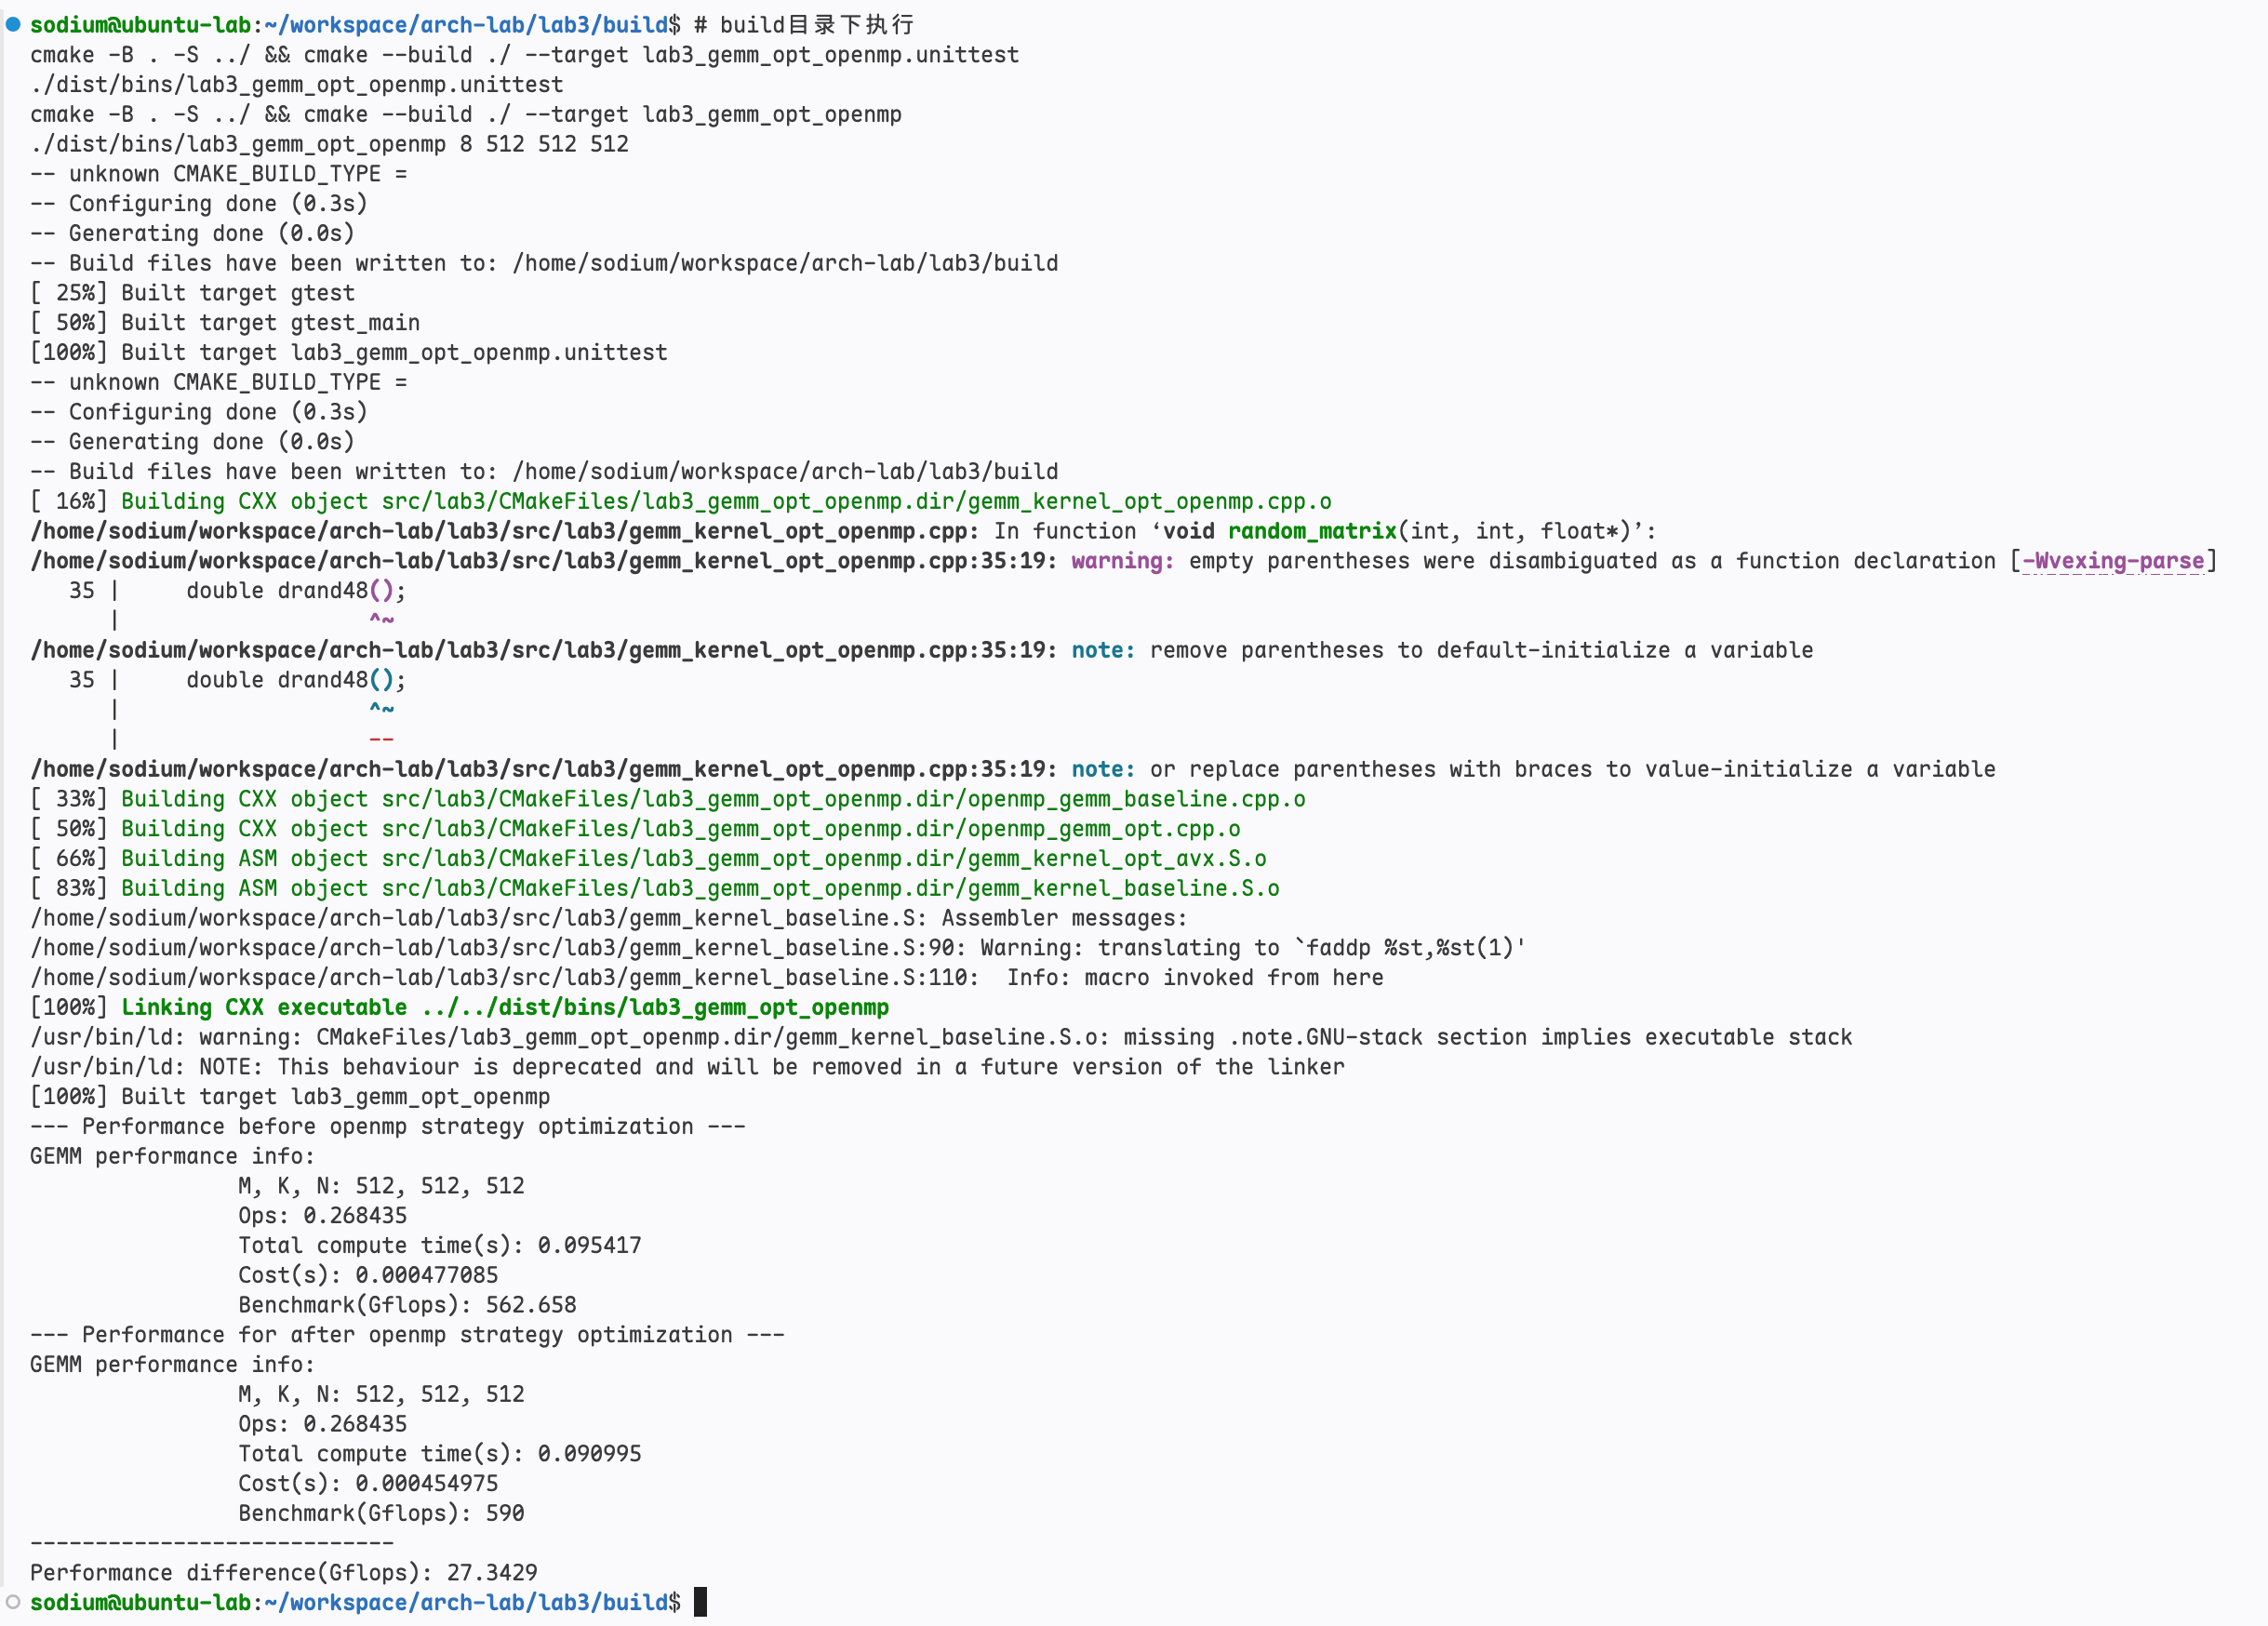
完成后尝试运行
# build目录下执行
cmake -B . -S ../ && cmake --build ./ --target lab3_gemm_opt_openmp.unittest
./dist/bins/lab3_gemm_opt_openmp.unittest
cmake -B . -S ../ && cmake --build ./ --target lab3_gemm_opt_openmp
./dist/bins/lab3_gemm_opt_openmp 8 512 512 512
优化
分析 baseline 的拷贝,能发现两处冗余:
A 的冗余拷贝:baseline 每个线程都把自己的 A 行块
memcpy进A_padding,但 A 的行块在原矩阵中本来就是连续的(行主序)。当m_padding == 0(行块行数是KERNEL_MR的整数倍)时,直接把A + thread_m_start * K的指针传给内核即可,整份 A 拷贝都可以省掉。B 的冗余拷贝:baseline 固定
m_thread = 2,意味着同一个 B 列块会被 M 方向的 2 个线程各拷贝一份。改成「N 维优先并行」(m_thread = 1),B 就只拷贝一次。
同时把 get_parallel_thread_num 改成按 M/N 比例动态划分:N 足够分时优先 N 并行,N 分不动(每个线程分不到一个完整 AVX 列块)时才把线程挪到 M 维。
优化后的核心改动如下:
inline int get_parallel_thread_num(uint64_t M, uint64_t K, uint64_t N, int kernel_mr, int kernel_nr, int max_threads, int& m_thread, int& n_thread) {
    (void)K; (void)kernel_mr; (void)kernel_nr;
    // 优先 N 维并行(m_thread=1):A 免拷贝共享读,B 只拷贝一次
    int mt = 1;
    int nt = max_threads;
    while (nt > 1 && (int)N / nt < kernel_nr) {
        mt *= 2;
        nt = max_threads / mt;
        if (mt >= max_threads) { mt = max_threads; nt = 1; break; }
    }
    m_thread = mt;
    n_thread = nt;
    return mt * nt;
}
A 免拷贝的关键判断:
// 完整块且 m_padding==0 时,直接复用原 A 的连续行块,免拷贝
const float *A_ptr;
float *A_padding = nullptr;
if (m_padding == 0 && m_rows == dim_m_per_thread) {
    A_ptr = A + (uint64_t)thread_m_start * K;
} else {
    // ... 拷贝 + padding ...
}
运行结果(8 512 512 512 与 8 256 256 256):
| 规模 | baseline | opt | 提升 |
|---|---|---|---|
| 8, 512, 512, 512 | 630.5 | 649.6 | +3.0% |
| 8, 256, 256, 256 | 348.4 | 527.3 | +51.4% |
矩阵规模越小,拷贝在总开销中的占比越大,优化收益越明显;规模越大越接近 AVX 计算峰值,拷贝优化的空间越小。
附录
x86 汇编相关知识
.section .bss, .section .data 是程序中不同的段
| 段 | 存放内容 | 文件中是否占空间 |
|---|---|---|
.text | 代码 | 占 |
.rodata | 只读常量 | 占 |
.data | 已初始化的全局/静态变量 | 占 |
.bss | 未初始化或全零变量 | 不占(只记录大小) |
而 .lcomm, .global 含义如下
| 伪指令 | 作用 |
|---|---|
.lcomm buffer, 1024 | 分配局部符号的空间 |
.comm buffer, 1024 | 声明公共符号,通常允许链接器合并多个同名的公共声明 |
.globl buffer | 将符号声明为全局可见 |
而 newline:, _start: 这些则是不同的标签,用来记录内存地址的。
其中 newline: 后面的 .byte 10:表示在 newline 这个位置存放一个字节,值为 10,对应 ASCII 的 LF 换行符。
.p2align 2:按 2 的幂次对齐当前位置。2 表示 2^2 = 4 字节边界对齐。常用于保证后续函数/指令地址是 4 字节对齐。如果已对齐则不填充,否则填充 NOP/零等。
.type gemm_kernel, %function:设置符号 gemm_kernel 类型为函数。帮助链接器/调试器/动态链接处理,例如函数调用、异常展开等。不是实际指令,不生成机器码。
关于寻址方式,需要注意的是 %rip 出现时可能和普通情况不一样
| 寻址方式 | 汇编示例 | 地址计算 / 操作含义 |
|---|---|---|
| 立即数寻址 | mov $0x1234, %rax | RAX = 0x1234 |
| 寄存器寻址 | mov %r8, %rax | RAX = R8 |
| 绝对地址寻址 | mov 0x1234, %eax | EAX = MEM[0x1234] |
| 寄存器间接寻址 | mov (%rsp), %rax | RAX = MEM[RSP] |
| 基址 + 位移 | mov -20(%rsp), %rax | RAX = MEM[RSP - 20] |
| 基址 + 变址 | mov (%rsp,%rcx), %rax | RAX = MEM[RSP + RCX] |
| 基址 + 比例变址 | mov (%rsp,%rcx,4), %rax | RAX = MEM[RSP + RCX × 4] |
| 基址 + 变址 + 位移 | mov -20(%rsp,%rcx), %rax | RAX = MEM[RSP + RCX - 20] |
| 完整组合寻址 | mov 16(%rsp,%rcx,4), %rax | RAX = MEM[RSP + RCX × 4 + 16] |
| RIP 相对寻址 | mov 20(%rip), %rax | RAX = MEM[指令末尾地址 + 20] |
| 符号的 RIP 相对寻址 | mov buffer(%rip), %rax | RAX = MEM[buffer] |
| RIP 相对地址计算 | lea buffer+20(%rip), %rdi | RDI = buffer + 20 |
| 绝对地址加载 | movabs $0x123456789ABCDEF0, %rax | RAX = 0x123456789ABCDEF0 |
| 相对跳转 | jmp loop | 跳转到标签 loop |
| I/O 端口寻址 | in $0x60, %al | 从 I/O 端口 0x60 读取 1 字节 |
关于指令和寄存器,详见
x87 FPU 相关知识
x87 FPU浮点运算单元包含
- 8个80位的通用寄存器 R0 ~ R7
- 3个16位的状态和控制寄存器
- 2个48位的指针寄存器
- 以及1个11位的操作码寄存器
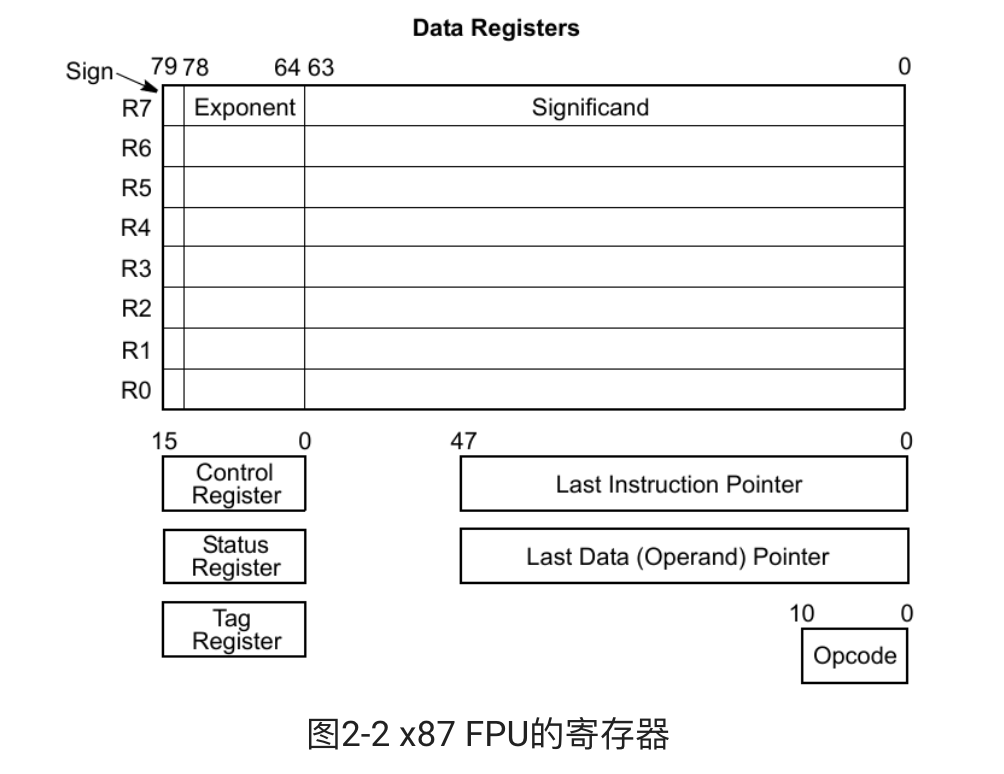
x87 FPU指令支持以栈的形式访问8个通用寄存器,且处于栈顶的数据始终被标记为 st(0)
下面是一个计算例子
...
flds (MAT_A, mat_elem_idx, 4)                   // 加载单精度浮点数 A[mat_elem_idx] 到 st(0)
                                                // A[..]
...
flds (MAT_B, mat_elem_idx, 4)                   // 加载 B[mat_elem_idx]
                                                // B[..], A[..]
fmul %st(1), %st(0)                             // st(0) *= st(1)
                                                // A[..]*B[..], A[..]
...
flds (MAT_C, mat_elem_idx, 4)                   // st(0) = C[..]
                                                // C[..], A[..]*B[..], A[..]
faddp %st(1), %st(0)                            // %st(1) += %st(0), pop
                                                // A[..] * B[..] + C[..], A[..]
fstps (MAT_C, mat_elem_idx, 4)                  // 写入,并且 pop
                                                // A[..]
fstp %st(0)                                     // 清空st(0), 此时矩阵A的元素不再使用
关于这里的 faddp 指令,同时存在两种情况
faddp %st(0), %st(1)
和
faddp %st(1), %st(0)
实际上正确的写法是目标寄存器在后面,按照 AT&T 语法是这样的,实验包的代码使用的 faddp %st(1), %st(0) 以及指导书的 faddp %st(3), %st(0) 不是正确的用法,编译时,会产生警告并且自动转换
prefetch 指令
| 指令名称 | 指令功能 | 适用对象 |
|---|---|---|
prefetcht0 | 预取数据到所有层级的Cache中 | 短期内多次访问的数据 |
prefetcht1 | 预取数据到L2 Cache及更高层级的Cache中 | 短期内多次访问的数据 |
prefetcht2 | 预取数据到L2 Cache及更高层级的Cache中 | 短期内多次访问的数据 |
prefetchnta | 预取数据到某个层级的Cache(尽可能不影响Cache现有数据) | 短期内不需多次访问的数据 |
预取指令的使用方法是 prefetch<t0/t1/t2/nta> (<byte_addr>)。其中,byte_addr 是字节地址;预取的数据单元大小取决于具体的处理器实现,一般至少为32字节(通常是一个Cache缓存行的大小)
AMD 家族代号对应的 CPUs 如下
| Family | 微架构/系列 | 代表性处理器系列 | 备注 |
|---|---|---|---|
| Family 0Fh | K8 | Athlon 64, Opteron, Sempron | 早期64位架构 |
| Family 10h | K10 (K10.5) | Phenom, Phenom II, Athlon II, Opteron | |
| Family 11h | Turion/Turion 64 | Turion X2, Athlon X2, Sempron X2 | 移动平台衍生版 |
| Family 12h | Fusion (Llano) | A系列APU (E2/A4/A6/A8) | 首代APU |
| Family 14h | Brazos | C/E/G/Z系列APU | 低功耗APU |
| Family 15h | Bulldozer/Piledriver/Steamroller/Excavator | FX系列, A系列APU, Opteron | 模块化架构 |
| Family 16h | Jaguar/Puma | Kabini, Mullins | 低功耗APU,用于游戏主机 |
| Family 17h | Zen / Zen 2 | Ryzen 1000/2000/3000, EPYC 7001/7002 | 现代Zen架构起点 |
| Family 18h | Zen (Hygon) | Hygon Dhyana | 海光基于Zen的授权产品 |
| Family 19h | Zen 3 / Zen 4 | Ryzen 5000/6000/7000, EPYC 7003/9004 | 当前主流架构 |
我使用的 R7 8845H 属于 Zen 4 架构,对应 Family 19h
Software Optimization Guide for the AMD Zen4 Microarchitecture
The AMD Zen4 microarchitecture implements improved software prefetch control allowing the PREFETCH instructions to target either the L1 data cache or the L2 cache. The following table shows the behavior of the PREFETCH instruction on the Zen4 microarchitecture.
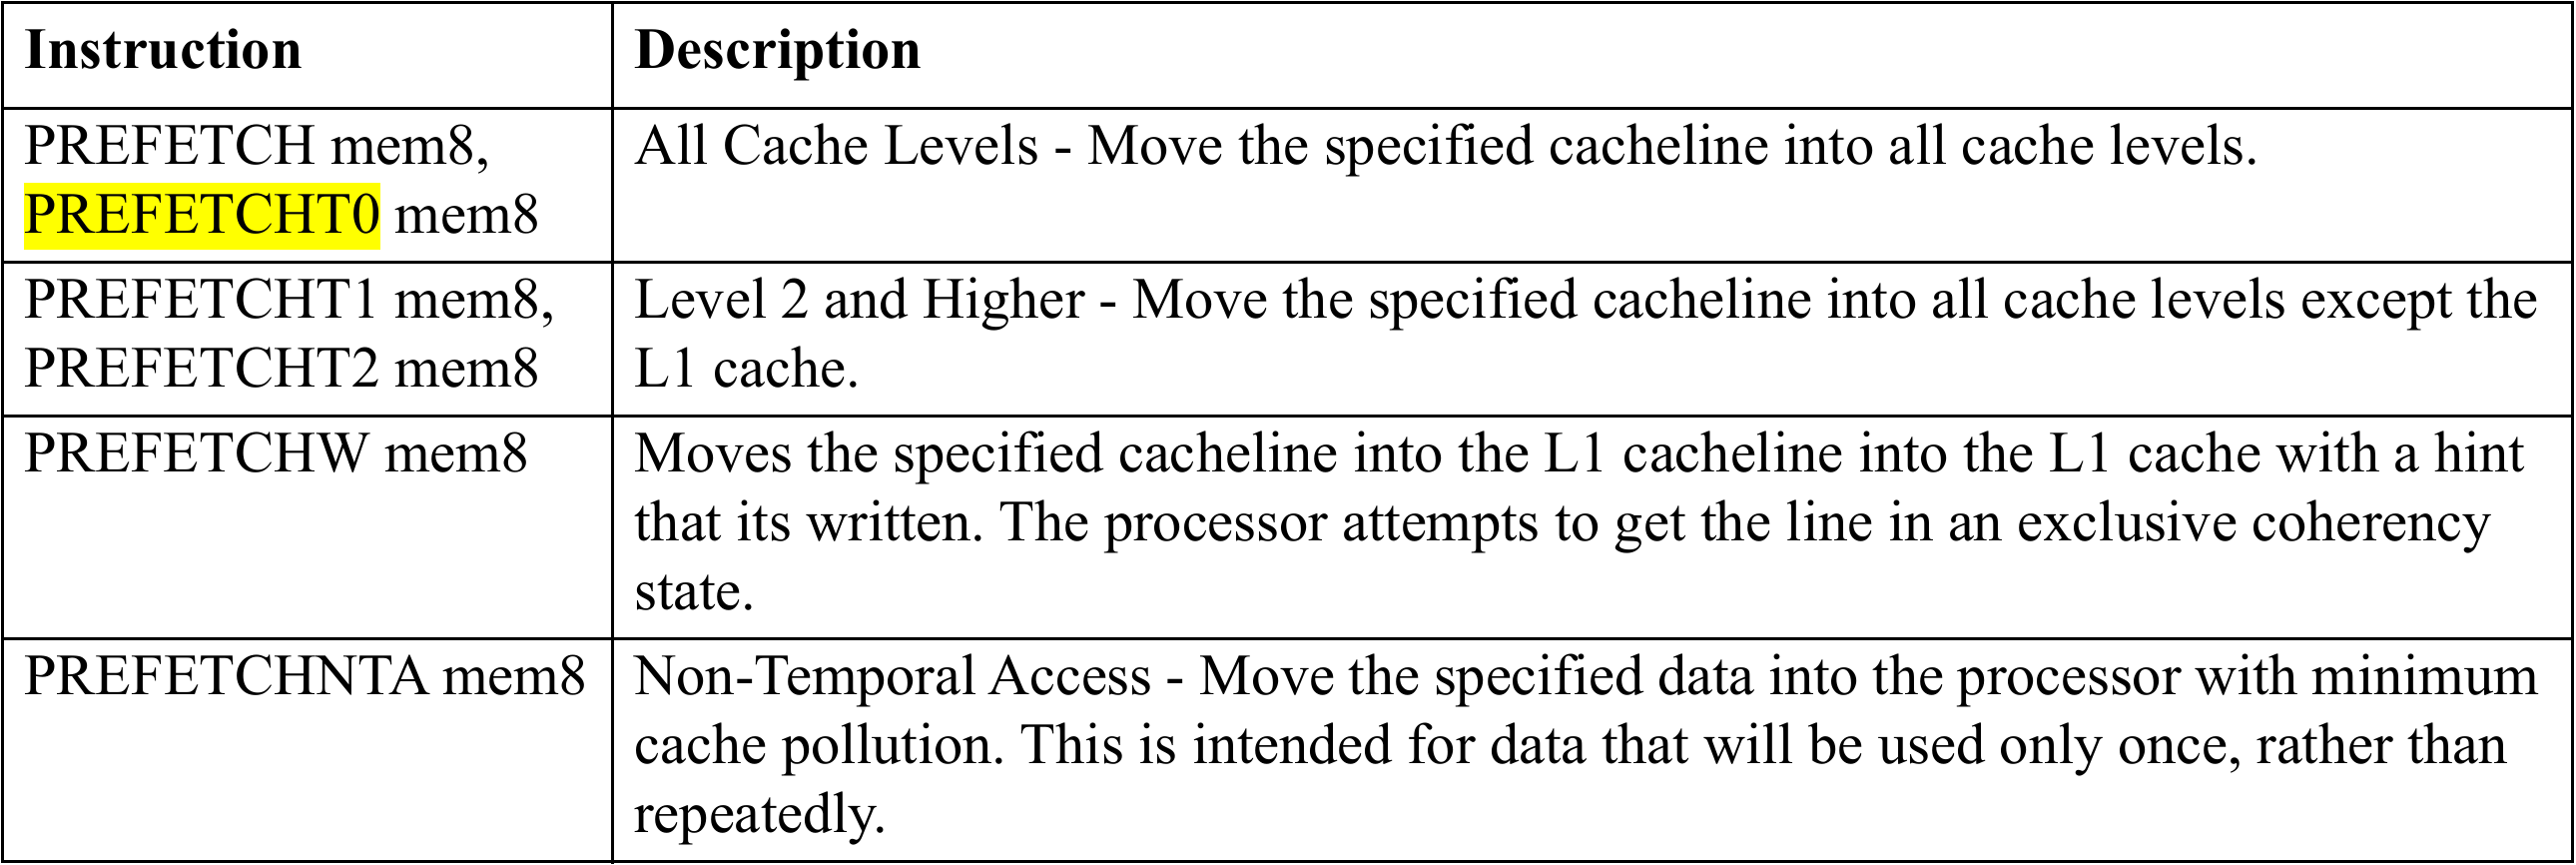
可以看到这里的描述和指导书的表格是一样的
Goto 算法
经典的 Goto 算法通常指 Goto 和 van de Geijn 在 2008 年提出的高性能矩阵乘法(GEMM)算法。它通过分块(Blocking)、打包(Packing)和多级循环组织,提高矩阵乘法在缓存层次结构上的性能。 对于矩阵乘法
$$ [ C \leftarrow C+AB ] $$
其中 $ (A) 为 (M\times K),(B) 为 (K\times N),(C) 为 (M\times N) $,经典的 Goto GEMM 可以用下面的伪代码表示。
for jc = 0 to N step NC:
    for pc = 0 to K step KC:

        Bc = pack_B(B[pc:pc+KC, jc:jc+NC])

        for ic = 0 to M step MC:

            Ac = pack_A(A[ic:ic+MC, pc:pc+KC])

            for jr = 0 to NC step NR:
                for ir = 0 to MC step MR:

                    micro_kernel(
                        Ac[ir:ir+MR, :],
                        Bc[:, jr:jr+NR],
                        C[ic+ir:ic+ir+MR, jc+jr:jc+jr+NR]
                    )
| 参数 | 含义 | 主要目的 |
|---|---|---|
NC | $(N)$ 方向的大块大小 | 控制 B 的分块,适配缓存 |
KC | $(K)$ 方向的分块大小 | 控制每轮累加的归约长度 |
MC | $(M)$ 方向的大块大小 | 控制 A 的分块 |
NR | 微内核的列块大小 | 寄存器与 SIMD 优化 |
MR | 微内核的行块大小 | 将 C 的小块保存在寄存器中 |
外层循环选择 N-K-M 会导致
B分块在 K 层按列方向访问,但是每个最内层循环是固定的A分块在 M 层按列方向访问C分块在 M 层按列方向访问
但是因为有打包,所以实际上是
B分块在K层时因打包变得连续,总共是 N*K 次打包能够复用A分块在M层时因打包变得连续,但是打包次数是 MKN 次C分块内的访问顺序由微内核决定
for jc:                 // N
    for pc:             // K
        Bc = pack_B(B)

        for ic:         // M
            Ac = pack_A(A)
            compute(Ac, Bc, C)
还有一种镜像版本是 M-K-N 顺序,这样能够复用 A 分块
现在看内层循环
C分块内用寄存器来存储结果,按什么顺序访问差异不大
| 循环 | 主要目的 |
|---|---|
jc (N) | 固定 B 的列块,使该块能够跨多个 A 块重复使用 |
pc (K) | 沿归约维度分块,逐步累加到 C |
ic (M) | 遍历 A 的行块,复用当前 B 块 |
jr (N) | 在微内核中选择当前列子块 |
ir (M) | 在微内核中选择当前行子块 |
lscpu 结果
sodium@ubuntu-lab:~/workspace/arch-lab/lab1/build$ lscpu
Architecture:                x86_64
  CPU op-mode(s):            32-bit, 64-bit
  Address sizes:             48 bits physical, 48 bits virtual
  Byte Order:                Little Endian
CPU(s):                      16
  On-line CPU(s) list:       0-15
Vendor ID:                   AuthenticAMD
  Model name:                AMD Ryzen 7 8845H w/ Radeon 780M Graphics
    CPU family:              25
    Model:                   117
    Thread(s) per core:      2
    Core(s) per socket:      8
    Socket(s):               1
    Stepping:                2
    Frequency boost:         enabled
    CPU(s) scaling MHz:      28%
    CPU max MHz:             6681.4448
    CPU min MHz:             1600.0000
    BogoMIPS:                7585.86
    Flags:                   fpu vme de pse tsc msr pae mce cx8 apic sep mtrr pge mca cmov pat pse36 clflush mmx fxsr sse ss
                             e2 ht syscall nx mmxext fxsr_opt pdpe1gb rdtscp lm constant_tsc rep_good amd_lbr_v2 nopl nonsto
                             p_tsc cpuid extd_apicid aperfmperf rapl pni pclmulqdq monitor ssse3 fma cx16 sse4_1 sse4_2 x2ap
                             ic movbe popcnt aes xsave avx f16c rdrand lahf_lm cmp_legacy svm extapic cr8_legacy abm sse4a m
                             isalignsse 3dnowprefetch osvw ibs skinit wdt tce topoext perfctr_core perfctr_nb bpext perfctr_
                             llc mwaitx cpb cat_l3 cdp_l3 hw_pstate ssbd mba perfmon_v2 ibrs ibpb stibp ibrs_enhanced vmmcal
                             l fsgsbase bmi1 avx2 smep bmi2 erms invpcid cqm rdt_a avx512f avx512dq rdseed adx smap avx512if
                             ma clflushopt clwb avx512cd sha_ni avx512bw avx512vl xsaveopt xsavec xgetbv1 xsaves cqm_llc cqm
                             _occup_llc cqm_mbm_total cqm_mbm_local user_shstk avx512_bf16 clzero irperf xsaveerptr rdpru wb
                             noinvd arat npt lbrv svm_lock nrip_save tsc_scale vmcb_clean flushbyasid decodeassists pausefil
                             ter pfthreshold vgif x2avic v_spec_ctrl vnmi avx512vbmi umip pku ospke avx512_vbmi2 gfni vaes v
                             pclmulqdq avx512_vnni avx512_bitalg avx512_vpopcntdq rdpid overflow_recov succor smca fsrm flus
                             h_l1d ibpb_exit_to_user
Virtualization features:
  Virtualization:            AMD-V
Caches (sum of all):
  L1d:                       256 KiB (8 instances)
  L1i:                       256 KiB (8 instances)
  L2:                        8 MiB (8 instances)
  L3:                        16 MiB (1 instance)
NUMA:
  NUMA node(s):              1
  NUMA node0 CPU(s):         0-15
Vulnerabilities:
  Gather data sampling:      Not affected
  Indirect target selection: Not affected
  Itlb multihit:             Not affected
  L1tf:                      Not affected
  Mds:                       Not affected
  Meltdown:                  Not affected
  Mmio stale data:           Not affected
  Reg file data sampling:    Not affected
  Retbleed:                  Not affected
  Spec rstack overflow:      Mitigation; Safe RET
  Spec store bypass:         Mitigation; Speculative Store Bypass disabled via prctl
  Spectre v1:                Mitigation; usercopy/swapgs barriers and __user pointer sanitization
  Spectre v2:                Mitigation; Enhanced / Automatic IBRS; IBPB conditional; STIBP always-on; PBRSB-eIBRS Not affec
                             ted; BHI Not affected
  Srbds:                     Not affected
  Tsa:                       Mitigation; Clear CPU buffers
  Tsx async abort:           Not affected
  Vmscape:                   Mitigation; IBPB before exit to userspace
sodium@ubuntu-lab:~/workspace/arch-lab/lab1/build$
AVX 指令
AVX 具有16个256位的向量寄存器 YMM0 ~ YMM15。一个 AVX 寄存器能够存储8个32位单精度浮点数(或4个64位双精度浮点数),存储单个数据的字段称为向量寄存器的单元或元素(Element)
实验中出现的寄存器如下
// 以下是计算过程中用到的avx寄存器
#define     mat_c0_0_8           %ymm0
#define     mat_c0_8_16          %ymm1
#define     mat_c0_16_24         %ymm2
#define     mat_c0_24_32         %ymm3
#define     mat_c1_0_8           %ymm4
#define     mat_c1_8_16          %ymm5
#define     mat_c1_16_24         %ymm6
#define     mat_c1_24_32         %ymm7
#define     mat_a0_0_8           %ymm8
#define     mat_a1_0_8           %ymm9
#define     mat_b0_0_8           %ymm10
#define     mat_b0_8_16          %ymm11
#define     mat_b0_16_24         %ymm12
#define     mat_b0_24_32         %ymm13
| 指令 | 说明 | 使用示例 |
|---|---|---|
vbroadcastss, vbroadcastsd, vbroadcastf128 | 从内存加载一个 32位 / 64位 / 128位 的操作数,并将其广播到向量寄存器的每个单元中 | vbroadcastss (%rax), %ymm0,设 d=MEM[%rax],则指令执行后,ymm0 寄存器为: |
vmovups, vmovdqu, vmovapd | 在内存和 AVX 寄存器之间移动 未对齐的单精度 / 未对齐的双精度 / 对齐的双精度 浮点数 | vmovups %ymm0, (%rax),将 ymm0 寄存器中的 8 个 float 浮点数存储到 MEM[%rax] |
vfmadd231ps, vaddps, vsubps, vmulps, vdivps, vsqrtps | 执行 256 位的 乘加 / 加 / 减 / 乘 / 除 / 开平方 运算,指令后缀的 s 表示操作数类型是单精度浮点 | vfmadd231ps %ymm0, %ymm1, %ymm2,计算 ymm2 += ymm0 * ymm1,且对向量寄存器的每个单元,均有 ymm2[i] += ymm0[i] * ymm1[i] |
OpenMP
OpenMP(Open specifications for Multi Processing)是一个支持以共享内存方式实现多线程并行处理的编程库。OpenMP提供嵌入到高级语言的编译指令/原语,从而将串行代码并行化。OpenMP支持不同粒度的并行化。此外,OpenMP简化了线程的使用,不需要开发者自行考虑线程的创建、同步、负载均衡等操作。