Introduction
本文旨在记录作者完成课程任务 Computer Architecture Lab 6 的过程,可供参考。
本实验需要完成的内容主要是优化大模型的矩阵乘法部分,检查加速效果
实验包链接如下
指导书链接如下(需校内网)
环境配置
实验要求使用 x86_64 Linux 并且安装 NVIDIA 显卡的实体机/物理机 完成
实验过程
先下载实验包
curl -OL http://10.249.14.10:3011/lab6/llama2.c.tar.gz
tar -xvzf llama2.c.tar.gz llama2.c
cd llama2.c
curl -OL http://10.249.14.10:3011/lab6/stories110M.bin
curl -OL http://10.249.14.10:3011/lab6/stories15M.bin
curl -OL http://10.249.14.10:3011/lab6/stories42M.bin
基线性能
尝试编译
# llama2.c/
make run
尝试运行
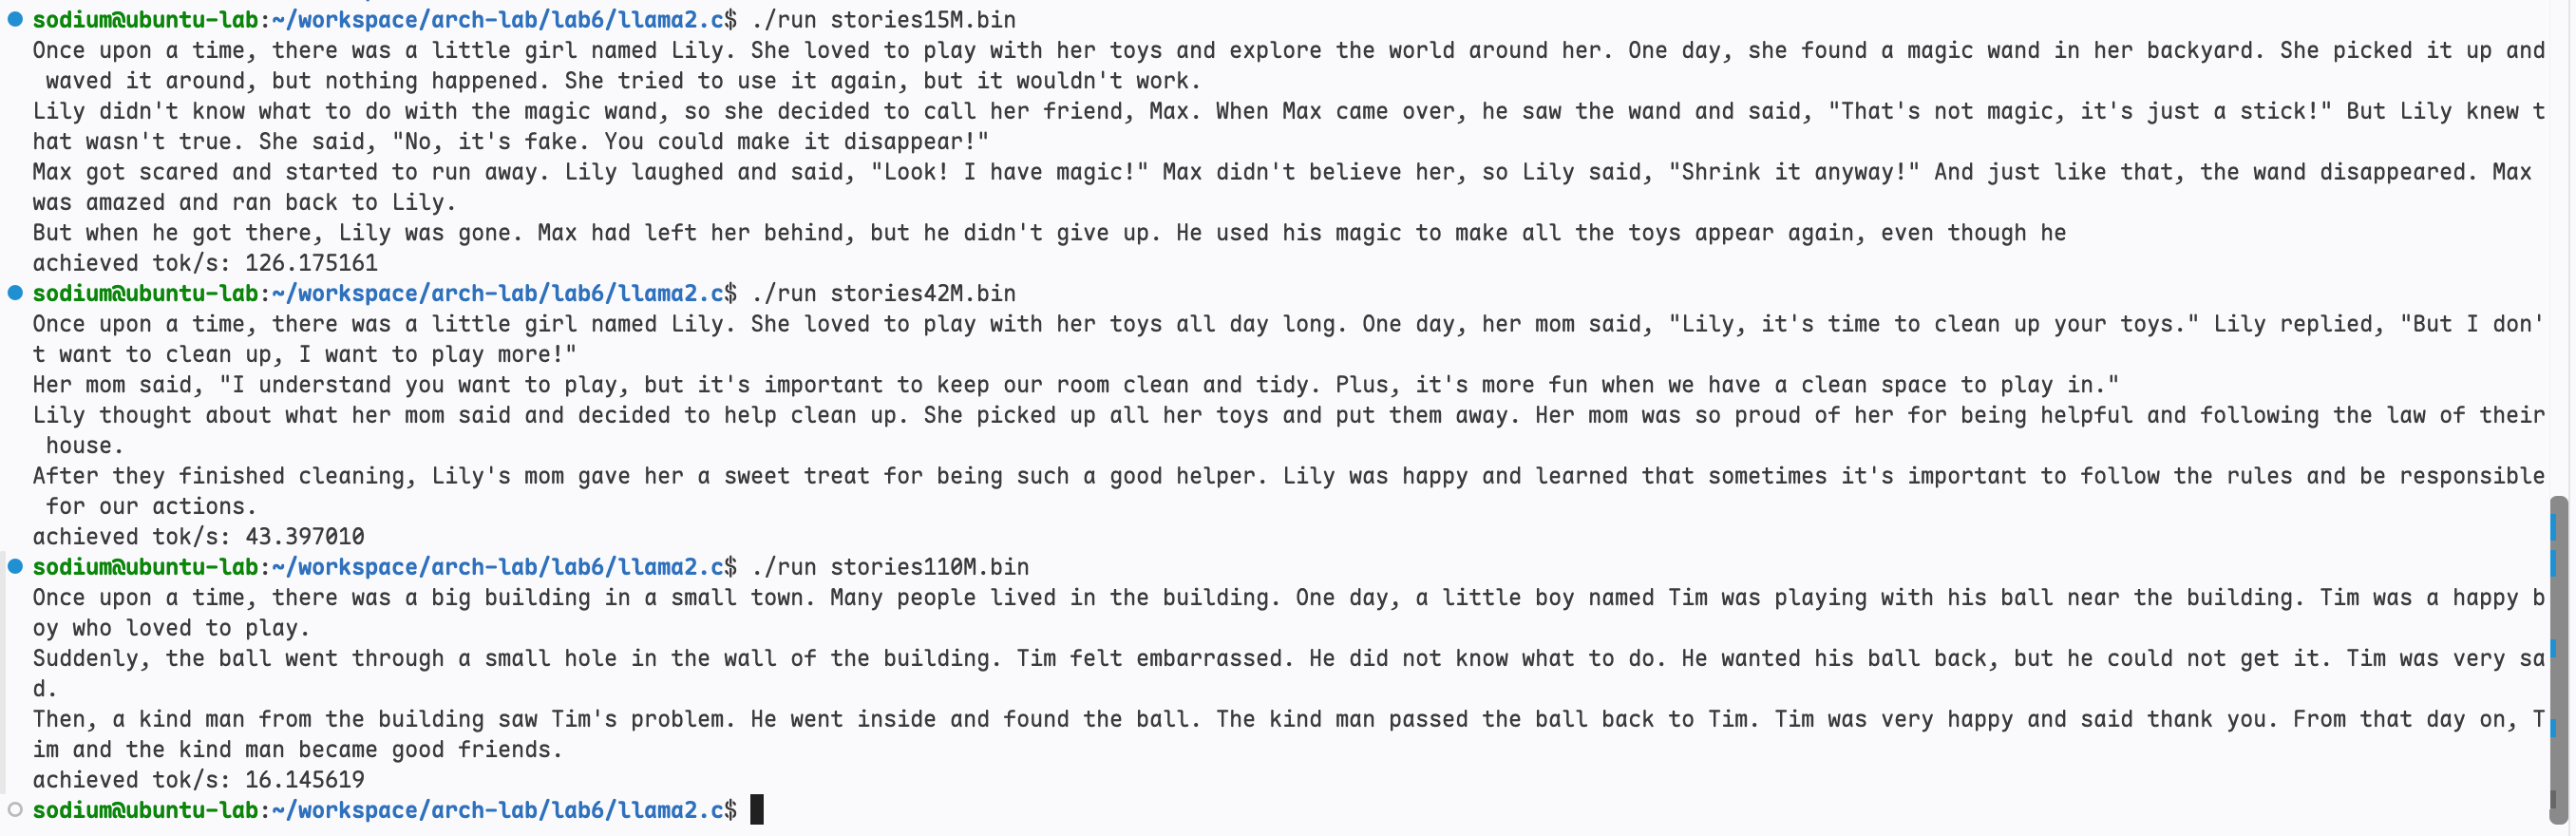
以下是 9 次运行的统计结果,按照模型规模分组:
| 序号 | 模型 | 生成速度(tok/s) |
|---|---|---|
| 1 | stories15M | 126.175 |
| 2 | stories42M | 43.397 |
| 3 | stories110M | 16.146 |
| 4 | stories15M | 127.148 |
| 5 | stories42M | 42.884 |
| 6 | stories110M | 16.086 |
| 7 | stories15M | 128.139 |
| 8 | stories42M | 42.804 |
| 9 | stories110M | 16.108 |
各模型运行统计
| 模型 | 运行次数 | 平均速度(tok/s) | 最高速度 | 最低速度 |
|---|---|---|---|---|
| stories15M | 3 | 127.154 | 128.139 | 126.175 |
| stories42M | 3 | 43.028 | 43.397 | 42.804 |
| stories110M | 3 | 16.113 | 16.146 | 16.086 |
对比
| 模型 | 相对速度 |
|---|---|
| stories15M | 1.00× |
| stories42M | 0.338× |
| stories110M | 0.127× |
数据表明,三种模型的运行速度非常稳定,三次测试的波动都很小。随着模型规模增大,生成速度明显下降。
尝试优化
矩阵乘法函数如下,指导书写到这是性能瓶颈
void matmul(float* xout, float* x, float* w, int n, int d) {
    // W (d,n) @ x (n,) -> xout (d,)
    // by far the most amount of time is spent inside this little function
    int i;
    #pragma omp parallel for private(i)
    for (i = 0; i < d; i++) {
        float val = 0.0f;
        for (int j = 0; j < n; j++) {
            val += w[i * n + j] * x[j];
        }
        xout[i] = val;
    }
}
直接尝试使用 cuBLAS 库,替换原来的代码
void matmul(float* xout, float* x, float* w, int n, int d) {
    cublasHandle_t handle;
    cublasCreate(&handle);

    float *d_x, *d_w, *d_y;

    cudaMalloc((void**)&d_x, n * sizeof(float));
    cudaMalloc((void**)&d_w, d * n * sizeof(float));
    cudaMalloc((void**)&d_y, d * sizeof(float));

    cudaMemcpy(d_x, x, n * sizeof(float),
               cudaMemcpyHostToDevice);

    cudaMemcpy(d_w, w, d * n * sizeof(float),
               cudaMemcpyHostToDevice);

    float alpha = 1.0f;
    float beta = 0.0f;

    cublasSgemv(
        handle,
        CUBLAS_OP_T,
        n, d,
        &alpha,
        d_w, n,
        d_x, 1,
        &beta,
        d_y, 1
    );

    cudaMemcpy(xout, d_y, d * sizeof(float),
               cudaMemcpyDeviceToHost);

    cudaFree(d_x);
    cudaFree(d_w);
    cudaFree(d_y);

    cublasDestroy(handle);
}
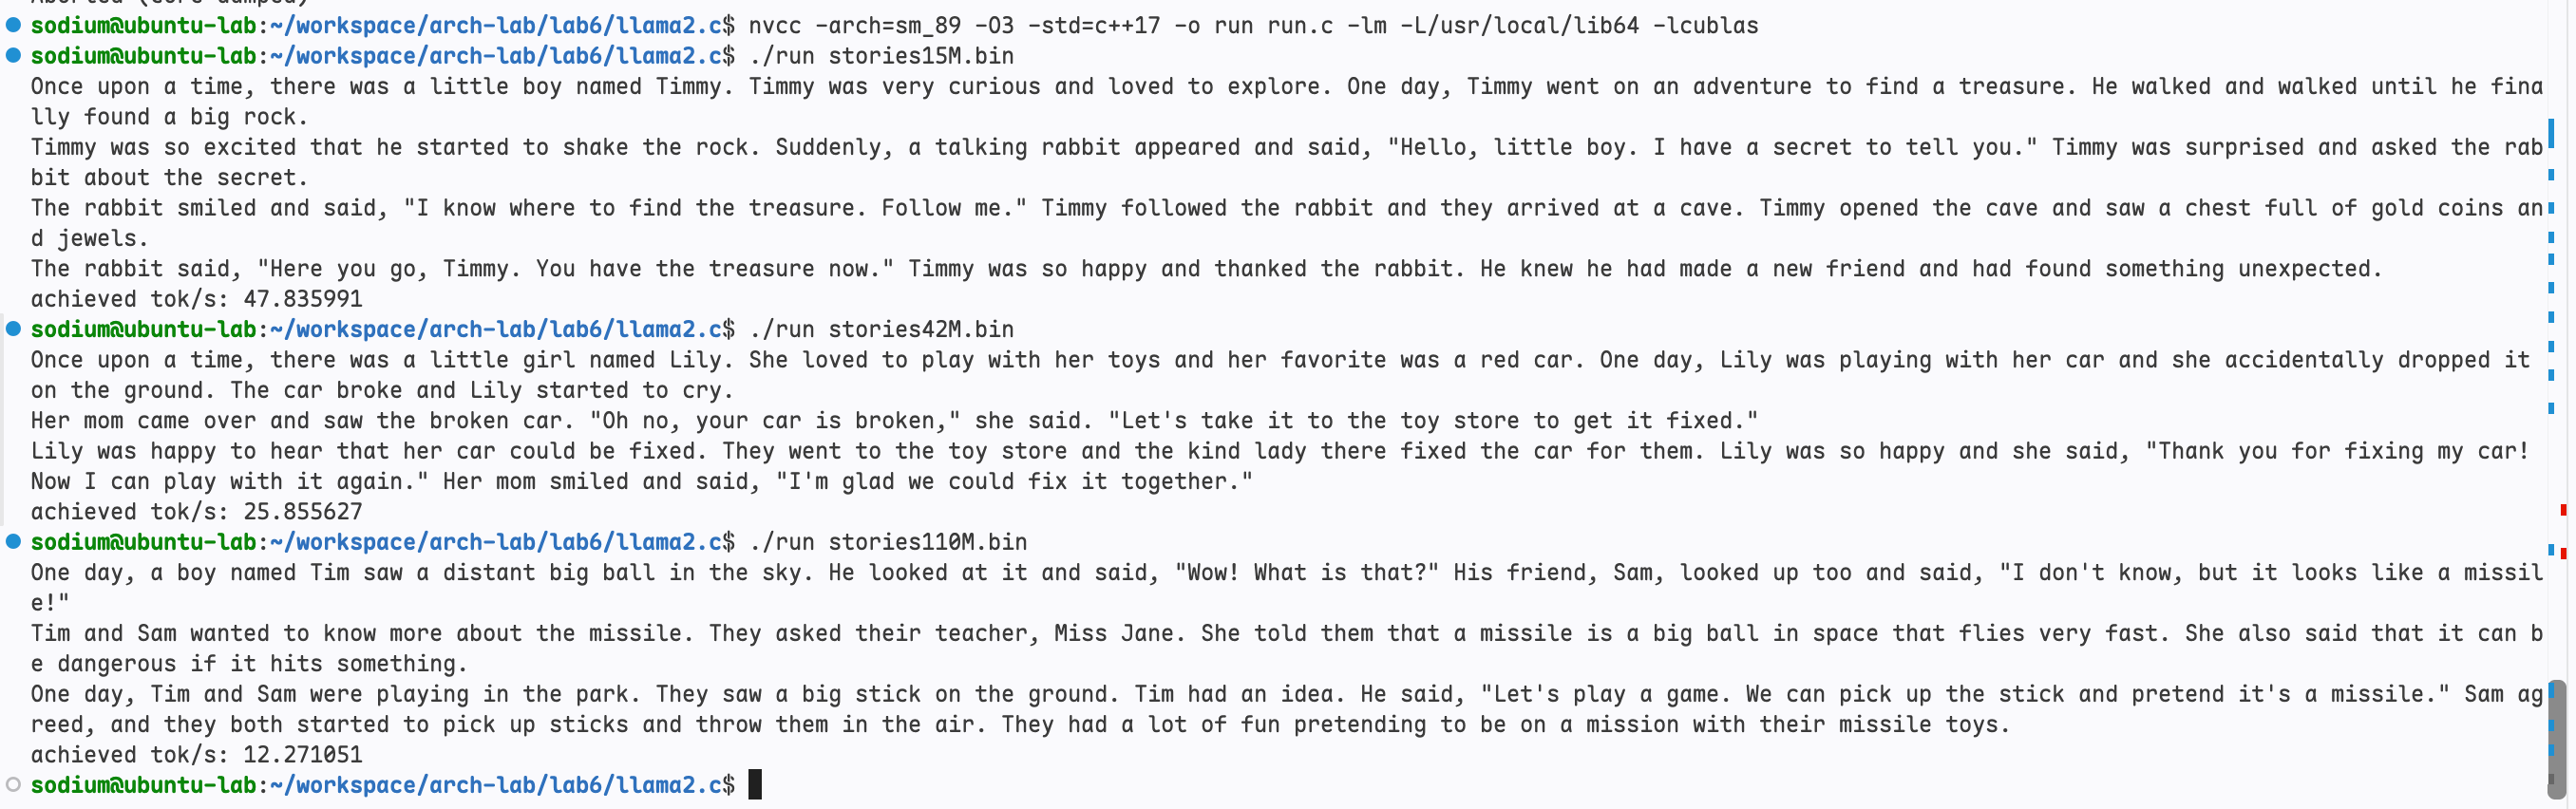
编译输出如图,因为反复地复制内存并且没有并行,效果还不如不优化
检查 matmul 的引用发现只有 forward 调用了它,所以尝试对其进行优化,尝试将权重参数尽量放在显存,下面是原代码
float* forward(Transformer* transformer, int token, int pos) {
    // a few convenience variables
    Config* p = &transformer->config;
    TransformerWeights* w = &transformer->weights;
    RunState* s = &transformer->state;
    float *x = s->x;
    int dim = p->dim;
    int kv_dim = (p->dim * p->n_kv_heads) / p->n_heads;
    int kv_mul = p->n_heads / p->n_kv_heads; // integer multiplier of the kv sharing in multiquery
    int hidden_dim =  p->hidden_dim;
    int head_size = dim / p->n_heads;

    // copy the token embedding into x
    float* content_row = w->token_embedding_table + token * dim;
    memcpy(x, content_row, dim*sizeof(*x));

    // forward all the layers
    for(unsigned long long l = 0; l < p->n_layers; l++) {
        // attention rmsnorm
        rmsnorm(s->xb, x, w->rms_att_weight + l*dim, dim);
        // key and value point to the kv cache
        int loff = l * p->seq_len * kv_dim; // kv cache layer offset for convenience
        s->k = s->key_cache + loff + pos * kv_dim;
        s->v = s->value_cache + loff + pos * kv_dim;
        // qkv matmuls for this position
        matmul(s->q, s->xb, w->wq + l*dim*dim, dim, dim);
        matmul(s->k, s->xb, w->wk + l*dim*kv_dim, dim, kv_dim);
        matmul(s->v, s->xb, w->wv + l*dim*kv_dim, dim, kv_dim);
        // RoPE relative positional encoding: complex-valued rotate q and k in each head
        for (int i = 0; i < dim; i+=2) {
            int head_dim = i % head_size;
            float freq = 1.0f / powf(10000.0f, head_dim / (float)head_size);
            float val = pos * freq;
            float fcr = cosf(val);
            float fci = sinf(val);
            int rotn = i < kv_dim ? 2 : 1; // how many vectors? 2 = q & k, 1 = q only
            for (int v = 0; v < rotn; v++) {
                float* vec = v == 0 ? s->q : s->k; // the vector to rotate (query or key)
                float v0 = vec[i];
                float v1 = vec[i+1];
                vec[i]   = v0 * fcr - v1 * fci;
                vec[i+1] = v0 * fci + v1 * fcr;
            }
        }
        // multihead attention. iterate over all heads
        int h;
        #pragma omp parallel for private(h)
        for (h = 0; h < p->n_heads; h++) {
            // get the query vector for this head
            float* q = s->q + h * head_size;
            // attention scores for this head
            float* att = s->att + h * p->seq_len;
            // iterate over all timesteps, including the current one
            for (int t = 0; t <= pos; t++) {
                // get the key vector for this head and at this timestep
                float* k = s->key_cache + loff + t * kv_dim + (h / kv_mul) * head_size;
                // calculate the attention score as the dot product of q and k
                float score = 0.0f;
                for (int i = 0; i < head_size; i++) {
                    score += q[i] * k[i];
                }
                score /= sqrtf(head_size);
                // save the score to the attention buffer
                att[t] = score;
            }

            // softmax the scores to get attention weights, from 0..pos inclusively
            softmax(att, pos + 1);

            // weighted sum of the values, store back into xb
            float* xb = s->xb + h * head_size;
            memset(xb, 0, head_size * sizeof(float));
            for (int t = 0; t <= pos; t++) {
                // get the value vector for this head and at this timestep
                float* v = s->value_cache + loff + t * kv_dim + (h / kv_mul) * head_size;
                // get the attention weight for this timestep
                float a = att[t];
                // accumulate the weighted value into xb
                for (int i = 0; i < head_size; i++) {
                    xb[i] += a * v[i];
                }
            }
        }
        // final matmul to get the output of the attention
        matmul(s->xb2, s->xb, w->wo + l*dim*dim, dim, dim);
        // residual connection back into x
        for (int i = 0; i < dim; i++) {
            x[i] += s->xb2[i];
        }
        // ffn rmsnorm
        rmsnorm(s->xb, x, w->rms_ffn_weight + l*dim, dim);
        // Now for FFN in PyTorch we have: self.w2(F.silu(self.w1(x)) * self.w3(x))
        // first calculate self.w1(x) and self.w3(x)
        matmul(s->hb, s->xb, w->w1 + l*dim*hidden_dim, dim, hidden_dim);
        matmul(s->hb2, s->xb, w->w3 + l*dim*hidden_dim, dim, hidden_dim);
        // SwiGLU non-linearity
        for (int i = 0; i < hidden_dim; i++) {
            float val = s->hb[i];
            // silu(x)=x*σ(x), where σ(x) is the logistic sigmoid
            val *= (1.0f / (1.0f + expf(-val)));
            // elementwise multiply with w3(x)
            val *= s->hb2[i];
            s->hb[i] = val;
        }
        // final matmul to get the output of the ffn
        matmul(s->xb, s->hb, w->w2 + l*dim*hidden_dim, hidden_dim, dim);
        // residual connection
        for (int i = 0; i < dim; i++) {
            x[i] += s->xb[i];
        }
    }
    // final rmsnorm
    rmsnorm(x, x, w->rms_final_weight, dim);
    // classifier into logits
    matmul(s->logits, x, w->wcls, p->dim, p->vocab_size);
    return s->logits;
}
由于代码比较复杂,后面的修改都交给了 Deepseek V41Flash
重新分析瓶颈
第一版直接用 cuBLAS 替换 matmul,结果反而更慢。原因在于这里的 matmul 是 batch=1 的 GEMV。以 stories110M 为例(dim = 768、hidden_dim = 2048、n_layers = 12、vocab_size = 32000,且 n_kv_heads = n_heads,所以 kv_dim = dim),每生成一个 token 要执行的矩阵向量乘法如下:
| 位置 | 权重形状 (d × n) | 每层次数 | 每 token 次数 |
|---|---|---|---|
| q 投影 | 768 × 768 | 1 | 12 |
| k / v 投影 | 768 × 768 | 2 | 24 |
| attention 输出 | 768 × 768 | 1 | 12 |
| FFN w1 / w3 | 2048 × 768 | 2 | 24 |
| FFN w2 | 768 × 2048 | 1 | 12 |
| classifier | 32000 × 768 | - | 1 |
也就是每生成一个 token 要调用 85 次 matmul、做约 9500 万次乘加(约 1.9 亿 FLOP),但要读的权重却有 438MB。这个算子的性能瓶颈从来不是算力,而是显存(在 CPU 上是内存)带宽。
第一版每调用一次 matmul 就 cudaMalloc 三个显存块、把整个权重矩阵拷到显存、算完再 cudaFree,权重流量被放大成两倍以上的 H2D/D2H,再叠加每次调用的 cublasCreate/cublasDestroy,自然比 CPU 还慢。
正确的做法只有两条:
- 权重只在启动时上传一次,之后常驻显存;
- 一个 token 的整条数据流都留在 GPU 上,每 token 只回传一次 logits。
优化实现
原版和 GPU 版的根本差别在于数据放在哪、循环由谁执行。原版 run.c 里权重就是 mmap 进来的主机内存,激活缓冲是 calloc 出来的主机数组,matmul 直接在这些主机指针上做双重循环,整个 forward 由 CPU 执行;GPU 版把这套数据整体搬到显存,matmul 改调 cuBLAS,其余循环改写成 kernel,每 token 的主机↔设备通信只剩开头的 embedding 行和结尾的 logits。
两者共存于同一份 run.c:gcc 编译时走原版 CPU 路径(一行未改),nvcc 编译时通过 __CUDACC__ 自动启用 GPU 后端,-DUSE_FP16 再切成半精度权重。改动量上,run.c 从 973 行变成 1480 行,新增 526 行、删改 19 行(全是 nvcc 按 C++ 编译所需的强制类型转换),原 CPU 逻辑一行没删。下面每一处都先放原版 CPU 代码,再放对应的 CUDA 实现,方便直接对照。
| 环节 | 原版 CPU 路径 | CUDA 版 |
|---|---|---|
| 权重 | mmap 的主机内存,matmul 每次直接读 | 启动时拷到显存,之后常驻 |
| 激活 | RunState 用 calloc 分配在主机 | CudaModel 的显存副本 |
| matmul | 双重循环 + OpenMP,读主机权重 | gemv:cuBLAS 读常驻显存指针 |
| q/k/v | 3 次 matmul,k/v 直接写进 KV cache | 1 次融合 GEMV,rope_kernel 写 cache |
| RoPE | forward 里的循环,逐次算三角函数 | rope_kernel 查预计算的 cos/sin 表 |
| attention | for h / for t / softmax / 加权和 | attention_kernel:1 head 1 block |
| SwiGLU | forward 里的 hidden_dim 循环 | silu_mul_kernel |
| 残差 | for (i) x[i] += xb2[i] | gemv 的 beta = 1 直接累加 |
| 主机↔设备 | 无(全部在主机内存) | 每 token 1KB D2D + 128KB logits D2H |
切换点就是 forward 的出口,原版实现保留在 #else 分支里:
float* forward(Transformer* transformer, int token, int pos) {
#ifdef USE_CUDA
    return forward_cuda(transformer, token, pos);   // GPU 路径
#else
    ... 原来的 CPU 实现,一行未改 ...
#endif
}
1. matmul:从双重循环到 cuBLAS GEMV
原版 CPU 版(run.c,直接读主机内存里的权重):
void matmul(float* xout, float* x, float* w, int n, int d) {
    // W (d,n) @ x (n,) -> xout (d,)
    // by far the most amount of time is spent inside this little function
    int i;
    #pragma omp parallel for private(i)
    for (i = 0; i < d; i++) {
        float val = 0.0f;
        for (int j = 0; j < n; j++) {
            val += w[i * n + j] * x[j];
        }
        xout[i] = val;
    }
}
第一版直接把循环换成 cuBLAS,但每次调用都 malloc/copy/free(见上一节),反而更慢。真正有效的改法是把权重变成显存里常驻的指针,再调 cublasSgemv。注意 cuBLAS 是列主序,行主序的 (d,n) 权重会被看成 W 的转置,所以带 CUBLAS_OP_T 调用时参数是:m = 输入维度、n = 输出维度、lda = m。最后一个 beta 用来合并残差(0 覆盖写,1 累加),正好对应原版里 x[i] += xb2[i] 的循环。fp16 版本没有对应的 hgemv 接口,改用 cublasGemmEx 表示 GEMV(n=1),A/B 为 half、C 为 float、CUBLAS_COMPUTE_32F 保证 fp32 累加。
CUDA 版(gemv,所有 matmul 调用的统一入口,指针换成显存指针):
static void gemv(float* y, const float* x, const wt_t* W, int m, int n, float beta) {
    const float alpha = 1.0f;
#ifdef USE_FP16
    f2h_kernel<<<grid_for(m, 256), 256>>>(x, cm.hx, m);       // 输入转 half
    CUBLAS_CHECK(cublasGemmEx(cm.handle, CUBLAS_OP_T, CUBLAS_OP_N, n, 1, m, &alpha,
                              W, CUDA_R_16F, m, cm.hx, CUDA_R_16F, m, &beta,
                              y, CUDA_R_32F, n, CUBLAS_COMPUTE_32F, CUBLAS_GEMM_DEFAULT));
#else
    CUBLAS_CHECK(cublasSgemv(cm.handle, CUBLAS_OP_T, m, n, &alpha, W, m, x, 1, &beta, y, 1));
#endif
}
于是程序里所有 matmul 调用点都换成了这个 gemv。
2. 数据布局:从 mmap/calloc 到 CudaModel
原版 CPU 版:权重的指针直接指向 mmap 进来的 checkpoint,激活缓冲在 malloc_run_state 里用 calloc 分配在主机:
// 权重:memory_map_weights() 把指针指到 mmap 的内存上
float* token_embedding_table;   // (vocab_size, dim)
float* wq;                      // (layer, dim, n_heads*head_size)
float* wk;                      // (layer, dim, n_kv_heads*head_size)
float* w1;                      // (layer, hidden_dim, dim)
// ...

// 激活:malloc_run_state() 里 calloc 在主机内存
s->x    = calloc(p->dim, sizeof(float));
s->xb   = calloc(p->dim, sizeof(float));
s->hb   = calloc(p->hidden_dim, sizeof(float));
s->q    = calloc(p->dim, sizeof(float));
s->key_cache   = calloc(p->n_layers * p->seq_len * kv_dim, sizeof(float));
s->value_cache = calloc(p->n_layers * p->seq_len * kv_dim, sizeof(float));
s->logits = calloc(p->vocab_size, sizeof(float));
CUDA 版:新增一个全局的 CudaModel cm,把这些数据在显存里再存一份;权重类型 wt_t 在 fp16 版本是 __half,而 token_embedding_table 保持 fp32(每 token 只读一行):
typedef struct {
    cublasHandle_t handle;
    float* token_embedding_table;   // (vocab_size, dim),每 token 只读一行
    wt_t*  wcls;                    // (vocab_size, dim)
    float *rms_att_weight, *rms_ffn_weight, *rms_final_weight;
    wt_t*  wqkv;                    // (layer, dim+2*kv_dim, dim)  wq|wk|wv
    wt_t*  w13;                     // (layer, 2*hidden_dim, dim)  w1|w3
    wt_t*  w2;                      // (layer, dim, hidden_dim)
    wt_t*  wo;                      // (layer, dim, dim)
    float *x, *xb, *hb13, *qkv, *logits;   // 激活
    float *key_cache, *value_cache;        // KV cache
    float2* freq_cis;               // 预计算的 RoPE cos/sin 表
#ifdef USE_FP16
    __half* hx;                     // GEMV 输入转半精度的中转缓冲
#endif
} CudaModel;
cuda_upload_weights 只在 build_transformer 里执行一次(对应原版的 read_checkpoint / memory_map_weights):把每层 wq、wk、wv 拼成 (dim+2·kv_dim, dim),把 w1、w3 拼成 (2·hidden_dim, dim);tied embedding 时分类器直接复用 embedding 表(fp16 版本复制一份半精度副本);RoPE 的 cos/sin 表也在这时算好上传。cuda_alloc_state 对应原版的 malloc_run_state,在显存里分配激活和 KV cache。cuda_init 创建全局唯一的 cuBLAS 句柄并调用这两个函数(第一版每次 matmul 都 cublasCreate/cublasDestroy,这也是它慢的原因之一),cuda_free 按逆序释放并对 tied 指针判重:
void cuda_init(Transformer* t) {
    CUBLAS_CHECK(cublasCreate(&cm.handle));  // 句柄只创建一次
    cuda_upload_weights(t);                  // 权重一次性上传 + 融合
    cuda_alloc_state(t);                     // 激活缓冲 + KV cache
}
3. 逐层计算:原版的循环 → 4 个 kernel
原版这几部分都是 forward 里的普通 C 循环,GPU 版则各自是一个独立 kernel。下面逐个对照:CPU 一侧注明这段代码位于 forward() 的哪个部分,GPU 一侧给出完整的 kernel 定义(函数原型 + 函数体)以及它在 forward_cuda() 里的调用方式和启动参数。
rmsnorm
原版 CPU 版(两趟串行循环):
void rmsnorm(float* o, float* x, float* weight, int size) {
    // calculate sum of squares
    float ss = 0.0f;
    for (int j = 0; j < size; j++) {
        ss += x[j] * x[j];
    }
    ss /= size;
    ss += 1e-5f;
    ss = 1.0f / sqrtf(ss);
    // normalize and scale
    for (int j = 0; j < size; j++) {
        o[j] = weight[j] * (ss * x[j]);
    }
}
CUDA 版(一个 block、256 线程,平方和用块内规约代替串行累加):
__global__ void rmsnorm_kernel(float* o, const float* x, const float* w, int size) {
    __shared__ float sh[32];
    float ss = 0.0f;
    for (int i = threadIdx.x; i < size; i += blockDim.x) ss += x[i] * x[i];
    ss = block_reduce_sum(ss, sh);
    const float scale = 1.0f / sqrtf(ss / (float)size + 1e-5f);
    for (int i = threadIdx.x; i < size; i += blockDim.x) o[i] = w[i] * (scale * x[i]);
}

// 调用处(forward_cuda 内每层):一个 block、256 线程
rmsnorm_kernel<<<1, 256>>>(cm.xb, cm.x, cm.rms_att_weight + l*dim, dim);
缩放因子同样用 1.0f / sqrtf(...),写出表达式也和原版一致,这样结果才能和原版对得上;o 和 x 允许是同一块显存(最后的 rmsnorm 就是原地做的)。块内规约本身由 warp_reduce_sum(shuffle 树形归约)和 block_reduce_sum(各 warp 结果写共享内存、第一个 warp 再归约一次)组成,末尾多一次 __syncthreads(),保证所有线程读完结果后共享内存才能被下一次调用复用。
RoPE
原版 CPU 版(i 步长 2 的循环,每个位置都重新算 powf/cosf/sinf,q、k 原地旋转):
// 原版代码:这段位于 float* forward(Transformer*, int, int) 的逐层循环内
// RoPE relative positional encoding: complex-valued rotate q and k in each head
for (int i = 0; i < dim; i+=2) {
    int head_dim = i % head_size;
    float freq = 1.0f / powf(10000.0f, head_dim / (float)head_size);
    float val = pos * freq;
    float fcr = cosf(val);
    float fci = sinf(val);
    int rotn = i < kv_dim ? 2 : 1; // how many vectors? 2 = q & k, 1 = q only
    for (int v = 0; v < rotn; v++) {
        float* vec = v == 0 ? s->q : s->k; // the vector to rotate (query or key)
        float v0 = vec[i];
        float v1 = vec[i+1];
        vec[i]   = v0 * fcr - v1 * fci;
        vec[i+1] = v0 * fci + v1 * fcr;
    }
}
CUDA 版(cos/sin 表启动时算好;一个线程一对元素,旋转后的 k 直接写进 KV cache、v 原样拷入):
__global__ void rope_kernel(float* q, float* k, const float* v, float* kcache,
                            float* vcache, const float2* cis, int dim, int kv_dim,
                            int half_head, int pos) {
    const int hi = blockIdx.x * blockDim.x + threadIdx.x; // 第 hi 对 (i, i+1)
    const int i = hi * 2;
    if (i >= dim) return;
    const float2 c = cis[(size_t)pos * half_head + (hi % half_head)];
    {   // q 总是旋转
        const float q0 = q[i], q1 = q[i + 1];
        q[i] = q0 * c.x - q1 * c.y;
        q[i + 1] = q0 * c.y + q1 * c.x;
    }
    if (i < kv_dim) { // k 旋转后写 cache,v 原样存入
        const float k0 = k[i], k1 = k[i + 1];
        kcache[i] = k0 * c.x - k1 * c.y;
        kcache[i + 1] = k0 * c.y + k1 * c.x;
        vcache[i] = v[i];
        vcache[i + 1] = v[i + 1];
    }
}

// 调用处(forward_cuda 内每层):共 dim/2 个线程,每个线程处理一对相邻元素
rope_kernel<<<grid_for(dim / 2, 128), 128>>>(
    cm.qkv, cm.qkv + dim, cm.qkv + dim + kv_dim,
    cm.key_cache + loff + (size_t)pos * kv_dim,
    cm.value_cache + loff + (size_t)pos * kv_dim,
    cm.freq_cis, dim, kv_dim, half_head, pos);
原版里 s->k 本身就指向 KV cache,所以旋转结果直接落在 cache 里;GPU 版的 qkv 是一次 GEMV 的连续输出,因此改成在 rope_kernel 里显式写回 cache,效果与原版一致。
attention
原版 CPU 版(for h 三重循环,整个跑在 CPU 上):
// 原版代码:这段位于 float* forward(Transformer*, int, int) 的逐层循环内
int h;
#pragma omp parallel for private(h)
for (h = 0; h < p->n_heads; h++) {
    float* q = s->q + h * head_size;
    float* att = s->att + h * p->seq_len;
    for (int t = 0; t <= pos; t++) {
        float* k = s->key_cache + loff + t * kv_dim + (h / kv_mul) * head_size;
        float score = 0.0f;
        for (int i = 0; i < head_size; i++) {
            score += q[i] * k[i];
        }
        score /= sqrtf(head_size);
        att[t] = score;
    }
    softmax(att, pos + 1);
    float* xb = s->xb + h * head_size;
    memset(xb, 0, head_size * sizeof(float));
    for (int t = 0; t <= pos; t++) {
        float* v = s->value_cache + loff + t * kv_dim + (h / kv_mul) * head_size;
        float a = att[t];
        for (int i = 0; i < head_size; i++) {
            xb[i] += a * v[i];
        }
    }
}
CUDA 版(每个 head 一个 block,score/softmax/加权和融合进一个 kernel):
__global__ void attention_kernel(const float* qkv, const float* key_cache,
                                 const float* value_cache, float* xb, int pos,
                                 int head_size, int kv_dim, int kv_mul,
                                 size_t loff, float scale) {
    extern __shared__ float satt[]; // 当前 head 的注意力权重(pos+1 个)
    __shared__ float sh[32];
    const int h = blockIdx.x;       // 每个 head 一个 block
    const float* q = qkv + h * head_size;
    const int kvh = h / kv_mul;     // GQA/MQA:多个 q head 共享 kv
    const float* kbase = key_cache + loff + (size_t)kvh * head_size;
    const float* vbase = value_cache + loff + (size_t)kvh * head_size;

    // 1) score:一个线程一个 timestep,串行点积(与 CPU 累加顺序相同)
    for (int t = threadIdx.x; t <= pos; t += blockDim.x) {
        const float* k = kbase + (size_t)t * kv_dim;
        float s = 0.0f;
        for (int i = 0; i < head_size; i++) s += q[i] * k[i];
        satt[t] = s * scale;
    }
    __syncthreads();

    // 2) softmax:块内 max → expf → 块内 sum → 归一化
    float mx = -3.402823466e+38f;
    for (int t = threadIdx.x; t <= pos; t += blockDim.x) mx = fmaxf(mx, satt[t]);
    mx = block_reduce_max(mx, sh);
    float sum = 0.0f;
    for (int t = threadIdx.x; t <= pos; t += blockDim.x) {
        satt[t] = expf(satt[t] - mx);
        sum += satt[t];
    }
    sum = block_reduce_sum(sum, sh);
    const float inv = 1.0f / sum;
    for (int t = threadIdx.x; t <= pos; t += blockDim.x) satt[t] *= inv;
    __syncthreads();

    // 3) 加权和:线程并行于 head_size,t 串行累加(同样与 CPU 顺序一致)
    for (int i = threadIdx.x; i < head_size; i += blockDim.x) {
        float acc = 0.0f;
        for (int t = 0; t <= pos; t++) acc += satt[t] * vbase[(size_t)t * kv_dim + i];
        xb[h * head_size + i] = acc;
    }
}

// 调用处(forward_cuda 内每层):每 head 一个 block,动态共享内存放 seq_len 个权重
attention_kernel<<<p->n_heads, 128, (size_t)p->seq_len * sizeof(float)>>>(
    cm.qkv, cm.key_cache, cm.value_cache, cm.xb, pos, head_size, kv_dim,
    kv_mul, loff, 1.0f / sqrtf((float)head_size));
score 阶段一个线程负责一个 timestep 并串行点积(累加顺序与原版相同,这是 GPU 输出能和 CPU 逐字节一致的关键);softmax 用块规约求 max/sum,指数用 expf 而不是近似版 __expf;加权求和阶段线程并行于 head_size,对 t 的累加仍然串行。
SwiGLU
原版 CPU 版(hidden_dim 的循环):
// 原版代码:这段位于 float* forward(Transformer*, int, int) 的逐层循环内
// SwiGLU non-linearity
for (int i = 0; i < hidden_dim; i++) {
    float val = s->hb[i];
    // silu(x)=x*σ(x), where σ(x) is the logistic sigmoid
    val *= (1.0f / (1.0f + expf(-val)));
    // elementwise multiply with w3(x)
    val *= s->hb2[i];
    s->hb[i] = val;
}
CUDA 版(w1/w3 的输出拼在 hb13 里,a 的前半是 w1(x)、后半是 w3(x)):
__global__ void silu_mul_kernel(float* a, const float* b, int n) {
    const int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < n) a[i] = (a[i] / (1.0f + expf(-a[i]))) * b[i];
}

// 调用处(forward_cuda 内每层):每个元素一个线程
silu_mul_kernel<<<grid_for(hidden_dim, 128), 128>>>(cm.hb13, cm.hb13 + hidden_dim,
                                                   hidden_dim);
4. 合并权重,减少 GEMV 次数
原版 CPU 版(每层 7 次 matmul,7 次都要读一遍 xb):
// 原版代码:这段位于 float* forward(Transformer*, int, int) 的逐层循环内
matmul(s->q, s->xb, w->wq + l*dim*dim, dim, dim);
matmul(s->k, s->xb, w->wk + l*dim*kv_dim, dim, kv_dim);
matmul(s->v, s->xb, w->wv + l*dim*kv_dim, dim, kv_dim);
// ...
matmul(s->hb,  s->xb, w->w1 + l*dim*hidden_dim, dim, hidden_dim);
matmul(s->hb2, s->xb, w->w3 + l*dim*hidden_dim, dim, hidden_dim);
CUDA 版(把共享输入的权重在启动时拼好,每层只剩 4 次 GEMV,xb 少读一遍):
// 以下调用位于 float* forward_cuda(Transformer*, int, int) 的逐层循环内
// qkv = (wq|wk|wv) @ xb,一次 GEMV 出三个投影
gemv(cm.qkv, cm.xb, cm.wqkv + (size_t)l * rows_qkv * dim, dim, rows_qkv, 0.0f);
// hb13 = (w1|w3) @ xb,一次 GEMV 出两个 FFN 投影
gemv(cm.hb13, cm.xb, cm.w13 + (size_t)l * 2 * hidden_dim * dim, dim, 2 * hidden_dim, 0.0f);
拼接后的布局在输出端正好对应:qkv 缓冲前 dim 个是 q、接着 kv_dim 个是 k、最后 kv_dim 个是 v,一次 GEMV 之后可以直接把 q/k/v 作为指针传给 RoPE 和 attention;w1|w3 的输出也正好是"前一半 w1、后一半 w3",SwiGLU 只需读 a[i] 与 a[i+hidden_dim]。
5. 顺手省掉两个 kernel
原版 CPU 版(残差是 for 循环;RoPE 之后不需要额外拷贝,因为 s->k 直接指向 cache):
// 原版其中:这两段位于 float* forward(Transformer*, int, int) 的逐层循环内
// attention 之后
for (int i = 0; i < dim; i++) x[i] += s->xb2[i];
// ffn 之后
for (int i = 0; i < dim; i++) x[i] += s->xb[i];
CUDA 版(残差交给 cublasSgemv 的 beta = 1 直接累加;k/v 写入 cache 合进 rope_kernel):
// 以下调用位于 float* forward_cuda(Transformer*, int, int) 的逐层循环内
// beta = 1:y = alpha*W*x + 1*y,等价于原版的 x[i] += xb2[i]
gemv(cm.x, cm.xb,  cm.wo + (size_t)l * dim * dim, dim, dim, 1.0f);
gemv(cm.x, cm.hb13, cm.w2 + (size_t)l * hidden_dim * dim, hidden_dim, dim, 1.0f);
// k/v 写入 KV cache 放在 rope_kernel 里,省掉两次 cudaMemcpy
最终每 token 的 GPU 操作只有:12 层 × 9 个 kernel(2 次 rmsnorm、4 次 GEMV、RoPE、attention、SwiGLU)+ 收尾的 rmsnorm、GEMV,共约 110 次 kernel launch;fp16 版每个 GEMV 多一次输入转换,约 159 次。
6. forward_cuda 与原版 forward 的逐句对照
原版 CPU 版(forward 的骨架,RoPE 和 attention 的细节见上):
float* forward(Transformer* transformer, int token, int pos) {
    // ... 取 p / w / s,copy token embedding 到 x ...
    memcpy(x, content_row, dim*sizeof(*x));
    for (unsigned long long l = 0; l < p->n_layers; l++) {
        rmsnorm(s->xb, x, w->rms_att_weight + l*dim, dim);
        int loff = l * p->seq_len * kv_dim;   // kv cache 层偏移
        s->k = s->key_cache + loff + pos * kv_dim;
        s->v = s->value_cache + loff + pos * kv_dim;
        matmul(s->q, s->xb, w->wq + l*dim*dim, dim, dim);
        matmul(s->k, s->xb, w->wk + l*dim*kv_dim, dim, kv_dim);
        matmul(s->v, s->xb, w->wv + l*dim*kv_dim, dim, kv_dim);
        /* RoPE 与 attention:见上一节 */
        matmul(s->xb2, s->xb, w->wo + l*dim*dim, dim, dim);
        for (int i = 0; i < dim; i++) x[i] += s->xb2[i];
        rmsnorm(s->xb, x, w->rms_ffn_weight + l*dim, dim);
        matmul(s->hb,  s->xb, w->w1 + l*dim*hidden_dim, dim, hidden_dim);
        matmul(s->hb2, s->xb, w->w3 + l*dim*hidden_dim, dim, hidden_dim);
        /* SwiGLU:见上一节 */
        matmul(s->xb, s->hb, w->w2 + l*dim*hidden_dim, hidden_dim, dim);
        for (int i = 0; i < dim; i++) x[i] += s->xb[i];
    }
    rmsnorm(x, x, w->rms_final_weight, dim);
    matmul(s->logits, x, w->wcls, p->dim, p->vocab_size);
    return s->logits;
}
CUDA 版(forward_cuda,结构逐句对应):
float* forward_cuda(Transformer* transformer, int token, int pos) {
    // ... 取 p / s,copy token embedding 行到显存 x(D2D)...
    cudaMemcpyAsync(cm.x, cm.token_embedding_table + (size_t)token * dim,
                    (size_t)dim * sizeof(float), cudaMemcpyDeviceToDevice);
    for (int l = 0; l < p->n_layers; l++) {
        rmsnorm_kernel<<<1, 256>>>(cm.xb, cm.x, cm.rms_att_weight + l*dim, dim);
        gemv(cm.qkv, cm.xb, cm.wqkv + (size_t)l*rows_qkv*dim,
             dim, rows_qkv, 0.0f);                    // 一次 GEMV 出 q|k|v
        rope_kernel<<<...>>>(cm.qkv, cm.qkv+dim, cm.qkv+dim+kv_dim, ...);
        attention_kernel<<<p->n_heads, 128, seq_len*4>>>(...);
        gemv(cm.x, cm.xb, cm.wo + (size_t)l*dim*dim,
             dim, dim, 1.0f);                         // beta=1:累加残差
        rmsnorm_kernel<<<1, 256>>>(cm.xb, cm.x, cm.rms_ffn_weight + l*dim, dim);
        gemv(cm.hb13, cm.xb, cm.w13 + (size_t)l*2*hidden_dim*dim,
             dim, 2*hidden_dim, 0.0f);                // 一次 GEMV 出 w1|w3
        silu_mul_kernel<<<grid_for(hidden_dim,128),128>>>(
            cm.hb13, cm.hb13 + hidden_dim, hidden_dim);
        gemv(cm.x, cm.hb13, cm.w2 + (size_t)l*hidden_dim*dim,
             hidden_dim, dim, 1.0f);                  // beta=1:累加残差
    }
    rmsnorm_kernel<<<1, 256>>>(cm.x, cm.x, cm.rms_final_weight, dim);
    gemv(cm.logits, cm.x, cm.wcls, dim, p->vocab_size, 0.0f);
    cudaMemcpy(s->logits, cm.logits, (size_t)p->vocab_size * 4,
               cudaMemcpyDeviceToHost);               // 唯一的回传
    return s->logits;
}
两边的对应关系汇总成一张表:
| 原版 forward(CPU 路径) | CUDA 版 forward_cuda |
|---|---|
| memcpy(x, embedding 行, dim*4) | cudaMemcpyAsync 到显存 x(D2D) |
| matmul(q/k/v, xb, wq/wk/wv) ×3 | gemv(qkv, xb, wqkv + lrows_qkvdim, dim, rows_qkv, 0) |
| RoPE 双重循环(原地改 q/k) | rope_kernel(旋转 + 写 KV cache) |
| for h:点积 / softmax / 加权和 | attention_kernel(每 head 一个 block) |
| matmul(xb2, xb, wo) + x += xb2 | gemv(x, xb, wo + …, dim, dim, 1.0f) |
| matmul(hb, xb, w1) + matmul(hb2, xb, w3) | gemv(hb13, xb, w13 + …, dim, 2*hidden_dim, 0) |
| SwiGLU 循环(hidden_dim) | silu_mul_kernel |
| matmul(xb, hb, w2) + x += xb | gemv(x, hb13, w2 + …, hidden_dim, dim, 1.0f) |
| rmsnorm(x, x, rms_final) + matmul(logits, x, wcls) | rmsnorm_kernel + gemv + D2H 回传 logits |
注意原版里 s->q、s->k、s->v 是指向 KV cache 的指针,matmul 的输出现场就落在 cache 上;GPU 版改成一块 qkv 连续缓冲加显式偏移,所以 RoPE 里要多写一次 cache。
编译
# llama2.c/
make run              # gcc:CPU 基线,和原始代码逐字节一致
make runcublas        # nvcc -x cu:cuBLAS 版(权重常驻显存)
make runcublasfp16    # 同一份 run.c,再加 -DUSE_FP16
./run_cublas stories15M.bin -n 256 -t 0 -s 42 -i "Once upon a time"
实际命令就是 nvcc -x cu -O3 -std=c++17 -arch=native -o run_cublas run.c -lm -lcublas:用 -x cu 让 nvcc 直接编译 run.c,用 -arch=native 针对本机 GPU 生成代码(指导书里的 compute_35 太老,发挥不出新架构)。指导书里 cp run.c run.cu && nvcc ... 的流程也能直接跑通,因为启用 CUDA 后端靠的是 __CUDACC__ 而不是文件后缀。生成/采样逻辑没有改动。
正确性验证
GPU 的浮点求和顺序与 CPU 不完全相同,为了确认不是"快但算错了",另外写了一个对比程序:把同一段 token 序列分别喂给原版 CPU 路径和 GPU 实现,逐位置比较 32000 维 logits。
- 前 256 个位置,logits 的最大绝对误差分别为 4.1e-5(15M)、3.7e-5(42M)、3.4e-5(110M),argmax 全部一致;
- 三个模型在贪心解码(
-t 0 -s 42,256 步)下,生成的文本与 CPU 版本逐字节相同。
性能对比
为了公平,所有版本都在同一台机器上重新测试 5 次(第一版 cuBLAS 3 次),取平均值,单位为 tok/s,测试条件 -n 256 -t 0 -s 42、prompt 为 “Once upon a time”,每组波动都在 1% 以内:
| 模型 | CPU 基线 | 第一版 cuBLAS | 优化后 (cuBLAS) | 加速比 |
|---|---|---|---|---|
| stories15M | 128.52 | 48.32 | 2024.38 | 15.7× |
| stories42M | 43.29 | 25.94 | 1071.43 | 24.8× |
| stories110M | 15.85 | 12.28 | 439.04 | 27.7× |
测试机器:AMD Ryzen 7 8845H + NVIDIA GeForce RTX 4060 Laptop GPU(8GB、128-bit、标称带宽 256 GB/s)。
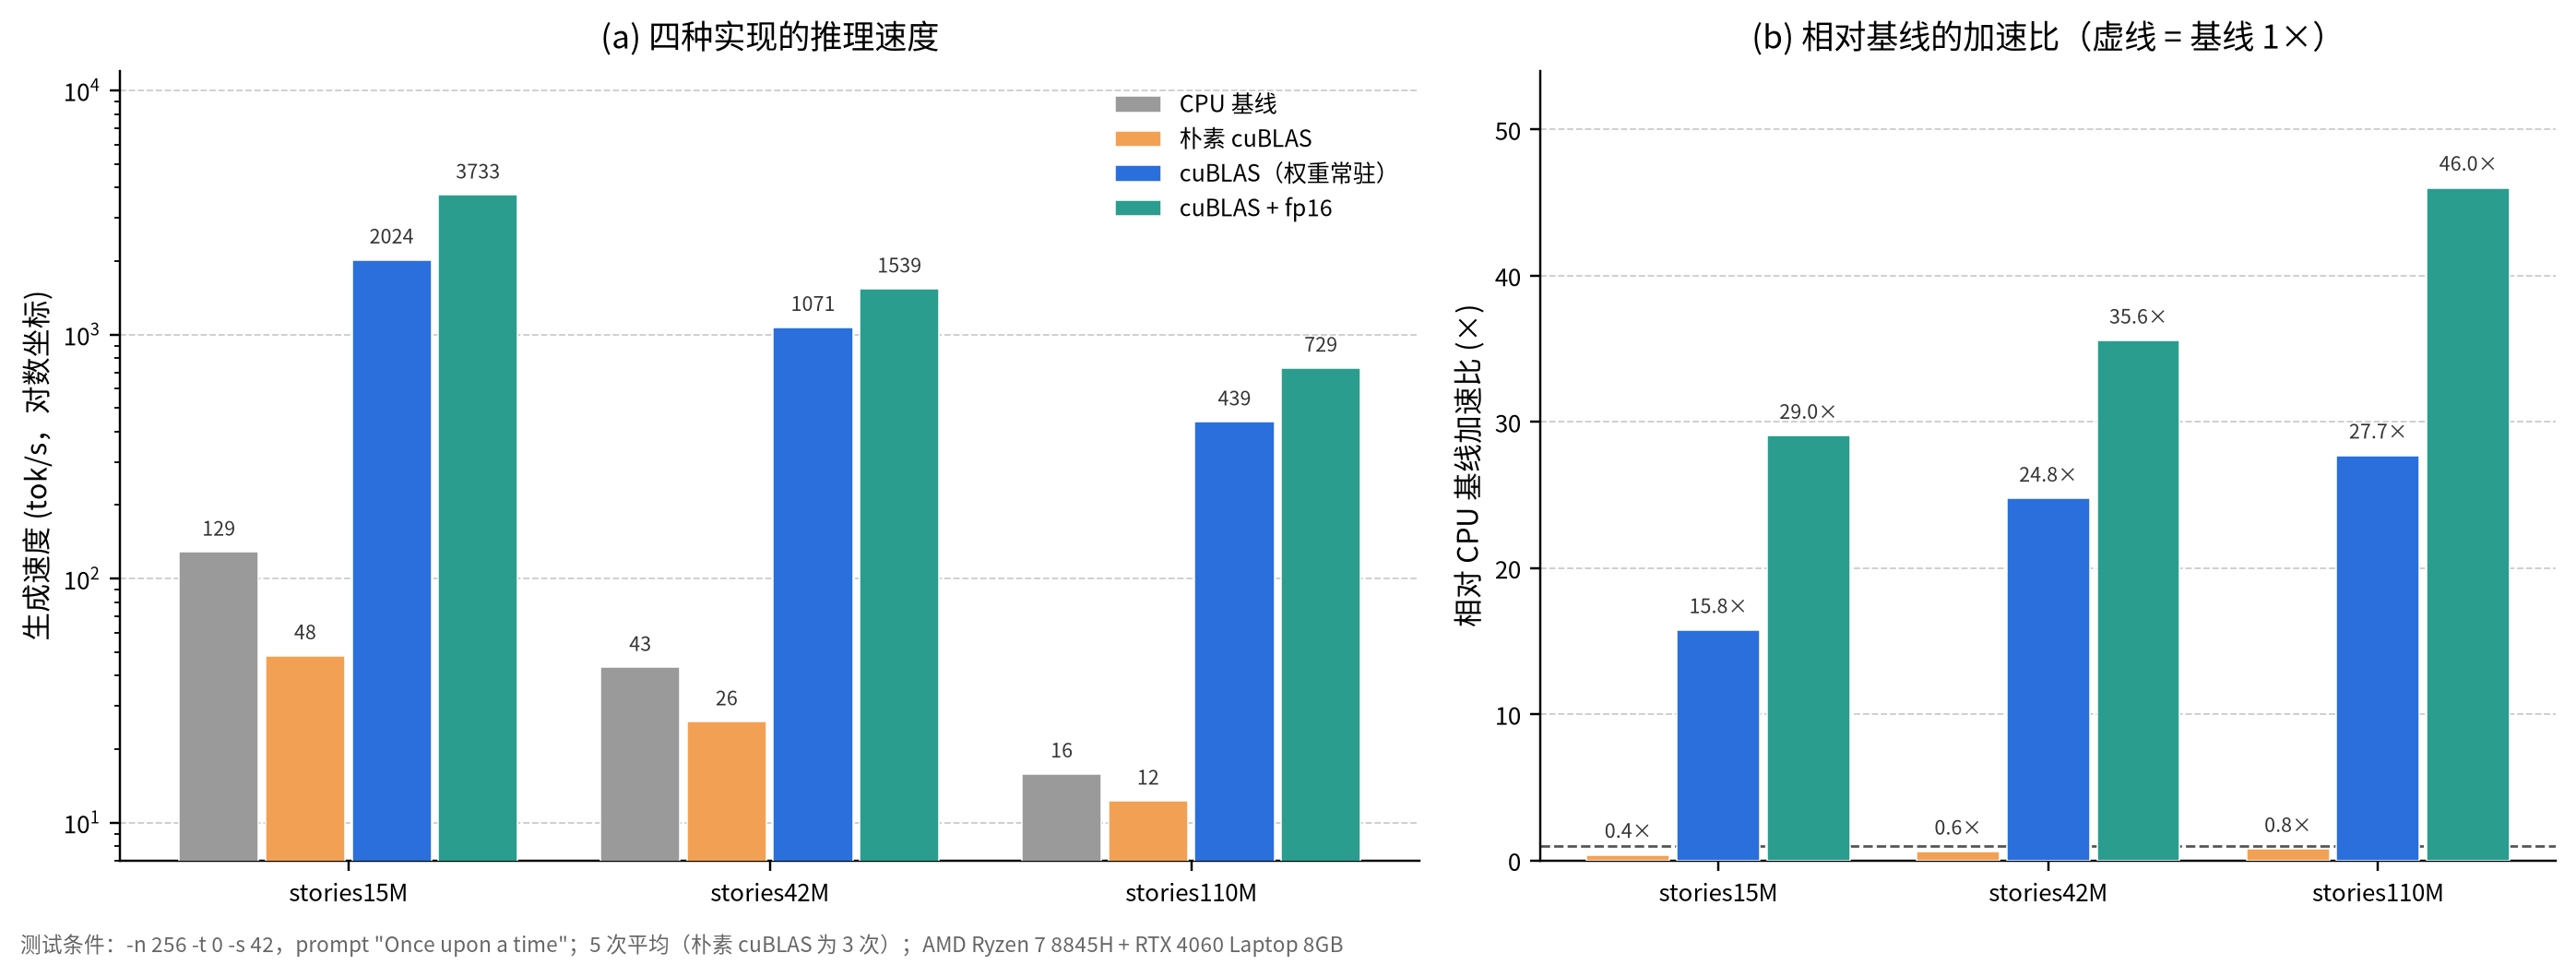
上图中 (a) 是四种实现的生成速度(对数坐标,数值标在柱顶),(b) 是相对 CPU 基线的加速比。可以直观地看到:朴素 cuBLAS 版因为每 token 都要把权重拷进显存,反而比 CPU 还慢(0.40.8×);权重常驻显存之后才真正吃上 GPU 的带宽,速度直接跳两个数量级;半精度再在 fp32 的基础上翻 1.41.8×。
结果分析
把每 token 需要读取的权重和实测时间放在一起看:
| 模型 | 每 token 权重 | 每 token 时间 | 等效带宽 | 相对标称峰值 |
|---|---|---|---|---|
| stories15M | 60.8 MB | 0.494 ms | 123 GB/s | 48% |
| stories42M | 167.2 MB | 0.933 ms | 179 GB/s | 70% |
| stories110M | 438.4 MB | 2.278 ms | 192 GB/s | 75% |
(每 token 权重按模型文件大小算,其中包含共享的 embedding / classifier 权重。)
可以得到几个结论:
- 优化后每 token 时间几乎与参数量成正比,说明 kernel 启动、logits 回传这些固定开销已经很小,程序进入了"以显存带宽为瓶颈"的状态;
- stories110M 达到 192 GB/s,约为标称峰值的 75%。batch=1 的 GEMV 只读不写、每行又很短,实际可用带宽本来就低于拷贝测试的峰值,这个数字已经接近 cuBLAS 在这块卡上的上限,继续在 fp32 下压榨的空间不大;
- 模型越小,固定开销占比越高:stories15M 只有 60.8MB 权重,0.494ms 里还有一部分是 56 个 kernel 的启动和 logits 回传开销,所以等效带宽只有 123 GB/s;
- 模型越大提升越明显(15.7× → 27.7×):CPU 单线程(
make run没有开 OpenMP)算 GEMV 的劣势随矩阵规模放大,而 GPU 端始终贴着带宽跑。
进一步优化:半精度权重
既然瓶颈是显存带宽,最直接的办法就是减少权重的字节数:把权重存成 fp16、用 cublasGemmEx 以 fp32 累加,每 token 的权重流量直接减半。实测还能再快 1.4~1.7×:
| 模型 | fp32 优化版 | fp16 权重 | 相对 fp32 | 相对 CPU 基线 |
|---|---|---|---|---|
| stories15M | 2024.38 | 3733.28 | 1.84× | 29.0× |
| stories42M | 1071.43 | 1539.16 | 1.44× | 35.6× |
| stories110M | 439.04 | 729.36 | 1.66× | 46.0× |
代价是输出不再与 CPU 版本逐字节一致(贪心解码下个别 token 会变化),但生成的文本仍然通顺。半精度只需要 -DUSE_FP16 开关,和 fp32 版共用同一份 run.c(多一个 wt_t 类型和一次 fp32→fp16 的权重转换),make runcublasfp16 即可编译,作为实验对比;主交付仍然是 fp32 版本。
复现
# 基线
make run && ./bench.sh ./run 5
# 优化版
make runcublas && ./bench.sh ./run_cublas 5
# 半精度实验
make runcublasfp16 && ./bench.sh ./run_cublas_fp16 5
bench.sh 就是上面表格用的测试脚本(三个模型各跑若干次,输出平均值/最小/最大)。