Introduction
本文旨在记录作者完成课程任务 HITSZ os-lab5 的过程,可供参考。
本实验需要完成的内容包括
- 实现青春版 EXT2 文件系统
- 附加题
- 附加题一:扩展功能 ——在自己的青春版 EXT2(newfs)上扩展文件读写、删除、移动、硬链接或大文件支持。
- 附加题二:CheckpointFS ——复用你在附加题一中实现的普通文件读写、目录操作、删除与硬链接能力,实现文件版本快照保存(create)与安全回滚(restore)。
- 附加题三:VectorFS ——复用你在附加题一中实现的普通文件读写与目录遍历能力,通过标准 FUSE 回调(getattr/readdir/readlink)将动态计算的相似文档检索结果呈现为虚拟目录与软链接(无需先做 CheckpointFS)。
- 附加题四:在自制 FS 上训练简单模型 ——在完成普通文件读写、持久化与 1MB+ 大文件支持的基础上,直接在自己的文件系统上运行 PyTorch 模型训练脚本(无需先做 CheckpointFS 或 VectorFS)。
实验仓库链接如下
指导书链接如下(需校内网)
git clone https://gitee.com/ftutorials/user-land-filesystem.git
环境搭建与启动/调试工作说明
建立工作目录
user-land-filesystem/
├── driver
│   ├── ddriver.sh
│   ├── kernel_ddriver
│   └── user_ddriver
├── fs
│   ├── demo
│   ├── simplefs
│   └── template
│       ├── src
│       │   ├── PROJECT_NAME.c
│       │   ├── checkpointfs.c
│       │   └── vectorfs.c
│       └── bonus
│           ├── include
│           │   ├── bonus.h
│           │   ├── checkpointfs.h
│           │   └── vectorfs.h
│           ├── src(教师支持源码)
│           ├── tools
│           ├── tests
│           └── README.md
├── LICENSE
├── README.md
└── setenv.sh
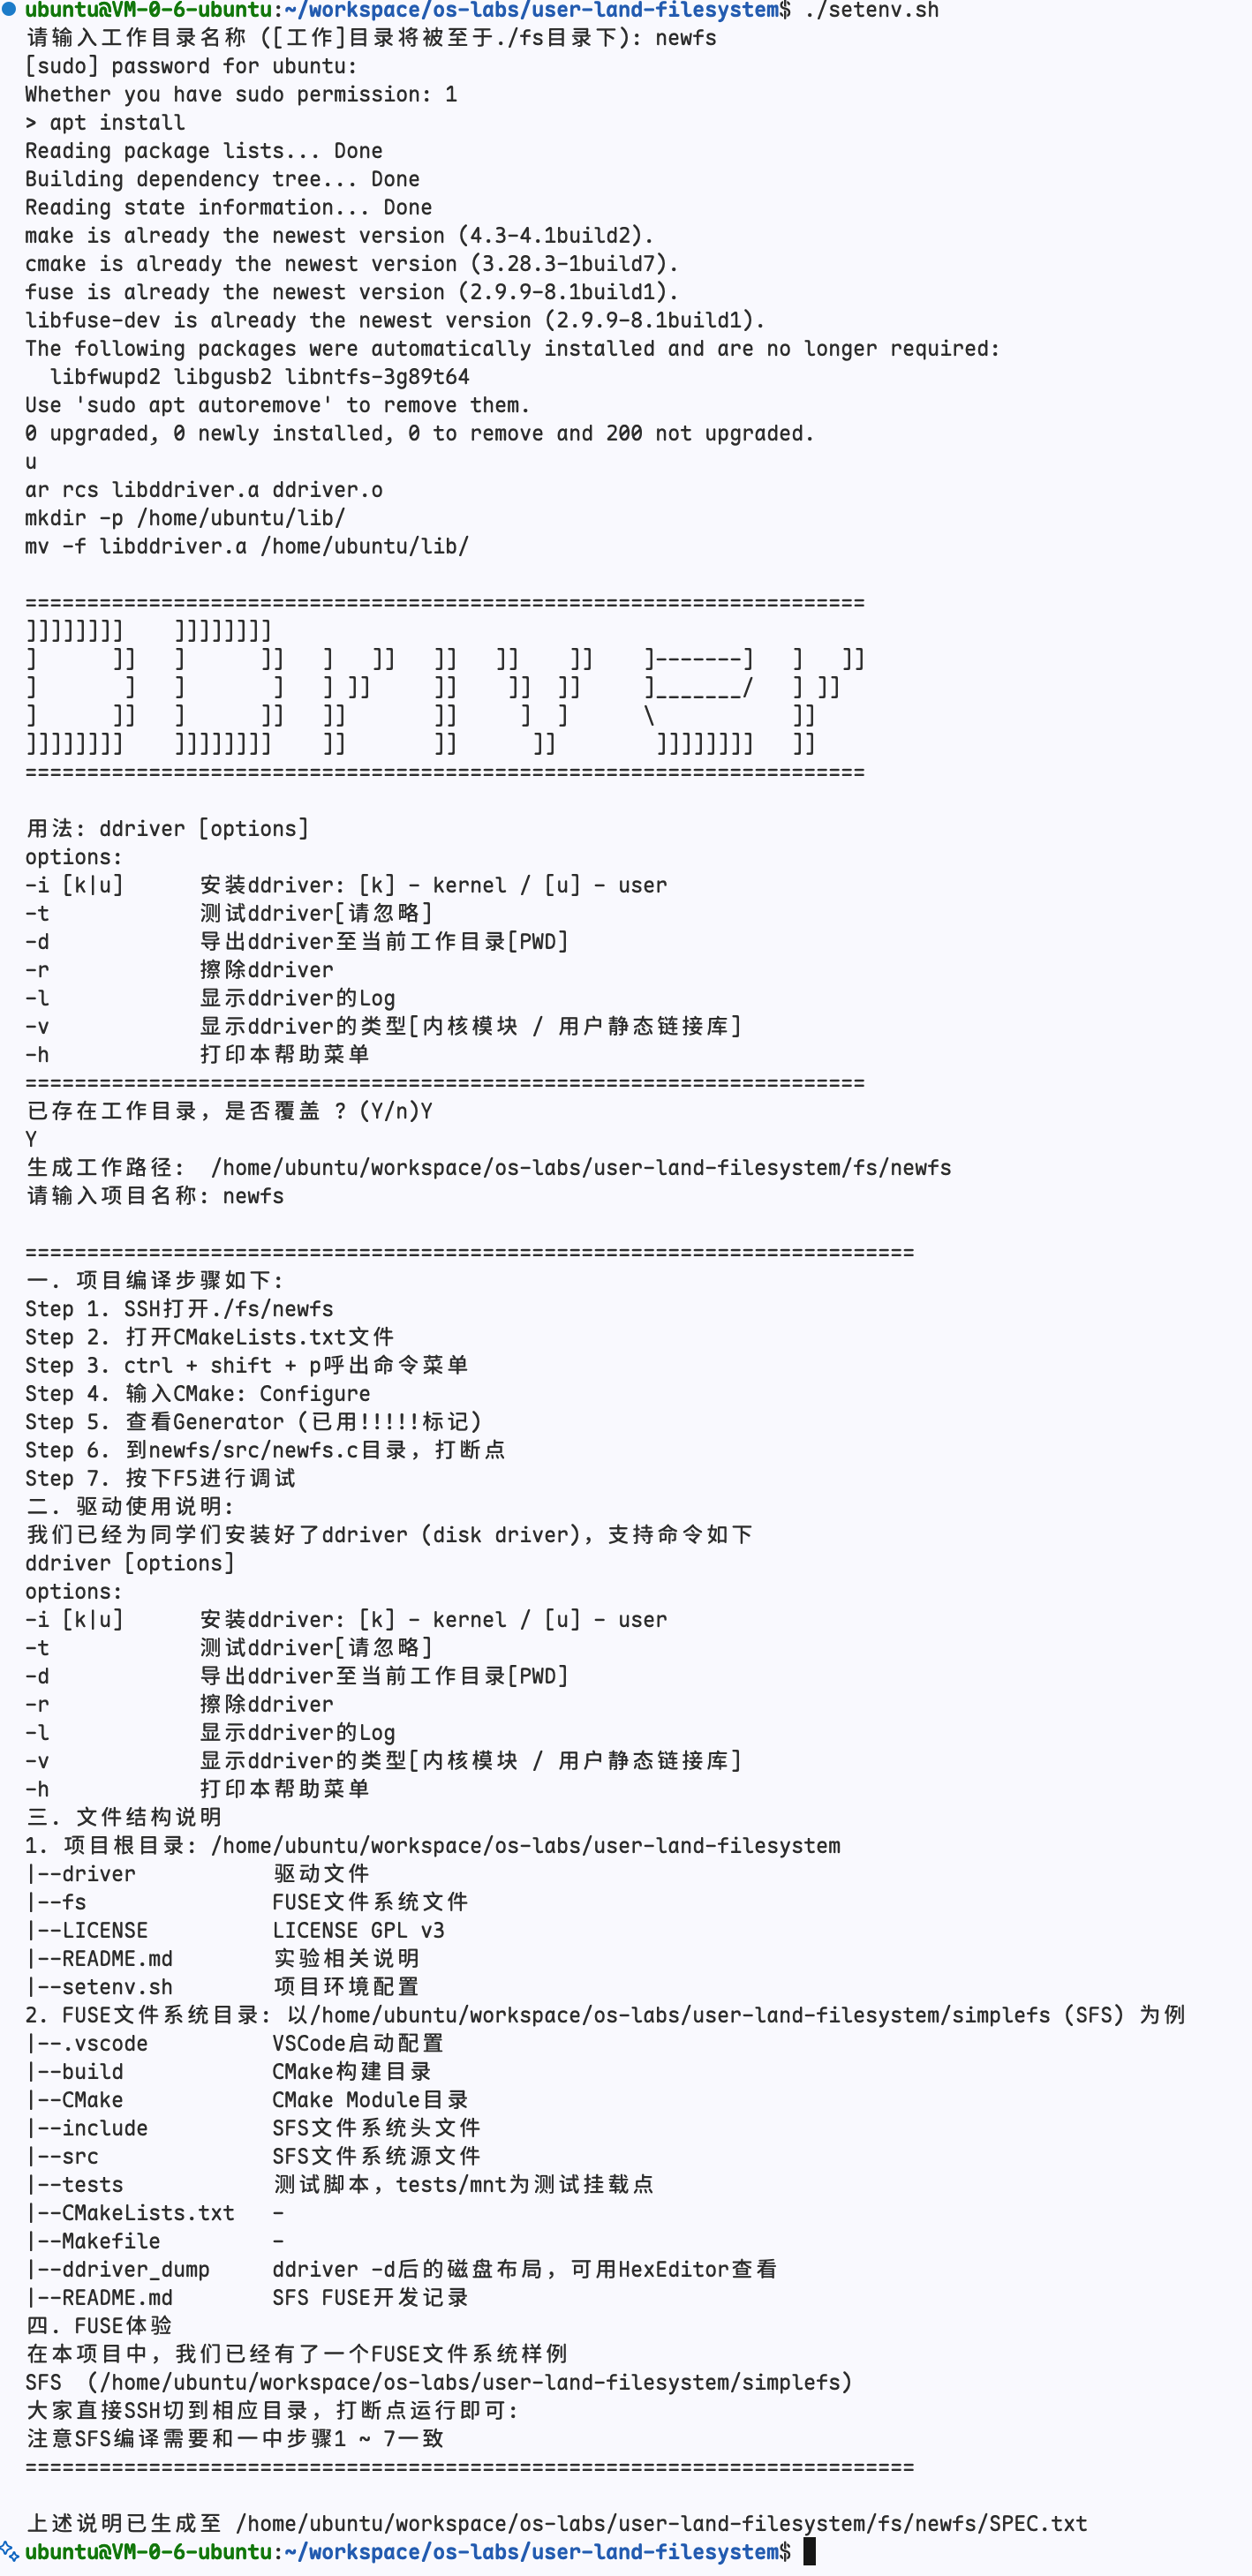
克隆仓库之后,运行 setenv.sh 这样就能生成任务二的工作目录,这里直接叫 newfs
- 做必做任务二与附加题一 :直接编辑
../src/newfs.c和../include/下的头文件即可。 - 选做附加题二(CheckpointFS)或附加题三(VectorFS) :
- 练习源码已经一并生成在
../src/checkpointfs.c和../src/vectorfs.c中(初始返回 -ENOSYS,不影响基础实验编译和运行),教师辅助代码与测试脚本位于../bonus/,CMake 与 FUSE 路由均已预先接好。
- 练习源码已经一并生成在
- 测试命令区分:
- 不带参数的 bash
tests/test.sh用于运行本页后面的基础实验测评; - 当你完成附加题二或三后,可在
..目录下运行bash tests/test.sh checkpoint、bash tests/test.sh vector或bash tests/test.sh all进行附加题自动验收(脚本会自动管理专用临时测试盘,不会擦除你的个人 ddriver 磁盘)
- 不带参数的 bash
确保环境变量生效,执行下面的命令
source ~/.bashrc
进行挂载和卸载
图形化界面的说明指导书已给出,这里整理一下命令行方式
任务一的编译和启动
编译
# fs/demo
mkdir build && cd build
cmake ..
make
./build/demo -f -d -s ./tests/mnt/
任务一
该任务需要补充 demo 工程。需要满足:
- 只需要支持
ls; - 根目录的数据位于逻辑块 500;
- 这个逻辑块里只有一个
dentry,对应文件名<filename>; - 逻辑块大小与任务二保持一致,都是两个 IO 块,也就是 1024B;
- 除了这里用到的块,其他磁盘内容都可以视为无关。
挂载 demo_mount
/* 挂载文件系统 */
static void* demo_mount(struct fuse_conn_info * conn_info){
    // 打开驱动
    char device_path[128] = {0};
    sprintf(device_path, "%s/" DEVICE_NAME, getpwuid(getuid())->pw_dir);
    super.driver_fd = ddriver_open(device_path);

    printf("super.driver_fd: %d\n", super.driver_fd);


    /* 填充super信息 */
    super.sz_io = /* TODO */;
    super.sz_disk = /* TODO */;
    super.sz_blks = /* TODO */;

    return 0;
}
这里直接使用接口 ddriver_ioctl 来获取 super 信息
/**
 * @brief ddriver IO控制
 *
 * @param fd ddriver设备handler
 * @param cmd 命令号,查看ddriver_ctl_user,IOC_开头
 * @param ret 返回值
 * @return int 0成功,否则失败
 */
int ddriver_ioctl(int fd, unsigned long cmd, void *ret);
指导书提到,任务一里,一个逻辑块等于两个 IO 块,这里不要把 512B 当成逻辑块大小直接用。
/* 挂载文件系统 */
static void* demo_mount(struct fuse_conn_info * conn_info){
    // 打开驱动
    char device_path[128] = {0};
    sprintf(device_path, "%s/" DEVICE_NAME, getpwuid(getuid())->pw_dir);
    super.driver_fd = ddriver_open(device_path);

    printf("super.driver_fd: %d\n", super.driver_fd);


    /* 填充super信息 */
    ddriver_ioctl(super.driver_fd, IOC_REQ_DEVICE_IO_SZ, &super.sz_io);
    ddriver_ioctl(super.driver_fd, IOC_REQ_DEVICE_SIZE, &super.sz_disk);
    super.sz_blks = super.sz_io * 2;

    return 0;
}
读目录 demo_readdir
/* 遍历目录 */
static int demo_readdir(const char* path, void* buf, fuse_fill_dir_t filler, off_t offset, struct fuse_file_info* fi)
{
    // 此处任务一同学无需关注demo_readdir的传入参数,也不要使用到上述参数

    char filename[128]; // 待填充的

    /* 根据超级块的信息,从第500逻辑块读取一个dentry,ls将只固定显示这个文件名 */

    /* TODO: 计算磁盘偏移off,并根据磁盘偏移off调用ddriver_seek移动磁盘头到磁盘偏移off处 */

    /* TODO: 调用ddriver_read读出一个磁盘块到内存,512B */

    /* TODO: 使用memcpy拷贝上述512B的前sizeof(demo_dentry)字节构建一个demo_dentry结构 */

    /* TODO: 填充filename */

    // 此处大家先不关注filler,已经帮同学写好,同学填充好filename即可
    return filler(buf, filename, NULL, 0);
}
虚拟磁盘接口模拟了磁头移动和读写的过程,所以读取磁盘需要先使用 ddriver_seek 移到指定位置再使用 ddriver_read 或者 ddriver_write
// user-land-filesystem/../include/ddriver.h
/**
 * @brief 移动ddriver磁盘头
 *
 * @param fd ddriver设备handler
 * @param offset 移动到的位置,注意要和设备IO单位对齐
 * @param whence SEEK_SET即可
 * @return int 0成功,否则失败
 */
int ddriver_seek(int fd, off_t offset, int whence);

/**
 * @brief 写入数据
 *
 * @param fd ddriver设备handler
 * @param buf 要写入的数据Buf
 * @param size 要写入的数据大小,注意一定要等于单次设备IO单位
 * @return int 0成功,否则失败
 */
int ddriver_write(int fd, char *buf, size_t size);
/**
 * @brief 读出数据
 *
 * @param fd ddriver设备handler
 * @param buf 要读出的数据Buf
 * @param size 要读出的数据大小,注意一定要等于单次设备IO单位
 * @return int
 */
int ddriver_read(int fd, char *buf, size_t size);
这里的注释是有问题的,根据函数的定义,读写接口返回的实际上是成功的字节数,而 seek 实际上返回的也是新的文件位置
static int demo_readdir(const char* path, void* buf, fuse_fill_dir_t filler, off_t offset, struct fuse_file_info* fi)
{
    // 此处任务一同学无需关注demo_readdir的传入参数,也不要使用到上述参数

    char filename[128]; // 待填充的

    /* 根据超级块的信息,从第500逻辑块读取一个dentry,ls将只固定显示这个文件名 */
    char buff[512];
    off_t off = 500 * super.sz_blks;
    /* TODO: 计算磁盘偏移off,并根据磁盘偏移off调用ddriver_seek移动磁盘头到磁盘偏移off处 */
    ddriver_seek(super.driver_fd, off, SEEK_SET);
    /* TODO: 调用ddriver_read读出一个磁盘块到内存,512B */
    ddriver_read(super.driver_fd, buff, super.sz_io);
    /* TODO: 使用memcpy拷贝上述512B的前sizeof(demo_dentry)字节构建一个demo_dentry结构 */
    struct demo_dentry dentry;
    memcpy(&dentry, buff, sizeof(dentry));
    /* TODO: 填充filename */
    memcpy(filename, dentry.fname, sizeof(filename));

    // 此处大家先不关注filler,已经帮同学写好,同学填充好filename即可
    return filler(buf, filename, NULL, 0);
}
这里读取磁盘直接通过接口,后续会对这类读写操作进行封装
获取文件属性 demo_getattr
/* 显示文件属性 */
#define DEMO_DEFAULT_PERM        0777

static int demo_getattr(const char* path, struct stat *stbuf)
{
    if(strcmp(path, "/") == 0)
        stbuf->st_mode = DEMO_DEFAULT_PERM | S_IFDIR;            // 根目录是目录文件
    else
        stbuf->st_mode = /* TODO: 显示为普通文件 */;            // 该文件显示为普通文件
    return 0;
}
根据指导书的极简示例
/* 文件属性:这是极简写法,根路径是目录,其余路径统一按普通文件处理 */
static int test_getattr(const char* path, struct stat *stbuf)
{
    // 如果当前查询的是根路径 "/",就把它声明成一个目录
    // 0755 是目录常见权限,S_IFDIR 表示目录类型
    if(strcmp(path, "/") == 0)
        stbuf->st_mode = 0755 | S_IFDIR;
    // 否则就按普通文件处理
    // 0644 是普通文件常见权限,S_IFREG 表示普通文件类型
    else
        stbuf->st_mode = 0644 | S_IFREG;
    return 0;
}
注意到 demo 中默认权限是 0777,直接模仿
/* 显示文件属性 */
static int demo_getattr(const char* path, struct stat *stbuf)
{
    if(strcmp(path, "/") == 0)
        stbuf->st_mode = DEMO_DEFAULT_PERM | S_IFDIR;            // 根目录是目录文件
    else
        stbuf->st_mode = DEMO_DEFAULT_PERM | S_IFREG;            // 该文件显示为普通文件
    return 0;
}
编译与测试
进行编译
编译命令如下,如果已经执行过 cmake,只需要执行 make 即可
# fs/demo
mkdir build && cd build
cmake ..
make
进行挂载和卸载操作
# fs/demo/tests
mkdirmnt
挂载
# fs/demo
./build/demo -f -d -s ./tests/mnt/
卸载(在另一个中断)
# fs/demo/tests
fusermount -u ./mnt
进行测试
尝试手动测试程序
# fs/demo/tests
chmod +x start.sh && ./start.sh
进行挂载之后在另一个终端
# fs/demo/tests
ls ./mnt
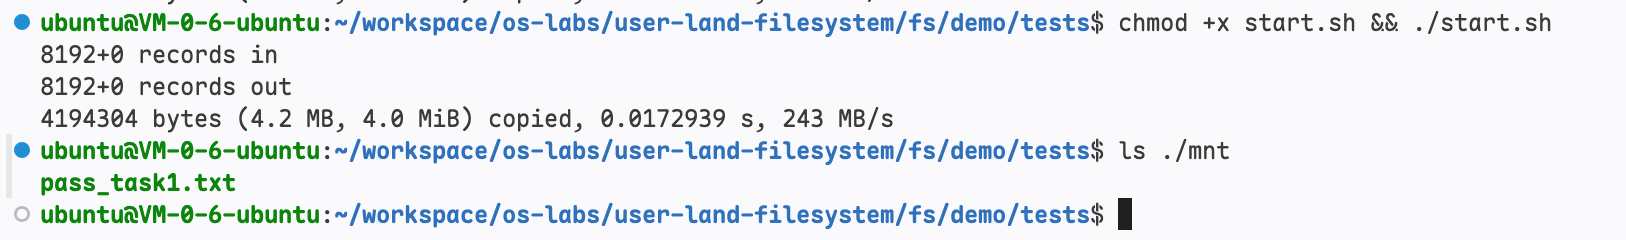
可以看到正常显示了内容
然后卸载
# fs/demo/tests
fusermount -u ./mnt
评测程序的方法如下
# fs/demo/tests
chmod +x test.sh && ./test.sh
任务二、附加题一与附加题四
这三个的要求实际上是 EXT2 的一部分,并且也是最早完成的去年实验的一部分,因此一起给出
完成的期间经历了多次代码修改和重构,因此这里直接从结果开始重新写一遍代码。本章先给出必做部分,再给出附加题一(扩展功能)的实现。
任务的要求完成全部钩子函数以及支持大文件扩展,这里直接使用了 indirect block
文件系统布局
必做的任务里面,计划只有 6 个 block pointer,而每一个逻辑块的大小是1KB,因此每个 inode 最多只能容下 6KB 数据,而模型训练设计的文件大小最大接近 1MB,光靠添加 block pointer 会显得很臃肿,因此这里决定添加一些一级间接块指针
一个间接块指针能够容纳 1024B/4B = 256 个数据块指针,也就是 256 KB 数据,因此只需要五个间接块指针就能支持大约 1MB 的数据了
最终设计好的结构如下,控制一个 inode 的大小为 64 Bytes,这样一个逻辑块就能刚好容下 16 个 inode
#define MAX_DIRECT_BLOCK    6
#define MAX_INDIRECT_BLOCK  5
#define MAX_BLOCKPOINTER    (MAX_DIRECT_BLOCK + MAX_INDIRECT_BLOCK * NEWFS_BLOCK_SIZE / 4)

#define MAX_FILE_SIZE       (MAX_BLOCKPOINTER * NEWFS_BLOCK_SIZE)

typedef enum file_type {
    NEWFS_FILE,   // 普通文件
    NEWFS_DIR     // 目录文件
} FILE_TYPE;

struct newfs_inode_d {
    uint32_t ino;           // inode 编号,用来标识这是第几个 inode
    int size;               // 文件当前大小
    int link;               // 链接数;本实验必做部分不要求专门处理,通常可默认为 1
    FILE_TYPE ftype;        // 文件类型,例如普通文件或目录
    int block_pointer[MAX_DIRECT_BLOCK];   // 直接数据块指针,用来找到文件对应的数据块
    int indirect_pointer[MAX_INDIRECT_BLOCK]; // 间接数据块指针,指向的地方全是BLOCK_POINTER
    int dir_cnt;            // 如果是目录,可记录当前目录下有多少个子项
};
然后考虑 inode 的数量应该有多少个,model 分支的磁盘大小是 80MB,而默认分支是 4MB,也就是 80MB/1KB = 80✖️1024 个逻辑块,每个 inode 指向的逻辑块最多为 $6+5\times(1024/4) = 1286$ 个,但考虑到不可能所有的 inode 数据大小都占满1286个逻辑块,所以这里直接取 1024 个 inode
在 1024 个 inode 的情况下,最多能够指向 1,316,864 个逻辑块 (> 81,920),如果不使用间接块,那么最多指向 6,144 个逻辑块
1024个 inode 本身占用的逻辑块数量是 1024/16 = 64,super 和 inode map 各占一个块,而 data map 比较大,80✖️1024个逻辑块大约需要 10KB 大小空间存储位图,也就是 10 个逻辑块
| BSIZE = 1024 B |
| Super(1) | Inode Map(1) | DATA Map(10) | INODE(64) | DATA(*) |
但是考虑到默认分支只有 4MB,所以这个布局还需要修改一下,data map 大约需要 512 Bytes 空间,也就是一个逻辑块就够了。最终写进 include/fs.layout 的就是下面这种布局,checkbm.py 会依据它检查超级块、位图和数据区的位置
| BSIZE = 1024 B |
| Super(1) | Inode Map(1) | DATA Map(1) | INODE(64) | DATA(*) |
为了让文件系统同时支持这两种大小,需要提前计算好布局。sz_io 和 sz_disk 在挂载时通过 ddriver_ioctl 从设备读出,所以布局相关的宏都写成带 disk_size 参数的形式,同一份代码就能同时适配 80MB 和 4MB 的磁盘
#define DDISK_IO_SIZE()     (super.disk.sz_io)
#define DISK_SIZE()         (super.disk.sz_disk)
#define NEWFS_DRIVER()      (super.fd)

#define NEWFS_BLOCK_SIZE    1024

#define MAX_DIRECT_BLOCK    6
#define MAX_INDIRECT_BLOCK  5
#define MAX_BLOCKPOINTER    (MAX_DIRECT_BLOCK + MAX_INDIRECT_BLOCK * NEWFS_BLOCK_SIZE / 4)

#define MAX_FILE_SIZE       (MAX_BLOCKPOINTER * NEWFS_BLOCK_SIZE)

#define INODE_NUM           1024
#define INODE_SIZE          64
#define SUPER_BLOCK_NUM     1

#define INODE_MAP_SIZE      (INODE_NUM / 8) // 单位字节
#define INODE_MAP_BLOCK_NUM ((INODE_MAP_SIZE + NEWFS_BLOCK_SIZE - 1) / NEWFS_BLOCK_SIZE)

#define INODE_BLOCK_NUM     (INODE_NUM * INODE_SIZE / NEWFS_BLOCK_SIZE) // 可以整除

#define TOTAL_BLOCKS(disk_size)         (disk_size / NEWFS_BLOCK_SIZE)
#define DATA_MAP_SIZE(disk_size)        (TOTAL_BLOCKS(disk_size) / 8)       // 所有逻辑块都算了进去,以确保空间足够
#define DATA_MAP_BLOCK_NUM(disk_size)   ((DATA_MAP_SIZE(disk_size) + NEWFS_BLOCK_SIZE - 1) / NEWFS_BLOCK_SIZE)

#define DATABLOCK_NUM(disk_size)   (TOTAL_BLOCKS(disk_size) \
                                    - SUPER_BLOCK_NUM \
                                    - INODE_MAP_BLOCK_NUM \
                                    - DATA_MAP_BLOCK_NUM(disk_size) \
                                    - INODE_BLOCK_NUM)
然后在指导书的基础上给出剩下的结构体
struct newfs_super_d {
    uint32_t magic;
    int blks_size;          // 文件系统的逻辑块大小,本实验通常是 1024B
    int blks_nums;          // 逻辑块总数

    int sb_offset;          // 超级块区域在磁盘中的起始偏移
    int sb_blks;            // 超级块区域占多少个逻辑块
    int ino_map_offset;     // inode 位图区域的起始偏移
    int ino_map_blks;       // inode 位图区域占多少个逻辑块
    int data_map_offset;    // data 位图区域的起始偏移
    int data_map_blks;      // data 位图区域占多少个逻辑块
    int inode_offset;       // inode 区域的起始偏移
    int inode_blks;         // inode 区域占多少个逻辑块
    int data_offset;        // data 区域的起始偏移
    int data_blks;          // data 区域占多少个逻辑块

    int sz_io;              // 物理块大小
    int sz_disk;            // 硬盘大小
    int ino_max;            // 最多支持多少个 inode
    unsigned int file_max;           // 单个文件允许的最大大小
    int root_ino;           // 根目录对应的 inode 编号
};

struct newfs_dentry_d {
    char     name[MAX_NAME_LEN];
    uint32_t ino;
    FILE_TYPE ftype;        // 文件类型
};
MAX_NAME_LEN 取 120,struct newfs_dentry_d(120 + 4 + 4)正好 128 Bytes,一个逻辑块正好放下 8 个 dentry,不会再因为结构体不对齐浪费空间。
为了便于操作,运行时结构体不同于上面,因此附加一些内容
// Run-time structure
struct newfs_super {
    struct newfs_super_d disk;
    // shouldn't be written to disk:
    int      fd;            // 文件描述符
    // bit map
    uint8_t *ino_map;
    uint8_t *data_map;
};

struct newfs_inode {
    struct newfs_inode_d disk;
    unsigned int block_number;
};

struct newfs_dentry {
    struct newfs_dentry_d disk;

    struct newfs_inode *inode;
    struct newfs_dentry *parent;
    struct newfs_dentry *child;
    struct newfs_dentry *next;
};
工具函数
接口只提供了 open, seek, read, write, ioctl 和 close 六个函数,需要进行一些封装。另外超级块用 NEWFS_MAGIC(0x114514)标记磁盘是否已经格式化过
头文件 include/newfs_utils.h 中集中声明了这些工具函数:
#ifndef _NEWFS_UTILS_H_
#define _NEWFS_UTILS_H_
#include "types.h"

// super and bitmaps
void init_super(int devfd, int io_size, int disk_size);
int load_super(int devfd);
int sync_super(void);

// root inode and dentry
void init_root(void);
void load_root(void);

// drivers
int newfs_read_block(int fd, char* buf, size_t size);
int newfs_write_block(int fd, char* buf, size_t size);
int read_logical_block(unsigned int block_pointer, char* buf);
int write_logical_block(unsigned int block_pointer, char* buf);

// inode
int alloc_inode(struct newfs_inode* inode, FILE_TYPE ftype);
int free_inode(struct newfs_inode* inode);
int read_inode(unsigned int ino, struct newfs_inode* inode);
int sync_inode(struct newfs_inode* inode);

int get_block_pointer(struct newfs_inode* inode, int pointer_index);

int write_data_block(struct newfs_inode* inode, unsigned int pointer_index, char* buf);
int read_data_block(struct newfs_inode* inode, unsigned int pointer_index, char* buf);
int alloc_datablock(struct newfs_inode* inode);
int free_last_datablock(struct newfs_inode* inode);
int clear_datablock_bit(unsigned int data_block_num);
int free_indirect_block(unsigned int indirect_block_num);
int read_indirect_block(unsigned int indirect_block_num);
int adapt_datablock_alloc(struct newfs_inode* inode);

// dentry and hierarchy
int create_hierarchy(struct newfs_dentry* dentry);
int sync_hierarchy(struct newfs_dentry* dentry);
int get_dentry(const char* path, struct newfs_dentry** dentry);
int attach_parent(struct newfs_dentry* parent_dentry, struct newfs_dentry* dentry);
int detach_parent(struct newfs_dentry* dentry);
int drop_dentry(struct newfs_dentry* dentry);
int get_parent_dentry(const char* path, struct newfs_dentry** parent, char* name);
int get_dentry_create(const char* path, struct newfs_dentry** dentry, FILE_TYPE ftype, int need_inode);

#endif
Super 块与设备信息读取
ddriver_ioctl 能够进行四种操作
- 读取设备大小,对应命令
IOC_REQ_DEVICE_SIZE - 读取设备状态,对应命令
IOC_REQ_DEVICE_STATE返回内容有读、写、寻道计数 - 设备重制,对应命令
IOC_REQ_DEVICE_RESET,实际内容是清空磁盘和设备状态 - 读取设备IO大小,对应命令
IOC_REQ_DEVICE_IO_SZ
由于超级块里面设备大小和IO大小和它有关,考虑新建一个工具函数对超级块进行初始化
/**
 * @brief 初始化 super
 *
 * @param devfd ddriver 设备 handler
 * @param io_size io 大小
 * @param disk_size 磁盘大小
 * @return void
 */
void init_super(int devfd, int io_size, int disk_size)
{
    // initialization
    super.disk.magic = NEWFS_MAGIC;
    super.disk.blks_size = NEWFS_BLOCK_SIZE;
    super.disk.blks_nums = TOTAL_BLOCKS(disk_size);                     // 逻辑块总数
    super.disk.sb_offset = 0;                                           // 超级块区域在磁盘中的起始偏移
    super.disk.sb_blks = SUPER_BLOCK_NUM;                               // 超级块区域占多少个逻辑块
    super.disk.ino_map_offset = SUPER_BLOCK_NUM;                        // inode 位图区域的起始偏移
    super.disk.ino_map_blks = INODE_MAP_BLOCK_NUM;                      // inode 位图区域占多少个逻辑块
    super.disk.data_map_offset = SUPER_BLOCK_NUM + INODE_MAP_BLOCK_NUM; // data 位图区域的起始偏移
    super.disk.data_map_blks = DATA_MAP_BLOCK_NUM(disk_size);           // data 位图区域占多少个逻辑块
    super.disk.inode_offset =
        SUPER_BLOCK_NUM + INODE_MAP_BLOCK_NUM + DATA_MAP_BLOCK_NUM(disk_size); // inode 区域的起始偏移
    super.disk.inode_blks = INODE_BLOCK_NUM;                                   // inode 区域占多少个逻辑块
    super.disk.data_offset = SUPER_BLOCK_NUM + INODE_MAP_BLOCK_NUM + DATA_MAP_BLOCK_NUM(disk_size) + INODE_BLOCK_NUM;
    super.disk.data_blks = DATABLOCK_NUM(disk_size);
    super.disk.sz_io = io_size;          // 物理块大小
    super.disk.sz_disk = disk_size;      // 硬盘大小
    super.disk.ino_max = INODE_NUM;      // 最多支持多少个 inode
    super.disk.file_max = MAX_FILE_SIZE; // 单个文件允许的最大大小
    super.disk.root_ino = 0;             // 根目录对应的 inode 编号
    super.fd = devfd;
    if (!super.ino_map) {
        super.ino_map = (uint8_t*)malloc(INODE_MAP_SIZE);
    }
    if (!super.data_map) {
        super.data_map = (uint8_t*)malloc(DATA_MAP_SIZE(disk_size));
    }
    memset(super.ino_map, 0, INODE_MAP_SIZE);
    memset(super.data_map, 0, DATA_MAP_SIZE(disk_size));
}

/**
 * @brief 尝试从磁盘加载 super,要求设备已打开
 *
 * @param devfd ddriver 设备 handler
 * @return int 0 表示正常读取,1表示进行初始化
 */
int load_super(int devfd)
{
    super.fd = devfd;
    int io_size, disk_size;
    ddriver_ioctl(devfd, IOC_REQ_DEVICE_IO_SZ, &io_size);
    ddriver_ioctl(devfd, IOC_REQ_DEVICE_SIZE, &disk_size);
    super.disk.sz_io = io_size;
    super.disk.sz_disk = disk_size;
    // load
    char buf[SUPER_BLOCK_NUM * NEWFS_BLOCK_SIZE];
    if (ddriver_seek(devfd, 0, SEEK_SET) < 0) {
        fprintf(stderr, "Seek failed!\n");
        return -EIO;
    }
    if (newfs_read_block(devfd, buf, sizeof(buf)) != 0) {
        fprintf(stderr, "Read failed!\n");
        return -EIO;
    }
    memmove(&super.disk, buf, sizeof(struct newfs_super_d));
    if (super.disk.magic != NEWFS_MAGIC) {
        fprintf(stdout, "Magic Number mismatch! Now try to init\n");

        init_super(devfd, io_size, disk_size);
        return 1;
    }
    if (!super.ino_map) {
        super.ino_map = (uint8_t*)malloc(INODE_MAP_SIZE);
    }
    if (!super.data_map) {
        super.data_map = (uint8_t*)malloc(DATA_MAP_SIZE(super.disk.sz_disk));
    }
    if (ddriver_seek(devfd, SUPER_BLOCK_NUM * NEWFS_BLOCK_SIZE, SEEK_SET) < 0) {
        fprintf(stderr, "Seek failed!\n");
        return -EIO;
    }
    char* bitmap_buf = malloc((super.disk.ino_map_blks + super.disk.data_map_blks) * NEWFS_BLOCK_SIZE);
    if (newfs_read_block(devfd, bitmap_buf, (super.disk.ino_map_blks + super.disk.data_map_blks) * NEWFS_BLOCK_SIZE) !=
        0) {
        fprintf(stderr, "Read failed!\n");
        free(bitmap_buf);
        return -EIO;
    }
    memmove(super.ino_map, bitmap_buf, INODE_MAP_SIZE);
    memmove(super.data_map, bitmap_buf + (super.disk.ino_map_blks * NEWFS_BLOCK_SIZE),
            DATA_MAP_SIZE(super.disk.sz_disk));
    free(bitmap_buf);
    return 0;
}
超级块与位图持久化
/**
 * @brief 同步 super 和 bitmaps
 *
 * @return int 不出错误返回 0
 */
int sync_super(void)
{
    // 同步 superblock 和 bitmaps
    char* super_bitmaps_buf =
        malloc((super.disk.sb_blks + super.disk.ino_map_blks + super.disk.data_map_blks) * NEWFS_BLOCK_SIZE);
    memset(super_bitmaps_buf, 0,
           (super.disk.sb_blks + super.disk.ino_map_blks + super.disk.data_map_blks) * NEWFS_BLOCK_SIZE);
    memmove(super_bitmaps_buf, &super.disk, sizeof(struct newfs_super_d));
    memmove(super_bitmaps_buf + super.disk.sb_blks * NEWFS_BLOCK_SIZE, super.ino_map, INODE_MAP_SIZE);
    memmove(super_bitmaps_buf + (super.disk.sb_blks + super.disk.ino_map_blks) * NEWFS_BLOCK_SIZE, super.data_map,
            DATA_MAP_SIZE(super.disk.sz_disk));
    if (ddriver_seek(super.fd, 0, SEEK_SET) < 0) {
        fprintf(stderr, "Seek Failed\n");
        free(super_bitmaps_buf);
        return -EIO;
    }
    if (newfs_write_block(super.fd, super_bitmaps_buf,
                          (super.disk.sb_blks + super.disk.ino_map_blks + super.disk.data_map_blks) *
                              NEWFS_BLOCK_SIZE) != 0) {
        fprintf(stderr, "Write Failed\n");
        free(super_bitmaps_buf);
        return -EIO;
    }
    free(super_bitmaps_buf);
    return 0;
}
逻辑块读取
将原本的接口进行封装,实现按逻辑块读写。注意每次 ddriver_read / ddriver_write 都必须对齐到设备 IO 单位(512B),所以一个逻辑块要拆成多次 IO:
/**
 * @brief 按逻辑块读出数据
 *
 * @param fd ddriver设备handler
 * @param buf 要读出的数据Buf
 * @param size 要读出的数据大小,注意与单次设备IO单位对齐
 * @return int
 */
int newfs_read_block(int fd, char* buf, size_t size)
{
    int disk_io_sz = super.disk.sz_io;
    if (size == 0)
        return 0;
    if (size % super.disk.sz_io)
        return -EINVAL;
    int times = size / disk_io_sz;
    for (int i = 0; i < times; i++) {
        if (ddriver_read(fd, buf + i * disk_io_sz, disk_io_sz) != disk_io_sz)
            return -EIO;
    }
    return 0;
}

/**
 * @brief 按逻辑块写入数据
 *
 * @param fd ddriver设备handler
 * @param buf 要写入的数据Buf
 * @param size 要写入的数据大小,注意与单次设备IO单位对齐
 * @return int 0成功,否则失败
 */
int newfs_write_block(int fd, char* buf, size_t size)
{
    int disk_io_sz = super.disk.sz_io;
    if (size == 0)
        return 0;
    if (size % super.disk.sz_io)
        return -EINVAL;
    int times = size / disk_io_sz;
    for (int i = 0; i < times; i++) {
        int ret = ddriver_write(fd, buf + i * disk_io_sz, disk_io_sz);
        // fprintf(stdout, "Write: %d, ret: %d\n", fd, ret);
        if (ret != disk_io_sz)
            return -EIO;
    }
    return 0;
}

/**
 * @brief 从一个逻辑块读取数据
 *
 * @param block_pointer 逻辑块 序号
 * @param buf 返回读取的数据
 * @return int 0成功,否则失败
 */
int read_logical_block(unsigned int block_pointer, char* buf)
{
    int total_blocks = super.disk.blks_nums;
    if (block_pointer >= total_blocks) {
        fprintf(stderr, "Invalid Input: %u > TOTAL_BLOCKS\n", block_pointer);
        return -EINVAL;
    }
    if (ddriver_seek(super.fd, block_pointer * NEWFS_BLOCK_SIZE, SEEK_SET) < 0) {
        fprintf(stderr, "Seek failed!\n");
        return -EIO;
    }
    int ret = newfs_read_block(super.fd, buf, NEWFS_BLOCK_SIZE);
    if (ret != 0) {
        fprintf(stderr, "Write failed!: %d\n", ret);
        return -EIO;
    }
    return 0;
}

/**
 * @brief 写入数据到一个逻辑块
 *
 * @param block_pointer 逻辑块 序号
 * @param buf 要写入的数据
 * @return int 0成功,否则失败
 */
int write_logical_block(unsigned int block_pointer, char* buf)
{
    int total_blocks = super.disk.blks_nums;
    if (block_pointer >= total_blocks) {
        printf("Invalid Input: %u > TOTAL_BLOCKS\n", block_pointer);
        return -EINVAL;
    }

    if (ddriver_seek(super.fd, block_pointer * NEWFS_BLOCK_SIZE, SEEK_SET) < 0) {
        printf("Seek failed!\n");
        return -EIO;
    }
    int ret = newfs_write_block(super.fd, buf, NEWFS_BLOCK_SIZE);
    if (ret != 0) {
        printf("write failed!: %d\n", ret);
        return -EIO;
    }
    return 0;
}
数据块的分配和释放
数据块的分配和释放涉及位图的修改,而这涉及到索引的问题,数据块序号并不等于逻辑块序号,这里规定仅在调用读写接口的时候使用逻辑块序号,其他时候均使用数据块序号
/**
 * @brief 从 datablock bitmap 中找一个空闲
 *
 * @return 成功返回 data block num,否则返回 -ENOSPC
 */
int alloc_datablock_bit(void)
{
    // 先检查 bitmap
    int data_block_num = -ENOSPC;
    for (unsigned int i = 0; i < DATA_MAP_SIZE(super.disk.sz_disk) * 8; i++) {
        if ((super.data_map[i / 8] & (1 << (i % 8))) == 0) {
            data_block_num = i;
            break;
        }
    }
    // 不是合法的 data_block_num
    if (data_block_num >= super.disk.data_blks) {
        data_block_num = -ENOSPC;
    } else if (data_block_num > 0) {
        super.data_map[data_block_num / 8] |= (1 << (data_block_num % 8));
    }
    return data_block_num;
}

/**
 * @brief 输入 data block num 并清除对应的 bit
 *
 * @param data_block_num data_block的序号
 * @return 成功返回 0,否则返回 -1
 */
int clear_datablock_bit(unsigned int data_block_num)
{
    if (data_block_num == 0) { // 根目录的数据块不能清除
        return -EINVAL;
    }
    // 不是合法的 data block num
    if (data_block_num >= super.disk.data_blks)
        return -EINVAL;
    if ((super.data_map[data_block_num / 8] & (1 << (data_block_num % 8))) == 0) {
        fprintf(stderr, "Double release!\n");
        return -EINVAL;
    }
    super.data_map[data_block_num / 8] &= ~(1 << (data_block_num % 8));
    return 0;
}
inode 的分配和释放
文件系统中的 inode 位图和数据块位图都以字节数组的形式存储,分配和修改起来不太方便,这里进行封装
/**
 * @brief 分配一个 inode,但是不分配 datablock ,也不进行磁盘同步
 *
 * @param inode 传入 inode 非空指针
 * @param ftype 文件类型
 * @return 成功返回 0,否则返回 -1
 */
int alloc_inode(struct newfs_inode* inode, FILE_TYPE ftype)
{
    if (inode == NULL)
        return -EINVAL;
    // 先检查 bitmap
    int ino = -1;
    for (unsigned int i = 1; i < INODE_MAP_SIZE * 8; i++) {
        if ((super.ino_map[i / 8] & (1 << (i % 8))) == 0) {
            ino = i;
            break;
        }
    }
    // failed to find
    if (ino == -1)
        return -ENOSPC;
    // 初始化
    inode->block_number = 0;
    inode->disk.ino = ino;     // inode 编号,用来标识这是第几个 inode
    inode->disk.size = 0;      // 文件当前大小
    inode->disk.link = 1;      // 链接数;本实验必做部分不要求专门处理,通常可默认为 1
    inode->disk.ftype = ftype; // 文件类型,例如普通文件或目录
    memset(inode->disk.block_pointer, -1, sizeof(inode->disk.block_pointer));
    memset(inode->disk.indirect_pointer, -1, sizeof(inode->disk.indirect_pointer));
    inode->disk.dir_cnt = 0; // 如果是目录,可记录当前目录下有多少个子项
    super.ino_map[ino / 8] |= (1 << (ino % 8));
    return 0;
}
释放 inode 同理
/**
 * @brief 释放 inode ,同样只修改内存中数据
 *
 * @param inode 传入 inode 指针
 * @return 成功返回 0
 */
int free_inode(struct newfs_inode* inode)
{
    if (inode == NULL)
        return -EINVAL;

    // 先检查修改 bitmap
    unsigned int ino = inode->disk.ino;
    if (ino >= INODE_NUM)
        return -EINVAL;
    if (ino == 0)
        return -EINVAL;
    if ((super.ino_map[ino / 8] & (1 << (ino % 8))) == 0) {
        fprintf(stderr, "Something wrong with inode bitmap and inode!\n");
        return -EIO;
    }
    // inode 下的 data block 也要释放掉
    int i = 0;
    while (i < MAX_DIRECT_BLOCK && (inode->disk.block_pointer[i] > 0)) {
        int ret = clear_datablock_bit(inode->disk.block_pointer[i]);
        if (ret != 0)
            return ret;
        i++;
        inode->block_number--;
    }
    // inode 下的 indirect block 同样要释放
    i = 0;
    while (i < MAX_INDIRECT_BLOCK && (inode->disk.indirect_pointer[i] > 0)) {
        int ret = free_indirect_block(inode->disk.indirect_pointer[i]);
        if (ret < 0)
            return ret;
        int free_count = ret;
        inode->block_number -= free_count;
        i++;
    }
    if (inode->block_number != 0) {
        printf("inode->block_number=%u after free!\n", inode->block_number);
        return -1;
    }
    super.ino_map[ino / 8] &= ~(1 << (ino % 8));
    free(inode);
    return 0;
}
注意到这里有两个函数用来释放数据块
获取 inode 中的数据块指针
要读取 inode 的间接指针指向的数据块和直接指针不一样,涉及到磁盘多次读取,因此这里封装一个函数
/**
 * @brief 给定 inode 和 block pointer 序号,获得指定 datablock pointer
 *
 * @param inode 传入的inode
 * @param pointer_index pointer 下标,范围在 0 到 inode 的 block_numbers-1 之间
 * @param pointer 读取出来的 block pointer,是数据块序号而非逻辑块序号
 * @return 成功返回指针
 */
int get_block_pointer(struct newfs_inode* inode, int pointer_index)
{
    // 检查输入
    if (inode == NULL)
        return -EINVAL;
    if (pointer_index >= inode->block_number)
        return -EINVAL;
    // direct block
    if (pointer_index < MAX_DIRECT_BLOCK) {
        // 直接返回
        return inode->disk.block_pointer[pointer_index];
    } else { // indirect block
        int indirect_pointer_index = (pointer_index - MAX_DIRECT_BLOCK) / (NEWFS_BLOCK_SIZE / sizeof(unsigned int));
        int pointer_index_in_block = (pointer_index - MAX_DIRECT_BLOCK) % (NEWFS_BLOCK_SIZE / sizeof(unsigned int));
        // 先找到 pointer
        int pointers[NEWFS_BLOCK_SIZE / sizeof(unsigned int)];
        int indirect_pointer = inode->disk.indirect_pointer[indirect_pointer_index];
        if (indirect_pointer < 0)
            return -EIO;
        int ret = read_logical_block(indirect_pointer + super.disk.data_offset, (char*)pointers);
        if (ret != 0)
            return ret;
        return pointers[pointer_index_in_block];
    }
}
读写 inode 的数据块
由于已经有了获取数据块指针的函数了,现在可以对 inode 的数据块进行读写
/**
 * @brief 给定 inode 和 block pointer 序号,读出来指定 datablock
 * 的内容(非indirect block)
 *
 * @param inode 传入的inode
 * @param pointer_index pointer 下标,范围在 0 到 block_numbers-1 之间
 * @param buf 返回读出来的整个 datablock 数据
 * @return 成功返回 0
 */
int read_data_block(struct newfs_inode* inode, unsigned int pointer_index, char* buf)
{
    // 检查输入
    if (inode == NULL || buf == NULL)
        return -EINVAL;
    if (pointer_index >= inode->block_number)
        return -EINVAL;
    int ret = get_block_pointer(inode, pointer_index);
    if (ret <= 0) {
        return ret;
    }
    int block_index = ret + super.disk.data_offset;
    return read_logical_block(block_index, buf);
}

/**
 * @brief 给定 inode 和 block pointer 序号,写入出来指定 datablock
 * 的内容(非indirect block)
 *
 * @param inode 传入的inode
 * @param pointer_index pointer 下标,范围在 0 到 block_numbers-1 之间
 * @param buf 待写入的整个 datablock 数据
 * @return 成功返回 0,出错返回 -1
 */
int write_data_block(struct newfs_inode* inode, unsigned int pointer_index, char* buf)
{
    // 检查输入
    if (inode == NULL || buf == NULL)
        return -EINVAL;
    if (pointer_index >= inode->block_number)
        return -EINVAL;
    int ret = get_block_pointer(inode, pointer_index);
    if (ret <= 0) {
        return ret;
    }
    int block_index = ret + super.disk.data_offset;
    return write_logical_block(block_index, buf);
}
给 inode 分配/释放数据块
由于分配和释放数据块一般会发生在扩大文件内容或者缩小文件内容上,所以这里给一个分配一个数据块/释放最后一个数据块的接口
/**
 * @brief 给 inode 分配一个 datablock,但是不进行写操作,先分配 data
 * block,再分配 indirect block
 *
 * @param inode 传入 inode 非空指针
 * @return 成功返回 0
 */
int alloc_datablock(struct newfs_inode* inode)
{
    if (inode == NULL)
        return -EINVAL;
    if (inode->block_number >= MAX_BLOCKPOINTER) {
        return -EFBIG;
    }
    // 先检查 bitmap
    int data_block_num = alloc_datablock_bit();
    // failed to find
    if (data_block_num == -1)
        return -ENOSPC;
    // 清空那块区域
    int block_index = super.disk.data_offset + data_block_num;
    char buf[NEWFS_BLOCK_SIZE];
    memset(buf, 0, NEWFS_BLOCK_SIZE);
    if (write_logical_block(block_index, buf) != 0) {
        printf("Clear failed!\n");
        return -EIO;
    }
    // 初始化
    int new_index = inode->block_number;
    // 根据 new_index 决定分配
    if (new_index < MAX_DIRECT_BLOCK) {
        // 不涉及 indirect block ,在这里进行分配即可
        inode->disk.block_pointer[new_index] = data_block_num;
    } else {
        // 涉及 indirect block
        int indirect_pointer_index = (new_index - MAX_DIRECT_BLOCK) / (NEWFS_BLOCK_SIZE / sizeof(int));
        int pointer_index_in_block = (new_index - MAX_DIRECT_BLOCK) % (NEWFS_BLOCK_SIZE / sizeof(int));
        if (pointer_index_in_block == 0) {
            // 需要分配一个indirect block
            int indirect_block_num = alloc_datablock_bit();
            if (indirect_block_num == -1) {
                clear_datablock_bit(data_block_num);
                return -ENOSPC;
            }
            // 初始化,写入带有一个指针的空白块
            memset(buf, -1, NEWFS_BLOCK_SIZE);
            memmove(buf, &data_block_num, sizeof(int));
            int new_indirect_block_index = super.disk.data_offset + indirect_block_num;
            if (write_logical_block(new_indirect_block_index, buf) != 0) {
                fprintf(stderr, "Clear failed!\n");
                clear_datablock_bit(data_block_num);
                clear_datablock_bit(indirect_block_num);
                return -EIO;
            }
            inode->disk.indirect_pointer[indirect_pointer_index] = indirect_block_num;
        } else {
            // 直接在已有的 indirect block 上操作
            int indirect_pointer = inode->disk.indirect_pointer[indirect_pointer_index];
            if (read_logical_block(indirect_pointer + super.disk.data_offset, buf) != 0) {
                fprintf(stderr, "Clear failed!\n");
                clear_datablock_bit(data_block_num);
                return -EIO;
            }
            memmove(buf + pointer_index_in_block * sizeof(int), &data_block_num, sizeof(int));
            if (write_logical_block(indirect_pointer + super.disk.data_offset, buf) != 0) {
                printf("Write failed!\n");
                clear_datablock_bit(data_block_num);
                return -EIO;
            }
        }
    }
    inode->block_number++;
    return 0;
}
释放类似
/**
 * @brief 释放最后一个 datablock
 *
 * @param inode 传入 inode 非空指针
 * @return 成功返回 0
 */
int free_last_datablock(struct newfs_inode* inode)
{
    // 检查输入
    if (inode == NULL)
        return -EINVAL;
    if (inode->block_number == 0)
        return -EINVAL;
    int ret = 0;
    unsigned int pointer_index = inode->block_number - 1;
    int target_pointer = -1;
    // direct block
    if (pointer_index < MAX_DIRECT_BLOCK) {
        target_pointer = inode->disk.block_pointer[pointer_index];
        inode->disk.block_pointer[pointer_index] = -1;
    } else { // indirect block
        int indirect_pointer_index = (pointer_index - MAX_DIRECT_BLOCK) / (NEWFS_BLOCK_SIZE / sizeof(int));
        int pointer_index_in_block = (pointer_index - MAX_DIRECT_BLOCK) % (NEWFS_BLOCK_SIZE / sizeof(int));
        // 先找到 pointer
        int pointers[NEWFS_BLOCK_SIZE / sizeof(int)];
        int indirect_block_num = inode->disk.indirect_pointer[indirect_pointer_index];
        int indirect_block_index = super.disk.data_offset + indirect_block_num;
        if (indirect_block_num <= 0) // 0 号 datablock 属于 root
            return -EIO;
        if (pointer_index_in_block == 0) {
            // 需要释放整个 indirect_block
            if ((ret = free_indirect_block(indirect_block_num)) != 1)
                return ret;
            inode->disk.indirect_pointer[indirect_pointer_index] = -1;
            inode->block_number -= ret;
            return 0;
        } else {
            // 释放单个指针
            if (read_logical_block(indirect_block_index, (char*)pointers) != 0)
                return -EIO;
            target_pointer = pointers[pointer_index_in_block];
            pointers[pointer_index_in_block] = -1;
            if (write_logical_block(indirect_block_index, (char*)pointers) != 0)
                return -EIO;
        }
    }
    ret = clear_datablock_bit(target_pointer);
    if (ret != 0)
        return ret;
    inode->block_number--;
    return 0;
}
还有一个 free_indirect_block 的函数需要补充
/**
 * @brief 释放 indirect_block,并且返回释放的 block 数量
 *
 * @param indirect_block_num 传入 data block 编号
 * @return 返回释放的 block 数量
 */
int free_indirect_block(unsigned int indirect_block_num)
{
    if (indirect_block_num >= super.disk.data_blks) {
        printf("Invalid indirect block: %u\n", indirect_block_num);
        return -EINVAL;
    }
    // 读出内容,释放这些 data blocks
    int indirect_block_index = super.disk.data_offset + indirect_block_num;
    int pointers[NEWFS_BLOCK_SIZE / sizeof(int)];
    if (read_logical_block(indirect_block_index, (char*)pointers) != 0) {
        return -1;
    }
    unsigned int free_count = 0;
    for (int i = 0; i < NEWFS_BLOCK_SIZE / sizeof(unsigned int); i++) {
        if (pointers[i] <= 0)
            break;
        int ret = clear_datablock_bit(pointers[i]);
        if (ret != 0)
            return ret;
        free_count++;
    }
    if (clear_datablock_bit(indirect_block_num) != 0)
        return -1;
    return free_count;
}
按文件大小调整数据块分配
truncate(以及 write 扩展文件时)需要按目标大小补齐或释放数据块,这里单独封装:按 inode->disk.size 算出目标块数,少了就 alloc_datablock,多了就 free_last_datablock。
/**
 * @brief 检查 inode 的大小,为其分配足够的数据块/释放足够的数据块
 *
 * @param inode 传入 inode
 * @return 成功返回0
 */
int adapt_datablock_alloc(struct newfs_inode* inode)
{
    if (inode == NULL)
        return -EINVAL;
    unsigned int old_block_num = inode->block_number;
    unsigned int target_block_num = (inode->disk.size + NEWFS_BLOCK_SIZE - 1) / NEWFS_BLOCK_SIZE; // 向上取整
    if (inode->disk.ftype == NEWFS_DIR) {
        // 目录至少要保留一个数据块
        target_block_num = (target_block_num == 0) ? 1 : target_block_num;
    }
    if (old_block_num == target_block_num) {
        return 0;
    }
    int ret = 0;
    while (old_block_num < target_block_num) {
        if ((ret = alloc_datablock(inode)) != 0)
            return ret;
        old_block_num = inode->block_number;
    }
    while (old_block_num > target_block_num) {
        if ((ret = free_last_datablock(inode)) != 0)
            return ret;
        old_block_num = inode->block_number;
    }
    return ret;
}
读取 inode 和持久化 inode
前面的操作大部分是对数据块的处理,而 inode 本身要从磁盘中读取,挂载时也要写会磁盘中,indirect block 不需要额外同步
/**
 * @brief 给定 inode 编号,返回 inode 信息
 *
 * @param ino inode编号
 * @param inode 传入指针进行修改
 * @return 成功返回 0,否则返回 -1
 */
int read_inode(unsigned int ino, struct newfs_inode* inode)
{
    if (inode == NULL)
        return -EINVAL;
    if (ino >= INODE_NUM)
        return -EINVAL;
    char buf[NEWFS_BLOCK_SIZE];
    unsigned int inode_capacity = super.disk.sz_io / sizeof(struct newfs_inode_d);
    unsigned int io_block_num = super.disk.inode_offset * 2 + ino / inode_capacity; // 在第几个 io block 找?
    unsigned int num_in_io_block = ino % inode_capacity; // 在 io block 里第几个位置?
    if (ddriver_seek(super.fd, io_block_num * super.disk.sz_io, SEEK_SET) < 0)
        return -EIO;
    if (newfs_read_block(super.fd, buf, super.disk.sz_io) != 0)
        return -EIO;
    memmove(&(inode->disk), buf + num_in_io_block * sizeof(struct newfs_inode_d), sizeof(struct newfs_inode_d));
    // 还原 block_number
    int i = 0;
    while (i < MAX_DIRECT_BLOCK && (inode->disk.block_pointer[i] >= 0)) {
        i++;
    }
    inode->block_number = i;
    i = 0;
    while (i < MAX_INDIRECT_BLOCK && (inode->disk.indirect_pointer[i] > 0)) {
        int read_num = read_indirect_block(inode->disk.indirect_pointer[i]);
        if (read_num < 0)
            return -EIO;
        inode->block_number += read_num;
        i++;
    }
    return 0;
}

/**
 * @brief 检查 indirect_block,并且返回里面的 block_pointer 数量
 *
 * @param indirect_pointer 传入 data block 序号
 * @return 返回释放的 block 数量
 */
int read_indirect_block(unsigned int indirect_block_num)
{
    if (indirect_block_num >= super.disk.data_blks) {
        fprintf(stderr, "Invalid indirect block: %u\n", indirect_block_num);
        return -EINVAL;
    }
    int indirect_block_index = indirect_block_num + super.disk.data_offset;
    // 读出内容
    int pointers[NEWFS_BLOCK_SIZE / sizeof(int)];
    if (read_logical_block(indirect_block_index, (char*)pointers) != 0) {
        return -1;
    }
    int pointer_count = 0;
    for (int i = 0; i < NEWFS_BLOCK_SIZE / sizeof(int); i++) {
        if (pointers[i] <= 0)
            break;
        pointer_count++;
    }
    return pointer_count;
}
inode 的持久化和读取类似
/**
 * @brief 给定 inode 编号,将 inode 同步到硬盘中
 *
 * @param inode_d 传入 inode 指针
 * @return 成功返回 0,否则返回 -1
 */
int sync_inode(struct newfs_inode* inode)
{
    if (inode == NULL)
        return -EINVAL;
    struct newfs_inode_d* inode_d = &(inode->disk);
    unsigned int ino = inode_d->ino;
    if (ino >= INODE_MAP_SIZE * 8)
        return -EINVAL;
    char buf[NEWFS_BLOCK_SIZE];
    unsigned int inode_capacity = super.disk.sz_io / sizeof(struct newfs_inode_d);
    unsigned int io_block_num = super.disk.inode_offset * 2 + ino / inode_capacity; // 在第几个 io block 找?
    unsigned int num_in_io_block = ino % inode_capacity; // 在 io block 里第几个位置?
    ddriver_seek(super.fd, io_block_num * super.disk.sz_io, SEEK_SET);
    if (newfs_read_block(super.fd, buf, super.disk.sz_io) != 0) {
        fprintf(stderr, "sync_inode: Read failed, ino=%u, io_block=%u\n", ino, io_block_num);
        return -EIO;
    }
    memmove(buf + num_in_io_block * sizeof(struct newfs_inode_d), inode_d, sizeof(struct newfs_inode_d));
    ddriver_seek(super.fd, io_block_num * super.disk.sz_io, SEEK_SET);
    if (newfs_write_block(super.fd, buf, super.disk.sz_io) != 0) {
        fprintf(stderr, "sync_inode: Write failed, ino=%u, io_block=%u\n", ino, io_block_num);
        return -EIO;
    }
    // indirect block 属于 data blocks 不在内存中,不同步
    return 0;
}
读取 dentry 和读取目录树
整个目录结构在运行时是存储在内存中的,所以需要事前读取整个目录树,卸载时将目录同步,但是数据块部分会实时写入,不需要额外进行同步
/**
 * @brief 从 buf 中逐条读 dentry_d 并且插入到 dentry 中
 *
 * @param data_buf 传入一个逻辑块大小的数据
 * @param dentry 拥有这些数据的 dentry
 * @return 成功返回 0
 */
int load_dentry(char* data_buf, struct newfs_dentry* dentry)
{
    if (dentry == NULL) {
        return -EINVAL;
    }
    struct newfs_dentry_d* pointer = (struct newfs_dentry_d*)data_buf;
    for (int i = 0; i < NEWFS_BLOCK_SIZE / sizeof(struct newfs_dentry_d); i++) {
        if (pointer[i].name[0] == '\0')
            break;
        // 找到了 dentry,加载进去
        struct newfs_dentry* new_dentry = malloc(sizeof(struct newfs_dentry));
        if (new_dentry == NULL)
            return -ENOMEM;
        memmove(&new_dentry->disk, &pointer[i], sizeof(struct newfs_dentry_d));
        new_dentry->parent = dentry;
        new_dentry->child = NULL;
        new_dentry->inode = NULL;
        new_dentry->next = dentry->child;
        dentry->child = new_dentry;
        int ret = create_hierarchy(new_dentry);
        if (ret != 0)
            return ret;
    }
    return 0;
}

/**
 * @brief 给定目录的 dentry,读取磁盘并创建目录树,
 *
 * @param dentry 目录的 dentry,除了 child 和 inode 其他都已齐全
 * @return 成功返回 0,出错返回 -1
 */
int create_hierarchy(struct newfs_dentry* dentry)
{
    if (dentry == NULL) {
        return -EINVAL;
    }
    unsigned int inode_num = dentry->disk.ino;
    int ret = 0;
    // 先加载 inode
    if (dentry->inode == NULL) {
        struct newfs_inode* inode = malloc(sizeof(struct newfs_inode));
        if (inode == NULL)
            return -ENOMEM;
        if ((ret = read_inode(inode_num, inode)) != 0) {
            free(inode);
            return ret;
        }
        dentry->inode = inode;
    }
    // 普通文件不需要 child
    if (dentry->disk.ftype == NEWFS_FILE) {
        dentry->child = NULL;
        return 0;
    }
    // 对于目录,需要加载数据块,并且创建底下的 dentry ,然后建立关系(parent,
    // child, next) direct block 的情况
    for (int i = 0; i < MAX_DIRECT_BLOCK; i++) {
        if (dentry->inode->disk.block_pointer[i] < 0) {
            break;
        }
        char data_buf[NEWFS_BLOCK_SIZE];
        int direct_block_index = dentry->inode->disk.block_pointer[i] + super.disk.data_offset;
        if ((ret = read_logical_block(direct_block_index, data_buf)) != 0)
            return ret;
        // 读取 buf 并插入 dentry 中
        if ((ret = load_dentry(data_buf, dentry)) != 0)
            return ret;
    }
    // 考虑 indirect block 的情况
    for (int i = 0; i < MAX_INDIRECT_BLOCK && (dentry->inode->disk.indirect_pointer[i] > 0); i++) {
        int pointers[NEWFS_BLOCK_SIZE / sizeof(int)];
        int indirect_block_index = dentry->inode->disk.indirect_pointer[i] + super.disk.data_offset;
        if ((ret = read_logical_block(indirect_block_index, (char*)pointers)) != 0)
            return ret;
        // 对每一个指针进行读取
        for (int j = 0; j < NEWFS_BLOCK_SIZE / sizeof(int); j++) {
            if (pointers[j] < 0)
                break;
            char dentries_buf[NEWFS_BLOCK_SIZE];
            if ((ret = read_logical_block(pointers[j] + super.disk.data_offset, dentries_buf)) != 0)
                return ret;
            if ((ret = load_dentry(dentries_buf, dentry)) != 0)
                return ret;
        }
    }
    return 0;
}
挂载时,会将根节点传入这个函数
目录树同步
卸载时需要同步目录树
/**
 * @brief 给定目录的 dentry,将目录树写入磁盘,不考虑 bitmap 的同步问题
 *
 * @param dentry 目录的 dentry
 * @return 成功返回 0,出错返回 -1
 */
int sync_hierarchy(struct newfs_dentry* dentry)
{
    if (dentry == NULL) {
        return -EINVAL;
    }
    int ret = 0;
    // 同步 inode
    if (dentry->inode != NULL) {
        if ((ret = sync_inode(dentry->inode)) != 0) {
            fprintf(stderr, "sync_inode failed: ino=%u, errno:%d\n", dentry->inode->disk.ino, ret);
            return ret;
        }
    }
    // 普通文件没有 child 直接返回
    if (dentry->disk.ftype == NEWFS_FILE) {
        return 0;
    }
    // 目录如果没有 child ,也返回
    if (dentry->child == NULL) {
        return 0;
    }
    // 有 child,需要考虑同步数据块的问题
    // 先写入到 direct block
    struct newfs_dentry* child = dentry->child;
    for (int i = 0; i < MAX_DIRECT_BLOCK; i++) {
        if (!child)
            break;
        if (dentry->inode->disk.block_pointer[i] < 0) {
            break;
        }
        char data_buf[NEWFS_BLOCK_SIZE];
        memset(data_buf, 0, sizeof(data_buf));
        // 读取 buf 并插入到 dentry 中
        struct newfs_dentry_d* pointer = (struct newfs_dentry_d*)data_buf;
        for (int j = 0; j < NEWFS_BLOCK_SIZE / sizeof(struct newfs_dentry_d) && child; j++) {
            memmove(&pointer[j], &child->disk, sizeof(struct newfs_dentry_d));
            if ((ret = sync_hierarchy(child)) != 0)
                return ret;
            child = child->next;
        }
        // 将带有 dentry 的 data blocks 写回
        if (write_logical_block(dentry->inode->disk.block_pointer[i] + super.disk.data_offset, data_buf) != 0)
            return -EIO;
    }

    // 如果 children 足够多,需要写到 indirect block
    for (int i = 0; i < MAX_INDIRECT_BLOCK && (dentry->inode->disk.indirect_pointer[i] > 0) && child; i++) {
        // 先读出来 pointers
        unsigned int pointers[NEWFS_BLOCK_SIZE / sizeof(unsigned int)];
        if (read_logical_block(dentry->inode->disk.indirect_pointer[i] + super.disk.data_offset, (char*)pointers) != 0)
            return -EIO;
        // 根据 pointers 写入对应的 data blocks
        for (int j = 0; j < NEWFS_BLOCK_SIZE / sizeof(unsigned int) && child; j++) {
            if (pointers[j] <= 0) // pointers 不存在
                break;
            char dentries_buf[NEWFS_BLOCK_SIZE];
            memset(dentries_buf, 0, sizeof(dentries_buf));
            struct newfs_dentry_d* pointer = (struct newfs_dentry_d*)dentries_buf;
            // 每个 child 写入到 buf 中
            for (int k = 0; k < NEWFS_BLOCK_SIZE / sizeof(struct newfs_dentry_d) && child; k++) {
                if ((ret = sync_hierarchy(child)) != 0) {
                    return ret;
                }
                memmove(&pointer[k], &child->disk, sizeof(struct newfs_dentry_d));
                child = child->next;
            }
            // 写回磁盘
            if (write_logical_block(pointers[j] + super.disk.data_offset, dentries_buf) != 0)
                return -EIO;
        }
    }
    if (child != NULL) {
        fprintf(stderr, "dentry has no enough data blocks\n");
        return -EFBIG;
    }
    return 0;
}
目录树的修改
这里需要三个函数:detach_parent 把 dentry 从父目录摘除(同时更新父 inode 的 dir_cnt 和容量);attach_parent 把 dentry 挂到新父目录下并维护父 inode 计数;drop_dentry 递归释放目录树(对文件真正回收 inode 与数据块,对目录先递归处理子项)。
/**
 * @brief 传入 dentry 指针,将其从父 dentry 剥离,父 inode 的 disk size 和 disk
 * dir cnt 都会减少,自动更新父inode分配的数据块数量
 *
 * @param dentry 传入 dentry 指针
 * @return 成功返回 0,否则返回 -1
 */
int detach_parent(struct newfs_dentry* dentry)
{
    if (dentry == NULL) {
        return -EINVAL;
    }
    if (dentry->parent == NULL) {
        fprintf(stderr, "Failed to find its parent!\n");
        return -EINVAL;
    }
    // 把自己从父项分出去
    struct newfs_dentry* parent = dentry->parent;
    if (parent != NULL) {
        if (parent->child == dentry) {
            parent->child = dentry->next;
        } else {
            struct newfs_dentry* prev = parent->child;
            while (prev && prev->next != dentry)
                prev = prev->next;
            if (prev == NULL) {
                fprintf(stderr, "Parent failed to find this dentry!\n");
                return -EIO;
            }
            prev->next = dentry->next;
        }
        parent->inode->disk.dir_cnt--;
        parent->inode->disk.size -= sizeof(struct newfs_dentry_d);
    }
    dentry->parent = NULL;
    return adapt_datablock_alloc(parent->inode);
}

/**
 * @brief 传入无 parent dentry 指针,将添加到父 dentry,父 inode 的 disk size 和
 * disk dir cnt 都会增加,自动更新父inode分配的数据块数量
 *
 * @param dentry 传入 dentry 指针
 * @return 成功返回 0
 */
int attach_parent(struct newfs_dentry* parent_dentry, struct newfs_dentry* dentry)
{
    if (dentry == NULL || parent_dentry == NULL) {
        return -EINVAL;
    }
    if (dentry->parent != NULL) {
        fprintf(stderr, "Parent exists!\n");
        return -EINVAL;
    }
    // 把自己添加到父 dentry
    dentry->parent = parent_dentry;
    dentry->next = parent_dentry->child;
    parent_dentry->child = dentry;
    parent_dentry->inode->disk.dir_cnt++;
    parent_dentry->inode->disk.size += sizeof(struct newfs_dentry_d);
    return adapt_datablock_alloc(parent_dentry->inode);
}

/**
 * @brief
 * 从一个索引结点下,删除一个指定的目录项。在删除一个文件或目录时,先删除其本身的索引结点,再从父目录移除目录项。
 *
 * @param dentry 传入 dentry 指针
 * @return 成功返回 0
 */
int drop_dentry(struct newfs_dentry* dentry)
{
    if (dentry == NULL)
        return -EINVAL;
    int ret = 0;
    // 对于目录,让子项自己把自己分离出去,然后目录自己再从父项分出去
    if (dentry->disk.ftype == NEWFS_DIR) {
        struct newfs_dentry* child = dentry->child;
        while (child) {
            struct newfs_dentry* next = child->next;
            if ((ret = drop_dentry(child)) != 0) {
                return ret;
            }
            child = next;
        }
    }
    // 把自己从父项分出去
    if (dentry->parent)
        if ((ret = detach_parent(dentry)) != 0) {
            return ret;
        }
    // 检查是否需要释放 inode
    if (dentry->inode == NULL) {
        free(dentry);
        return 0;
    }
    if (dentry->inode->disk.link > 1){
        dentry->inode->disk.link--;
        free(dentry);
        return 0;
    }
    if ((ret = free_inode(dentry->inode)) != 0) {
        fprintf(stderr, "Free inode failed!\n");
        return ret;
    }
    // 释放自己
    free(dentry);
    return 0;
}
给定目录获取/创建 dentry
get_parent_dentry 从路径中拆出父目录和最后一级名字;get_dentry 递归解析整条路径;get_dentry_create 是给 mkdir / mknod / link 用的封装:在父目录下创建新 dentry(可选分配 inode),并维护父 inode 的计数与数据块。
/**
 * @brief 给定目录,返回其父目录的 dentry,比如 /a/b/c 返回 /a/b 的 entry,name
 * 返回 c
 *
 * @param path 目录字符串
 * @param parent 返回父目录的 dentry 的指针,应传入空指针的地址
 * @param name 返回最后一级文件/目录的名字
 * @return 成功返回 0,出错返回错误码
 */
int get_parent_dentry(const char* path, struct newfs_dentry** parent, char* name)
{
    if (path == NULL || parent == NULL || name == NULL)
        return -EINVAL;
    if (path[0] != '/')
        return -EINVAL;
    // 从字符串末尾开始找指定字符,返回最后一次出现的位置。
    const char* last_slash = strrchr(path, '/');
    if (last_slash == NULL)
        return -EINVAL;
    // 提取最后一级名字
    if (*(last_slash + 1) == '\0')
        return -EINVAL;
    if (strlen(last_slash + 1) >= MAX_NAME_LEN)
        return -EINVAL;
    strcpy(name, last_slash + 1);
    // 提取父目录路径
    char pathbuf[MAX_NAME_LEN * 4];
    unsigned int parent_len = last_slash - path;
    if (parent_len == 0) {
        strcpy(pathbuf, "/");
    } else {
        if (parent_len >= sizeof(pathbuf)) // 目录过长
            return -EINVAL;
        memmove(pathbuf, path, parent_len);
        pathbuf[parent_len] = '\0';
    }
    return get_dentry(pathbuf, parent);
}
/**
 * @brief 给定目录,返回目录的 dentry
 *
 * @param path 目录字符串
 * @param dentry 返回目录的 dentry,应传入空指针
 * @return 成功返回 0,出错返回错误码
 */
int get_dentry(const char* path, struct newfs_dentry** dentry)
{
    if (path == NULL || dentry == NULL)
        return -EINVAL;
    if (path[0] != '/')
        return -EINVAL;
    *dentry = NULL;
    struct newfs_dentry* pointer = &root;
    // 解析目录
    char* p1 = (char*)path;
    while (1) {
        // 跳过 '/'
        while (*p1 == '/')
            p1++;
        if (*p1 == '\0')
            break;
        // 找到当前 component 的结尾
        char* p2 = p1;
        unsigned int length = 0;
        while (*p2 != '/' && *p2 != '\0') {
            length++;
            p2++;
        }
        if (length >= MAX_NAME_LEN)
            return -EINVAL;
        char namebuf[MAX_NAME_LEN];
        memset(namebuf, 0, sizeof(namebuf));
        memmove(namebuf, p1, length);
        // 当前 pointer 必须是目录
        if (pointer->inode->disk.ftype != NEWFS_DIR)
            return -ENOTDIR;
        // 在 child 链表中寻找 namebuf
        struct newfs_dentry* child = pointer->child;
        // search in directory
        while (child != NULL) {
            if (strcmp(child->disk.name, namebuf) == 0)
                break;
            child = child->next;
        }
        if (child == NULL)
            return -ENOENT;
        pointer = child;
        p1 = p2;
    }
    *dentry = pointer;
    return 0;
}

/**
 * @brief 给定目录,创建目录的 dentry,要求父 dentry 存在,并且子结点应该不存在
 *
 * @param path 目录字符串
 * @param dentry 返回目录的 dentry,应传入空指针
 * @param ftype 输入要创建的文件类型
 * @param need_inode 是否分配 inode,输入0则返回不带 inode 的 dentry
 * @return 成功返回 0,出错返回错误码
 */
int get_dentry_create(const char* path, struct newfs_dentry** dentry, FILE_TYPE ftype, int need_inode)
{
    if (dentry == NULL)
        return -EINVAL;
    if (*dentry != NULL)
        return -EINVAL;
    struct newfs_dentry* parent = NULL;
    (*dentry) = malloc(sizeof(struct newfs_dentry));
    struct newfs_dentry* new_dentry = (*dentry);
    if (new_dentry==NULL) {
        return -ENOMEM;
    }
    int ret = 0;
    if ((ret = get_parent_dentry(path, &parent, new_dentry->disk.name)) != 0) {
        free(new_dentry);
        return ret;
    }
    if (parent->inode->disk.ftype != NEWFS_DIR) {
        free(new_dentry);
        return -ENOTDIR;
    }
    // 检查重名
    struct newfs_dentry* child = parent->child;
    while (child != NULL) {
        if (strcmp(child->disk.name, new_dentry->disk.name) == 0) {
            free(new_dentry);
            return -EEXIST;
        }
        child = child->next;
    }
    new_dentry->parent = NULL;
    new_dentry->child = NULL;
    new_dentry->inode = NULL;
    new_dentry->next = NULL;
    new_dentry->disk.ftype = ftype;
    new_dentry->disk.ino = -1;
    if ((ret = attach_parent(parent, new_dentry)) != 0) {
        free(*dentry);
        return ret;
    }
    if (need_inode==0) {
        return 0;
    }
    struct newfs_inode* new_inode = malloc(sizeof(struct newfs_inode));
    if (new_inode==NULL) {
        return -ENOMEM;
    }
    if ((ret = alloc_inode(new_inode, ftype)) != 0) {
        drop_dentry(new_dentry);
        return ret;
    }
    if ((ret = adapt_datablock_alloc(new_inode)) != 0) {
        drop_dentry(new_dentry);
        return ret;
    }
    new_dentry->inode = new_inode;
    new_dentry->disk.ino = new_inode->disk.ino;
    return 0;
}
钩子函数
钩子函数位于 src/newfs.c,负责把 FUSE 的请求翻译成上面这些工具函数。必做部分只需要实现 mount/destroy/mkdir/getattr/readdir/mknod 六个钩子。
操作表
把所有钩子注册到 struct fuse_operations(必做 + 附加题一):
static struct fuse_operations operations = {.init = newfs_init,       /* mount文件系统 */
                                            .destroy = newfs_destroy, /* umount文件系统 */
                                            .mkdir = newfs_mkdir,     /* 建目录,mkdir */
                                            .getattr = newfs_getattr, /* 获取文件属性,类似stat,必须完成 */
                                            .readdir = newfs_readdir, /* 填充dentrys */
                                            .mknod = newfs_mknod,     /* 创建文件,touch相关 */
                                            .write = newfs_write,            /* 写入文件 */
                                            .read = newfs_read,       /* 附加题一:未完成时返回 ENOSYS */
                                            .utimens = newfs_utimens, /* 修改时间,忽略,避免touch报错 */
                                            .truncate = newfs_truncate,         /* 改变文件大小 */
                                            .link = newfs_link,                 /* 硬链接 */
                                            .unlink = newfs_unlink,           /* 删除文件 */
                                            .rmdir = newfs_rmdir,            /* 删除目录, rm -r */
                                            .rename = newfs_rename,           /* 重命名,mv */

                                            .open = newfs_open,
                                            .opendir = newfs_opendir,
                                            .access = newfs_access};
挂载
挂载时打开 ddriver 设备并读取超级块。通过超级块中的 magic 判断是不是第一次挂载:第一次挂载需要初始化超级块、位图和根目录,否则直接从磁盘恢复 inode 与整个目录树。
/**
 * @brief 挂载(mount)文件系统
 *
 * @param conn_info 可忽略,一些建立连接相关的信息
 * @return void*
 */
void* newfs_init(struct fuse_conn_info* conn_info)
{
    int devfd = ddriver_open((char*)newfs_options.device);
    if (devfd < 0) {
        return NULL;
    }
    // 读取 super block 并通过检查 magic 判断是否为第一次挂载
    int first_mount = load_super(devfd);
    if (first_mount == 1) {
        init_root();
        return NULL;
    } else if (first_mount == 0) {
        load_root();
        return NULL;
    }
    fprintf(stderr, "Failed to load super!!\n");
    ddriver_close(super.fd);
    return NULL;
}
卸载
卸载时把内存中的目录树、超级块和位图写回磁盘,最后关闭设备。注意只有这些同步都成功才关闭设备,否则前一步失败会让超级块没有落盘。
/**
 * @brief 卸载(umount)文件系统
 *
 * @param p 可忽略
 * @return void
 */
void newfs_destroy(void* p)
{
    int ret;
    if ((ret = sync_hierarchy(&root)) != 0) {
        printf("something wrong with sync_hierarchy!, errno:%d\n", ret);
    }
    if ((ret = sync_super()) != 0) {
        printf("something wrong with sync_super!, errno:%d\n", ret);
        ddriver_close(super.fd);
        return;
    }
    ddriver_close(super.fd);
    return;
}
创建目录
创建目录需要从 path 中拆出父目录和最后一级名字,在父目录下检查重名之后申请 inode 和一个数据块(目录本身也要有一个数据块来放 dentry);如果父目录已经放不下新的 dentry,还要给父目录追加数据块。
/**
 * @brief 创建目录
 *
 * @param path 相对于挂载点的路径
 * @param mode 创建模式(只读?只写?),可忽略
 * @return int 0成功,否则返回对应错误号
 */
int newfs_mkdir(const char* path, mode_t mode)
{
    /* 解析路径,创建目录 */
    if (path == NULL || path[0] != '/')
        return -EINVAL;
    int ret;
    struct newfs_dentry* new_dentry = NULL;
    ret = get_dentry_create(path, &new_dentry, NEWFS_DIR, 1);
    if (ret < 0) {
        return ret;
    }
    // 同步目录到磁盘
    if ((ret = sync_hierarchy(new_dentry->parent)) != 0) {
        drop_dentry(new_dentry);
        return ret;
    }
    return 0;
}
获取文件属性
getattr 是最重要的钩子之一,ls、stat 都依赖它。先解析路径拿到 dentry,再按 inode 中的类型填充 st_mode,同时把大小、链接数、块大小等信息填好。
/**
 * @brief 获取文件或目录的属性,该函数非常重要
 *
 * @param path 相对于挂载点的路径
 * @param newfs_stat 返回状态
 * @return int 0成功,否则返回对应错误号
 */
int newfs_getattr(const char* path, struct stat* newfs_stat)
{
    if (path == NULL || newfs_stat == NULL)
        return -EINVAL;

    struct newfs_dentry* dentry = NULL;
    if (get_dentry(path, &dentry) != 0)
        return -ENOENT;

    memset(newfs_stat, 0, sizeof(struct stat));

    if (dentry->inode->disk.ftype == NEWFS_DIR)
        newfs_stat->st_mode = NEWFS_DEFAULT_PERM | S_IFDIR;
    else
        newfs_stat->st_mode = NEWFS_DEFAULT_PERM | S_IFREG;

    newfs_stat->st_size = dentry->inode->disk.size;
    newfs_stat->st_nlink = dentry->inode->disk.link;
    newfs_stat->st_uid = getuid();
    newfs_stat->st_gid = getgid();
    newfs_stat->st_blksize = super.disk.sz_io;
    newfs_stat->st_blocks = dentry->inode->block_number * NEWFS_BLOCK_SIZE / super.disk.sz_io;
    newfs_stat->st_ino = dentry->inode->disk.ino;
    return 0;
}
遍历目录
readdir 把目录 dentry 链表中的子项依次通过 filler 交给 FUSE,offset 表示从第几个目录项开始,方便内核分批读取。
/**
 * @brief 遍历目录项,填充至buf,并交给FUSE输出
 *
 * @param path 相对于挂载点的路径
 * @param buf 输出buffer
 * @param filler 参数讲解:
 *
 * typedef int (*fuse_fill_dir_t) (void *buf, const char *name,
 *              const struct stat *stbuf, off_t off)
 * buf: name会被复制到buf中
 * name: dentry名字
 * stbuf: 文件状态,可忽略
 * off: 下一次offset从哪里开始,这里可以理解为第几个dentry
 *
 * @param offset 第几个目录项?
 * @param fi 可忽略
 * @return int 0成功,否则返回对应错误号
 */
int newfs_readdir(const char* path, void* buf, fuse_fill_dir_t filler, off_t offset, struct fuse_file_info* fi)
{
    struct newfs_dentry* dentry = NULL;
    if (path == NULL || path[0] != '/')
        return -EINVAL;
    int ret = 0;
    if ((ret = get_dentry(path, &dentry)) != 0)
        return ret;
    if (dentry->inode->disk.ftype != NEWFS_DIR)
        return -ENOTDIR;
    struct newfs_dentry* child = dentry->child;
    // 跳过 offset 个 dentry
    for (off_t i = 0; i < offset && child != NULL; i++)
        child = child->next;
    while (child != NULL) {
        if (filler(buf, child->disk.name, NULL, offset + 1) != 0)
            break;
        offset++;
        child = child->next;
    }
    return 0;
}
创建文件
mknod 和 mkdir 的流程基本一致,区别是文件只需要 inode、不需要分配数据块(touch 创建的就是空文件)。
/**
 * @brief 创建文件
 *
 * @param path 相对于挂载点的路径
 * @param mode 创建文件的模式,可忽略
 * @param dev 设备类型,可忽略
 * @return int 0成功,否则返回对应错误号
 */
int newfs_mknod(const char* path, mode_t mode, dev_t dev)
{
    /* 解析路径,并创建相应的文件 */
    if (path == NULL || path[0] != '/')
        return -EINVAL;
    int ret;
    struct newfs_dentry* new_dentry = NULL;
    ret = get_dentry_create(path, &new_dentry, NEWFS_FILE, 1);
    if (ret < 0) {
        return ret;
    }
    // 同步目录到磁盘
    if ((ret = sync_hierarchy(new_dentry->parent)) != 0) {
        drop_dentry(new_dentry);
        return ret;
    }
    return 0;
}
附加题一:扩展功能
在必做部分之上,把普通文件系统的核心操作补齐:read / write / truncate、unlink / rmdir、rename(mv)、link(硬链接 + nlink),以及 open / opendir / access。这样 cat、cp、mv、rm -r、ln、truncate 这些命令就能直接作用在挂载点里。
文件读写与 truncate
newfs_write 在写入范围超过文件当前大小时先调用 newfs_truncate 扩块,再按逻辑块逐块写入(整块直接写,非整块先读出再合并);newfs_read 按逻辑块读出并拷贝到用户 buf,不足一块的尾部单独处理。newfs_truncate 通过 adapt_datablock_alloc 按新大小增删数据块,扩大时把尾部区域补 0。
/**
 * @brief 写入文件
 *
 * @param path 相对于挂载点的路径
 * @param buf 写入的内容
 * @param size 写入的字节数
 * @param offset 相对文件的偏移
 * @param fi 可忽略
 * @return int 写入大小
 */
int newfs_write(const char* path, const char* buf, size_t size, off_t offset, struct fuse_file_info* fi)
{
    if (offset < 0)
        return -EINVAL;
    int ret;
    struct newfs_dentry* dentry = NULL;
    if ((ret = get_dentry(path, &dentry)) != 0)
        return -ENOENT;
    if (dentry->inode->disk.ftype != NEWFS_FILE)
        return -EISDIR;

    // offset + size > 当前文件大小,此时需要分配新的 data block,并扩大 inode->disk.size。
    off_t new_size = offset + size;
    if (new_size > dentry->inode->disk.size) {
        ret = newfs_truncate(path, new_size);
        if (ret != 0)
            return ret;
    }
    size_t progress = 0; // 读取进度
    char read_buf[NEWFS_BLOCK_SIZE];
    while (progress < size) {
        unsigned int block_num = (offset + progress) / NEWFS_BLOCK_SIZE;
        unsigned int in_block_off = (offset + progress) % NEWFS_BLOCK_SIZE;
        unsigned int block_index = 0;
        if ((ret = get_block_pointer(dentry->inode, block_num)) < 0)    // 避免反复读 indirect block
            return ret;
        block_index = ret + super.disk.data_offset;
        unsigned int diff = (size - progress) > (NEWFS_BLOCK_SIZE - in_block_off)
                                ? NEWFS_BLOCK_SIZE - in_block_off // 逻辑块剩下的部分都写进去
                                : size - progress;                // 逻辑块剩下的部分留了一点
        if (in_block_off == 0 && diff == NEWFS_BLOCK_SIZE) {
            // 整块可以直接写入
            if ((ret = write_logical_block(block_index, (char *)(buf + progress))) != 0)
                return ret;
        } else {
            // 必须读出来原来的再写入
            if ((ret = read_logical_block(block_index, read_buf)) != 0)
                return ret;
            memmove(read_buf + in_block_off, (char *)(buf + progress), diff);
            if ((ret = write_logical_block(block_index, read_buf)) != 0)
                return ret;
        }
        progress += diff;
    }
    return progress;
}
/**
 * @brief 读取文件
 *
 * @param path 相对于挂载点的路径
 * @param buf 读取的内容
 * @param size 读取的字节数
 * @param offset 相对文件的偏移
 * @param fi 可忽略
 * @return int 读取大小
 */
int newfs_read(const char* path, char* buf, size_t size, off_t offset, struct fuse_file_info* fi)
{
    /* 附加题一:完成普通文件读取,供 FUSE 和附加题复用。 */
    if (offset < 0)
        return -EINVAL;
    int ret;
    struct newfs_dentry* dentry = NULL;
    if ((ret = get_dentry(path, &dentry)) != 0)
        return ret;
    if (dentry->inode->disk.ftype != NEWFS_FILE)
        return -EISDIR;
    if (offset >= dentry->inode->disk.size)
        return 0;
    if (offset + size > dentry->inode->disk.size)
        size = dentry->inode->disk.size - offset;

    size_t progress = 0; // 读取进度
    char read_buf[NEWFS_BLOCK_SIZE];
    while (progress < size) {
        unsigned int block_num = (offset + progress) / NEWFS_BLOCK_SIZE;
        unsigned int in_block_off = (offset + progress) % NEWFS_BLOCK_SIZE;
        unsigned int block_index = 0;
        if ((ret = get_block_pointer(dentry->inode, block_num)) < 0)
            return ret;
        block_index = ret + super.disk.data_offset;
        if ((ret = read_logical_block(block_index, read_buf)) != 0)
            return ret;
        unsigned int diff =
            (size - progress) > (NEWFS_BLOCK_SIZE - in_block_off) ? NEWFS_BLOCK_SIZE - in_block_off : size - progress;
        memmove(buf + progress, read_buf + in_block_off, diff);
        progress += diff;
    }
    return progress;
}
/**
 * @brief 改变文件大小
 *
 * @param path 相对于挂载点的路径
 * @param offset 改变后文件大小
 * @return int 0成功,否则返回对应错误号
 */
int newfs_truncate(const char* path, off_t offset)
{
    struct newfs_dentry* dentry = NULL;
    if (get_dentry(path, &dentry) != 0)
        return -ENOENT;
    if (dentry->inode->disk.ftype != NEWFS_FILE)
        return -EISDIR;
    if (offset < 0)
        return -EINVAL;
    if (offset > (off_t)MAX_FILE_SIZE)
        return -ENOSPC;

    unsigned int original_size = dentry->inode->disk.size;
    unsigned int original_block_number = dentry->inode->block_number;
    if (offset == original_size)
        return 0;
    // 分配好数据块
    dentry->inode->disk.size = offset;
    int ret = adapt_datablock_alloc(dentry->inode);
    if (ret != 0) {
        return ret;
    }
    if (offset > original_size) {
        unsigned int tail_size = original_size % NEWFS_BLOCK_SIZE;
        // 原本末尾的 datablock 的数据要读出来重新写入以确保新的部分是0
        if (tail_size) {
            char buf[NEWFS_BLOCK_SIZE];
            if (read_data_block(dentry->inode, original_block_number - 1, buf) != 0) {
                return -EIO;
            }
            memset(buf + tail_size, 0, NEWFS_BLOCK_SIZE - tail_size);
             if (write_data_block(dentry->inode, original_block_number - 1, buf) != 0) {
                return -EIO;
            }
        }
    }
    if (sync_inode(dentry->inode) != 0)
        return -EIO;
    return 0;
}
文件与目录删除
unlink 和 rmdir 都通过 drop_dentry 完成:先从父目录摘掉目录项,再根据 nlink 决定是只减引用计数还是真正回收 inode 和数据块;目录会递归删除子项(对应指导书 1.2 中 rm -r 的思路)。
/**
 * @brief 删除文件
 *
 * @param path 相对于挂载点的路径
 * @return int 0成功,否则返回对应错误号
 */
int newfs_unlink(const char* path)
{
    struct newfs_dentry* dentry = NULL;
    if (get_dentry(path, &dentry) != 0)
        return -ENOENT;

    if (dentry->inode->disk.ftype != NEWFS_FILE)
        return -EISDIR;
    struct newfs_dentry* parent = dentry->parent;
    if (drop_dentry(dentry) != 0)
        return -EIO;
    // 同步目录到磁盘
    if (sync_hierarchy(parent) != 0)
        return -EIO;
    return 0;
}
/**
 * @brief 删除目录
 *
 * 一个可能的删除目录操作如下:
 * rm ./tests/mnt/j/ -r
 *  1) Step 1. rm ./tests/mnt/j/j
 *  2) Step 2. rm ./tests/mnt/j
 * 即,先删除最深层的文件,再删除目录文件本身
 *
 * @param path 相对于挂载点的路径
 * @return int 0成功,否则返回对应错误号
 */
int newfs_rmdir(const char* path)
{
    struct newfs_dentry* dentry = NULL;
    if (get_dentry(path, &dentry) != 0)
        return -ENOENT;
    if (dentry->inode->disk.ftype != NEWFS_DIR)
        return -ENOTDIR;
    struct newfs_dentry* parent = dentry->parent;
    if (drop_dentry(dentry) != 0)
        return -EIO;
    // 同步目录到磁盘
    if (sync_hierarchy(parent) != 0)
        return -EIO;
    return 0;
}
重命名与移动
rename 覆盖三种情况:目标不存在(直接改名字/父目录);目标是已有目录(移动到该目录下,VFS 通常已经把 mv f0 d0/ 转成 /d0/f0);目标是普通文件(覆盖:对旧目标做 unlink 语义,复用目标目录项,源 inode 的 nlink 保持不变)。两个路径指向同一 inode 时按 POSIX 语义直接返回成功。
/**
 * @brief 重命名文件
 *
 * @param from 源文件路径
 * @param to 目标文件路径
 * @return int 0成功,否则返回对应错误号
 */
int newfs_rename(const char* from, const char* to)
{
    if (strcmp(from, to) == 0)
        return 0;
    int move = 0; // 0 for rename, 1 for move

    struct newfs_dentry* from_dentry = NULL;
    if (get_dentry(from, &from_dentry) != 0)
        return -ENOENT;
    struct newfs_dentry* to_dentry = NULL;
    // 判断 move or rename
    int ret = get_dentry(to, &to_dentry);
    if (ret != 0) {
        // to 可能不存在,尝试 rename,在新的路径创建文件/目录
        int ret = 0;
        if (from_dentry->disk.ftype == NEWFS_FILE) {
            ret = newfs_mknod(to, 0, 0);
            if (ret != 0)
                return ret;
        } else if (from_dentry->disk.ftype == NEWFS_DIR) {
            ret = newfs_mkdir(to, 0);
            if (ret == -EEXIST)
                move = 1;
            else if (ret != 0)
                return ret;
        }
        // 检查是否创建成功
        if (get_dentry(to, &to_dentry) != 0)
            return -ENOENT;
    } else {
        // to 存在,判断是不是目录,如果是,移动到该目录下
        if (to_dentry->disk.ino == from_dentry->disk.ino)
            return 0;
        if (to_dentry->disk.ftype == NEWFS_DIR) {
            move = 1;
        } else {
            move = 0;   // 覆盖

        }
    }

    struct newfs_dentry* parent1 = from_dentry->parent;
    struct newfs_dentry* parent2 = to_dentry->parent;

    if (detach_parent(from_dentry) != 0) { // from_entry 从父项中剥离
        printf("Something wrong with detach!\n");
        return -ENOENT;
    }

    if (move == 1) {
        // move 的情况下,直接把当前目录的 parent 修改到新目录下
        ret = attach_parent(to_dentry, from_dentry);
        if (ret < 0) {
            return ret;
        }
    } else {
        // rename 的情况下去掉新创建的目录/文件的 inode
        to_dentry->inode->disk.link--;
        if (to_dentry->inode->disk.link == 0) {
            if (free_inode(to_dentry->inode) != 0)
                return -EIO;
        }
        to_dentry->disk.ino = from_dentry->disk.ino;
        to_dentry->disk.ftype = from_dentry->disk.ftype;
        to_dentry->inode = from_dentry->inode;
        to_dentry->inode->disk.link++;  // 增加引用计数防止 inode 被释放
        to_dentry->child = from_dentry->child;
        // 移动 children
        struct newfs_dentry* child = from_dentry->child;
        while (child) {
            child->parent = to_dentry;
            child = child->next;
        }
        from_dentry->inode->disk.link--;
        free(from_dentry);
    }
    // 同步目录到磁盘
    if (sync_hierarchy(parent1) != 0)
        return -EIO;
    // 同步目录到磁盘
    if (sync_hierarchy(parent2) != 0)
        return -EIO;
    return 0;
}
硬链接
newfs_link 在目标父目录下新建一个 directory entry,直接指向源文件的 inode(不复制数据块),并把 nlink 加 1;unlink 时先减 nlink,只有减到 0 才真正回收 inode 与数据块。
/**
 * @brief 硬链接
 *
 * @param from 源路径
 * @param to 目标路径
 * @return int 0成功,否则返回对应错误号
 */
int newfs_link(const char* from, const char* to)
{
    struct newfs_dentry *from_dentry = NULL;
    int ret;
    if ((ret = get_dentry(from, &from_dentry)) != 0)
        return ret;
    if (from_dentry->disk.ftype != NEWFS_FILE)
        return -EPERM;
    struct newfs_dentry *to_dentry = NULL;
    if ((ret = get_dentry_create(to, &to_dentry, NEWFS_FILE, 0)) != 0)
        return ret;
    to_dentry->inode = from_dentry->inode;
    to_dentry->disk.ino = from_dentry->disk.ino;
    to_dentry->inode->disk.link++;
    // 同步目录到磁盘
    if ((ret = sync_inode(to_dentry->inode)) != 0) return ret;
    if ((ret = sync_hierarchy(to_dentry->parent)) != 0) return ret;
    return 0;
}
打开与访问
open / opendir 主要做路径与类型检查,access 用来判断路径是否存在(读写的权限检查交给 VFS 的默认行为)。
/**
 * @brief
 * 打开文件,可以在这里维护fi的信息,例如,fi->fh可以理解为一个64位指针,可以把自己想保存的数据结构
 * 保存在fh中
 *
 * @param path 相对于挂载点的路径
 * @param fi 文件信息
 * @return int 0成功,否则返回对应错误号
 */
int newfs_open(const char* path, struct fuse_file_info* fi)
{
    // 检查一下路径是否存在
    struct newfs_dentry* dentry = NULL;
    if (get_dentry(path, &dentry) != 0)
        return -ENOENT;

    if (dentry->inode->disk.ftype != NEWFS_FILE)
        return -EISDIR;
    return 0;
}
/**
 * @brief 打开目录文件
 *
 * @param path 相对于挂载点的路径
 * @param fi 文件信息
 * @return int 0成功,否则返回对应错误号
 */
int newfs_opendir(const char* path, struct fuse_file_info* fi)
{
    // 检查一下路径是否存在
    struct newfs_dentry* dentry = NULL;
    if (get_dentry(path, &dentry) != 0)
        return -ENOENT;

    if (dentry->inode->disk.ftype != NEWFS_DIR)
        return -EISDIR;
    return 0;
}
/**
 * @brief 访问文件,因为读写文件时需要查看权限
 *
 * @param path 相对于挂载点的路径
 * @param type 访问类别
 * R_OK: Test for read permission.
 * W_OK: Test for write permission.
 * X_OK: Test for execute permission.
 * F_OK: Test for existence.
 *
 * @return int 0成功,否则返回对应错误号
 */
int newfs_access(const char* path, int type)
{
    struct newfs_dentry* dentry = NULL;
    if (get_dentry(path, &dentry) != 0)
        return -ENOENT;
    return 0;
}
大文件支持
前面提到了这里设计的 inode 中有 6 个直接块指针和 5 个一级间接块指针,单个文件上限为 MAX_FILE_SIZE = (6 + 5 × 256) × 1KB ≈ 1.25MB:写满直接块后 alloc_datablock 会自动分配间接块,read_inode / create_hierarchy 在重挂载时也会把间接块里的指针读回来。
附加题一验收
bash tests/test.sh选E:读写 +cp,满分 34/34。- 手工验证:
ln后两个名字 inode 相同且nlink = 2;删掉其中一个名字后另一个仍可读、nlink减 1;mv改名/移动/覆盖正常;truncate缩小、清零、扩大结果正确;1MB 文件cmp一致;卸载重挂载后文件内容、目录结构和硬链接关系都保持不变。
附加题四:在自制 FS 上训练模型
目标是让整个训练流程的数据集、初始模型、训练后的 checkpoint 都放在自己实现的 newfs 里,并验证 1MB 级文件读写与重挂载持久化。这里直接使用教师 origin/model 分支提供的 MNIST 裁剪训练脚本(fs/template/tests/mtrain/)来测试。
环境准备
训练脚本依赖 PyTorch(CPU 版);默认 4MB 虚拟盘放不下约 11MB 的裁剪数据集,所以需要切到 80MB 的 ddriver(model 分支的 driver/user_ddriver 已把 CONFIG_DISK_SZ 设为 80MB、driver/ddriver.sh 的 BLOCK_COUNT 设为 163840)。
# 1) PyTorch(CPU)——系统 pip 是 externally-managed,用 venv
python3 -m venv ~/venv-torch
~/venv-torch/bin/pip install torch torchvision tqdm --index-url https://download.pytorch.org/whl/cpu

# 2) 80MB ddriver(model 分支的驱动)
cd driver/user_ddriver && make            # 安装 80MB 版 libddriver.a 到 ~/lib
rm -f ~/ddriver
dd if=/dev/zero of=~/ddriver bs=512 count=163840 status=none
cd ../.. && cd .. && rm -rf build && mkdir build && cd build && cmake .. && make
运行训练
cd ..
mkdir -p tests/mnt
./build/newfs -f ./tests/mnt &
cd tests && source ~/venv-torch/bin/activate && bash train.sh
train.sh 会依次运行 data_setup.py(把 MNIST 裁剪成 10 个 train / 10 个 test 子集写到 mnt/trimmed/)、model.py(初始权重写到 mnt/model/model.pth)、train.py(从 FS 读数据训练 5 个 epoch 并把权重写回 FS)。MNIST 原始数据会缓存在普通盘的 tests/mtrain/data 下,只有裁剪后的 .pt 和模型落在 newfs 上。
实测结果
训练结果如图
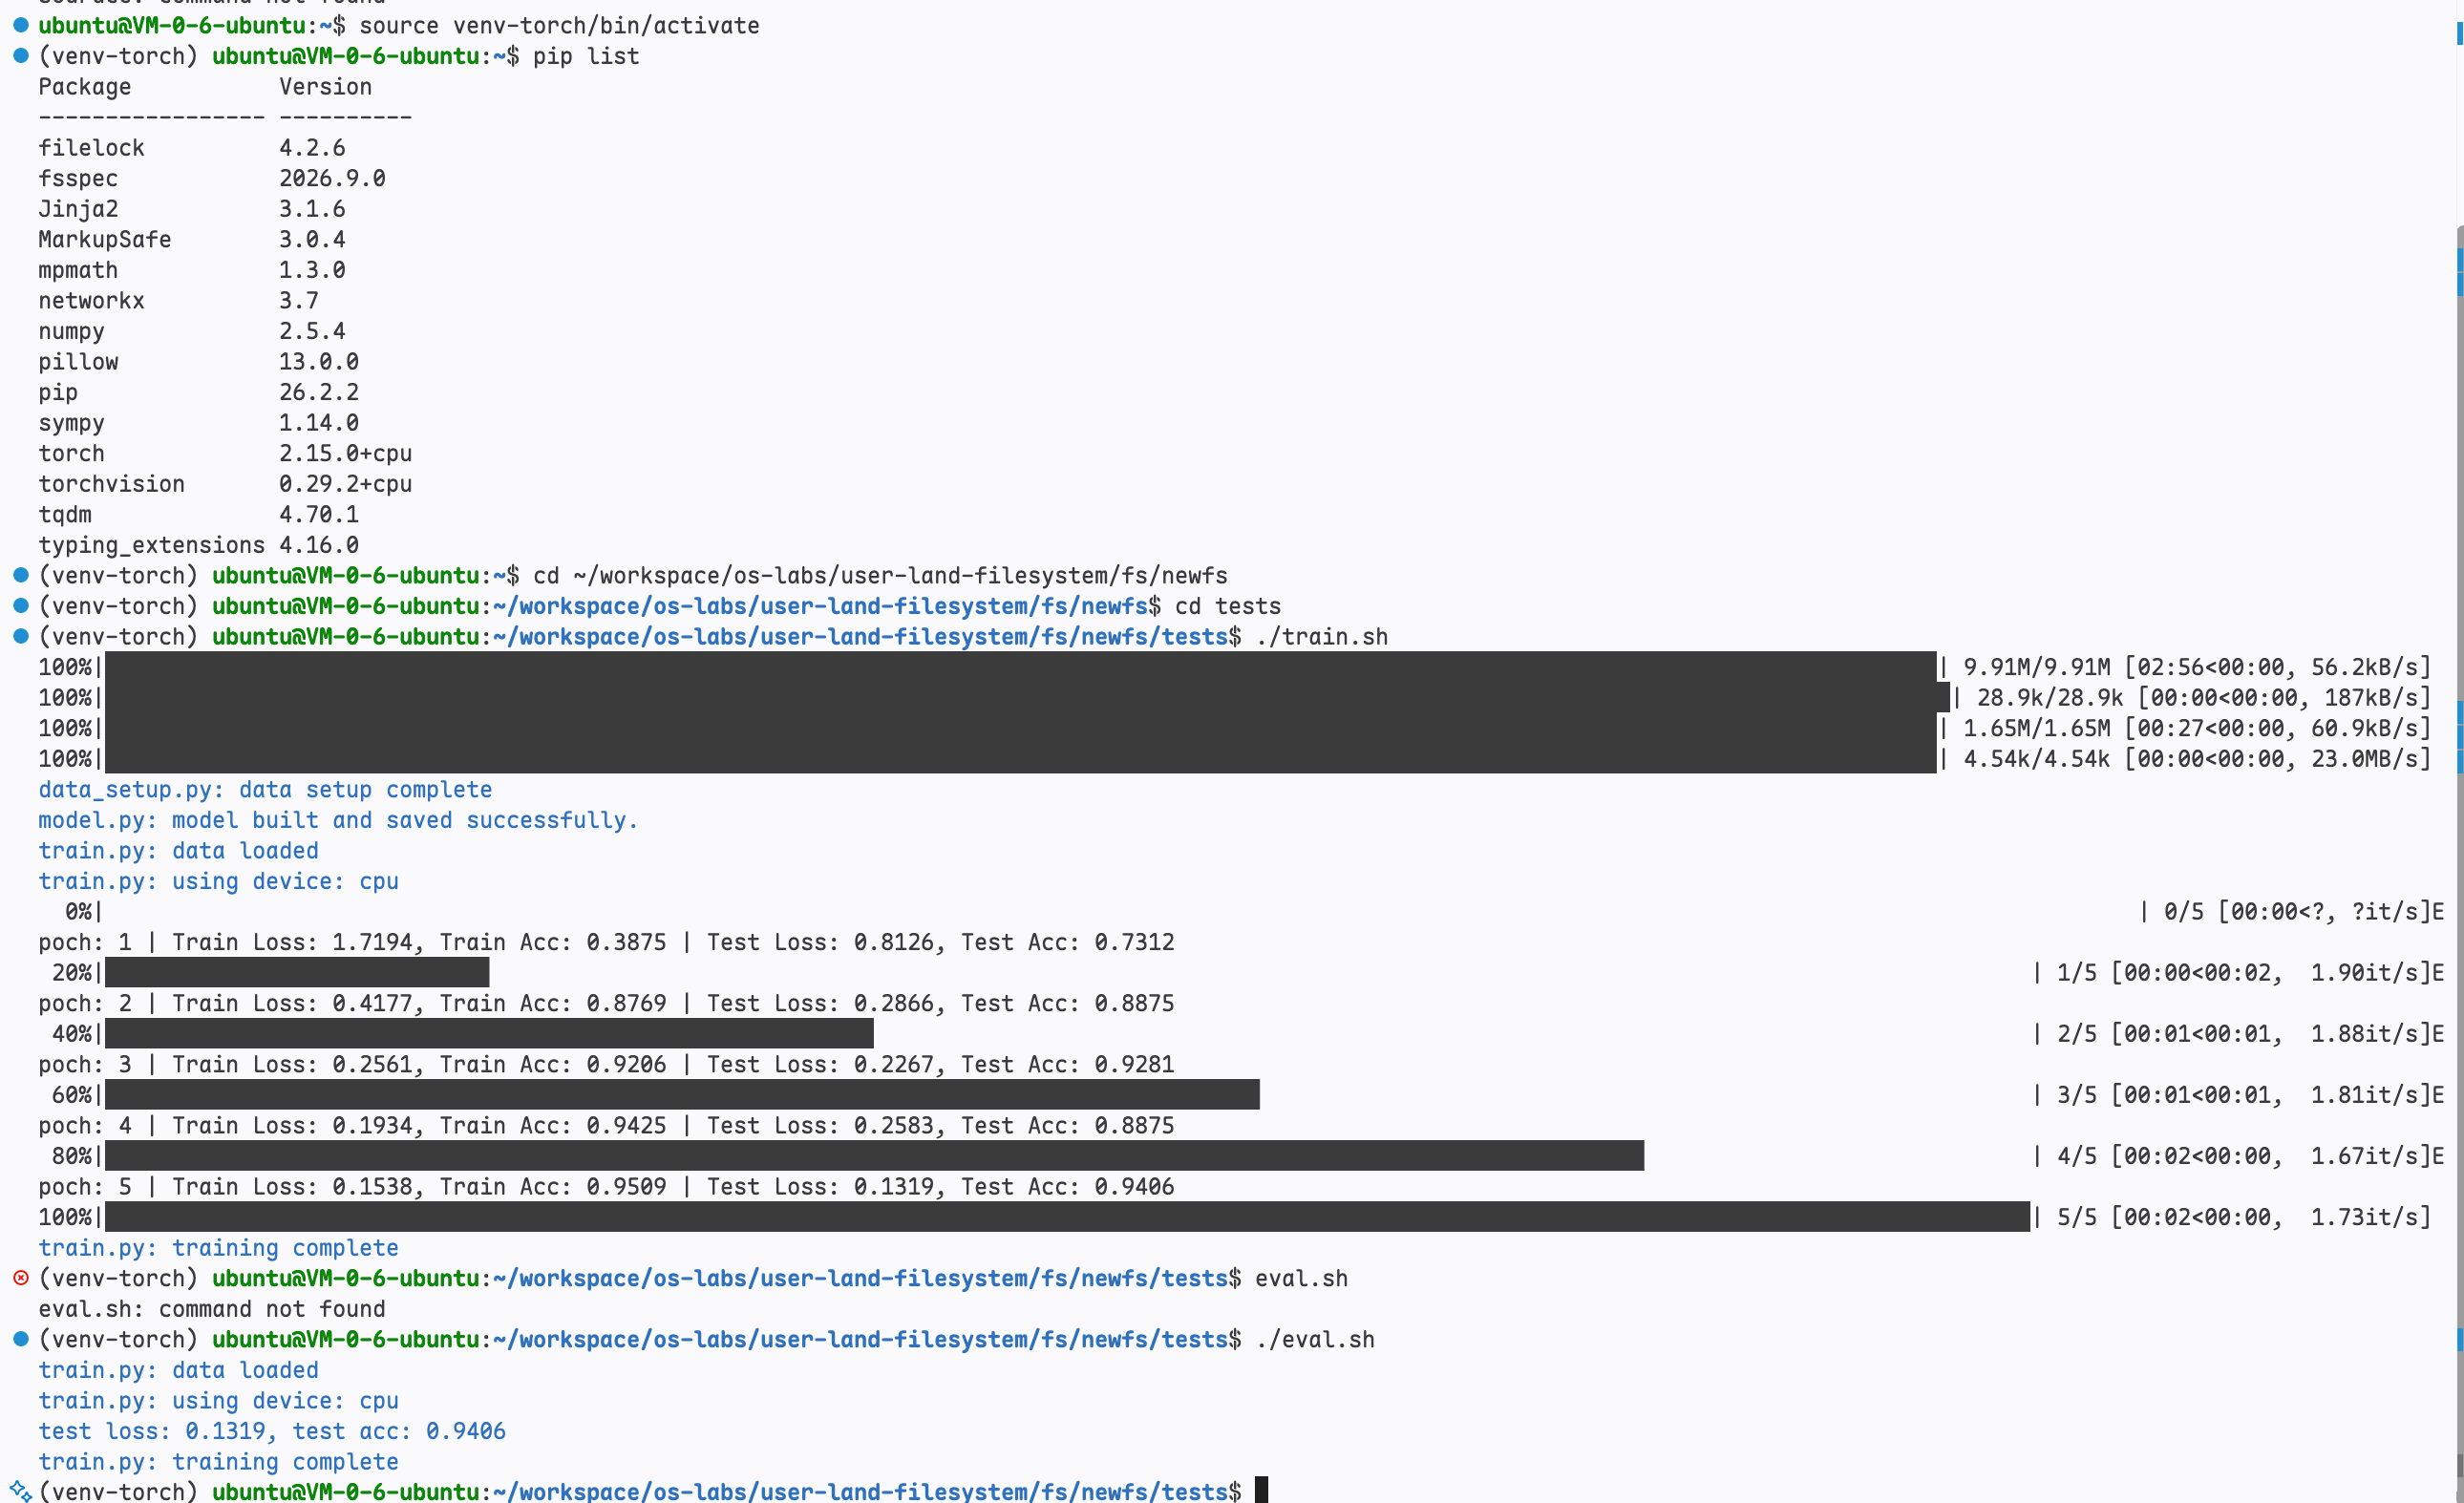
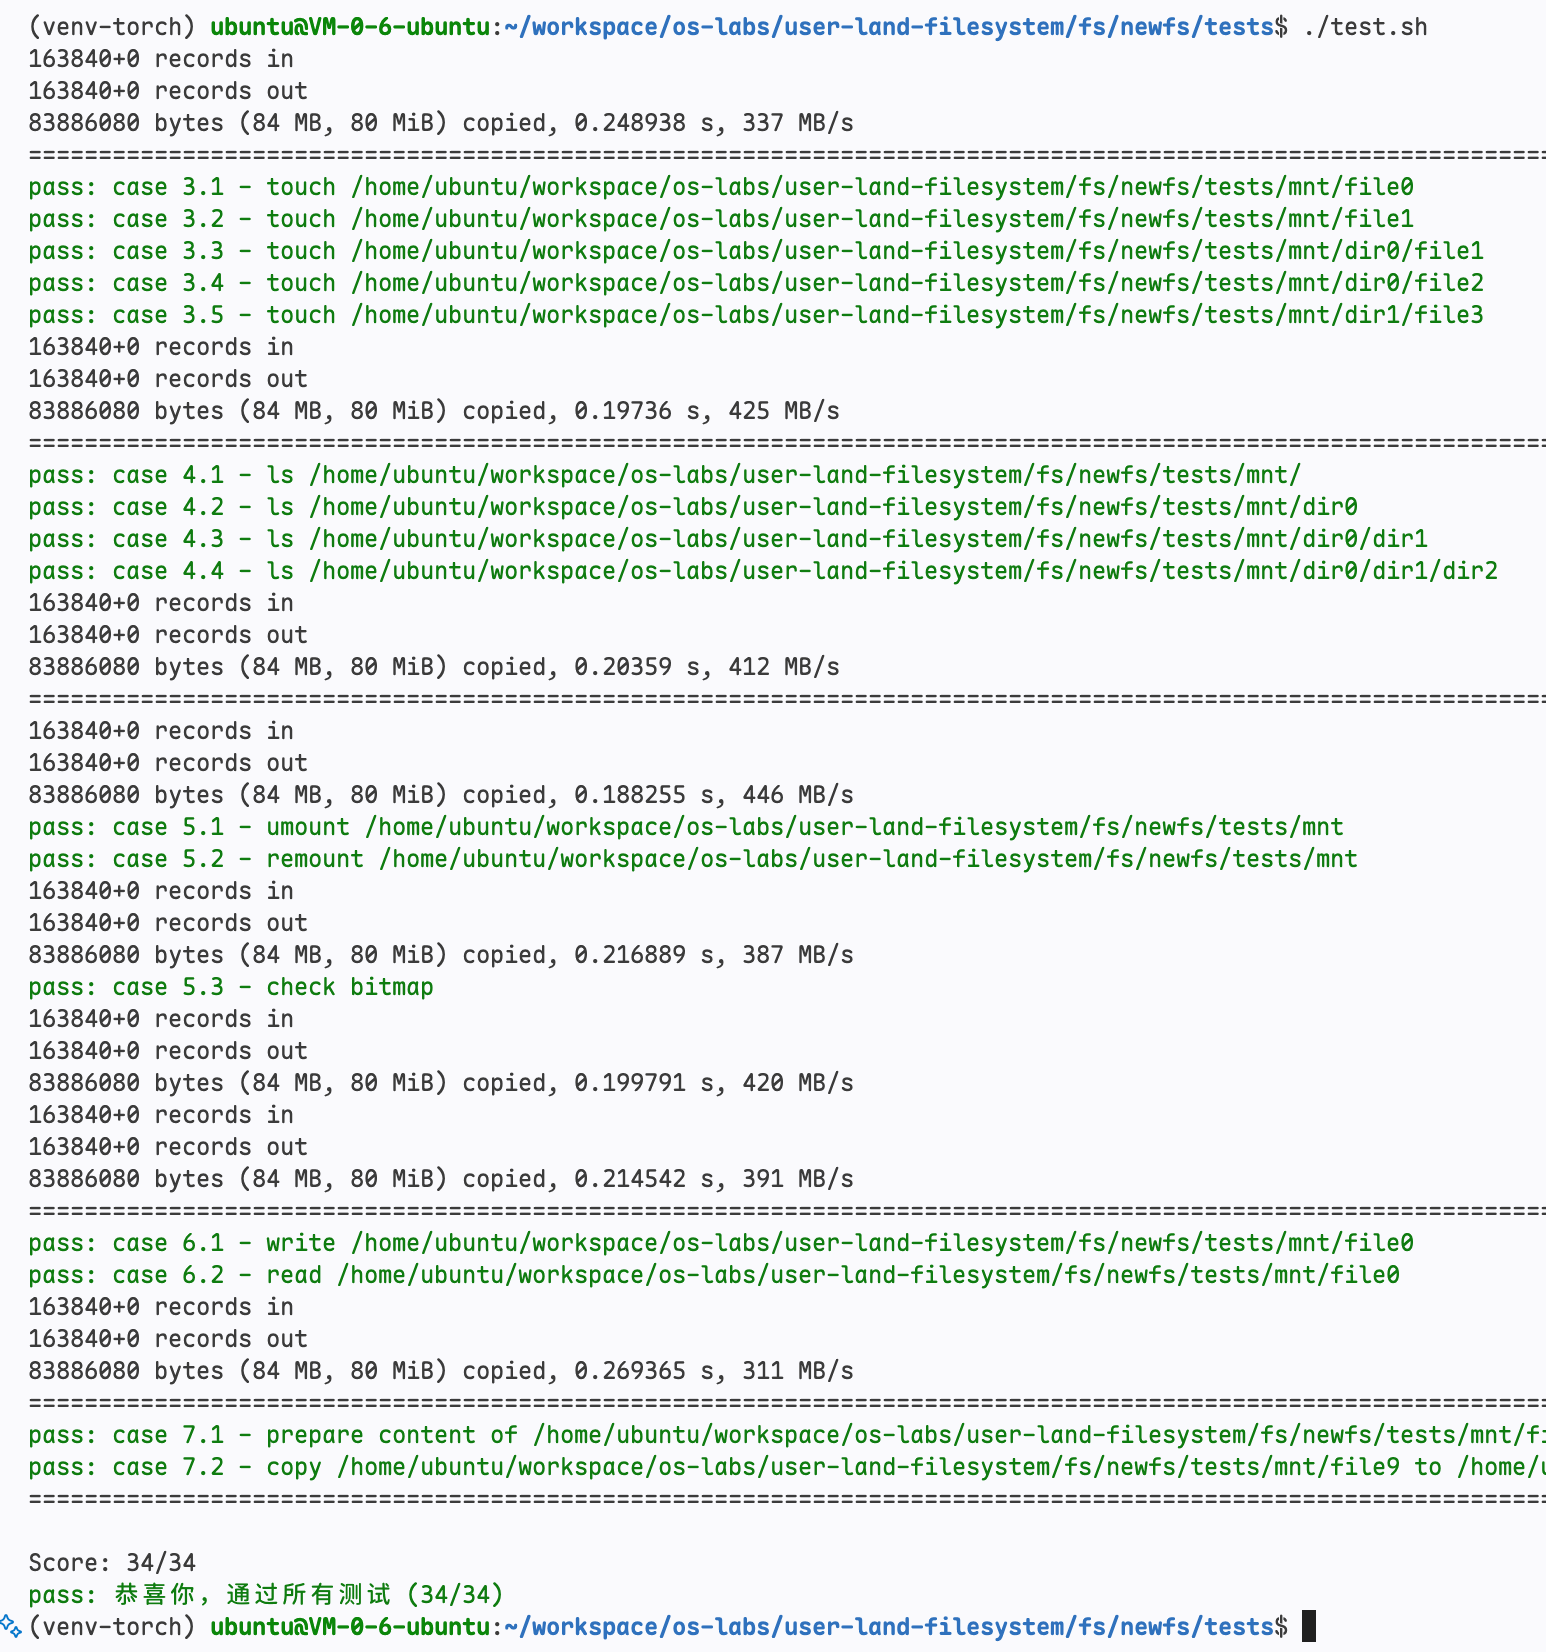
测试仍然是可以通过的
性能观察
真正训练(5 个 epoch)只用了约 4 秒;整个 train.sh 耗时约 3 分钟,说明绝大部分花在文件系统 I/O 上。功能上已经满足“在自制 FS 上训练模型”,瓶颈主要是 ddriver 的模拟延迟和单块读写,而不是模型本身。
编译与测试
编译方式与 fs/demo 一致:
# ..
mkdir -p build && cd build
cmake ..
make
挂载(参数依次是设备路径和挂载点):
# ..
mkdir -p tests/mnt
./build/newfs --device=$HOME/ddriver ./tests/mnt
测试脚本分两种用法:
# ../tests
chmod +x test.sh && ./test.sh
按提示输入测试方式:N 为基础功能测试(30 分),E 为带读写和 cp 的进阶测试(34 分),S 为分阶段测试。必做部分和附加题一的结果:
[N] Score: 30/30
[E] Score: 34/34
附加题二:CheckpointFS
这个附加题需要完成四个函数
static int copy_file(const char *source, const char *target);
int checkpointfs_create(const char *source, const char *id);
int checkpointfs_copy(const char *source, const char *source_id,
                      const char *target_id);
int checkpointfs_restore(const char *source, const char *hist_id,
                         const char *new_id);
Checkpoint FS 有两种基本操作
create: 创建检查点,复制当前工作文件为历史版本restore: 恢复检查点,复制历史检查点为新的检查点,并删除原来的文件路径,文件硬链接到当前检查点
假设执行 create /models/model.bin v0,那么
- 工作路径
/models/modle.bininode A - 历史检查点
/.checkpoints/models__model.bin/v0inode B
假设执行 restore /models/model.bin v0 resumed,那么
- 工作路径
/models/modle.bininode A 被删除,链接到 inode C - 历史检查点
/.checkpoints/models__model.bin/v0inode B - 新检查点
/.checkpoints/models__model.bin/resumedinode C 从 inode B 复制了一份
文件复制函数
假设 source 为 "/models/model.bin",target 为 "/.checkpoints/models__model.bin/v0" 那么 model.bin 的数据会复制到 v0 中
static int copy_file(const char *source, const char *target) {
    /* 按以下步骤实现通用文件独立复制(不在此函数内编码检查点路径或创建父目录):
     * Step 1: 调用自己的 newfs_getattr(source, &st) 检查源文件:
     *         若不存在直接返回对应负错误码;若不是普通文件(!S_ISREG(st.st_mode))返回 -EISDIR。
     * Step 2: 确认 target 尚不存在(避免覆盖已有文件),再调用 newfs_mknod(target, S_IFREG | 0644, 0)
     *         创建独立的目标文件 inode。
     * Step 3: 将 source 的全部字节(共 st.st_size 字节,含空文件和不足一块的尾部)复制到 target:
     *         - 方法 A:用固定大小缓冲区(如 4096 字节)循环调用自己的 newfs_read 和
     *           newfs_write(传入零初始化的 struct fuse_file_info fi = {0};),维护 offset;
     *         - 方法 B:直接在你自己的文件系统内部按数据块复制。
     *         注意:绝不能用硬链接代替复制!若步骤 3 中途出错,须先调用 newfs_unlink(target)
     *         清理本次新建的半成品文件,再返回负错误码。 */
    struct stat st;
    int ret = 0;
    CHECK(newfs_getattr(source, &st));
    if (!S_ISREG(st.st_mode)) {
        return -EISDIR;
    }
    struct stat st2;
    if ((ret = newfs_getattr(target, &st2) != -ENOENT)) {
        return -EEXIST;
    }
    CHECK(newfs_mknod(target, S_IFREG | 0644, 0));
    int progress = 0;
    char buf[4096];
    while (progress < st.st_size) {
        int slice_len = (st.st_size - progress) < 4096 ? (st.st_size - progress): 4096;
        ret = newfs_read(source, buf, slice_len, progress, NULL);
        if (ret < 0) {
            newfs_unlink(target);
            return ret;
        }
        ret = newfs_write(target, buf, slice_len, progress, NULL);
        if (ret < 0) {
            newfs_unlink(target);
            return ret;
        }
        progress += slice_len;
    }
    return 0;
}
创建、拷贝和恢复
假设 source 为 /models/model.bin, id 为 v0,那么 checkpointfs_create 会创建文件 /.checkpoints/models__model.bin/v0 并拷贝过去
/**
 * @brief 将当前工作文件保存为一个独立的历史检查点(对应命令 create FILE ID)
 *
 * @param source 工作文件的挂载内绝对路径(如 "/models/model.bin")
 * @param id 新检查点的名称(如 "v0")
 * @return int 成功返回 0,失败返回负错误码
 */
int checkpointfs_create(const char *source, const char *id) {
    /* 按以下步骤保存检查点:
     * Step 1: 声明局部路径缓冲区(长度 CHECKPOINTFS_PATH_MAX),调用
     *         CHECK(checkpointfs_path(source, id, ckpt_path, sizeof(ckpt_path))) 生成内部存储路径,
     *         再调用上方的 parent_path(ckpt_path, dir_path) 取得该文件专属的检查点集合目录。
     * Step 2: 固定的内部根目录 CHECKPOINTFS_STORAGE_DIR 已由教师控制层提前建好;
     *         你只需用 newfs_getattr 检查 dir_path 是否存在:
     *         - 若返回 -ENOENT,调用 newfs_mkdir(dir_path, 0755) 创建集合目录;
     *         - 若已存在但不是目录(!S_ISDIR),返回 -ENOTDIR。
     * Step 3: 调用 copy_file(source, ckpt_path) 将工作文件独立复制到检查点路径并返回结果。 */
    char ckpt_path[CHECKPOINTFS_PATH_MAX];
    int ret = 0;
    CHECK(checkpointfs_path(source, id, ckpt_path, sizeof(ckpt_path)));
    char dir_path[CHECKPOINTFS_PATH_MAX];
    parent_path(ckpt_path, dir_path);
    struct stat st;
    ret = newfs_getattr(dir_path, &st);
    if (ret == -ENOENT) {
        ret = newfs_mkdir(dir_path, 0755);
        if (ret != 0)
            return ret;
    } else if (ret == 0 && !S_ISDIR(st.st_mode)) {
        return -ENOTDIR;
    } else if (ret != 0) {
        // unknown situation
        return ret;
    }
    CHECK(copy_file(source, ckpt_path));
    return 0;
}
假设 source 为 /models/model.bin, source_id 为 v0, target_id 为 v1,那么 checkpointfs_copy 会复制文件内容 /.checkpoints/models__model.bin/v0 到 checkpoints/models__model.bin/v1
/**
 * @brief 在同一工作文件的检查点集合内,将已有检查点 source_id 独立复制为新检查点 target_id
 *
 * @param source 工作文件路径(用于确定检查点所属集合,切勿传入隐藏的内部路径)
 * @param source_id 已有的源检查点名称
 * @param target_id 新的目标检查点名称(不得覆盖已有检查点)
 * @return int 成功返回 0,失败返回负错误码
 */
int checkpointfs_copy(const char *source, const char *source_id,
                      const char *target_id) {
    /* 按以下步骤复制同一集合内的检查点(不改动工作文件 source):
     * Step 1: 声明两个长度为 CHECKPOINTFS_PATH_MAX 的局部路径缓冲区,以同一个 source 为第一个参数,
     *         分别调用 checkpointfs_path(source, source_id, ...) 和 checkpointfs_path(source, target_id, ...)
     *         得到源检查点和目标检查点的内部真实路径。
     * Step 2: 直接调用 copy_file(src_ckpt_path, dst_ckpt_path) 完成独立复制并返回结果。 */
    char src_ckpt_path[CHECKPOINTFS_PATH_MAX];
    char dst_ckpt_path[CHECKPOINTFS_PATH_MAX];
    CHECK(checkpointfs_path(source, source_id, src_ckpt_path, CHECKPOINTFS_PATH_MAX));
    CHECK(checkpointfs_path(source, target_id, dst_ckpt_path, CHECKPOINTFS_PATH_MAX));
    CHECK(copy_file(src_ckpt_path, dst_ckpt_path));
    return 0;
}
假设 source 为 /models/model.bin, hist_id 为 v0, new_id 为 resumed,那么 checkpointfs_restore 会复制文件内容 /.checkpoints/models__model.bin/v0 到 checkpoints/models__model.bin/resumed 然后删除原本的 /models/model.bin 并且将 /models/model.bin 链接到 checkpoints/models__model.bin/resumed 的 inode
/**
 * @brief 将历史检查点独立复制为新检查点,再让工作路径通过硬链接指向新检查点
 *        (对应命令 restore FILE HIST_CHECKPOINT NEW_CHECKPOINT)
 *
 * @param source 工作文件路径(如 "/models/model.bin")
 * @param hist_id 已有的历史检查点名称(如 "v0",恢复后其历史内容保持不变)
 * @param new_id 新生成的检查点名称(如 "resumed",恢复后与工作文件共享同一个 inode)
 * @return int 成功返回 0,失败返回负错误码
 * @note 恢复前未显式 create 保存的旧工作内容会被丢弃;即使工作文件当前已与 hist_id 同 inode,也必须复制出独立的新检查点。
 */
int checkpointfs_restore(const char *source, const char *hist_id,
                         const char *new_id) {
    /* 按以下步骤安全恢复工作文件:
     * Step 1: 调用 newfs_getattr(source, &st) 检查工作文件 source 是否存在且为普通文件
     *         (若为目录返回 -EISDIR,不存在则返回对应错误码,不要在 source 非法时创建新检查点)。
     * Step 2: 调用 CHECK(checkpointfs_copy(source, hist_id, new_id)) 将历史检查点独立复制为新检查点;
     *         若 hist_id 不存在或 new_id 已存在,此处会直接返回错误,工作文件 source 保持不变。
     * Step 3: 用 checkpointfs_path(source, new_id, new_ckpt_path, sizeof(new_ckpt_path)) 取得新检查点路径,
     *         先调用 CHECK(newfs_unlink(source)) 移除旧工作路径目录项,
     *         再调用 newfs_link(new_ckpt_path, source) 让工作路径硬链接到新检查点。 */
    struct stat st;
    CHECK(newfs_getattr(source, &st));
    if (!S_ISREG(st.st_mode)) {
        return -EISDIR;
    }
    CHECK(checkpointfs_copy(source, hist_id, new_id));
    char new_ckpt_path[CHECKPOINTFS_PATH_MAX];
    CHECK(checkpointfs_path(source, new_id, new_ckpt_path, sizeof(new_ckpt_path)));
    CHECK(newfs_unlink(source));
    CHECK(newfs_link(new_ckpt_path, source));
    return 0;
}
测试
# user-land-filesystem 目录下执行
bash ../tests/test.sh checkpoint
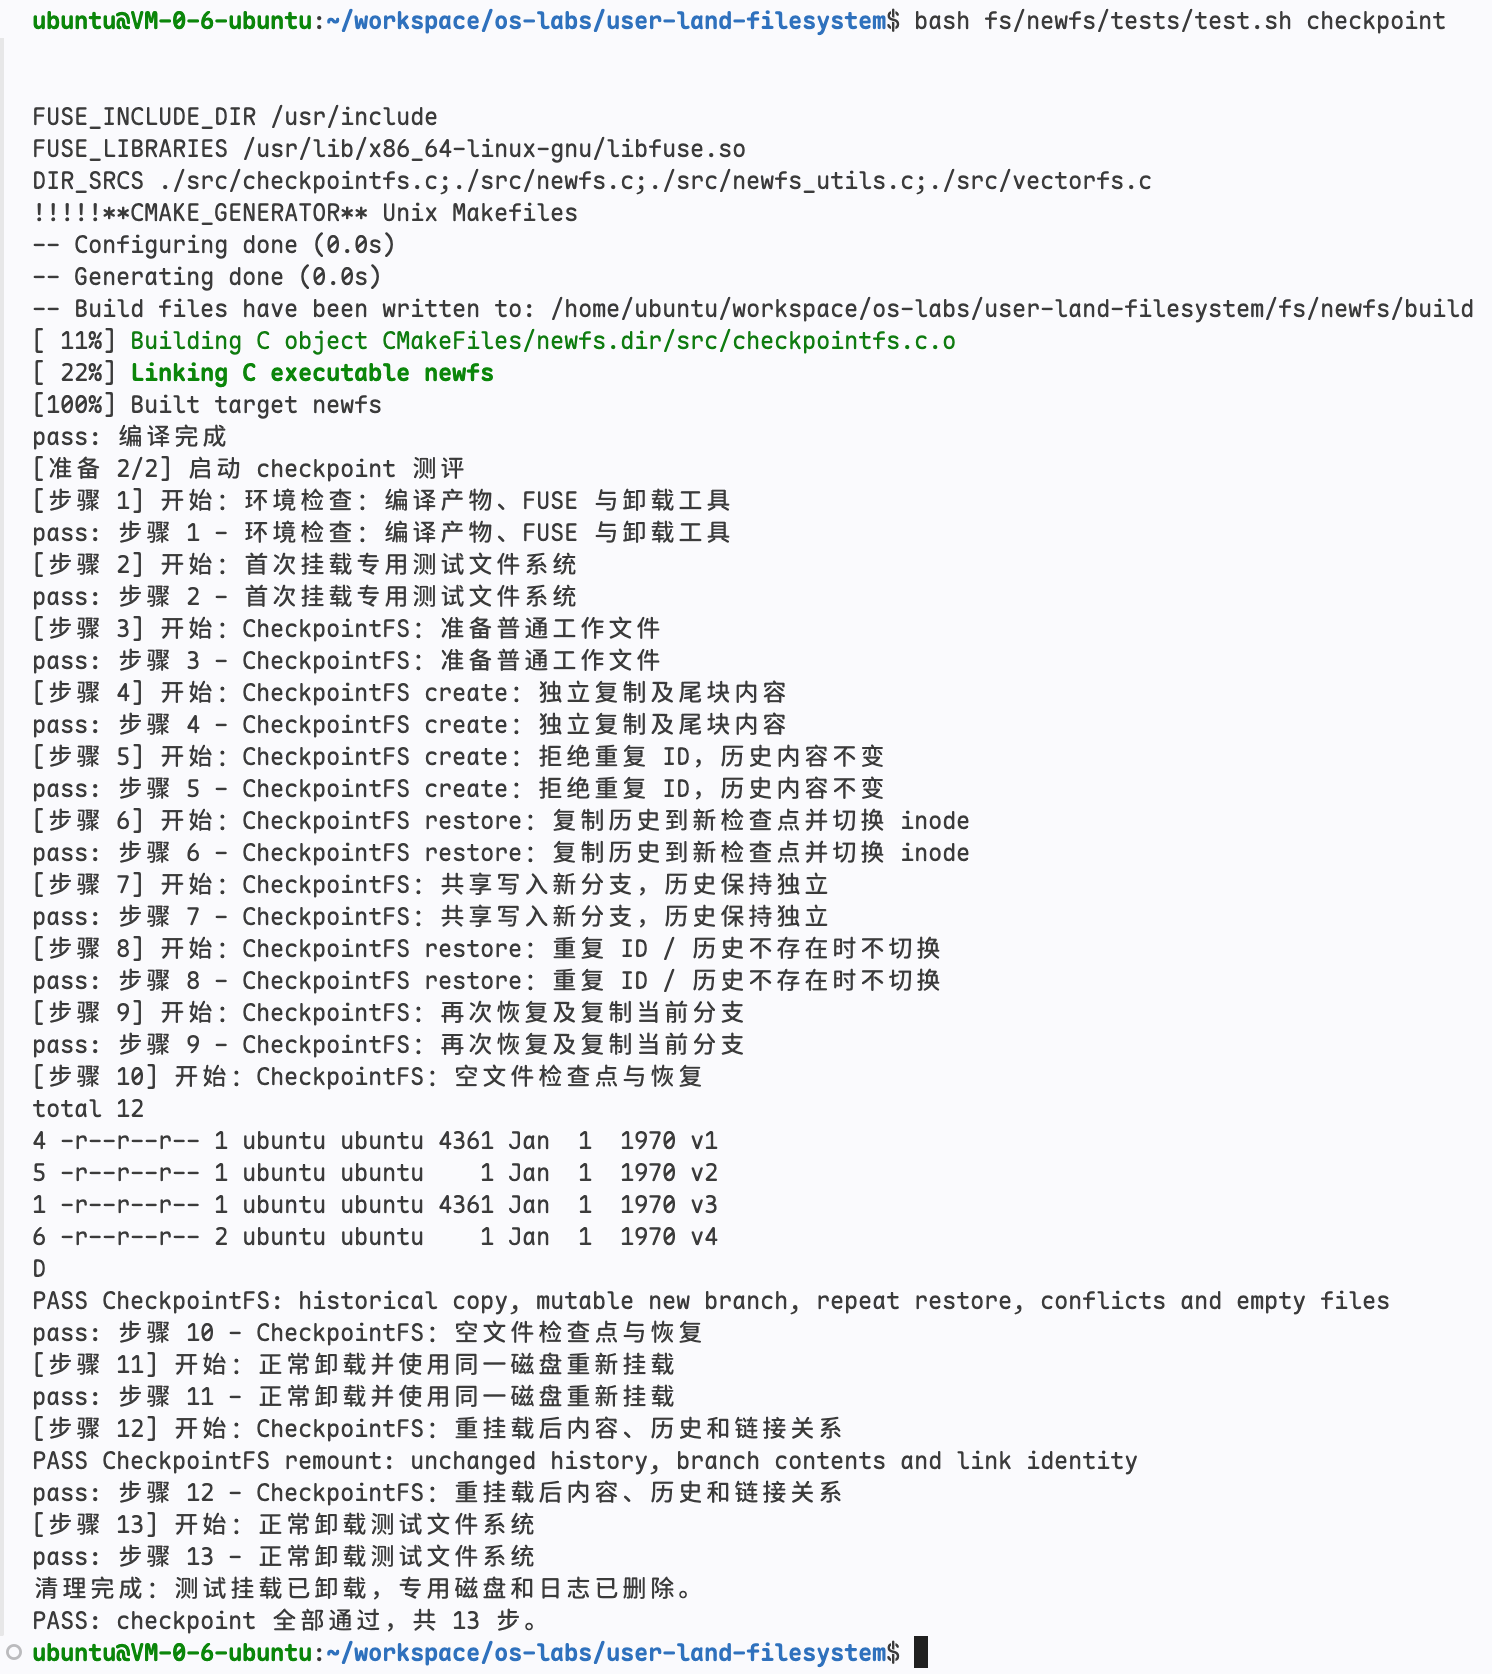
也可以尝试手动检查,这里略微修改了指导书给的命令,可以直接执行
先清空 ddriver 并挂载
# user-land-filesystem/fs/newfs/
ddriver -r
./build/newfs -f -d -s ./tests/mnt/
# 1. 创建工作文件并写入 "A",保存为检查点 v0
# user-land-filesystem/fs/newfs/tests
mkdir -p "mnt/models"
printf 'A\n' > "mnt/models/model.bin"
python3 ../bonus/tools/checkpointctl.py "mnt" create /models/model.bin v0
stat -c '%i %h %n' "mnt/models/model.bin" "mnt/.checkpoints/models__model.bin/v0"
# 预期现象:两个文件的 inode 编号(第 1 列)不同,硬链接数(第 2 列)均为 1

# 2. 修改工作文件为 "B",验证检查点 v0 不受影响,然后回滚到 v0(新分支命名为 resumed)
printf 'B\n' > "mnt/models/model.bin"
cat "mnt/.checkpoints/models__model.bin/v0"  # 仍输出 A(独立副本)
python3 ../bonus/tools/checkpointctl.py "mnt" restore /models/model.bin v0 resumed
stat -c '%i %h %n' "mnt/models/model.bin" "mnt/.checkpoints/models__model.bin/resumed" "mnt/.checkpoints/models__model.bin/v0"
# 预期现象:model.bin 与 resumed 的 inode 编号相同且硬链接数均为 2;v0 的 inode 编号与它们不同
cat "mnt/models/model.bin"  # 输出 A(刚才未保存的 B 已被丢弃)

# 3. 继续向工作文件写入 "C",观察新分支与旧历史的区别
printf 'C\n' > "mnt/models/model.bin"
cat "mnt/.checkpoints/models__model.bin/resumed"  # 输出 C(与工作文件共享 inode)
cat "mnt/.checkpoints/models__model.bin/v0"       # 仍输出 A(历史检查点不受影响)

# 4. 恢复前先显式 create 保存当前状态,再恢复到 v0,最后还能找回刚才保存的状态
python3 ../bonus/tools/checkpointctl.py "mnt" create /models/model.bin before_restore
python3 ../bonus/tools/checkpointctl.py "mnt" restore /models/model.bin v0 resumed_again
cat "mnt/models/model.bin"                                # 输出 A
cat "mnt/.checkpoints/models__model.bin/before_restore"   # 输出 C(之前显式保存的内容)
python3 ../bonus/tools/checkpointctl.py "mnt" restore /models/model.bin before_restore recovered
cat "mnt/models/model.bin"                                # 输出 C(成功从 before_restore 找回)
完成后记得卸载
# newfs/tests
fusermount -u mnt
运行状况如图
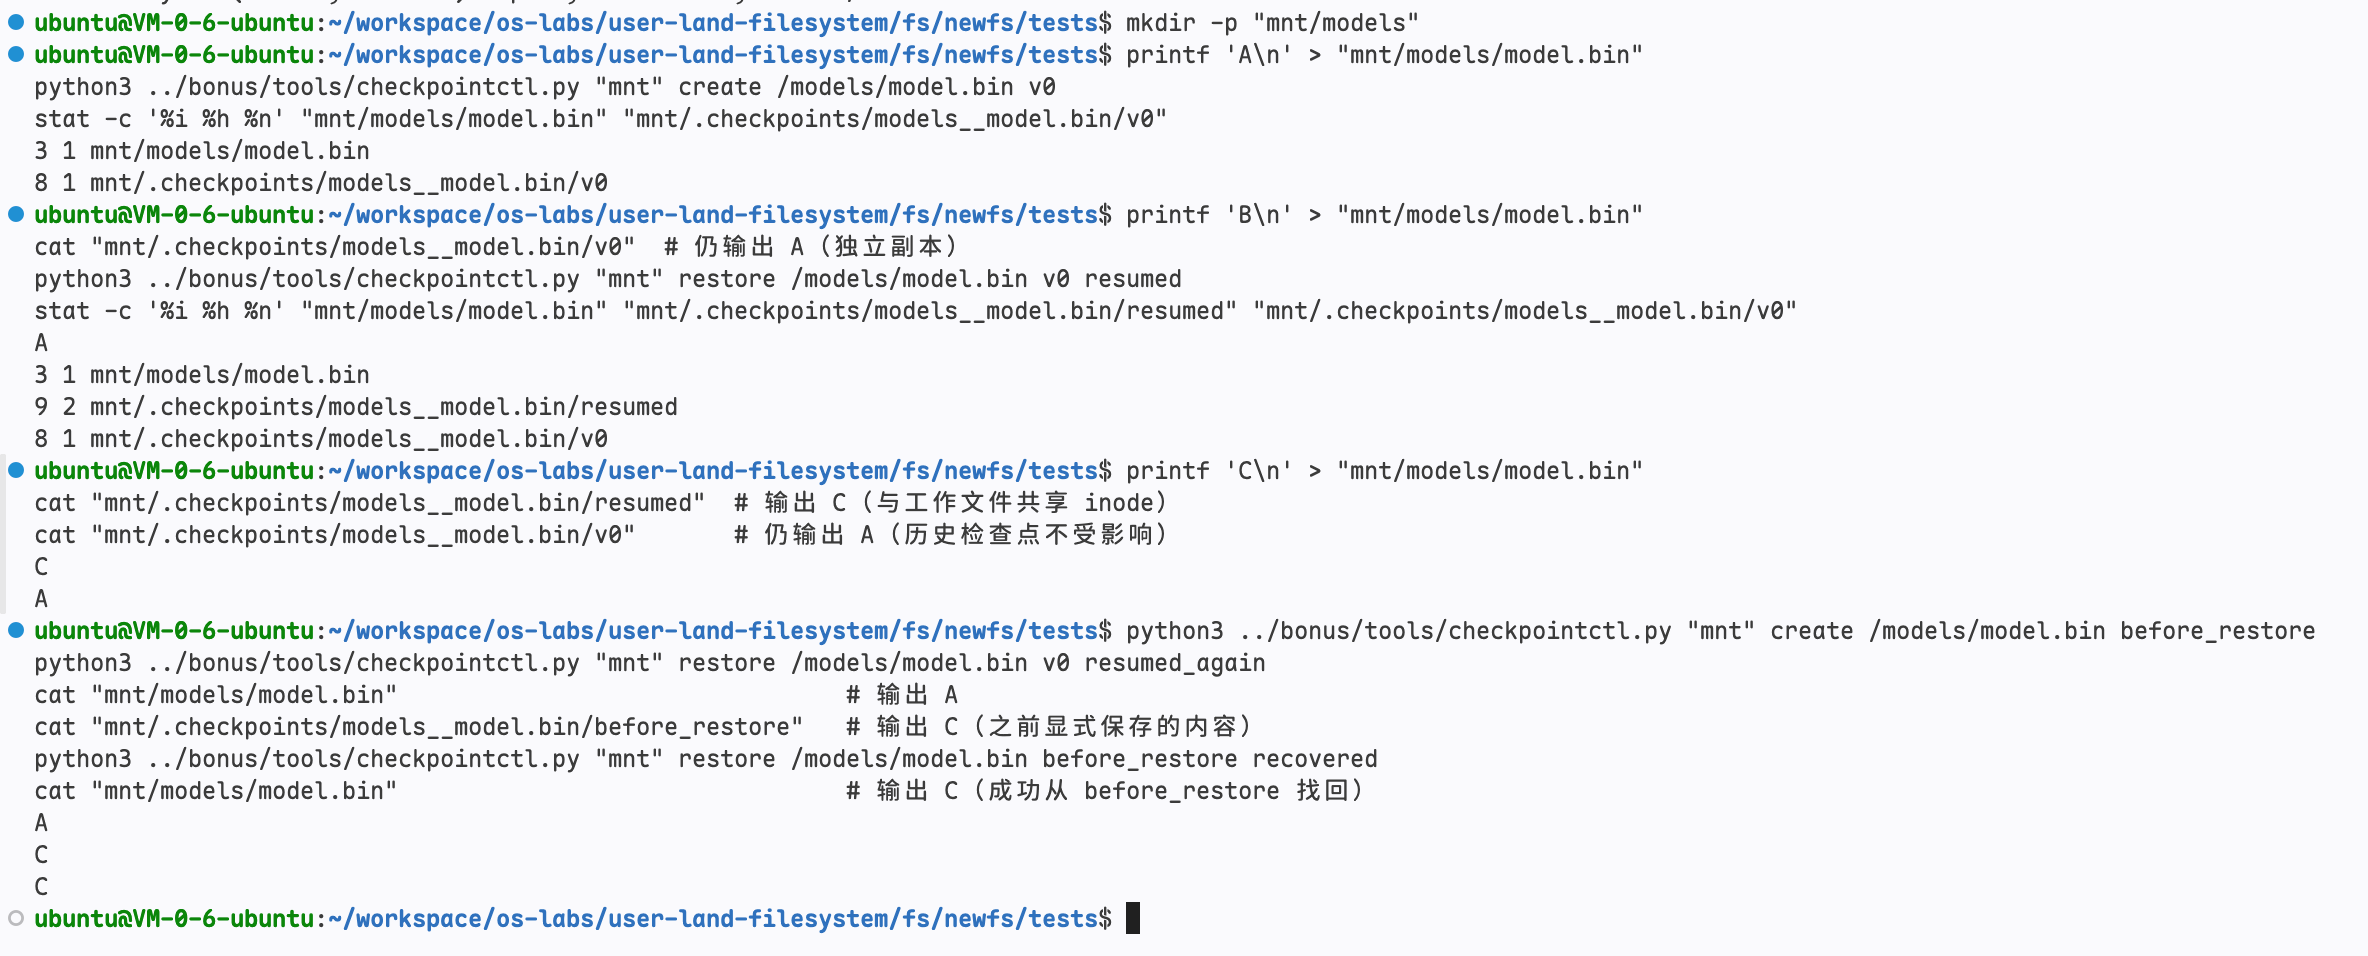
这里 inode 显示不一样是挂载参数导致的,应该改成下面的命令,并且由于磁盘IO时间开销,stat 显示的结果可能还没来得及变化的,建议逐条输入
./build/newfs -f -d -s -o use_ino ./mnt
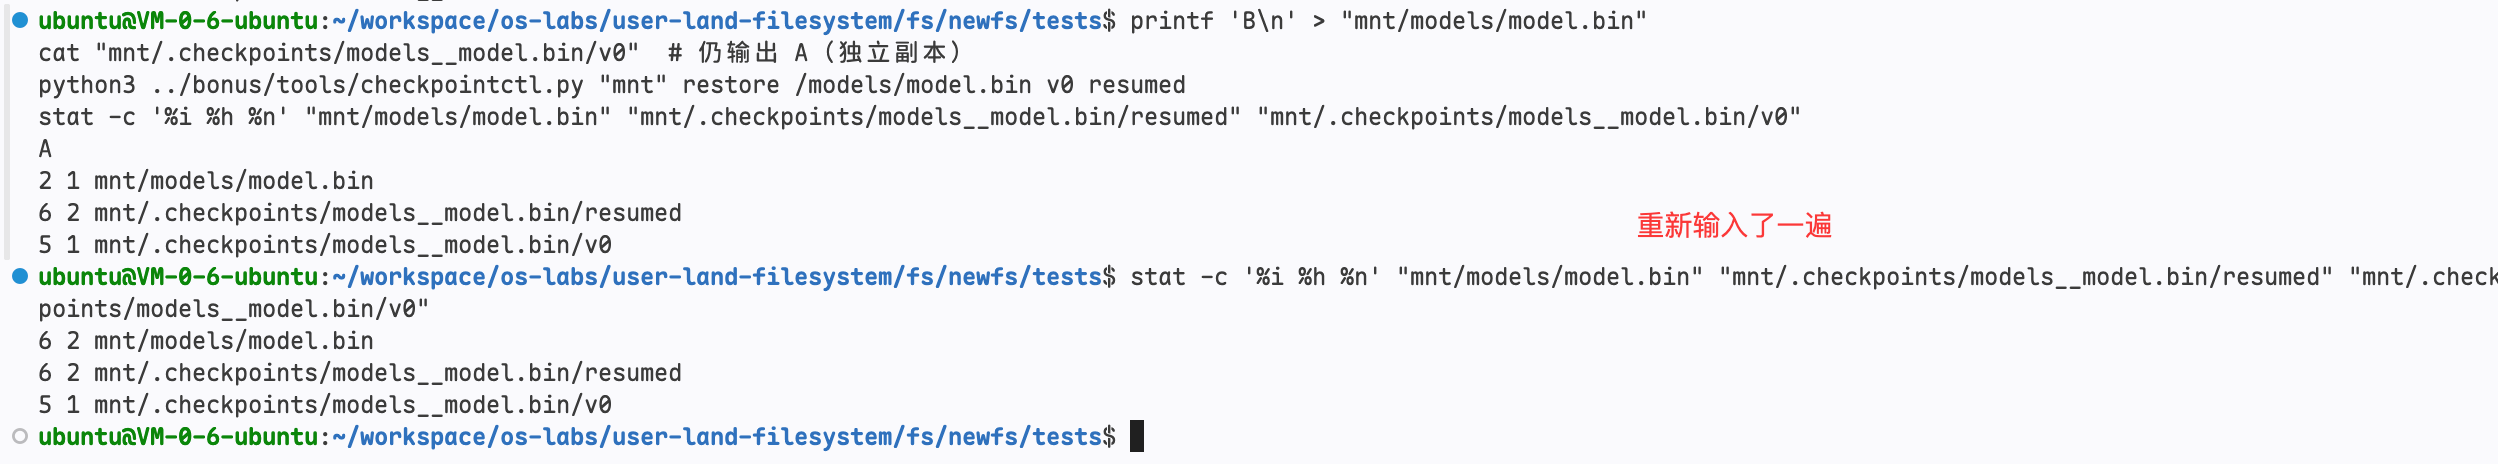
附加题三:VectorFS
VectorFS 要做的事情主要是根据搜索文本创建软链接,软链接指向普通文档。它的目录结构如下
.
├── .checkpoint
│   └── control
├── .checkpoints
├── documents
│   ├── fs.txt
│   ├── os
│   │   └── inode.txt
│   └── process.txt
└── .search
.search/qeury
├── 0.433963__02 -> ../../documents/process.txt
├── 0.680703__01 -> ../../documents/os/inode.txt
└── 0.695048__00 -> ../../documents/fs.txt
.search/file%20system
├── 0.787242__02 -> ../../documents/process.txt
├── 0.973279__01 -> ../../documents/os/inode.txt
└── 1.000000__00 -> ../../documents/fs.txt
其中 .search, .search/qeury 都是虚拟目录
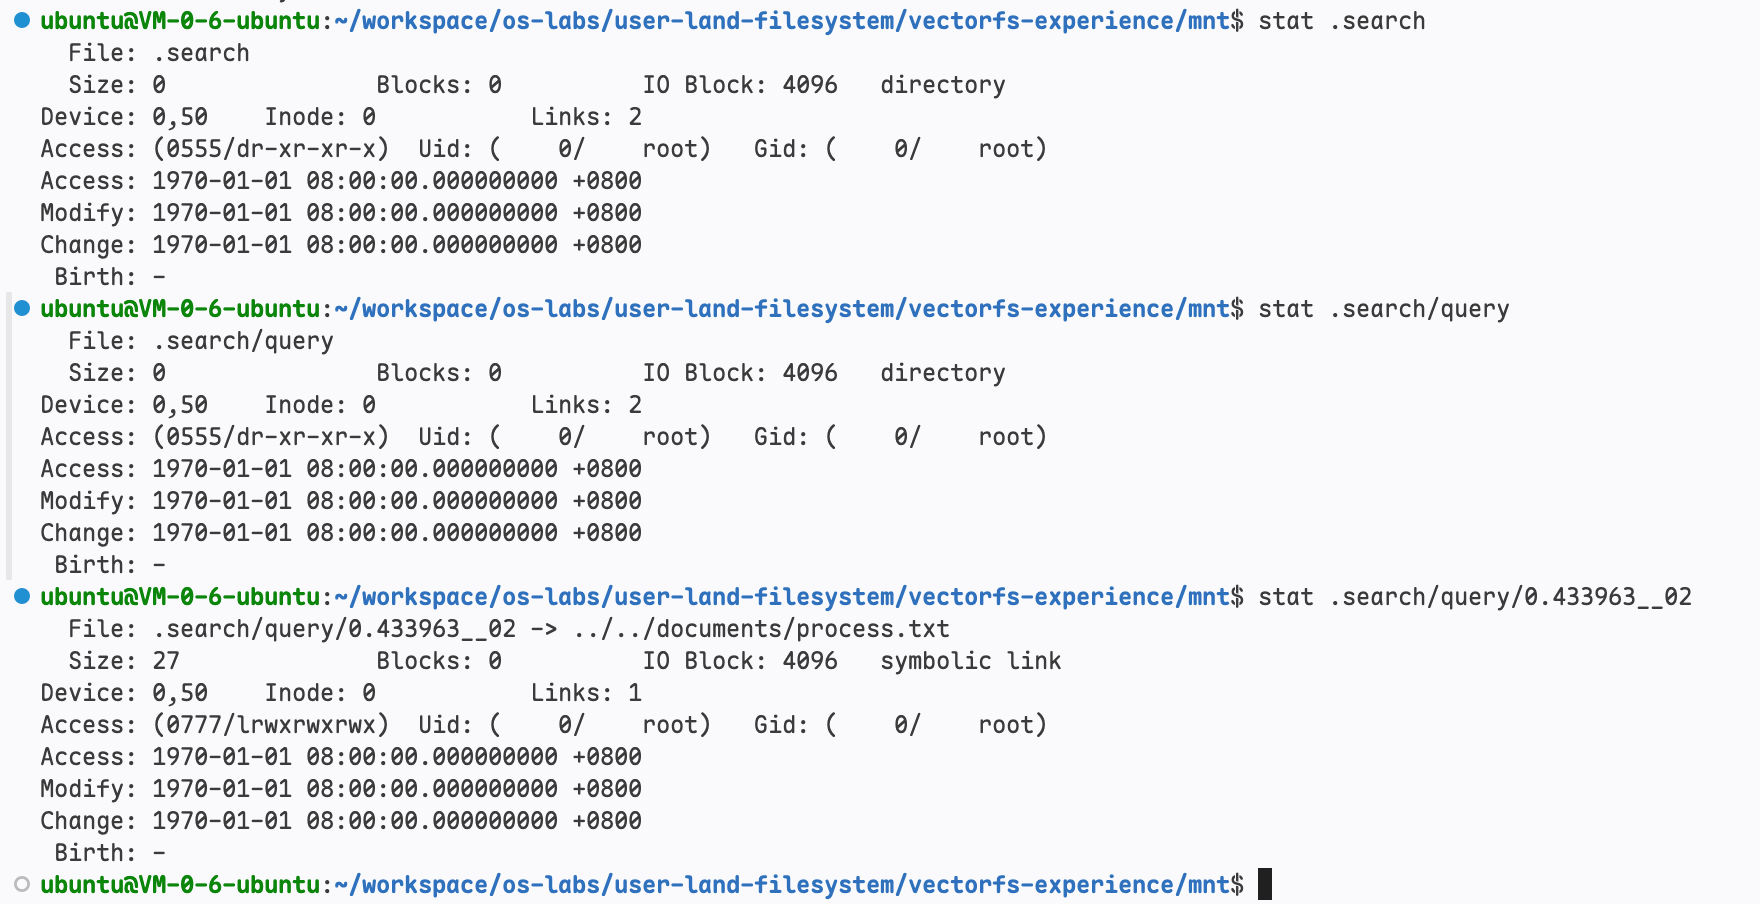
从图中可以看到,它们其实并不会持久化到磁盘中,指导书也说了它们是在内存中动态生成的,所以其实并不能理解成普通的软链接。
如果尝试 cat .search/query/0.695048__00 ,得到的内容和 cat documents/fs.txt 其实是一样的,在指导书的例子中是 "file system"
这里的 0.695048 是查询文本 query 向量化之后跟普通文档向量化之后的余弦相似度,而 00 则是相似度排名。可以看到 fs.txt 与 file%20system 相似度为 1,这说明 fs.txt 内容和查询文本一致,也就是 "file system",目录的 %20 是 URL 编码的结果
VectorFS 需要完成四个函数
搜索
这个函数需要根据查询文本返回最相似的几个普通文档
这里 query 是查询文本,vectorfs_result 是待返回的结果,需要返回最多前 VECTORFS_TOP_K 个结果,包含了文件的相对路径、相似度以及排名,而 count 则是实际返回的数量。
struct tuple {
    char *path;
    double rate;
};

int compare(const void *x1, const void *x2) {   // 比较函数,相似度相同时使用 `strcmp` 比较
    struct tuple *a = (struct tuple *)x1;
    struct tuple *b = (struct tuple *)x2;
    if (a->rate > b->rate) {
        return -1;  // 因为要求相似度降序排序,所以这里返回负数
    } else if (a->rate < b->rate) {
        return 1;
    } else {
        return strcmp(a->path, b->path);
    }
}

int vectorfs_search(const char *query,
                    struct vectorfs_result results[VECTORFS_TOP_K], size_t *count) {
    struct vectorfs_document *docs = NULL;
    size_t doc_count;
    CHECK(vectorfs_load_documents(&docs, &doc_count));  // 将所有普通文档信息加载出来,包括名字、相对路径以及向量
    float query_vec[VECTORFS_DIMENSION];
    int ret = vectorfs_embed(query, strlen(query), query_vec);  // 将查询文本向量化
    if (ret < 0) {
        vectorfs_documents_free(docs, doc_count);
        return ret;
    }
    struct tuple *tuples = malloc(doc_count * sizeof(struct tuple));
    if (tuples==NULL) {
        vectorfs_documents_free(docs, doc_count);
        return -ENOMEM;
    }
    for (int i=0; i<doc_count; i++) {
        tuples[i].path = docs[i].relative_path;
        tuples[i].rate = vectorfs_similarity(query_vec, docs[i].embedding); // 计算相似度
    }
    qsort(tuples, doc_count, sizeof(struct tuple), compare);    // qsort是升序排序,compare 是自己写的比较函数
    int k = doc_count < VECTORFS_TOP_K ? doc_count:VECTORFS_TOP_K;
    for (int j=0; j<k; j++) {
        strcpy(results[j].source, tuples[j].path);  // 复制相对路径
        results[j].rate = tuples[j].rate;           // 填写相似度和排名
        results[j].rank = j;
    }
    *count = k;
    vectorfs_documents_free(docs, doc_count);   // 释放文档信息
    free(tuples);
    return 0;
}
获取搜索目录或软链接的文件属性
类似于 newfs_getattr 需要填写 struct stat 信息
int vectorfs_getattr(const char *path, struct stat *st) {
    memset(st, 0, sizeof(*st));     // 清空结构体
    char *query = NULL;     // 解析目录得到的查询字符串
    double rate;            // 解析目录得到的相似度
    size_t rank;            // 解析目录得到的排名
    int kind = vectorfs_parse_path(path, &query, &rate, &rank); // 解析路径
    if (kind < 0) {
        return kind;
    }
    if (kind == 0 || kind == 1) {       // 对应输入路径 /.search 或者 /.search/<query>
        st->st_mode = S_IFDIR | 0555;   // 只读虚拟目录
        st->st_nlink = 2;
        free(query);
        return 0;
    }
    if (kind == 2) {                    // 对应输入路径 /.search/<query>/<rate>__<rank>/
        struct vectorfs_result *results = NULL;
        size_t count;
        int ret = vectorfs_cache_get(query, &results, &count);  // 读缓存,失效会调用 vectorfs_search
        if (ret < 0) {
            free(query);
            return ret;
        }
        if (rank >= count){ // 越界检查
            free(query);
            return -ENOENT;
        }
        char expected_name[VECTORFS_RESULT_NAME_MAX];
        vectorfs_result_name(&results[rank], expected_name, sizeof(expected_name)); // 根据结果的相似度 rate 以及排名 rank 生成文件名
        char name[VECTORFS_RESULT_NAME_MAX];
        snprintf(name, sizeof(name), "%.6f__%02zu", rate, rank);    // 自己根据目录的 rate 和 rank 进行拼接得到文件名
        if (strcmp(expected_name, name) != 0) {     // 进行比对
            free(query);
            return -ENOENT;
        }
        // 根据结果的 source 生成软链接相对目标路径(格式 "../../documents/%s")
        char target[VECTORFS_RESULT_NAME_MAX];
        ret = vectorfs_result_target(&results[rank], target, sizeof(target));
        if (ret != 0) {
            free(query);
            return ret;
        }
        st->st_mode = S_IFLNK | 0777;
        st->st_nlink = 1;
        st->st_size = strlen(target);
    }
    free(query);
    return 0;
}
遍历搜索根目录或查询目录
这个函数类似于 newfs_readdir,给定路径需要向 buf 填充子项,跳过前 offset 个子项
int vectorfs_readdir(const char *path, void *buf, fuse_fill_dir_t filler,
                     off_t offset, struct fuse_file_info *fi) {
    if (offset < 0)
        return -EINVAL;
    char *query = NULL;
    double rate;
    size_t rank;
    int kind = vectorfs_parse_path(path, &query, &rate, &rank); // 解析路径得到查询文本、相似度、排名
    int err = 0;
    if (kind < 0) {
        return kind;
    } else if (kind == 2) {     // 结果软链接文件不是目录
        err = -ENOTDIR;
        goto error;
    } else if (kind == 0) {     // /.search 搜索根目录,不保存历史查询记录,只返回 . 和 ..
        if (offset < 1 && filler(buf, ".", NULL, 1) != 0)   // filler 不返回 0 说明缓冲区填满,可直接返回
            goto done;
        if (offset < 2 && filler(buf, "..", NULL, 2) != 0)
            goto done;
        goto done;
    } else if (kind == 1) {     // /.search/<query> 查询目录
        struct vectorfs_result *results = NULL;
        size_t count;
        if ((err = vectorfs_cache_get(query, &results, &count)) < 0)    // 获取结果数组
            goto error;
        if (offset < 1 && filler(buf, ".", NULL, 1) != 0)
            goto done;
        if (offset < 2 && filler(buf, "..", NULL, 2) != 0)
            goto done;
        char name[VECTORFS_RESULT_NAME_MAX];
        for (int i=0; i<count; i++) {
            off_t cookie = (off_t)i + 3;
            if (cookie <= offset)   // 跳过前 offset 个子项
                continue;
            if ((err = vectorfs_result_name(&results[i], name, sizeof(name))) < 0)  // 根据结果数组获取文件名
                goto error;
            if ((filler(buf, name, NULL, cookie)) != 0) // 填充文件名
                goto done;
        }
    }
done:
    free(query);
    return 0;
error:
    free(query);
    return err;
}
根据软链接获得目标相对路径
这个函数输入软链接结果路径 path 比如(/.search/a/1.000000__00),需要返回目标相对路径 buf 比如(../../documents/<source>),size 则是缓冲区大小
int vectorfs_readlink(const char *path, char *buf, size_t size) {
    if (!buf || size==0)
        return -EINVAL;
    char *query = NULL;
    double rate;
    size_t rank;
    int err;
    int kind = vectorfs_parse_path(path, &query, &rate, &rank); // 获得搜索文本、相似度和排名
    if (kind < 0) {
        return kind;
    } else if (kind == 0 || kind == 1) {    // 不是软链接结果文件
        err = -EINVAL;
        goto error;
    } else if (kind == 2) {
        struct vectorfs_result *results = NULL;
        size_t count;
        if ((err = vectorfs_cache_get(query, &results, &count)) < 0)    // 获得结果数组
            goto error;
        if (rank >= count){ // 检查越界
            err = -ENOENT;
            goto error;
        }
        // 根据排名索引出结果数组中的结果,得到期望的文件名
        char expected_name[VECTORFS_RESULT_NAME_MAX];
        vectorfs_result_name(&results[rank], expected_name, sizeof(expected_name));
        // 根据解析路径得到的相似度和排名,合成文件名
        char name[VECTORFS_RESULT_NAME_MAX];
        if ((err = snprintf(name, sizeof(name), "%.6f__%02zu", rate, rank)) < 0)
            goto error;
        // 比对文件名
        if (strcmp(expected_name, name) != 0) {
            err = -ENOENT;
            goto error;
        }
        // 合成目标相对路径并拷贝到缓冲区中
        char target[VECTORFS_RESULT_NAME_MAX];
        if ((err = vectorfs_result_target(&results[rank], target, sizeof(target))) < 0)
            goto error;
        strncpy(buf, target, size - 1);
        buf[size-1] = '\0';
    }
    free(query);
    return 0;
error:
    free(query);
    return err;
}
测试结果
完成实现后,在仓库根目录运行以下脚本,即可进行 VectorFS 自动验收,这和前面 CheckpointFS是一样的
bash fs/newfs/tests/test.sh vector
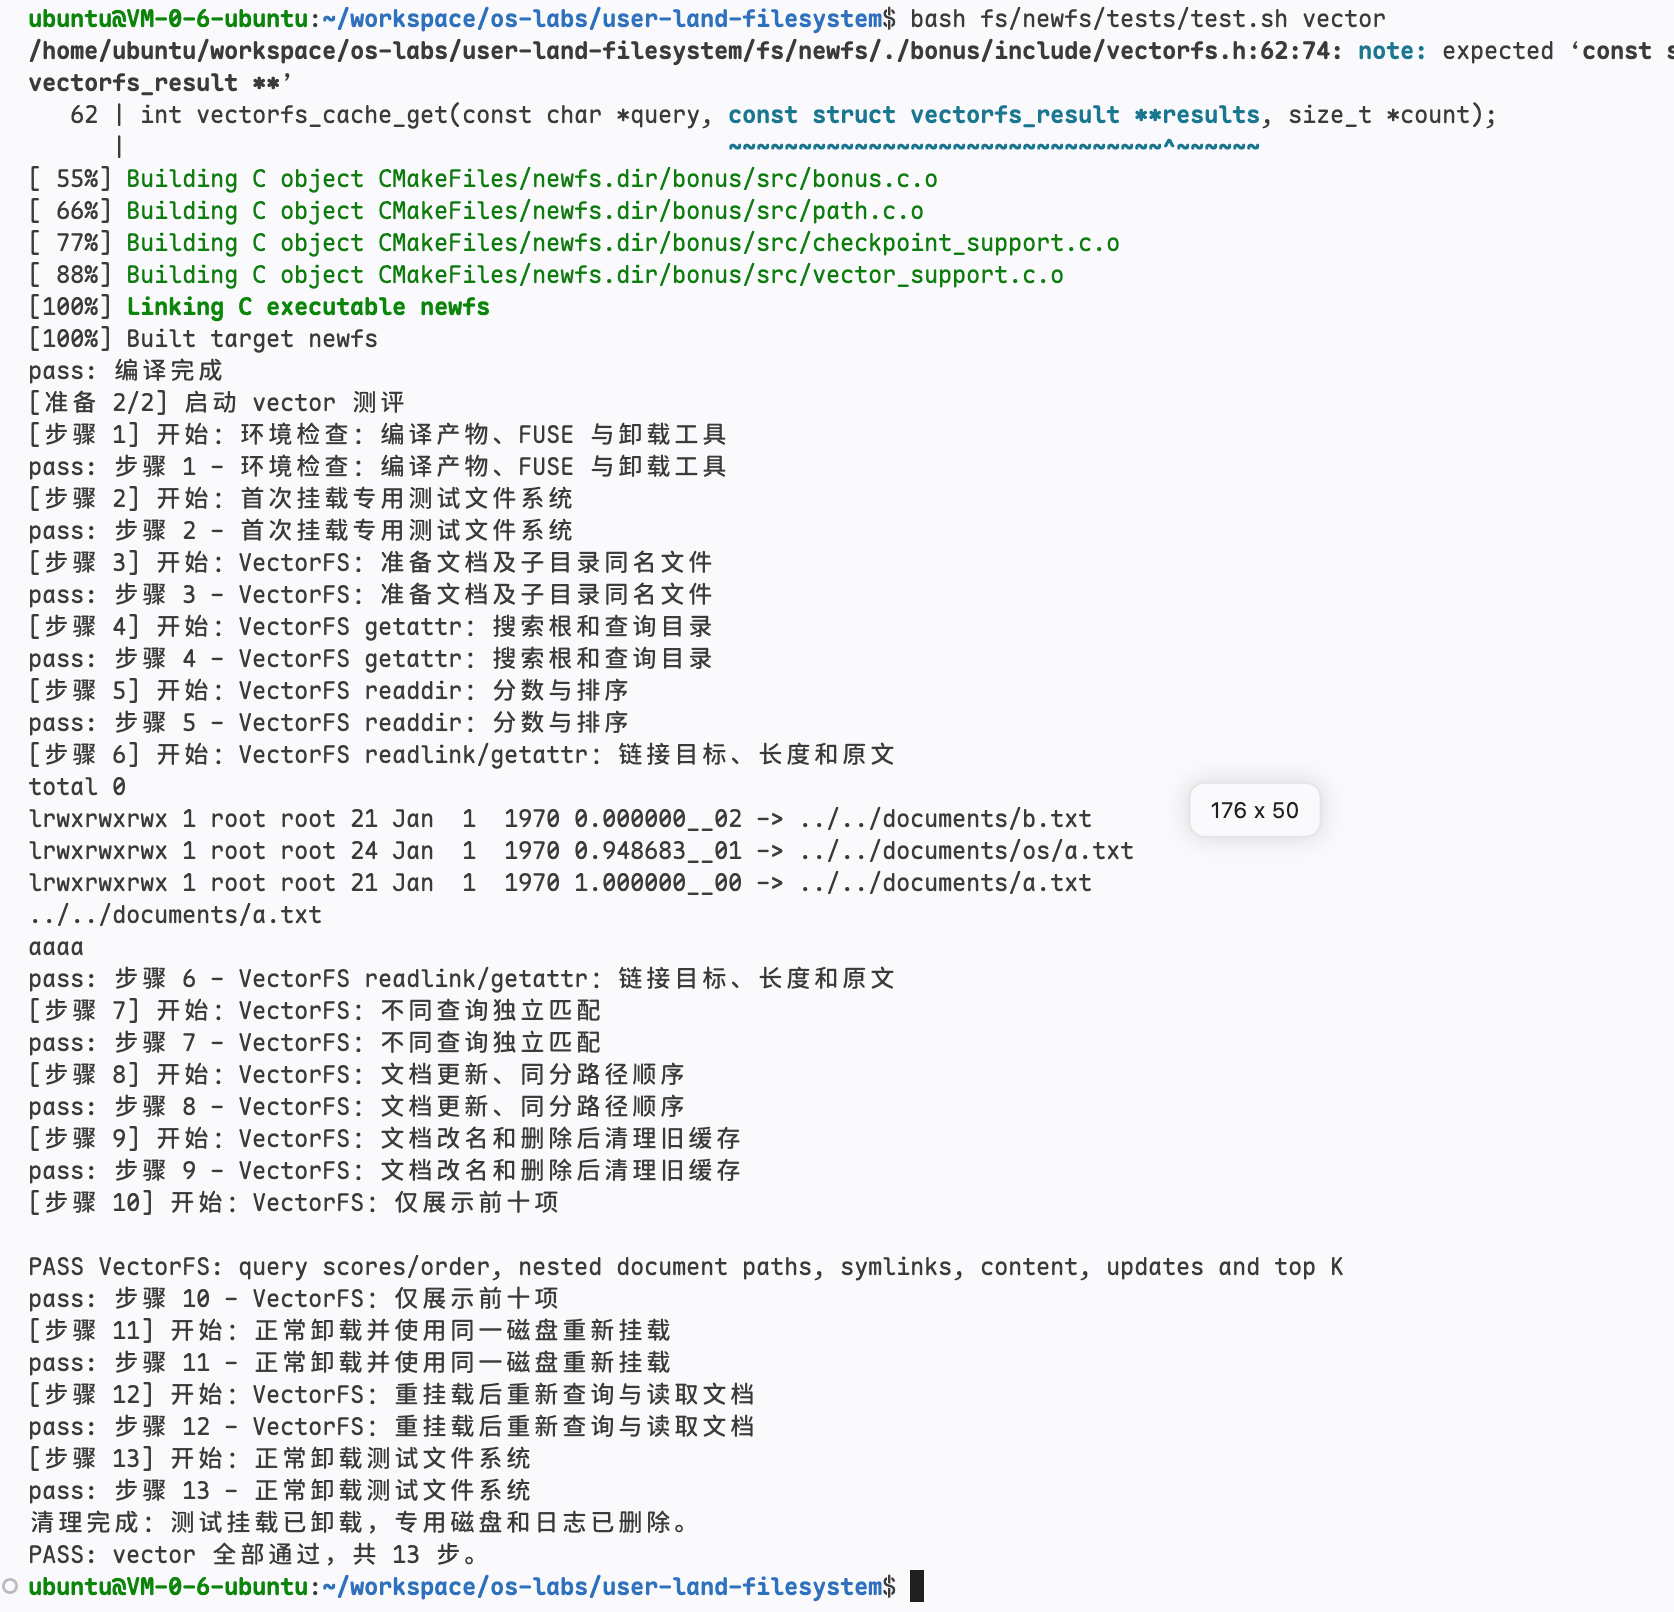
附录:所有错误码
钩子函数需要按规定返回错误码,下面是 errno.h 中的错误码
#define EPERM   1 /* Operation not permitted */
#define ENOENT  2 /* No such file or directory */
#define ESRCH   3 /* No such process */
#define EINTR   4 /* Interrupted system call */
#define EIO     5 /* I/O error */
#define ENXIO   6 /* No such device or address */
#define E2BIG   7 /* Argument list too long */
#define ENOEXEC 8 /* Exec format error */
#define EBADF   9 /* Bad file number */
#define ECHILD  10 /* No child processes */
#define EAGAIN  11 /* Try again */
#define ENOMEM  12 /* Out of memory */
#define EACCES  13 /* Permission denied */
#define EFAULT  14 /* Bad address */
#define ENOTBLK 15 /* Block device required */
#define EBUSY   16 /* Device or resource busy */
#define EEXIST  17 /* File exists */
#define EXDEV   18 /* Cross-device link */
#define ENODEV  19 /* No such device */
#define ENOTDIR 20 /* Not a directory */
#define EISDIR  21 /* Is a directory */
#define EINVAL  22 /* Invalid argument */
#define ENFILE  23 /* File table overflow */
#define EMFILE  24 /* Too many open files */
#define ENOTTY  25 /* Not a typewriter */
#define ETXTBSY 26 /* Text file busy */
#define EFBIG   27 /* File too large */
#define ENOSPC  28 /* No space left on device */
#define ESPIPE  29 /* Illegal seek */
#define EROFS   30 /* Read-only file system */
#define EMLINK  31 /* Too many links */
#define EPIPE   32 /* Broken pipe */
#define EDOM    33 /* Math argument out of domain of func */
#define ERANGE  34 /* Math result not representable */
附录:常见问题
check bitmap 报错:ddriver 尺寸与 fs.layout 不一致
现象:跑 bash tests/test.sh(N 档)时,前面 mount / mkdir / touch / ls / remount 都通过,只有 case 5.3 报错:
数据写回错误, 没有写回到指定的数据区中
fail: case 5.3 - check bitmap
有时也会看到 Inode位图错误, 期望值: 2 个有效位, 实际值: 0 个有效位(这通常是把盘擦成 0 后的干扰信息)。
原因:切换分支后,仓库里的 driver 源码变了,但 ~/lib/libddriver.a 还是上一个分支编译的尺寸版本(例如 main 是 4MB、model 是 80MB)。newfs 是静态链接这个库的,所以实际使用的设备大小由 ~/lib 里的库决定。
而 ddriver 用户态驱动的 ddriver_open() 只按 CONFIG_DISK_SZ 做 posix_fallocate,不会校验已有文件的大小。于是:
tests/test.sh用当前分支的ddriver -r把盘擦成 4MB;- 挂载时用的却是 80MB 版的库,
ddriver_open又把 4MB 的盘扩成 80MB; - FS 读到
sz_disk = 80MB,按 80MB 布局初始化:Super(1) | Inode Map(1) | DATA Map(10) | INODE(64) | DATA(*),数据区从逻辑块 76 开始; - 但
fs.layout还是 4MB 布局:Super(1) | Inode Map(1) | DATA Map(1) | INODE(64) | DATA(*),checkbm 算出数据区从逻辑块 67 开始; super、inode_map、data_map的偏移两种布局恰好相同,所以前三项检查能过;到check_data时 checkbm 按 4MB 布局去读逻辑块 67 —— 它落在 inode 表区域(全 0),于是报“数据写回错误”。
另外 model 分支的 ddriver 还限制设备路径必须是 $HOME/ddriver,用 --device=/tmp/xxx 会直接 PANIC: wrong path。
修复:
cd user-land-filesystem/driver/user_ddriver
make clean && make all       # 注意:默认 make 只编译 .o,要 make all 才会生成并安装 lib 到 ~/lib
ls -l ~/lib/libddriver.a     # 4MB 版约 32580 B;80MB 版约 29716 B

# 重新编译文件系统
cd ../../..
rm -rf build && mkdir build && cd build && cmake .. && make
# 删去旧的 ddriver
rm -f ~/ddriver
dd if=/dev/zero of=~/ddriver bs=512 count=8192 status=none # ddriver 填充数据 0
cd ../tests && printf "N\n" | bash test.sh
修复后 N 档 30/30(case 5.3 pass),E 档 34/34。
记忆点:~/lib/libddriver.a 不在 git 仓库里,是 make all 安装到 home 的;切换分支后要重编 lib 并重新编译 newfs(静态链接)。driver/ddriver.sh 的 BLOCK_COUNT、lib 的 CONFIG_DISK_SZ、include/fs.layout 三者必须和磁盘大小一致(4MB → DATA Map(1);80MB → DATA Map(10))。