Introduction
本文旨在记录作者完成课程任务 HITSZ os-lab3 的过程,可供参考。
本实验需要完成的内容包括
- 修改内存分配器(主要修改 kernel/kalloc.c),使多个 CPU 不必总是争用同一条空闲页链表和同一把 kmem.lock。
- 主要修改
kernel/bio.c,将原本的全局锁改为细粒度锁,可采取哈希桶等办法 - AI 推理服务附加题:使用缓存和预存取优化原本的baseline
实验仓库链接如下
指导书链接如下(需校内网)
仓库内有多个 lab 分支,本文所提的 lab3 对应的分支切换方法如下
git clone git@gitee.com:ftutorials/xv6-oslabs-hitsz.git
git checkout lock
任务零:回答问题
这些内容应写入实验报告,建议结合示意图,用简短但准确的语言回答:
内存分配器
问:什么是内存分配器?它的作用是什么?
答:内存分配器是内核中负责管理物理内存页的组件,用于跟踪哪些物理页空闲、哪些已占用;为内核对象、页表、用户进程等提供空闲物理页;回收不再使用的页,使内存可复用;在多核环境下保证分配/释放的并发安全。
问:xv6 的内存分配器核心数据结构是什么?主要有哪些操作(函数)?
答:核心数据结构是空闲页链表,主要操作包括 kinit(), kalloc(), kfree() 等
struct run:空闲页链表节点。空闲页本身被拿来存放这个节点,所以不额外占内存。
struct kmem:包含一把自旋锁和一个空闲页链表。
问:为什么“每 CPU 一条空闲页链表”能够减少锁竞争?
答:把原来的一条全局 freelist + 一把全局锁改成每个 CPU 一条 freelist + 每条链表各自的锁,多数情况下应该是
- CPU0 只动自己的链表;
- CPU1 只动自己的链表;
- CPU2 只动自己的链表;
- 它们互相之间不必总挤在同一把锁上。
这样,很多原本“必须串行”的操作,就能并行了。当然,这种设计不是没有代价:
- 某个 CPU 可能很快把自己的空闲页用光;
- 另一个 CPU 却还剩很多页。
所以通常还需要补一个“偷页 / 借页”逻辑:本地链表空了,再去其他 CPU 的链表里找可用页。
磁盘缓存
问:什么是磁盘缓存?它的作用是什么?
答:xv6 的文件系统最终是和磁盘打交道的,而磁盘访问比内存慢得多。如果每次读文件都直接去磁盘拿数据,会非常慢。所以系统通常会把“最近用过、可能还会再用”的磁盘块先缓存在内存里。这就是 Buffer Cache 的作用。
从调用关系看,buffer cache 正好夹在 文件系统 和 磁盘驱动 之间:
- 对上,文件系统里的 inode、目录、日志等代码不会直接操作磁盘,而是通过
bread()/bwrite()这类接口按块读写数据; - 对下,buffer cache 真正需要把某个块从磁盘读入、或把修改后的块写回磁盘时,又会继续调用底层磁盘驱动;
- 因此,它本质上就是一层“位于文件系统之下、位于磁盘驱动之上”的块缓存。
因此它至少承担了三件事:
- 缓存加速:减少重复读盘;
- 一致性约束:保证同一个磁盘块在缓存里不要出现多份副本;
- 并发控制:保证多个内核执行流同时访问缓存时不会把状态弄乱。
问:struct buf 为什么同时保留 prev 和 next?
答: prev 和 next 同时存在是因为原版 xv6 使用的 LRU 缓存管理很依赖双向链表:
- 命中查找时会遍历链表;
- 释放时要把结点移到链表前面;
- 选择可替换块时常常要从另一端开始找。
而双向链表可以将插入操作降低为 O(1) 复杂度,减少时间开销。
问:为什么哈希桶思路可以减少锁争用?为什么不能简单照搬“每 CPU 一份缓存”的做法?
答:对 kalloc 来说,把空闲页按 CPU 分开,问题不大,因为“页”本来就是会被分配给不同执行流独立使用的资源。
但 bcache 不一样:
- 它缓存的是 共享的磁盘数据;
- 同一个磁盘块,很多进程都可能来访问;
- 如果你简单做成“每 CPU 一份缓存”,就可能出现:
- CPU0 缓存了块 X
- CPU1 也缓存了块 X
- 两边内容不一致 这样就会直接破坏“同一个磁盘块在内存里只有一份副本”这个关键约束。
所以 bcache 的优化重点不是“把数据完全分家”,而是:
- 在 不破坏唯一副本语义 的前提下;
- 尽量把锁竞争分散开。
环境准备
切换到新的分支,并且清空先前留下的 fs.img
git checkout lock
make clean
make
多核环境启动
make qemu
单核环境启动,用于排查并发问题
make qemu CPUS=1
原题测试
kalloctest
usertests sbrkmuch
bcachetest
usertests
由于测试打印的信息太多了,所以统一放到了附录中
任务一:优化内存分配器
指导书要求
任务要求降低 kalloc, kfree 时发生的锁竞争,常见做法是把原来的单个 freelist 改成“每 CPU 一条 freelist”。例如:
struct run {
  struct run *next;
};

struct kmem {
  struct spinlock lock;
  struct run *freelist;
};

struct kmem kmems[NCPU];
你不必和这个示例完全一样,但最终设计至少要满足:
- 空闲页不能丢;
- 空闲页不能重复出现在多条链表中;
- 新增锁名要以 kmem 开头。
推荐实现顺序
- 先把 kinit()、freerange()、kfree()、kalloc() 之间的调用关系看清楚。
- 再决定你的新数据结构怎么组织:是每 CPU 一把锁 + 一条链表,还是其他等价设计。
- 先把“当前 CPU 上申请 / 释放”这条基本路径改通。
- 再补“本地没页时从其他 CPU 借页”的逻辑。
- 最后跑 kalloctest、usertests sbrkmuch、usertests 检查正确性和性能。
原题设计
原来的 kalloc.c 中的内容并不多,大致如下
extern char end[]; // first address after kernel.
                   // defined by kernel.ld.

struct run {
  struct run *next;
};

struct {
  struct spinlock lock;
  struct run *freelist;
} kmem;

void
kinit()
{
  initlock(&kmem.lock, "kmem");
  freerange(end, (void*)PHYSTOP);   // 释放 end 到 PHYSTOP 的物理页
}

void
freerange(void *pa_start, void *pa_end)
{
  // 按范围释放物理页
  char *p;
  p = (char*)PGROUNDUP((uint64)pa_start);
  for(; p + PGSIZE <= (char*)pa_end; p += PGSIZE)
    kfree(p);
}

void
kfree(void *pa)
{
  // 将物理页填满垃圾数据,然后添加到空闲页链表中
  struct run *r;
  if(((uint64)pa % PGSIZE) != 0 || (char*)pa < end || (uint64)pa >= PHYSTOP)
    panic("kfree");
  memset(pa, 1, PGSIZE);
  r = (struct run*)pa;

  acquire(&kmem.lock);
  r->next = kmem.freelist;
  kmem.freelist = r;
  release(&kmem.lock);
}

void *
kalloc(void)
{
  // 从空闲页链表中找到空闲页,填充垃圾数据然后返回
  struct run *r;
  acquire(&kmem.lock);
  r = kmem.freelist;
  if(r)
    kmem.freelist = r->next;
  release(&kmem.lock);

  if(r)
    memset((char*)r, 5, PGSIZE); // fill with junk
  return (void*)r;
}
本文的修改思路
在和 ChatGPT 商讨一段时间后,最终打算实现的思路如下
- 采用每 CPU 一个空闲页链表,每个链表都有自己的锁
- 释放时,获得空闲页链表自己的锁,释放页到自己的链表中
- 分配时,先检查当前空闲页链表是否有空闲页,如果没有,执行偷页操作,再尝试进行分配
- 采用偷页的方式,当空闲页链表空了,遍历其他CPU的链表信息,进行偷页
- 每个空闲页链表对象都会存储空闲页数量信息
- 偷页时,不带锁检查一遍全部空闲页链表,选出 victim
- 对受害者进行偷页时,获得锁,进行偷页,按照 victim 的空闲页数量进行比例偷取,本文偷 victim 中的一半的空闲页
- 偷页完成后,当前空闲页链表的页数量会变多
- 返回页链表头结点,或者失败返回空指针
- 初始化时,让 CPU0 获得全部页,其他CPU的空闲页链表都是空的,只有需要时才进行偷取
修改代码
初始化
首先是初始化的代码,不需要太多更改,因为释放的页全部都到了 CPU0 这里
void
kinit()
{
  // 给锁起名字方便调试
  for(int i=0;i<NCPU;i++){
    kmem_names[i][0] = 'k';
    kmem_names[i][1] = 'm';
    kmem_names[i][2] = 'e';
    kmem_names[i][3] = 'm';
    kmem_names[i][4] = '0' + i;
    kmem_names[i][5] = '\0';
    initlock(&kmems[i].lock, kmem_names[i]);
    kmems[i].free_pages = 0;
  }
  freerange(end, (void*)PHYSTOP);
}

void
freerange(void *pa_start, void *pa_end)
{
  char *p;
  p = (char*)PGROUNDUP((uint64)pa_start);
  for(; p + PGSIZE <= (char*)pa_end; p += PGSIZE)
    kfree(p);   // all to cpu0 first
  printf("kmem0 have all free_pages: %d\n", kmems[0].free_pages);   // 调试打印用
}
偷页
获取CPU ID时,程序不能发生中断,否则可能获取到错误的CPUID,为了保持当前 CPU 上下文稳定,需要使用 push_off(), pop_off() 暂时关闭中断
push_off();
int cid = cpuid();
...
pop_off();
如果不这么做,可能会出现 CPU2 拿着 CPU0 的空闲页链表进行操作的情况,所以在此期间本文使用了 push_off,pop_off 覆盖了 cid 的使用范围。
偷页函数如下
// Try stealing pages from other CPUS
void *
ksteal(void)
{
  struct run *head;
  struct run *tail = 0;
  push_off();
  int cid = cpuid();
  int victim = -1;
  int max_free_pages = 0;

  for(int i=0;i<NCPU;i++){  // scan free_pages
    if (i==cid) continue;
    if (kmems[i].free_pages>max_free_pages){
      victim = i;
      max_free_pages = kmems[i].free_pages;
    }
  }

  if(victim!=-1){
    acquire(&(kmems[victim].lock));
    int free_pages = kmems[victim].free_pages;
    if (free_pages){
      // steal half of the free pages
      int steal_num = (free_pages + 1)/2;
      head = kmems[victim].freelist;
      for (int i=0; i<steal_num;++i){
        tail = kmems[victim].freelist;
        kmems[victim].freelist = kmems[victim].freelist->next;
      }
      kmems[victim].free_pages -= steal_num;
      release(&(kmems[victim].lock));
      // 将偷来的页添加到页链表中
      acquire(&(kmems[cid].lock));
      kmems[cid].free_pages += steal_num;
      tail->next = kmems[cid].freelist;
      kmems[cid].freelist = head;
      release(&(kmems[cid].lock));

      pop_off();
      return (void*)head;
    }
    release(&(kmems[victim].lock));
  }
  pop_off();
  return 0; // failed;
}
这里虽然是先放弃一个锁,再获得另一个锁,但却是安全的。
kalloc(), kfree() 修改
kalloc() 和 kfree() 同样需要获得当前CPUID,并且获得对应的锁
void
kfree(void *pa)
{
  struct run *r;
  push_off();
  int cid = cpuid();

  if(((uint64)pa % PGSIZE) != 0 || (char*)pa < end || (uint64)pa >= PHYSTOP)
    panic("kfree");

  // Fill with junk to catch dangling refs.
  memset(pa, 1, PGSIZE);

  r = (struct run*)pa;

  acquire(&(kmems[cid].lock));
  r->next = kmems[cid].freelist;
  kmems[cid].freelist = r;
  kmems[cid].free_pages++;
  release(&kmems[cid].lock);
  pop_off();
}

void *
kalloc(void)
{
  struct run *r;
  push_off();
  int cid = cpuid();
  acquire(&(kmems[cid].lock));
  r = kmems[cid].freelist;
  if(r){
    kmems[cid].freelist = r->next;
    kmems[cid].free_pages--;
    release(&kmems[cid].lock);
  } else {
    release(&kmems[cid].lock);
    ksteal();
    acquire(&kmems[cid].lock);
    r = kmems[cid].freelist;
    if(r){
      kmems[cid].freelist = r->next;
      kmems[cid].free_pages--;
    }
    release(&kmems[cid].lock);
  }
  pop_off();
  if(r)
    memset((char*)r, 5, PGSIZE); // fill with junk
  return (void*)r;
}
测试结果
不出意外的话,测试结果中应该可以看到锁竞争次数会下降为0
...
--- lock kmem/bcache stats
lock: kmem0: #fetch-and-add 0 #acquire() 160393
lock: kmem1: #fetch-and-add 0 #acquire() 136444
lock: kmem2: #fetch-and-add 0 #acquire() 136185
...
而原本的代码中锁竞争次数很高
--- lock kmem/bcache stats
lock: kmem: #fetch-and-add 3896751 #acquire() 433016
更多测试数据相见附录
任务二:优化 buffer cache
指导书要求
减少 bcache.lock 的集中竞争,同时保持 bio.c 的缓存语义不变。
你需要继续保证:
- 同一个磁盘块在缓存中最多只有一份副本;
refcnt、命中查找、替换和释放逻辑仍然正确;- 新增锁名以 bcache 开头。
- 一种常见做法是使用多个哈希桶。例如:
#define NBUCKETS 13

struct {
  struct spinlock lock[NBUCKETS];
  struct buf buf[NBUF];
  struct buf hashbucket[NBUCKETS];
} bcache;
你也不必照抄这个结构,但“多桶分散竞争”通常是比较自然的方向。
推荐实现顺序
- 先把
binit()、bget()、bread()、brelse()、bpin()、bunpin()的行为理清楚。 - 再决定你的桶划分方式,例如按
blockno哈希到固定数量的桶。 - 先实现“命中时如何找到块并安全增加引用计数”。
- 再实现“未命中时如何找一个空闲 buf 并把它放到新桶里”。
- 最后检查
bcachetest和usertests。
bio.c 内容分析
bio.c 的主要函数如下
binit(): 初始化操作,包括初始化锁和插入链表bget(): 给定blockno返回buf结点,并且增加refcnt。未 cached 的结点会用 LRU 释放一个。返回之前会持有结点的睡眠锁。bread(): 调用bget()获取buf结点,如果是新结点会读取磁盘内容再返回bwrite(): 检查锁是否持有,然后写回磁盘brelse(): 并且释放结点睡眠锁,获取全局锁并且减少buf结点的refcnt,如果refcnt减至0,将其移动到bache.head->next的位置bpin(): 获取 bache 锁,增加结点的refcnt,释放锁bunpin(): 获取 bache 锁,减少结点的refcnt,释放锁
实现思路
本文使用哈希桶进行实现,相关数据结构和哈希函数如下
struct bucket {
  struct spinlock lock;
  struct buf *head;
} bucket;

struct {
  struct buf buf[NBUF];
  struct bucket bucket[NBUCKET];
} bcache;

int
bhash(uint blockno)
{
  return blockno % NBUCKET;
}
- 初始化时,按照数组下标将
buf结点插入到各个桶之中 - 需要获取
buffer cache时,根据三种情况进行处理- cached: 直接在桶里面找到对应的
buf - uncached: 在桶里面尝试回收
refcnt==0的结点并返回 - steal: 当桶里面没有可回收的结点,尝试从其他桶里面进行偷取
- 遍历每个桶里面的结点尝试回收
- cached: 直接在桶里面找到对应的
- 修改锁的获取释放
初始化 bcache
void
binit(void)
{
  struct buf *b;
  for(int i=0; i<NBUCKET; ++i){
    bucket_names[i][0] = 'b';
    bucket_names[i][1] = 'c';
    bucket_names[i][2] = 'a';
    bucket_names[i][3] = 'c';
    bucket_names[i][4] = 'h';
    bucket_names[i][5] = 'e';
    bucket_names[i][6] = i>=10? ('0' + i/10):('0' + i);
    bucket_names[i][7] = i>=10? ('0' + i%10):('\0');
    bucket_names[i][8] = '\0';
    initlock(&(bcache.bucket[i].lock), bucket_names[i]);
    bcache.bucket[i].head = 0;
  }

  // Create linked list of buffers
  for(int i=0; i < NBUF; i++){  // 在 head 和下个结点间插入新结点
    b = &bcache.buf[i];
    initsleeplock(&b->lock, "buffer");
    int bucket_num = bhash(i);
    b->bucket = bucket_num;
    b->next = bcache.bucket[bucket_num].head;
    bcache.bucket[bucket_num].head = b;
  }
}
因为放弃了双向链表,这里没有 prev 。直接使用头插法插入结点,并且初始化每个桶的锁。
为了方便根据结点获取桶位置,这里修改了 struct buf,添加了 bucket 变量记录这个结点在哪个桶中。
struct buf {
  int valid;   // has data been read from disk?
  int disk;    // does disk "own" buf?
  uint dev;
  uint blockno;
  struct sleeplock lock;
  uint refcnt;
  uint bucket;
  struct buf *prev; // LRU cache list
  struct buf *next;
  uchar data[BSIZE];
};
261012更新:实验不允许修改 struct buf 所以只能用哈希函数即时获取桶序号
修改 bget()
根据前面的修改思路,这里给出代码如下
static struct buf*
bget(uint dev, uint blockno)
{
  struct buf *b;
  int bucket_num = bhash(blockno);
  acquire(&(bcache.bucket[bucket_num].lock));

  // Is the block already cached?
  for(b = bcache.bucket[bucket_num].head; b; b = b->next){
    if(b->dev == dev && b->blockno == blockno){
      b->refcnt++;
      release(&(bcache.bucket[bucket_num].lock));
      acquiresleep(&b->lock);
      return b;
    }
  }

  // Not cached.
  // Recycle in the bucket first
  for(b = bcache.bucket[bucket_num].head; b; b = b->next){
    if(b->refcnt == 0) {
      b->dev = dev;
      b->blockno = blockno;
      b->valid = 0;
      b->refcnt = 1;
      release(&(bcache.bucket[bucket_num].lock));
      acquiresleep(&b->lock);
      return b;
    }
  }

  // steal buf from other buckets
  release(&(bcache.bucket[bucket_num].lock));
  struct buf *prevb;
  for(int offset=0; offset<NBUCKET;offset++){
    prevb = 0;
    int i = (cpuid()+offset)%NBUCKET; // optimization
    if (i==bucket_num) continue;
    acquire(&(bcache.bucket[i].lock));
    for(b = bcache.bucket[i].head; b; prevb = b, b = b->next){
      if(b->refcnt == 0) {

        if(prevb) // b is not head
          prevb->next = b->next;
        else
          bcache.bucket[i].head = b->next;
        b->dev = dev;
        b->blockno = blockno;
        b->valid = 0;
        b->refcnt = 1;
        // b->bucket = bucket_num;  不允许
        release(&(bcache.bucket[i].lock));

        acquire(&(bcache.bucket[bucket_num].lock));
        b->next = bcache.bucket[bucket_num].head;
        bcache.bucket[bucket_num].head = b;
        release(&(bcache.bucket[bucket_num].lock));

        acquiresleep(&b->lock);
        return b;
      }
    }
    release(&(bcache.bucket[i].lock));
  }
  panic("bget: no buffers");
}
其他处理
前面添加 bucket 成员变量就是为了方便这里进行锁的持有和释放
void
brelse(struct buf *b)
{
  if(!holdingsleep(&b->lock))
    panic("brelse");
  int bucket_num = b->bucket;
  releasesleep(&b->lock);

  acquire(&(bcache.bucket[bucket_num].lock));
  b->refcnt--;
  release(&(bcache.bucket[bucket_num].lock));
}

void
bpin(struct buf *b) {
  int bucket_num = b->bucket;
  acquire(&(bcache.bucket[bucket_num].lock));
  b->refcnt++;
  release(&(bcache.bucket[bucket_num].lock));
}

void
bunpin(struct buf *b) {
  int bucket_num = b->bucket;
  acquire(&(bcache.bucket[bucket_num].lock));
  b->refcnt--;
  release(&(bcache.bucket[bucket_num].lock));
}
261012更新:实验不允许修改 struct buf 所以只能用哈希函数即时获取桶序号
void
bpin(struct buf *b) {
  int bucket_num = bhash(b->blockno);
  acquire(&(bcache.bucket[bucket_num].lock));
  b->refcnt++;
  release(&(bcache.bucket[bucket_num].lock));
}
其他类似
测试结果
不出意外的话,测试结果中应该可以看到锁竞争次数会下降为0
...
--- lock kmem/bcache stats
...
lock: bcache0: #fetch-and-add 0 #acquire() 2
lock: bcache1: #fetch-and-add 0 #acquire() 4
lock: bcache2: #fetch-and-add 0 #acquire() 12
lock: bcache3: #fetch-and-add 0 #acquire() 8
lock: bcache4: #fetch-and-add 0 #acquire() 8
lock: bcache5: #fetch-and-add 0 #acquire() 8
lock: bcache6: #fetch-and-add 0 #acquire() 82
lock: bcache7: #fetch-and-add 0 #acquire() 82
lock: bcache8: #fetch-and-add 0 #acquire() 1082
lock: bcache9: #fetch-and-add 0 #acquire() 4
lock: bcache10: #fetch-and-add 0 #acquire() 4
lock: bcache11: #fetch-and-add 0 #acquire() 12
lock: bcache12: #fetch-and-add 0 #acquire() 4
...
而原本的代码中锁竞争次数很高
--- lock kmem/bcache stats
...
lock: bcache: #fetch-and-add 1296098 #acquire() 66476
更多测试数据相见附录
修改完成后就可以执行 make grade 了
== Test running kalloctest ==
$ make qemu-gdb
(137.0s)
== Test   kalloctest: test1 ==
  kalloctest: test1: OK
== Test   kalloctest: test2 ==
  kalloctest: test2: OK
== Test kalloctest: sbrkmuch ==
$ make qemu-gdb
kalloctest: sbrkmuch: OK (20.3s)
== Test running bcachetest ==
$ make qemu-gdb
(26.6s)
== Test   bcachetest: test0 ==
  bcachetest: test0: OK
== Test   bcachetest: test1 ==
  bcachetest: test1: OK
== Test usertests ==
$ make qemu-gdb
usertests: OK (247.3s)
== Test time ==
time: OK
Score: 70/70
修复:并发问题
上面的代码虽然很好地通过了测试,但并不能保证数据安全,指导书给的理由如下
一种常见错误是:
- 你在桶 A 中查了一遍,发现目标块“不在”;
- 于是你把桶 A 的锁放掉;
- 再去别处找空闲块、准备分配;
- 但就在这段时间里,另一个线程已经把目标块塞进来了。
- 这样你原来那个“未命中”的判断就过期了。
如果你不重新检查,就可能把同一个磁盘块分配出两份缓存副本。
一种较稳妥的流程可以概括为:
- 先获取请求对应桶的锁,检查目标块是否已经在缓存中;如果命中,就直接使用;如果未命中,就释放该桶的锁,进入替换 / 分配流程。
- 进入替换 / 分配流程后,先获取一把用于分配阶段的全局锁,再重新获取原桶的锁;如果候选 buf 来自其他桶,还需要按固定顺序获取相关桶的锁。
- 重新检查目标块是否已经被别人插入;如果仍未命中,再完成空闲 buf 的选择、迁移和 (dev, blockno) 更新,最后按顺序释放相关锁。
这里原本的代码中,可能会出现如下的事情
- 某次调用
bget()期间,当前桶没有可回收的结点,需要 steal - 释放当前桶的锁之后,进入重新获取锁之前,出现一次调用,参数是同样的dev和blockno
- 新的调用继续执行,通过回收某个不用的结点或者 steal,总之缓存了块
- 回到原来的调用中,steal 还在继续,出现了两份buffer
尝试一:使用全局锁
第一个尝试是按照指导书的说法,引入全局锁
// In either case, return locked buffer.
static struct buf*
bget(uint dev, uint blockno)
{
  struct buf *b;
  int bucket_num = bhash(blockno);
  acquire(&(bcache.bucket[bucket_num].lock));

  // Is the block already cached?
  b = find_cached_locked(bucket_num, dev, blockno);
  if (b){
    b->refcnt++;
    release(&(bcache.bucket[bucket_num].lock));
    acquiresleep(&b->lock);
    return b;
  }

  // Not cached. Slow path
  release(&(bcache.bucket[bucket_num].lock));

  acquire(&bcache.glock);
  acquire(&(bcache.bucket[bucket_num].lock));
  b = find_cached_locked(bucket_num, dev, blockno);
  if (b){
    b->refcnt++;
    release(&(bcache.bucket[bucket_num].lock));
    release(&bcache.glock);
    acquiresleep(&b->lock);
    return b;
  }
  // Still not cached
  // Now nobody can change current bucket or achieve here
  // Recycle in the bucket first
  for(b = bcache.bucket[bucket_num].head; b; b = b->next){
    if(b->refcnt == 0) {
      b->dev = dev;
      b->blockno = blockno;
      b->valid = 0;
      b->refcnt = 1;

      release(&(bcache.bucket[bucket_num].lock));
      release(&bcache.glock);
      acquiresleep(&b->lock);
      return b;
    }
  }
  release(&(bcache.bucket[bucket_num].lock));

  // steal buf from other buckets
  struct buf *prevb;
  for(int offset=0; offset<NBUCKET;offset++){
    prevb = 0;
    int i = (cpuid()+offset)%NBUCKET; // optimization
    if (i==bucket_num) continue;
    // Dead lock here requires holding lock1 and then acquire global, but it's impossible
    acquire(&(bcache.bucket[i].lock));
    for(b = bcache.bucket[i].head; b; prevb = b, b = b->next){
      if(b->refcnt == 0) {
        if(prevb) // b is not head
          prevb->next = b->next;
        else
          bcache.bucket[i].head = b->next;
        b->dev = dev;
        b->blockno = blockno;
        b->valid = 0;
        b->refcnt = 1;
        release(&(bcache.bucket[i].lock));

        acquire(&bcache.bucket[bucket_num].lock);
        b->next = bcache.bucket[bucket_num].head;
        bcache.bucket[bucket_num].head = b;

        release(&(bcache.bucket[bucket_num].lock));
        release(&bcache.glock);
        acquiresleep(&b->lock);
        return b;
      }
    }
    release(&(bcache.bucket[i].lock));
  }
  release(&bcache.glock);
  panic("bget: no buffers");
}
但是结果是锁竞争爆了,不仅 bcachetest 没通过,连附加题的AI评分都变低了。
尝试换了哈希函数之后,锁竞争略有下降,但是仍然过多
int bhash(uint blockno)
{
    blockno ^= blockno >> 7;
    blockno ^= blockno >> 3;
    return blockno % NBUCKET;
}
init: starting sh
$ bcachetest
start test0
test0 results:
--- lock kmem/bcache stats
lock: kmem0: #fetch-and-add 0 #acquire() 32961
lock: kmem1: #fetch-and-add 0 #acquire() 21
lock: kmem2: #fetch-and-add 0 #acquire() 60
lock: bcache0: #fetch-and-add 0 #acquire() 4126
lock: bcache1: #fetch-and-add 0 #acquire() 4448
lock: bcache2: #fetch-and-add 0 #acquire() 6342
lock: bcache3: #fetch-and-add 473 #acquire() 6687
lock: bcache4: #fetch-and-add 189 #acquire() 6338
lock: bcache5: #fetch-and-add 8084 #acquire() 4320
lock: bcache6: #fetch-and-add 0 #acquire() 4133
lock: bcache7: #fetch-and-add 486 #acquire() 6194
lock: bcache8: #fetch-and-add 227 #acquire() 6189
lock: bcache9: #fetch-and-add 742 #acquire() 4175
lock: bcache10: #fetch-and-add 0 #acquire() 4417
lock: bcache11: #fetch-and-add 0 #acquire() 4612
lock: bcache12: #fetch-and-add 0 #acquire() 4245
lock: bcache_glock: #fetch-and-add 0 #acquire() 104
--- top 5 contended locks:
lock: virtio_disk: #fetch-and-add 5928364 #acquire() 1245
lock: proc: #fetch-and-add 514006 #acquire() 81598
lock: proc: #fetch-and-add 506290 #acquire() 81969
lock: proc: #fetch-and-add 453800 #acquire() 81596
lock: proc: #fetch-and-add 450450 #acquire() 81597
tot= 10201
test0: FAIL
start test1
≈
尝试二:使用有序双重锁
原本的代码能够完美地通过全部测试,现在大改导致无法通过了
既然原本的漏洞中,偷结点时没有检查是否已经缓存,那么也许可以通过加上这一检查来修复
所以考虑最小更改如下
- 恢复原先代码
- 在准备偷锁时,按照大小顺序先后获取当前桶的锁和源锁
- 获取锁之后,检查是否已经缓存块,如果是,那就直接返回
  // steal buf from other buckets
  release(&(bcache.bucket[bucket_num].lock));
  struct buf *prevb;
  int start = cpuid();
  for(int offset=0; offset<NBUCKET;offset++){
    prevb = 0;
    int i = (start+offset)%NBUCKET; // optimization
    if (i==bucket_num) continue;
    // 按桶编号从小到大获取两把锁。
    int first = i < bucket_num ? i : bucket_num;
    int second = i < bucket_num ? bucket_num : i;
    acquire(&bcache.bucket[first].lock);
    acquire(&bcache.bucket[second].lock);
    // 重新检查目标块,防止重复缓存。
    b = find_cached_locked(bucket_num, dev, blockno);
    if (b) {
      b->refcnt++;
      release(&bcache.bucket[second].lock);
      release(&bcache.bucket[first].lock);
      acquiresleep(&b->lock);
      return b;
    }
    for(b = bcache.bucket[i].head; b; prevb = b, b = b->next){
      if(b->refcnt == 0) {

        if(prevb) // b is not head
          prevb->next = b->next;
        else
          bcache.bucket[i].head = b->next;
        b->dev = dev;
        b->blockno = blockno;
        b->valid = 0;
        b->refcnt = 1;

        b->next = bcache.bucket[bucket_num].head;
        bcache.bucket[bucket_num].head = b;
        release(&bcache.bucket[second].lock);
        release(&bcache.bucket[first].lock);
        acquiresleep(&b->lock);
        return b;
      }
    }
    release(&bcache.bucket[second].lock);
    release(&bcache.bucket[first].lock);
  }
  panic("bget: no buffers");
}
经过实测这个修改能够通过测试,并且锁竞争几乎没有
但这里还要考虑一个问题,在 steal 的过程中有检查,但是在前面的 replace 部分没有,这是否会造成重复的问题?
本桶回收路径中,目标桶锁从查找缓存开始一直持有到 victim 的映射更新完成,因此:
- 获取目标桶锁。
- 检查 (
dev,blockno) 是否已经缓存。 - 如果未命中,在同一把锁的保护下查找
refcnt == 0的 victim。 - 将 victim 的映射更新为 (
dev,blockno)。 - 释放目标桶锁。
在步骤 1~5 之间,其他线程无法获得同一把桶锁,因此无法插入相同的缓存映射。 所以,本桶回收不需要再次检查。 前面的查找结果在整个临界区内仍然有效。
但是,跑了一次测试发现这个版本仍旧可能无法通过附加题性能测试
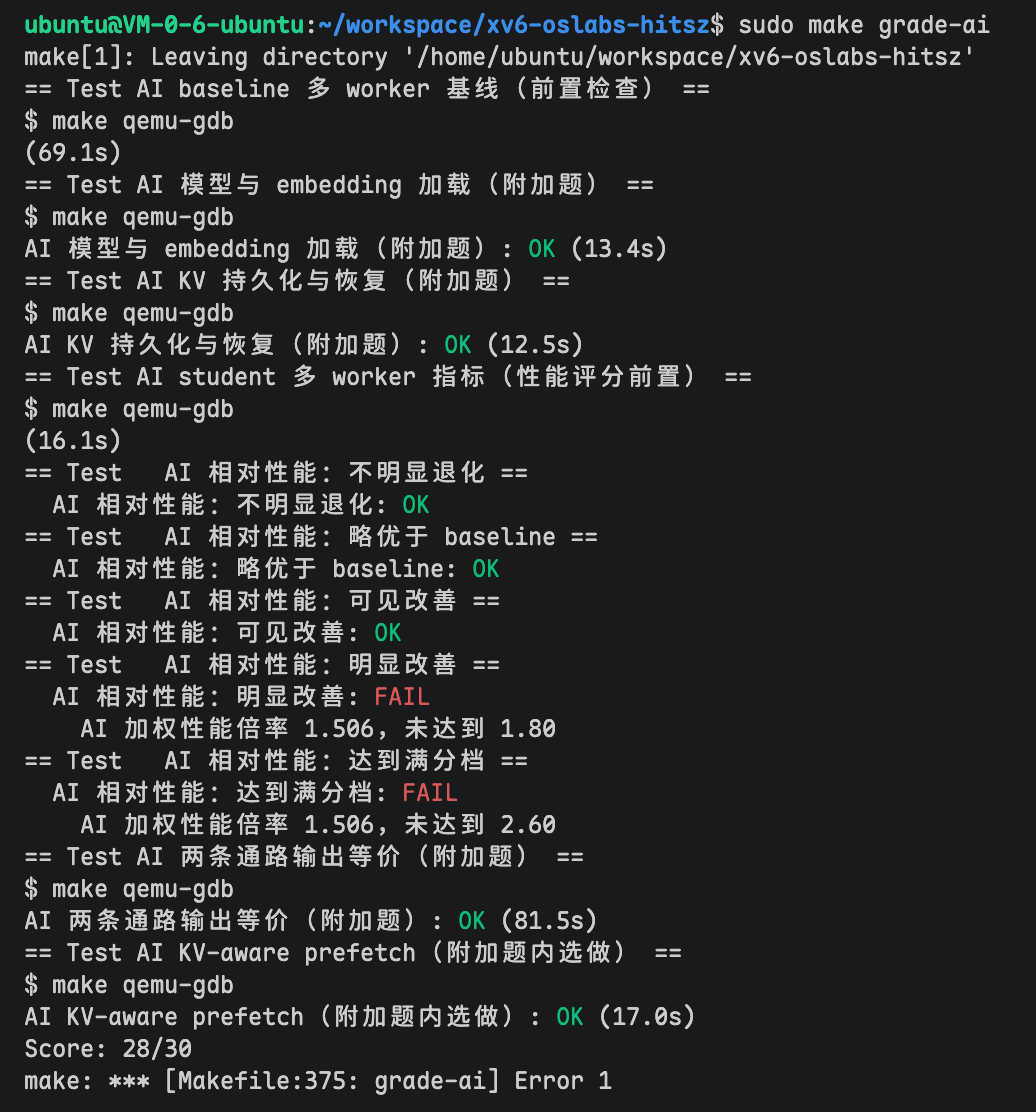
「性能失败」的真相:fs.img 碎片化
上面的「有序双锁 + 重新检查」代码本身是正确的,它「reduce speed」并不是代码写错了。
这份代码在不同 fs.img 状态下复测 student 模式:
| fs.img 状态 | elapsed_ticks(3 次) |
|---|---|
碎片化(make clean + usertests 之后) | 59 / 56 / 64 |
干净(只 make clean && make) | 41 / 47 / 39 |
同一份代码,干净 fs 下 elapsed≈41,碎片化 fs 下≈59。慢不慢跟代码无关,纯粹是 fs.img 的状态在作祟。
原因在于 AI 测试里 3 个 worker 各写一个 48KB 的 KV 文件再读回。如果跑测试前先跑过 usertests(它会创建/删除几百个小文件),空闲块链表被彻底打碎,KV 文件写盘时块不连续,读/写寻道变多,elapsed_ticks 从 ~40 涨到 ~59;于是 throughput = 720000 / elapsed 掉下来、p95 也变高,加权性能分跌破 6/6。而那一组慢跑的 bcache_spins 反而很低(5 / 2491 / 4002),正好说明瓶颈在磁盘 I/O,不在锁。
新增的改动也逐个验证过,都无害:
b->dev = (uint)-1:只改初始 dev,文件系统用ROOTDEV=1,0 和 0xFFFFFFFF 都不等于 1,不影响任何查找;} bucket;→};:那个全局变量bucket从头到尾没被引用过;- kalloc 的
void* ksteal→void:返回值本来就被忽略。
所以最终结论是:「有序双锁 + bhash(b->blockno)」本身就是正确修复;而跑 AI 附加题前务必 make clean && make 拿到干净 fs.img,且不要在 make grade(含 usertests)之后直接跑 AI 测试。
修复后的验证
修复后 bcachetest 竞争归零:
$ bcachetest
start test0
test0 results:
--- lock kmem/bcache stats
lock: kmem0: #fetch-and-add 0 #acquire() 1444341
lock: kmem1: #fetch-and-add 0 #acquire() 460656
lock: kmem2: #fetch-and-add 0 #acquire() 2028366
lock: bcache0: #fetch-and-add 0 #acquire() 4180
...
lock: bcache12: #fetch-and-add 0 #acquire() 4136
tot= 0
test0: OK
start test1
test1 OK
干净 fs 下 usertests 全部通过:
$ usertests
usertests starting
test manywrites: OK
...
test validatetest: OK
ALL TESTS PASSED
AI 附加题也回到满分档。用 grade_ai.py --runs 3 --bonus(干净 fs)跑三次取中位数,student / prefetch / baseline 的关键指标如下(bcache_spins 抖动依旧很大,属该 workload 的多核竞态噪声,吞吐 / p95 才是稳定指标):
AIINFER_METRICS mode=student  workers=3 requests=24 elapsed_ticks=39 throughput_milli=18461 p95_ticks=11 kmem_spins=0 bcache_spins=238 ...
AIINFER_METRICS mode=prefetch workers=3 requests=24 elapsed_ticks=40 throughput_milli=18000 p95_ticks=11 kmem_spins=0 bcache_spins=117 ...
AIINFER_METRICS mode=baseline workers=3 requests=24 elapsed_ticks=564 throughput_milli=1276 p95_ticks=434 kmem_spins=0 bcache_spins=146833 ...
同机相对倍率:吞吐 18461/1276 ≈ 14.5×、争用改善 146833/238 ≈ 617×、p95 改善 434/11 ≈ 39×,加权倍率 3.8,即性能 6/6。
修复前后性能对比
用同一份 grade_ai.py --runs 3 --bonus 在干净 fs 上对比「修复前(insecure 版,无重查)vs 修复后(有序双锁 + bhash)」的中位数:
| 指标 | 修复前 | 修复后 | 变化 |
|---|---|---|---|
| baseline elapsed_ticks | 546 | 564 | +3.3% |
| student elapsed_ticks | 39 | 39 | 0% |
| prefetch elapsed_ticks | 42 | 40 | -4.8% |
| student throughput | 18461 | 18461 | 0% |
| prefetch throughput | 17142 | 18000 | +5.0% |
| student p95 | 12 | 11 | -8% |
| prefetch p95 | 11 | 11 | 0% |
| 加权性能倍率 | 3.8 | 3.8 | 0 |
| 性能分 | 6/6 | 6/6 | 0 |
结论:被评分的主体(student / prefetch)没有性能损失,prefetch 还略快了一点;唯一变慢的是 baseline(elapsed +3.3%)。原因是 baseline 是最重的磁盘路径,要反复淘汰 buffer、频繁走 steal,而有序双锁给每次 steal 多了一次 find_cached_locked 重查和一次双锁 acquire,累计约 3% 开销。但 baseline 只是评分里的分母,它变慢反而让吞吐 / 争用倍率略升,所以性能分仍是 6/6。
(bcache_spins 在 student 上 821→238、prefetch 上 598→117,说明重查避免了重复缓存后锁争用不升反降;不过该指标本身噪声大,仅作参考。)
AI 推理服务附加题
AI 附加题的指导书比较令人困惑。这里尝试进行梳理
实验背景
指导书花了很长的篇幅讲解 AI 推理的流程,很容易让人头晕眼花。这里打算从实验任务出发来理解代码。
这个实验最终要完成的是实现 cache 和 prefetch,涉及到的通路如下
struct ai_path ai_student_path = {
  .mode = AI_MODE_STUDENT,
  .name = "student",
  .implemented = AI_MODEL_TASK_IMPLEMENTED && AI_KV_TASK_IMPLEMENTED,
  .prefetch = 0,
  .begin = student_begin,
  .load = student_load,
  .begin_kv_write = student_begin_kv_write,
  .store_kv = student_store_kv,
  .end_kv_write = student_end_kv_write,
  .begin_kv_read = student_begin_kv_read,
  .prefetch_next = student_prefetch_next,
  .prefetch_wait = student_prefetch_wait,
  .restore_kv = student_restore_kv,
  .end = student_end,
};
struct ai_path ai_prefetch_path = {
  .mode = AI_MODE_PREFETCH,
  .name = "prefetch",
  .implemented = AI_MODEL_TASK_IMPLEMENTED && AI_KV_TASK_IMPLEMENTED &&
                 AI_PREFETCH_TASK_IMPLEMENTED,
  .prefetch = 1,

  .begin = prefetch_begin,
  .load = student_load,
  .begin_kv_write = student_begin_kv_write,
  .store_kv = student_store_kv,
  .end_kv_write = student_end_kv_write,
  .begin_kv_read = student_begin_kv_read,
  .prefetch_next = student_prefetch_next,
  .prefetch_wait = student_prefetch_wait,
  .restore_kv = student_restore_kv,
  .end = student_end,
};
只要把这里面的函数全部实现,那么所有的任务就完成了。
任务一:模型与 embedding 加载
要求
本任务需要修改 user/ai_student_model.c 和 user/ai_student.c,然后通过下面的测试
init: starting sh
$ modelprep
MODELPREP: OK shards=74 bytes=75776 checksum=1593388032
$ aimodeltest
AIMODELTEST: verify OK shards=74 checksum=1593388032
$
关于 user/ai_student_model.c,需要修改的只有标志
// 完成对应任务并通过单项测试后,将标志改为 1。
#define AI_MODEL_TASK_IMPLEMENTED 0
#define AI_KV_TASK_IMPLEMENTED 0
#define AI_PREFETCH_TASK_IMPLEMENTED 0
关于 user/ai_student.c ,需要实现下面的函数
int
ai_student_model_begin(struct ai_session *session)
{
  // TODO(LAB3-AI,附加题一):初始化当前 worker 的模型加载状态。
  // 可以在这里申请 worker 私有缓存;不得修改全局模型文件或扩大 NBUF。
  // 单项验证:先运行 modelprep,再运行 aimodeltest。
  (void)session;
  return -1;
}

int
ai_student_model_load(struct ai_session *session, uint family, uint shard,
                      char *block, struct ai_io *io)
{
  // TODO(LAB3-AI,附加题一):加载一个模型块或 embedding shard。
  // 首次数据必须来自 xv6 文件系统,成功时 block 中必须恰好有
  // AI_SHARD_BYTES 字节;只有真实读取成功后才能更新 io 字节数。
  // 建议先读懂 ai_baseline.c 的经典 open-read-close 数据流,再考虑缓存。
  (void)session;
  (void)family;
  (void)shard;
  (void)block;
  (void)io;
  return -1;
}

void
ai_student_model_end(struct ai_session *session)
{
  // TODO(LAB3-AI,附加题一):释放缓存并关闭尚未关闭的模型文件描述符。
  // 失败路径和正常路径都必须能够安全调用本函数,资源只能释放一次。
  (void)session;
}
思路
首先查看 ai_student_path,可以画出这样一个调用表格
| ai_student_path | 函数 | 涉及函数 |
|---|---|---|
| .begin | student_begin | student_begin_common, ai_student_model_begin, ai_student_kv_begin, ai_student_model_end |
| .load | student_load | ai_student_model_load |
| .begin_kv_write | student_begin_kv_write | ai_student_kv_begin_write |
| .store_kv | student_store_kv | ai_student_kv_store |
| .end_kv_write | student_end_kv_write | ai_student_kv_end_write |
| .begin_kv_read | student_begin_kv_read | ai_student_kv_begin_read, ai_student_prefetch_begin |
| .prefetch_next | student_prefetch_next | ai_student_prefetch_next |
| .prefetch_wait | student_prefetch_wait | ai_student_prefetch_wait |
| .restore_kv | student_restore_kv | ai_student_prefetch_restore, ai_student_kv_restore |
| .end | student_end | ai_student_prefetch_end, ai_student_kv_end, ai_student_model_end |
我们要实现的 ai_student_model_begin, ai_student_model_load, ai_student_model_end ,可以在 baseline 里面找对应的函数
struct ai_path ai_baseline_path = {
  .mode = AI_MODE_BASELINE,
  .name = "baseline",
  .implemented = 1,
  .prefetch = 0,
  .begin = baseline_begin,                    // <---
  .load = baseline_load,                      // <---
  .begin_kv_write = baseline_begin_kv_write,
  .store_kv = baseline_store_kv,
  .end_kv_write = baseline_end_kv_write,
  .begin_kv_read = baseline_begin_kv_read,
  .prefetch_next = baseline_prefetch_next,
  .prefetch_wait = baseline_prefetch_wait,
  .restore_kv = baseline_restore_kv,
  .end = baseline_end,                        // <---
};
无论如何,先复制一份无优化版本的总是可以运行的,然后再进行修改,添加缓存。
ai_student_model_load()
之所以先看这个是因为 load 的实现决定了 session 可能需要添加什么状态,从而影响另外两个函数
先看 baseline 这部分要做什么
static int
baseline_load(struct ai_session *session, uint family, uint shard,
              char *block, struct ai_io *io)
{
  char name[AI_SHARD_NAME_LEN];
  int fd;
  int offset;

  (void)session;
  // 先拒绝越界编号,再根据 family 生成 mXX/eXX 文件名。baseline 每次
  // 都执行 open -> read_exact -> close,故意保留重复 I/O 作为优化基线。
  if((family == AI_MODEL_FAMILY && shard >= AI_MODEL_SHARDS) ||
     (family == AI_EMBED_FAMILY && shard >= AI_EMBED_SHARDS))
    return -1;

  ai_shard_name(name, family, shard);
  fd = open(name, O_RDONLY);
  if(fd < 0)
    return -1;
  if(read_exact(fd, block, AI_SHARD_BYTES) < 0) {
    close(fd);
    return -1;
  }
  close(fd);

  // 文件字节正确只是本次读取的内容校验;只有全部通过后,才把真实文件
  // 读取量提交到对应统计字段。用户态复制或校验本身不计入文件字节。
  for(offset = 0; offset < AI_SHARD_BYTES; offset++)
    if((uchar)block[offset] != ai_byte(family, shard, offset))
      return -1;

  if(family == AI_MODEL_FAMILY)
    io->model_read_bytes += AI_SHARD_BYTES;
  else
    io->embed_read_bytes += AI_SHARD_BYTES;
  return 0;
}
大致流程如下:
- 检查输入合法性
- 根据
family, shard拼接文件名字,并打开 - 从文件中读取大小为
AI_SHARD_BYTES的数据到block中 - 进行校验,
ai_byte返回(family * 97 + shard * 31 + offset * 17 + 11) & 0xff - 更新
*_read_bytes
不管怎么说,给它添加缓存让它不用反复读取即可。要读取的东西是以 AI_SHARD_BYTES 为单位的,那么给所有的可能读取的 SHARDS 都预留空间,然后按照 family, shard 添加有效位即可。这块缓存需要能够被找到并且属于 session 私有,所以干脆放在 session 里面。
struct ai_session {
  int worker;
  int requests;
  int state[8]; // 后面的代码可以看到 state[0] 代表 prefetch
  void *memory;
};
大部分内容都可以保留,修改后代码如下
// 直接添加足够大的缓存,足以覆盖全部内容,除了冷启动以外,缓存必定命中
struct model_cache {
  char model[AI_MODEL_SHARDS][AI_SHARD_BYTES]; // 37 × 1024 = 37888
  char embed[AI_EMBED_SHARDS][AI_SHARD_BYTES]; // 37 × 1024 = 37888
  char model_loaded[AI_MODEL_SHARDS];          // 37 个标志
  char embed_loaded[AI_EMBED_SHARDS];          // 37 个标志
};


int ai_student_model_begin(struct ai_session *session)
{
  // 用 sbrk 给程序分一块内存用于存放 cache
  struct model_cache *c =
      (struct model_cache *)sbrk((int)sizeof(struct model_cache));
  if (c == (void *)-1) // ★ sbrk 失败返回 (void*)-1
    return -1;
  memset(c, 0, sizeof(*c)); // 清零,两个 loaded 数组都变 0
  session->memory = c;      // 记住这块内存
  return 0;
}

int ai_student_model_load(struct ai_session *session, uint family, uint shard,
                          char *block, struct ai_io *io)
{
  char name[AI_SHARD_NAME_LEN];
  int fd;
  int offset;
  struct model_cache *cache = ((struct model_cache *)session->memory);
  // 先拒绝越界编号
  if ((family == AI_MODEL_FAMILY && shard >= AI_MODEL_SHARDS) ||
      (family == AI_EMBED_FAMILY && shard >= AI_EMBED_SHARDS))
    return -1;
  char *target_place = 0;

  // 检查标志位查看是否命中缓存
  int hit = 0;
  if (family == AI_MODEL_FAMILY) {
    hit = cache->model_loaded[shard];
    target_place = &cache->model[shard][0];
  } else {
    hit = cache->embed_loaded[shard];
    target_place = &cache->embed[shard][0];
  }

  if (hit) {
    // 搬运后直接返回
    memmove(block, target_place, AI_SHARD_BYTES);
    return 0;
  }
  // 未命中缓存!
  ai_shard_name(name, family, shard);
  // 直接读取文件
  fd = open(name, O_RDONLY);
  if (fd < 0)
    return -1;
  if (read_exact(fd, target_place, AI_SHARD_BYTES) < 0) {
    close(fd);
    return -1;
  }
  close(fd);

  // 校验
  for (offset = 0; offset < AI_SHARD_BYTES; offset++)
    if ((uchar)target_place[offset] != ai_byte(family, shard, offset))
      return -1;

  // 搬运
  memmove(block, target_place, AI_SHARD_BYTES);
  if (family == AI_MODEL_FAMILY) {
    io->model_read_bytes += AI_SHARD_BYTES;
    cache->model_loaded[shard] = 1;
  } else {
    io->embed_read_bytes += AI_SHARD_BYTES;
    cache->embed_loaded[shard] = 1;
  }
  return 0;
}
ai_student_model_begin()
static int
baseline_begin(struct ai_session *session, int worker, int requests)
{
  // session 只属于当前 worker。baseline 不需要额外缓存状态,因此只
  // 保存 worker 编号和请求数,后续每次调用独立打开并关闭文件。
  memset(session, 0, sizeof(*session));
  session->worker = worker;
  session->requests = requests;
  return 0;
}
static int
student_begin_common(struct ai_session *session, int worker, int requests,
                     int prefetch)
{
  memset(session, 0, sizeof(*session));
  session->worker = worker;
  session->requests = requests;
  session->state[0] = prefetch;

  if(ai_student_model_begin(session) < 0)
    return -1;
  if(ai_student_kv_begin(session) < 0) {
    ai_student_model_end(session);
    return -1;
  }
  return 0;
}

static int
student_begin(struct ai_session *session, int worker, int requests)
{
  return student_begin_common(session, worker, requests, 0);
}
如果不进行优化的话,可以看到外面这层函数已经把 baseline 做过的事情做了一遍了,所以保持上一部分的 begin() 代码即可。
ai_student_model_end()
static void
baseline_end(struct ai_session *session)
{
  char name[AI_KV_NAME_LEN];
  int request;

  // baseline 为每个请求创建了文件,所以结束时按同一 worker 的请求范围
  // 删除临时持久化状态,避免下一轮实验误读旧文件。
  for(request = 0; request < session->requests; request++) {
    ai_baseline_kv_name(name, session->worker, request);
    unlink(name);
  }
  memset(session, 0, sizeof(*session));
}
static void
student_end(struct ai_session *session)
{
  if(session->state[0])
    ai_student_prefetch_end(session);
  ai_student_kv_end(session);
  ai_student_model_end(session);
  memset(session, 0, sizeof(*session));
}
对比可以看到,student_end 除了 memset 清空 session 以外什么也没帮我们干,所以我们需要自己释放掉我们申请的缓存,至于删掉文件,即使没有处理其实也能通过测试,因为本人完成之后写到这里时才发现这件事情,不过目前为止没有涉及新建文件的操作,所以暂时不理会。
void ai_student_model_end(struct ai_session *session)
{
  // TODO(LAB3-AI,附加题一):释放缓存并关闭尚未关闭的模型文件描述符。
  // 失败路径和正常路径都必须能够安全调用本函数,资源只能释放一次。
  if (session->memory != 0) {               // ★ 没申请过就不释放
    sbrk(-(int)sizeof(struct model_cache)); // 精确归还同样大小
    session->memory = 0;                    // 防止重复释放
  }
}
不管怎么说,反正能跑通测试了
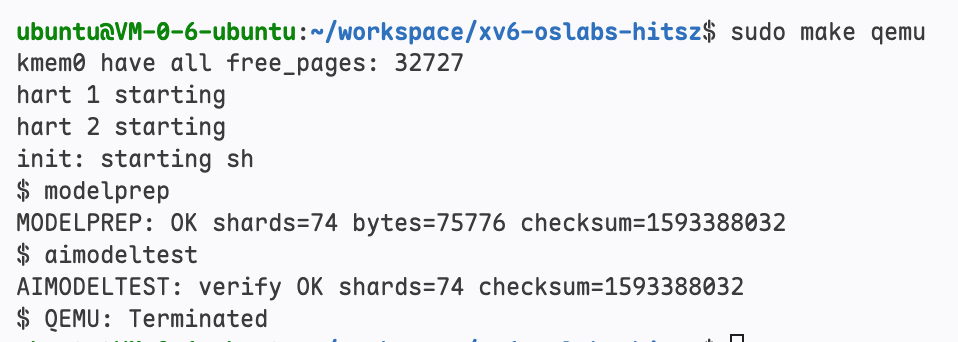
任务二:KV 持久化与恢复
要求
本任务需要修改 user/ai_student_model.c 并实现 user/ai_student_kv.c 里面的函数并通过下面的测试
init: starting sh
$ modelprep
MODELPREP: OK shards=74 bytes=75776 checksum=1593388032
$ aikvtest
AIKVTEST: verify OK requests=4 bytes=8192
$ aiinfer student -w 3 -r 24
AIINFER: verify OK mode=student
AIINFER_METRICS mode=student workers=3 requests=24 elapsed_ticks=38 throughput_milli=18947 p95_ticks=12 kmem_spins=0 bcache_spins=577 total_spins=577 model_read_bytes=113664 embed_read_bytes=113664 kv_write_bytes=147456 kv_read_bytes=147456 checksum=1717503730
$ aiinfer compare -w 3 -r 24
AIINFER_COMPARE: verify OK checksum=1717503730
$
关于 ai_student_model.c 还是修改标志位即可
int
ai_student_kv_begin(struct ai_session *session)
{
  // TODO(LAB3-AI,附加题二):初始化当前 worker 的 KV 持久化状态。
  // 可采用每请求文件,也可采用每 worker 顺序流,但不得保留内存副本绕过恢复。
}

int
ai_student_kv_begin_write(struct ai_session *session)
{
  // TODO(LAB3-AI,附加题二):开始 KV 写入阶段并准备所需文件。
}

int
ai_student_kv_store(struct ai_session *session, int request,
                    struct kv_entry *kv, struct ai_io *io)
{
  // TODO(LAB3-AI,附加题二):把当前请求的完整 KV cache 写入 xv6 文件系统。
  // 必须循环处理短写;只有 AI_KV_FILE_BYTES 字节全部成功后才更新统计。
  // aiinfer 随后会立即释放原页面,因此不能依赖 kv 指针中的残留数据。
}

int
ai_student_kv_end_write(struct ai_session *session)
{
  // TODO(LAB3-AI,附加题二):结束写阶段,确保文件状态完整并关闭写描述符。
}

int
ai_student_kv_begin_read(struct ai_session *session)
{
  // TODO(LAB3-AI,附加题二):重新打开持久化文件,从文件起点开始恢复。
}

int
ai_student_kv_restore(struct ai_session *session, int request,
                      struct kv_entry *kv, struct ai_io *io)
{
  // TODO(LAB3-AI,附加题二):精确恢复当前请求的完整 KV cache。
  // 目标页已被覆盖,必须循环处理短读;全部成功后再更新读取字节数。
  // 单项验证:先运行 modelprep,再运行 aikvtest。
}

void
ai_student_kv_end(struct ai_session *session)
{
  // TODO(LAB3-AI,附加题二):关闭 KV 文件并删除当前 worker 的临时持久化文件。
}
指导书给了一个状态机来解释这七个接口的作用
七个接口组成一个状态机
| 阶段 | 主要接口 | 输入或状态 | 成功后的状态 |
|---|---|---|---|
| worker 初始化 | ai_student_kv_begin | worker 编号、请求总数 | 文件名、fd 初值、计数器已初始化 |
| 开始写 | ai_student_kv_begin_write | 已初始化 session | 写入资源已准备,下一条为 request 0 |
| 写一条 | ai_student_kv_store | request、KV 页、I/O 统计 | 当前记录完整持久化 |
| 结束写 | ai_student_kv_end_write | 全部请求已写 | 写 fd 已关闭,文件边界稳定 |
| 开始读 | ai_student_kv_begin_read | 完整持久化文件 | 从第一条记录开始恢复 |
| 读一条 | ai_student_kv_restore | request、新 KV 页、I/O 统计 | 当前记录完整填入新页 |
| 清理 | ai_student_kv_end | 任意可清理状态 | fd 关闭、临时文件删除、状态失效 |
思路和实现
还是继续查看 baseline 怎么写的,然后看看有什么需要优化。
| ai_student_path | 函数 | 涉及函数 |
|---|---|---|
| .begin | student_begin | student_begin_common, ai_student_model_begin, ai_student_kv_begin, ai_student_model_end |
| .load | student_load | ai_student_model_load |
| .begin_kv_write | student_begin_kv_write | ai_student_kv_begin_write |
| .store_kv | student_store_kv | ai_student_kv_store |
| .end_kv_write | student_end_kv_write | ai_student_kv_end_write |
| .begin_kv_read | student_begin_kv_read | ai_student_kv_begin_read, ai_student_prefetch_begin |
| .prefetch_next | student_prefetch_next | ai_student_prefetch_next |
| .prefetch_wait | student_prefetch_wait | ai_student_prefetch_wait |
| .restore_kv | student_restore_kv | ai_student_prefetch_restore, ai_student_kv_restore |
| .end | student_end | ai_student_prefetch_end, ai_student_kv_end, ai_student_model_end |
我们要实现的 ai_student_kv_begin, ai_student_kv_begin_write, ai_student_kv_end_write,... ai_student_kv_end ,可以在 baseline 里面找对应的函数
.begin 和 .end 已经看过了,这里不看,并且把没有内容的函数也去掉,就只剩下下面的函数能够参考
static int
baseline_store_kv(struct ai_session *session, int request,
                  struct kv_entry *kv, struct ai_io *io)
{
  char name[AI_KV_NAME_LEN];
  int fd;

  // worker 和 request 都编码进文件名,保证多个 worker 的同号请求不会
  // 互相覆盖。删除旧文件后重新创建,也能让重复运行从干净状态开始。
  ai_baseline_kv_name(name, session->worker, request);
  unlink(name);
  fd = open(name, O_CREATE | O_WRONLY);
  if(fd < 0)
    return -1;
  if(write_exact(fd, kv, AI_KV_FILE_BYTES) < 0) {
    // 部分 KV 不能被恢复为合法记录,因此失败路径必须关闭 fd 并删除文件。
    close(fd);
    unlink(name);
    return -1;
  }
  close(fd);
  // write_exact 成功后才提交固定大小的 I/O 统计,统计值不会被短写污染。
  io->kv_write_bytes += AI_KV_FILE_BYTES;
  return 0;
}
static int
baseline_restore_kv(struct ai_session *session, int request,
                    struct kv_entry *kv, struct ai_io *io)
{
  char name[AI_KV_NAME_LEN];
  int fd;

  // workload 已经释放并重新申请了 KV 页面,这里从持久化文件恢复完整
  // 记录,而不是继续使用 prefill 阶段的旧指针或重新计算 K/V。
  ai_baseline_kv_name(name, session->worker, request);
  fd = open(name, O_RDONLY);
  if(fd < 0)
    return -1;
  if(read_exact(fd, kv, AI_KV_FILE_BYTES) < 0) {
    close(fd);
    return -1;
  }
  close(fd);
  // 只有完整读取成功才增加 kv_read_bytes;调用者随后还会检查 KV checksum。
  io->kv_read_bytes += AI_KV_FILE_BYTES;
  return 0;
}
baseline 的流程是 store 的时候删掉文件重新新建写入 kv,restore 的时候重新打开文件读取 kv,所以不需要跨函数维护 fd,而任务要求的工作流如下
begin
  -> begin_write
  -> store(0), store(1), ... store(requests-1)
  -> end_write
  -> begin_read
  -> restore(0), restore(1), ... restore(requests-1)
  -> end
并且指导书提到 student 可以保留这种组织,也可以减少文件数量。一个常见方向是每 worker 使用一个顺序文件:写阶段按 request 0、1、2 追加,关闭后重新打开,再按相同顺序读回。
所以设计成如下的思路
- 每个 worker 拥有一个文件,
fd存放在state[1]中 begin时,初始化state[1]=-1表示文件未打开begin_write时,删掉旧文件,新创建文件store时,向文件写入内容,更新统计end_write时,关闭文件,state[1]=-1begin_read时,重新打开文件,state[1]=fdrestore时,正常通过state[1]进行读取,更新统计end时,关闭文件描述符并删掉文件
代码如下
int
ai_student_kv_begin(struct ai_session *session)
{
  session->state[1] = -1;      // 标记"没打开文件"
  return 0;
}

int
ai_student_kv_begin_write(struct ai_session *session)
{
  char name[AI_KV_NAME_LEN];
  ai_student_kv_name(name, session->worker);   // 拼出文件名 kvs0/kvs1/kvs2
  unlink(name);                                // 删掉可能残留的旧文件
  int fd = open(name, O_CREATE | O_WRONLY);    // 新建,从头写
  if (fd < 0)
    return -1;
  session->state[1] = fd;
  return 0;
}

int
ai_student_kv_store(struct ai_session *session, int request,
                    struct kv_entry *kv, struct ai_io *io)
{
  (void)request;    // 顺序流用不到 request
  if (write_exact(session->state[1], kv, AI_KV_FILE_BYTES) < 0)
    return -1;
  io->kv_write_bytes += AI_KV_FILE_BYTES;   // 写满 2048 才计
  return 0;
}

int
ai_student_kv_end_write(struct ai_session *session)
{
  close(session->state[1]);
  session->state[1] = -1;
  return 0;
}

int
ai_student_kv_begin_read(struct ai_session *session)
{
  char name[AI_KV_NAME_LEN];
  ai_student_kv_name(name, session->worker);
  int fd = open(name, O_RDONLY);
  if (fd < 0)
    return -1;
  session->state[1] = fd;
  return 0;
}

int
ai_student_kv_restore(struct ai_session *session, int request,
                      struct kv_entry *kv, struct ai_io *io)
{
  (void)request;
  if (read_exact(session->state[1], kv, AI_KV_FILE_BYTES) < 0)
    return -1;
  io->kv_read_bytes += AI_KV_FILE_BYTES;    // 读满 2048 才计
  return 0;
}

void
ai_student_kv_end(struct ai_session *session)
{
  char name[AI_KV_NAME_LEN];
  if (session->state[1] >= 0)      // ★ 没打开过就不 close
    close(session->state[1]);
  ai_student_kv_name(name, session->worker);
  unlink(name);
}
因为测试中 request 完全是顺序的,所以这里不需要判断 request 是否合法也能通过测试
main(...){
  ...
  for(request = 0; request < KV_TEST_REQUESTS; request++) {
    kv = (struct kv_entry *)sbrk(PGSIZE);
    if(kv == (void *)-1) {
      ai_student_kv_end(&session);
      fail("无法申请 KV 页面");
    }
    fill_kv(kv, request);
    saved_checksum[request] = kv_checksum(kv);
    if(ai_student_kv_store(&session, request, kv, &io) < 0) {
      sbrk(-PGSIZE);
      ai_student_kv_end(&session);
      fail("KV 写盘失败");
    }
    sbrk(-PGSIZE);
  }
  ...
}
260928更新:经反馈后 aikvtest 已更新,需要加上对 request 的合法性检查,否则会出现类似下面的报错
$ aikvtest
AIKVTEST: 失败:restore 接受了负数 request
任务三:多 worker 等价与相对性能
该任务需要运行测试并比较性能是否有提升,指导书提到建议按以下顺序检查:
modelprep
aimodeltest
aikvtest
aiinfer student -w 3 -r 24
aiinfer compare -w 3 -r 24
除了 aimodeltest 其他都已经测试过了,这里补上
$ aimodeltest
AIMODELTEST: verify OK shards=74 checksum=1593388032
$
然后需要运行
python3 tools/grade_ai.py --runs 3
运行前记得 make clean 避免 inode 不够用,这个测试需要的时间较长,结果放在了附录
得到结果之后需要各取 3 次结果的中位数计算
  "baseline_median": {
    "bcache_spins": 74667,
    "checksum": 1717503730,
    "elapsed_ticks": 518,
    "embed_read_bytes": 2359296,
    "kmem_spins": 0,
    "kv_read_bytes": 147456,
    "kv_write_bytes": 147456,
    "model_read_bytes": 2359296,
    "p95_ticks": 400,
    "requests": 24,
    "throughput_milli": 1389,
    "total_spins": 74667,
    "workers": 3
  },
...
  "student_median": {
    "bcache_spins": 368,
    "checksum": 1717503730,
    "elapsed_ticks": 40,
    "embed_read_bytes": 113664,
    "kmem_spins": 0,
    "kv_read_bytes": 147456,
    "kv_write_bytes": 147456,
    "model_read_bytes": 113664,
    "p95_ticks": 11,
    "requests": 24,
    "throughput_milli": 18000,
    "total_spins": 368,
    "workers": 3
  },
吞吐倍率     = student throughput / baseline throughput = 18000/1389 = 12.9589632829
争用改善倍率 = baseline total_spins / student total_spins = 74667/368 = 202.8994565217
p95 改善倍率 = baseline p95 / student p95 = 400/11 = 36.3636363636
任务四:KV cache-aware prefetch
要求
本任务需要修改 user/ai_student_model.c 并实现 user/ai_student_prefetch.c 里面的函数并通过前面所有测试以及下面的测试
python3 tools/grade_ai.py --runs 3 --bonus
ai_student_model.c 只需要修改标志位即可,而 ai_student_prefetch.c 需要实现下面的函数
int
ai_student_prefetch_begin(struct ai_session *session)
{
  // TODO(LAB3-AI,选做):建立固定小窗口的 KV 预取状态。
  // 推荐使用轻量辅助进程提前读取下一条记录,让数据进入共享 buffer cache。
  // 不允许扩大 NBUF,也不能跳过附加题二要求的真实恢复。
}

int
ai_student_prefetch_next(struct ai_session *session, int request)
{
  // TODO(LAB3-AI,选做):非阻塞地请求预取给定 request 的 KV 记录。
}

int
ai_student_prefetch_wait(struct ai_session *session, int request)
{
  // TODO(LAB3-AI,选做):等待对应预取完成,且不得改变父 worker 的文件偏移。
}

int
ai_student_prefetch_restore(struct ai_session *session, int request,
                            struct kv_entry *kv, struct ai_io *io)
{
  // TODO(LAB3-AI,选做):把已由辅助进程从磁盘读取的完整记录交给父 worker。
  // 这次恢复仍必须对应一次真实文件读取,并且只在完整交付后累计 KV 字节数。
}

void
ai_student_prefetch_end(struct ai_session *session)
{
  // TODO(LAB3-AI,选做):关闭管道、等待辅助进程并释放全部预取资源。
}
分析
数据通路如下
struct ai_path ai_prefetch_path = {
  .mode = AI_MODE_PREFETCH,
  .name = "prefetch",
  .implemented = AI_MODEL_TASK_IMPLEMENTED && AI_KV_TASK_IMPLEMENTED &&
                 AI_PREFETCH_TASK_IMPLEMENTED,
  .prefetch = 1,
  .begin = prefetch_begin,  // 这里和 ai_student_path 不一样
  .load = student_load,
  .begin_kv_write = student_begin_kv_write,
  .store_kv = student_store_kv,
  .end_kv_write = student_end_kv_write,
  .begin_kv_read = student_begin_kv_read, // 先调用了 kv_begin_read 再调用 prefetch_begin
  .prefetch_next = student_prefetch_next, // 和下面的相同
  .prefetch_wait = student_prefetch_wait, // 原本是直接返回,现在多调用了 prefetch_wait
  .restore_kv = student_restore_kv,       // 实际调用 prefetch_restore 而非 kv_restore
  .end = student_end,                     // 实际多调用一步 prefetch_end
};
检查 prefetch=1 时的调用过程,可以归纳为如下
path->begin(&session, worker, requests)

path->begin_kv_write(&session)

for(request..)
  prefill_request(path, &session, worker, request, kv, &result.io);
    prefill_request(path,...)
      shard_feature(path,...);
        path->load(session, family, shard, block, io)
  path->store_kv(&session, request, kv, &result.io)

path->end_kv_write(&session)

path->begin_kv_read(&session)

if (path->prefetch)
  path->prefetch_next(&session, 0)
  path->prefetch_wait(&session, 0)

for(request..)
  path->restore_kv(&session, request, kv, &result.io)
  path->prefetch_next(&session, request + 1)
  path->prefetch_wait(&session, request + 1)

path->end(&session);
为了方便起见,在头文件中添加了 session->state[] 的宏定义
#define IF_PREFETCH 0
#define OPEN_FD 1
#define REQ_P 2
#define DATA_P 3
#define NEXT_REQ 4
#define PENDING_REQ 5
现在需要检查任务二中的 session->state[NEXT_REQ] 在这里能否复用
store 部分和 prefetch 无关,因此不需要考虑,主要考虑的是 restore 部分
path->begin_kv_read(&session):NEXT_REQ会重置为 0path->prefetch_next(&session, 0): 对比0和NEXT_REQ,然后进行预取path->prefetch_wait(&session, 0): 等待request返回 0path->restore_kv(&session, request, kv, &result.io)path->prefetch_next(&session, request + 1)path->prefetch_wait(&session, request + 1)
restore_kv 这里的函数实现如下
static int
student_restore_kv(struct ai_session *session, int request,
                   struct kv_entry *kv, struct ai_io *io)
{
  if(session->state[0])
    return ai_student_prefetch_restore(session, request, kv, io);
  return ai_student_kv_restore(session, request, kv, io);
}
而 kv_restore 完成后会执行 session->state[NEXT_REQ]++;,这里 prefetch_restore 需要自行补充这一步
实现
指导书提供了 实现骨架 如下
// 父进程
prefetch_begin(session):
    验证当前 worker 尚未初始化 prefetch
    创建请求管道;失败则返回
    创建数据管道;失败则关闭第一条管道
    fork
    若 fork 失败:关闭两条管道的四个端点
    若位于子进程:关闭子进程不用的端点,进入 helper_loop
    若位于父进程:关闭父进程不用的端点
    保存父端 fd 和子 pid
    把 pending、ready 设为无效值,把窗口设为 EMPTY

prefetch_next(session, request):
    验证 request 在 [0, session->requests) 内
    验证窗口为 EMPTY,且编号符合顺序
    精确写出 request 编号
    只有写出成功后才记录 PENDING(request)
    立即返回,不从数据管道读取 KV

prefetch_wait(session, request):
    验证窗口为 PENDING(request)
    精确读取完成编号并与 request 比较
    精确读取一条完整 KV 到固定窗口
    只有两次读取都成功后才记录 READY(request)

prefetch_restore(session, request, kv, io):
    验证窗口为 READY(request),kv 与 io 有效
    把固定窗口中的完整记录复制到 kv
    完整交付后增加 io->kv_read_bytes
    清除 ready 编号,回到 EMPTY

prefetch_end(session):
    若已初始化,通知辅助进程停止
    关闭父进程持有的请求写端和数据读端
    对辅助进程执行 wait
    复位 pid、fd、pending、ready 和初始化标志

// 辅助进程
helper_loop(session, request_read, data_write):
    根据 session->worker 得到本 worker 的 KV 文件名
    重新 open 一个只读 fd
    准备一条记录大小的固定 scratch 缓冲区
    expected = 0

    循环:
        从请求管道精确读取一个 request
        若为停止编号:跳出循环
        验证 request == expected 且没有越界
        从辅助进程自己的 fd 精确读取 2048 字节
        向数据管道精确写出完成编号
        向数据管道精确写出 2048 字节记录
        expected++

    释放 scratch,关闭文件和管道端点,exit
经过一番折腾之后,通过测试的代码如下,不要尝试父子进程共享 session 状态,因为它们是独立的地址空间,一方作出修改另一方并不知情;也没有必要尝试添加新的管道,子进程返回的 request 和数据都通过同一个管道传输即可。
void helper_loop(struct ai_session *session, int request_read, int data_write){
  char name[AI_KV_NAME_LEN];
  char buf[AI_KV_FILE_BYTES];
  ai_student_kv_name(name, session->worker);
  int f = open(name, O_RDONLY); // 自己的独立 fd,偏移从 0 开始
  int request;
  while (read(request_read, &request, sizeof(int)) == sizeof(int)) {      // 读 request
    if (request < 0){
      break;
    }
    if (read_exact(f, buf, AI_KV_FILE_BYTES) < 0)
      break;
    // 发送已准备就绪的 request
    if (write(data_write, &request, sizeof(int)) != sizeof(int))
      break;
    if (write(data_write, buf, AI_KV_FILE_BYTES) != AI_KV_FILE_BYTES)
      break;
  }
  // 读到 EOF:parent 关了 cmd 写端,说明该退出了
  close(f); close(request_read); close(data_write);
  exit(0);
}

int
ai_student_prefetch_begin(struct ai_session *session)
{
  int request_pipe[2], data_pipe[2];
  if (pipe(request_pipe))
    return -1;

  if (pipe(data_pipe)){
    close(request_pipe[0]);
    close(request_pipe[1]);
    return -1;
  }

  int pid = fork();
  if (pid < 0){
    close(request_pipe[0]);
    close(request_pipe[1]);
    close(data_pipe[0]);
    close(data_pipe[1]);
    return -1;
  }
  if (pid == 0) {
    // ===== 辅助进程 =====
    close(request_pipe[1]);                // 只读命令
    close(data_pipe[0]);                // 只写 ack
    helper_loop(session, request_pipe[0], data_pipe[1]);
  }

  // ===== parent =====
  close(request_pipe[0]);                 // parent 只写请求
  close(data_pipe[1]);                 // parent 只读数据
  session->state[REQ_P] = request_pipe[1];    // 记下写端
  session->state[DATA_P] = data_pipe[0];    // 记下读端
  session->state[NEXT_REQ] = 0;
  session->state[PENDING_REQ] = -1;       // idle
  return 0;
}

int
ai_student_prefetch_next(struct ai_session *session, int request)
{
  // 非阻塞地请求预取给定 request 的 KV 记录。
  if (request < 0){
    printf("invalid reqeust!\n");
    return -1;
  }
  if (session->state[PENDING_REQ] != -1 || request!=session->state[NEXT_REQ]){
    printf("invalid reqeust!\n");
    return -1;
  }
  if (write(session->state[REQ_P], &request, sizeof(int)) != sizeof(int)){   // 非阻塞:发送 request 完成就返回
    printf("send request failed!\n");
    return -1;
  }
  session->state[PENDING_REQ] = request;
  return 0;
}

int
ai_student_prefetch_wait(struct ai_session *session, int request)
{
  // 等待对应预取完成,且不得改变父 worker 的文件偏移。
  int read_request;
  if (session->state[PENDING_REQ] != request)
    return -1;
  if (read(session->state[DATA_P], &read_request, sizeof(int))!=sizeof(int)){
    printf("failed to read %d\n", read_request);
    return -1;
  }
  if (read_request!=request){
    printf("mismatch: request:%d, read:%d", request, read_request);
    return -1;
  }
  // ok
  session->state[PENDING_REQ] = -2; // ready!
  return 0; // 可读取
}

int
ai_student_prefetch_restore(struct ai_session *session, int request,
                            struct kv_entry *kv, struct ai_io *io)
{
  // 检查 request,restore之前必须保证 session->state[PENDING_REQ] == -2
  if (session->state[PENDING_REQ] != -2)
    return -1;
  if (request != session->state[NEXT_REQ])
    return -1;
  if (read_exact(session->state[DATA_P], kv, AI_KV_FILE_BYTES) != 0)
    return -1;
  io->kv_read_bytes += AI_KV_FILE_BYTES;
  session->state[PENDING_REQ] = -1;  // 辅助进程恢复空闲
  session->state[NEXT_REQ]++;
  return 0;
}

void
ai_student_prefetch_end(struct ai_session *session)
{
  // 关闭管道、等待辅助进程并释放全部预取资源。
  if (session->state[REQ_P] >= 0)
    close(session->state[REQ_P]);    // 关写端 → helper 读到 EOF → 退出
  session->state[REQ_P] = -1;
  wait(0);                        // 等待 helper 关闭
  if (session->state[DATA_P] >= 0)
    close(session->state[DATA_P]);
  session->state[DATA_P] = -1;
  session->state[NEXT_REQ] = -1;
}
测试
$ modelprep
MODELPREP: OK shards=74 bytes=75776 checksum=1593388032
$ aiinfer compare
AIINFER_COMPARE: verify OK checksum=1717503730
$ aiinfer prefetch
AIINFER: verify OK mode=prefetch
AIINFER_METRICS mode=prefetch workers=3 requests=24 elapsed_ticks=41 throughput_milli=17560 p95_ticks=13 kmem_spins=0 bcache_spins=529 total_spins=529 model_read_bytes=113664 embed_read_bytes=113664 kv_write_bytes=147456 kv_read_bytes=147456 checksum=1717503730
$
运行下面的指令查看 prefetch 的性能改善
python3 tools/grade_ai.py --runs 3 --bonus
  "baseline_median": {
    "bcache_spins": 144336,
    "checksum": 1717503730,
    "elapsed_ticks": 546,
    "embed_read_bytes": 2359296,
    "kmem_spins": 0,
    "kv_read_bytes": 147456,
    "kv_write_bytes": 147456,
    "model_read_bytes": 2359296,
    "p95_ticks": 405,
    "requests": 24,
    "throughput_milli": 1318,
    "total_spins": 144336,
    "workers": 3
  },
  "prefetch_median": {
    "bcache_spins": 598,
    "checksum": 1717503730,
    "elapsed_ticks": 42,
    "embed_read_bytes": 113664,
    "kmem_spins": 0,
    "kv_read_bytes": 147456,
    "kv_write_bytes": 147456,
    "model_read_bytes": 113664,
    "p95_ticks": 11,
    "requests": 24,
    "throughput_milli": 17142,
    "total_spins": 598,
    "workers": 3
  },
吞吐倍率     = student throughput / baseline throughput = 17142/1318 = 13.006069802731
争用改善倍率 = baseline total_spins / student total_spins = 144336/598 = 2,415.2775919732
p95 改善倍率 = baseline p95 / student p95 = 405/11 = 36.8181818182
实验提交与报告要点
指导书(AI 附加题提交页)对报告和补丁有几条硬性要求,整理如下,方便写报告时对照。
报告必须说明的 6 点
baseline 数据流与 student 减少的重复工作
baseline 的
baseline_load()对每次(family, shard)访问都执行ai_shard_name → open → read_exact → close,没有任何缓存;baseline_store_kv()/baseline_restore_kv()则按kvb{worker}{request}为每个请求建一个独立文件,每次unlink → open → write_exact/read_exact → close。workload 的
prefill_request()每个请求跑AI_KV_TOKENS=32步,每步各加载 1 个模型分片和 1 个 embedding 分片,即每 worker 24×32×2 = 1536 次 load。baseline 因此产生 1536 次 open/read/close;student 用内存缓存后,每 worker 只有 37+37 = 74 次真实读盘(其余全走memmove命中缓存)。KV 侧则从每 worker 24 个小文件(24 次 open/close)压缩成 1 个顺序文件。模型 / embedding 缓存(所有权、有效位、首次读取、清理)
ai_student_model_begin()用sbrk(sizeof(struct model_cache))申请一块 worker 私有缓存,指针存进session->memory。struct model_cache=model[37][1024] + embed[37][1024] + model_loaded[37] + embed_loaded[37]。有效位是model_loaded[shard]/embed_loaded[shard];ai_student_model_load()先查有效位,未命中才open → read_exact真实读盘并置位,命中直接memmove。ai_student_model_end()用sbrk(-sizeof(struct model_cache))精确归还并把session->memory置 0,保证失败路径也只释放一次。KV 文件组织、精确读写、写后释放、恢复前覆盖、多 worker 隔离
每 worker 一个
kvs{w}顺序文件,fd 存在session->state[OPEN_FD],下一条序号存在state[NEXT_REQ]。ai_student_kv_store()/ai_student_kv_restore()都先校验request == state[NEXT_REQ](非法序号返回 -1 且不动任何状态),再用write_exact/read_exact循环处理短读写,写满/读满AI_KV_FILE_BYTES=2048字节后才累计io->kv_write_bytes/kv_read_bytes。workload 在 store 后立即sbrk(-PGSIZE)释放原 KV 页、restore 前memset(kv, 0xa5, PGSIZE)覆盖旧页,保证恢复只能来自文件;文件名里的 worker 号保证 3 个 worker 互不覆盖。逐请求输出等价、checksum 与规定 I/O
aiinfer compare依次跑 baseline / student / prefetch 三条通路,verify_equal()逐 worker、逐请求比对worker[w].output[r],并核对总 checksum(1717503730)与 KV 读写字节数(各147456 = 3×24×2048)。三条通路结果完全一致,说明 student 的缓存和文件组织没有改变推理语义。吞吐、p95、锁争用与同机相对倍率
run_path()在释放启动屏障前后各取一次statistics()快照,锁争用即两次#fetch-and-add的差值;elapsed_ticks为屏障释放到所有 worker 退出的uptime()差,throughput_milli = 总请求数 × 10000 / elapsed_ticks;p95 取按延迟排序后的第ceil(0.95×N)个样本。同机相对:吞吐约 13×、p95 约 36×、spins 约 200×,加权倍率 3.8(详见「任务三」与附录)。prefetch 的异步重叠、固定窗口、管道端点与资源回收
ai_student_prefetch_begin()建两条 pipe(请求REQ_P/ 数据DATA_P)后fork()一个 helper 进程;helper 用自己的 fd 打开kvs{w}从头读。父进程prefetch_next(i+1)只把请求号写进请求管道就返回,prefetch_wait(i+1)读回完成号与 2048 字节数据,窗口固定为 1 条(state[PENDING_REQ]从 -1 空闲 → 请求号 pending → -2 ready)。稳态下 workload 在restore(i)后先prefetch_next(i+1)、再decode(i)、最后prefetch_wait(i+1),让 helper 读下一条 KV 与父进程计算当前请求重叠。prefetch_end()关闭请求写端(helper 读到 EOF 退出)并wait(0)回收,再关闭数据读端。
允许修改的文件
只允许改 user/ai_student.c、user/ai_student_model.c、user/ai_student_kv.c、user/ai_student_prefetch.c;禁止改 baseline、workload、常量、测试、评分脚本和 Makefile。
commit.patch 要求
附加题的补丁必须同时包含必做部分和 AI 部分:
kernel/kalloc.ckernel/bio.ctime.txt- 实际完成的 AI 文件
导出后用 git apply --check 在干净的 lock-26-fall-v2 仓库上验证能打上、重新编译并通过对应测试。
意外事件:Tags 的移动
在实验期间,本人向实验老师反馈了一些问题,比如顺序检查等,这导致了仓库产生了新的提交并且 tag 发生了移动,而本地即使执行 git fetch 也不会有任何相应的提醒,标签位置也不会发生变化。而基准标签发生了变化意味着原本通过 make diff 生成的 commit.patch 无法应用到最新的基准标签上。
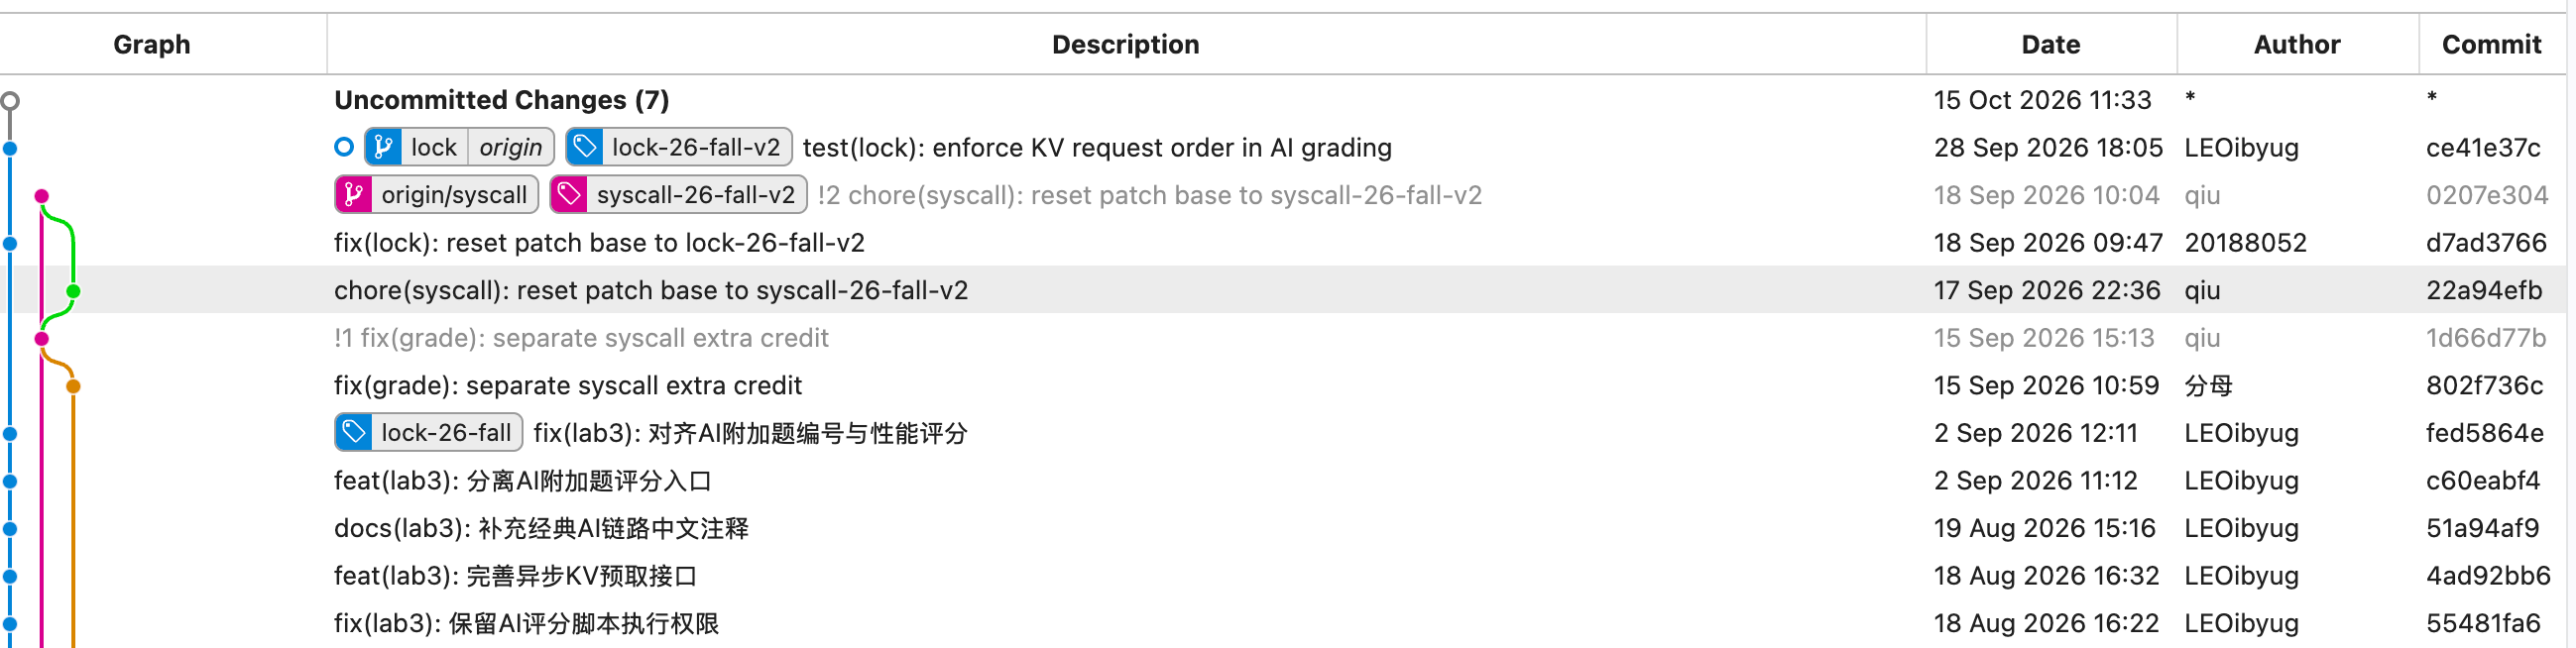
上图为最新标签(时间26年10月15日),而下图为执行 git fetch 之后的情况
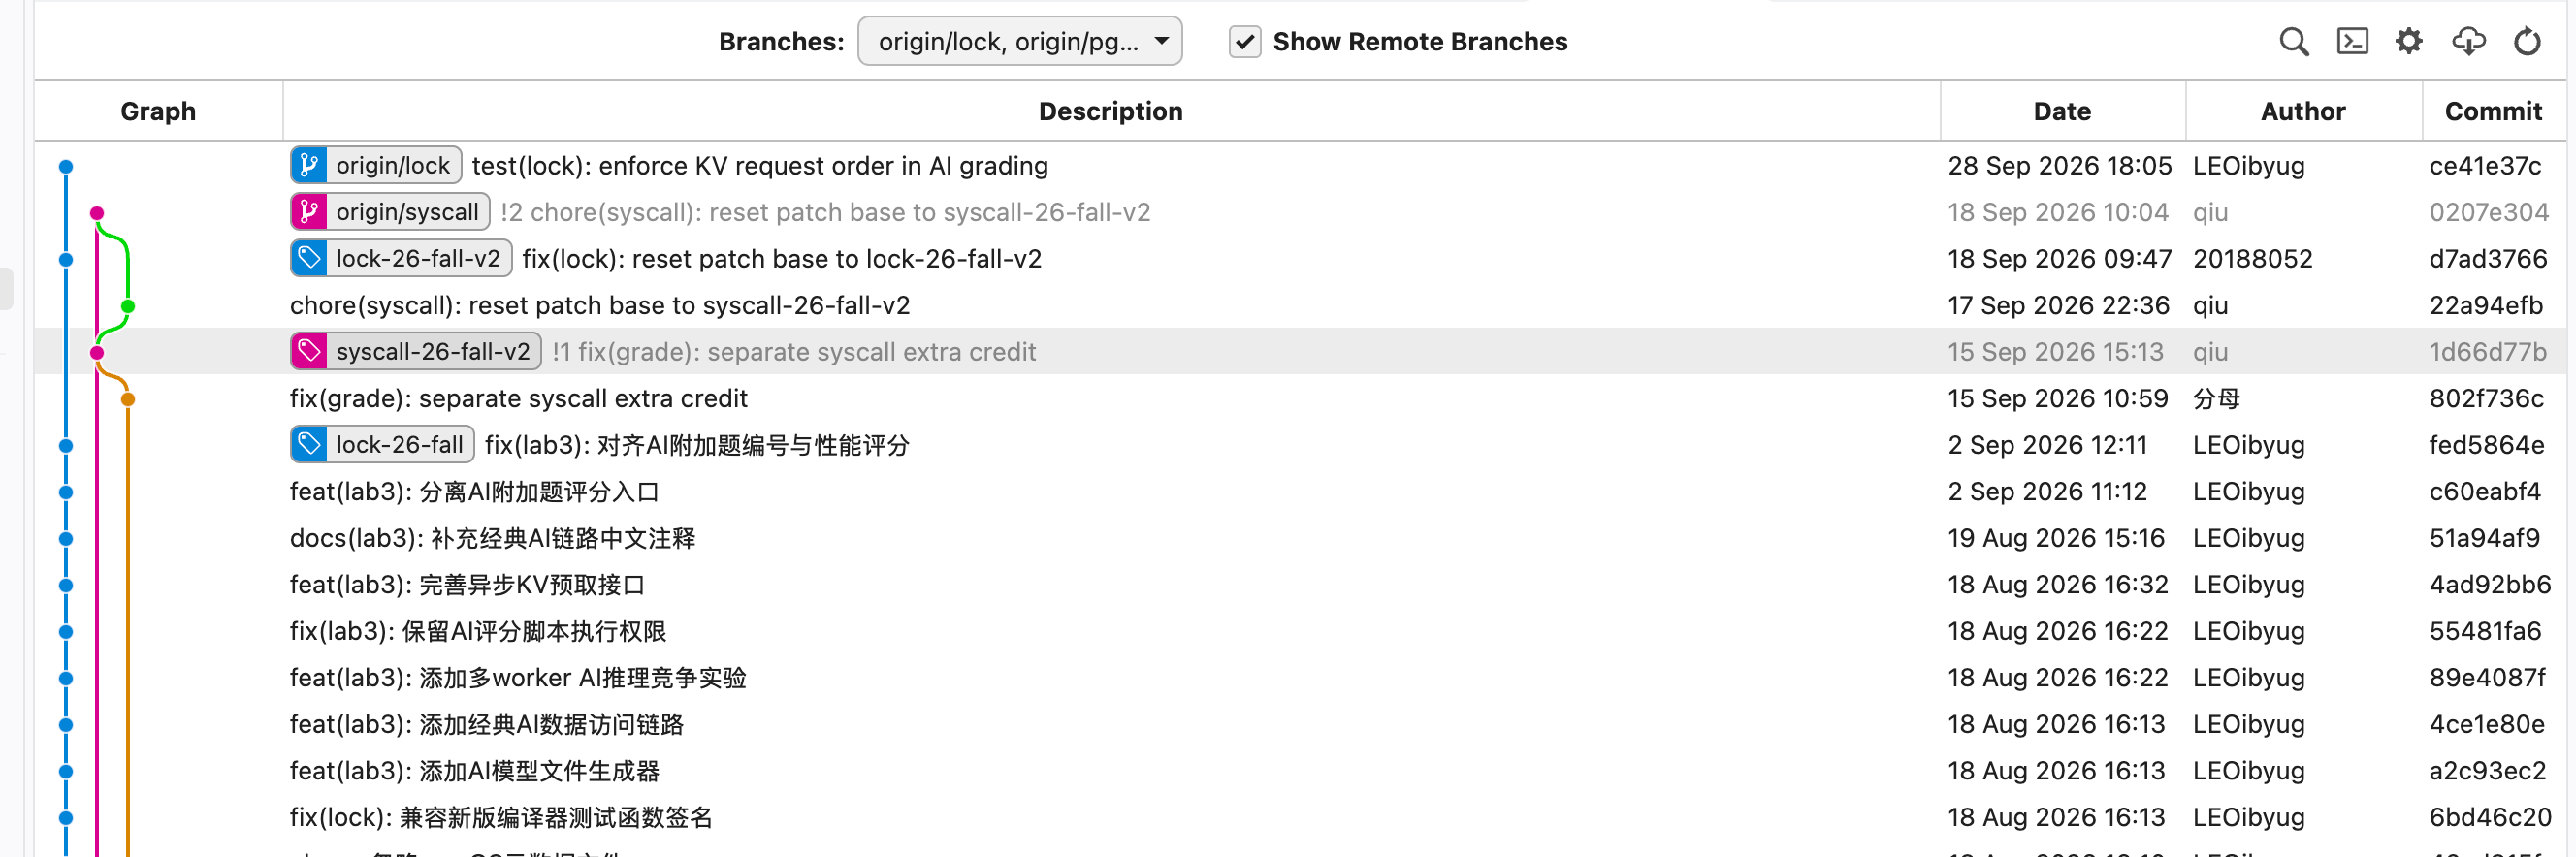
可以看到标签还是旧的位置,为了解决这个问题,在执行 make diff 前,需要
git fetch origin --tags -f
注意加上 -f 否则会有下面的结果。
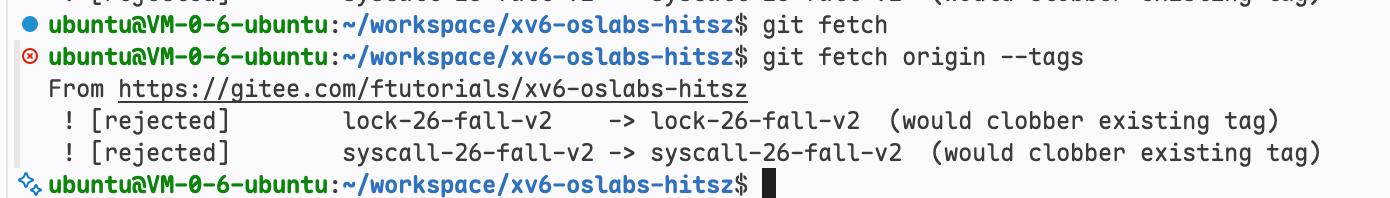
附录:测试结果
原题测试
xv6 kernel is booting

hart 1 starting
hart 2 starting
init: starting sh
$ kalloctest
start test1
test1 results:
--- lock kmem/bcache stats
lock: kmem: #fetch-and-add 3896751 #acquire() 433016
lock: bcache: #fetch-and-add 0 #acquire() 1312
--- top 5 contended locks:
lock: kmem: #fetch-and-add 3896751 #acquire() 433016
lock: proc: #fetch-and-add 210070 #acquire() 87197
lock: proc: #fetch-and-add 135980 #acquire() 87197
lock: proc: #fetch-and-add 134618 #acquire() 87197
lock: proc: #fetch-and-add 116582 #acquire() 87197
tot= 3896751
test1 FAIL
start test2
total free number of pages: 32499 (out of 32768)
.....
test2 OK
$ usertests sbrkmuch
usertests starting
test sbrkmuch: OK
ALL TESTS PASSED
$ bcachetest
start test0
test0 results:
--- lock kmem/bcache stats
lock: kmem: #fetch-and-add 3896751 #acquire() 3929833
lock: bcache: #fetch-and-add 1296098 #acquire() 66476
--- top 5 contended locks:
lock: proc: #fetch-and-add 51284292 #acquire() 2172131
lock: proc: #fetch-and-add 14378138 #acquire() 2168519
lock: proc: #fetch-and-add 14355023 #acquire() 2168519
lock: proc: #fetch-and-add 14239873 #acquire() 2168518
lock: proc: #fetch-and-add 13545737 #acquire() 2168519
tot= 5192849
test0: FAIL
start test1
test1 OK
$ usertests
usertests starting
test manywrites: OK
test execout: OK
test copyin: OK
test copyout: OK
test copyinstr1: OK
test copyinstr2: OK
test copyinstr3: OK
test rwsbrk: OK
test truncate1: OK
test truncate2: OK
test truncate3: OK
test reparent2: OK
test pgbug: OK
test sbrkbugs: usertrap(): unexpected scause 0x000000000000000c pid=3253
            sepc=0x000000000000573e stval=0x000000000000573e
usertrap(): unexpected scause 0x000000000000000c pid=3254
            sepc=0x000000000000573e stval=0x000000000000573e
OK
test badarg: OK
test reparent: OK
test twochildren: OK
test forkfork: OK
test forkforkfork: OK
test argptest: OK
test createdelete: OK
test linkunlink: OK
test linktest: OK
test unlinkread: OK
test concreate: OK
test subdir: OK
test fourfiles: OK
test sharedfd: OK
test dirtest: OK
test exectest: OK
test bigargtest: OK
test bigwrite: OK
test bsstest: OK
test sbrkbasic: OK
test sbrkmuch: OK
test kernmem: usertrap(): unexpected scause 0x000000000000000d pid=6234
            sepc=0x0000000000002198 stval=0x0000000080000000
usertrap(): unexpected scause 0x000000000000000d pid=6235
            sepc=0x0000000000002198 stval=0x000000008000c350
usertrap(): unexpected scause 0x000000000000000d pid=6236
            sepc=0x0000000000002198 stval=0x00000000800186a0
usertrap(): unexpected scause 0x000000000000000d pid=6237
            sepc=0x0000000000002198 stval=0x00000000800249f0
usertrap(): unexpected scause 0x000000000000000d pid=6238
            sepc=0x0000000000002198 stval=0x0000000080030d40
usertrap(): unexpected scause 0x000000000000000d pid=6239
            sepc=0x0000000000002198 stval=0x000000008003d090
usertrap(): unexpected scause 0x000000000000000d pid=6240
            sepc=0x0000000000002198 stval=0x00000000800493e0
usertrap(): unexpected scause 0x000000000000000d pid=6241
            sepc=0x0000000000002198 stval=0x0000000080055730
usertrap(): unexpected scause 0x000000000000000d pid=6242
            sepc=0x0000000000002198 stval=0x0000000080061a80
usertrap(): unexpected scause 0x000000000000000d pid=6243
            sepc=0x0000000000002198 stval=0x000000008006ddd0
usertrap(): unexpected scause 0x000000000000000d pid=6244
            sepc=0x0000000000002198 stval=0x000000008007a120
usertrap(): unexpected scause 0x000000000000000d pid=6245
            sepc=0x0000000000002198 stval=0x0000000080086470
usertrap(): unexpected scause 0x000000000000000d pid=6246
            sepc=0x0000000000002198 stval=0x00000000800927c0
usertrap(): unexpected scause 0x000000000000000d pid=6247
            sepc=0x0000000000002198 stval=0x000000008009eb10
usertrap(): unexpected scause 0x000000000000000d pid=6248
            sepc=0x0000000000002198 stval=0x00000000800aae60
usertrap(): unexpected scause 0x000000000000000d pid=6249
            sepc=0x0000000000002198 stval=0x00000000800b71b0
usertrap(): unexpected scause 0x000000000000000d pid=6250
            sepc=0x0000000000002198 stval=0x00000000800c3500
usertrap(): unexpected scause 0x000000000000000d pid=6251
            sepc=0x0000000000002198 stval=0x00000000800cf850
usertrap(): unexpected scause 0x000000000000000d pid=6252
            sepc=0x0000000000002198 stval=0x00000000800dbba0
usertrap(): unexpected scause 0x000000000000000d pid=6253
            sepc=0x0000000000002198 stval=0x00000000800e7ef0
usertrap(): unexpected scause 0x000000000000000d pid=6254
            sepc=0x0000000000002198 stval=0x00000000800f4240
usertrap(): unexpected scause 0x000000000000000d pid=6255
            sepc=0x0000000000002198 stval=0x0000000080100590
usertrap(): unexpected scause 0x000000000000000d pid=6256
            sepc=0x0000000000002198 stval=0x000000008010c8e0
usertrap(): unexpected scause 0x000000000000000d pid=6257
            sepc=0x0000000000002198 stval=0x0000000080118c30
usertrap(): unexpected scause 0x000000000000000d pid=6258
            sepc=0x0000000000002198 stval=0x0000000080124f80
usertrap(): unexpected scause 0x000000000000000d pid=6259
            sepc=0x0000000000002198 stval=0x00000000801312d0
usertrap(): unexpected scause 0x000000000000000d pid=6260
            sepc=0x0000000000002198 stval=0x000000008013d620
usertrap(): unexpected scause 0x000000000000000d pid=6261
            sepc=0x0000000000002198 stval=0x0000000080149970
usertrap(): unexpected scause 0x000000000000000d pid=6262
            sepc=0x0000000000002198 stval=0x0000000080155cc0
usertrap(): unexpected scause 0x000000000000000d pid=6263
            sepc=0x0000000000002198 stval=0x0000000080162010
usertrap(): unexpected scause 0x000000000000000d pid=6264
            sepc=0x0000000000002198 stval=0x000000008016e360
usertrap(): unexpected scause 0x000000000000000d pid=6265
            sepc=0x0000000000002198 stval=0x000000008017a6b0
usertrap(): unexpected scause 0x000000000000000d pid=6266
            sepc=0x0000000000002198 stval=0x0000000080186a00
usertrap(): unexpected scause 0x000000000000000d pid=6267
            sepc=0x0000000000002198 stval=0x0000000080192d50
usertrap(): unexpected scause 0x000000000000000d pid=6268
            sepc=0x0000000000002198 stval=0x000000008019f0a0
usertrap(): unexpected scause 0x000000000000000d pid=6269
            sepc=0x0000000000002198 stval=0x00000000801ab3f0
usertrap(): unexpected scause 0x000000000000000d pid=6270
            sepc=0x0000000000002198 stval=0x00000000801b7740
usertrap(): unexpected scause 0x000000000000000d pid=6271
            sepc=0x0000000000002198 stval=0x00000000801c3a90
usertrap(): unexpected scause 0x000000000000000d pid=6272
            sepc=0x0000000000002198 stval=0x00000000801cfde0
usertrap(): unexpected scause 0x000000000000000d pid=6273
            sepc=0x0000000000002198 stval=0x00000000801dc130
OK
test sbrkfail: usertrap(): unexpected scause 0x000000000000000d pid=6285
            sepc=0x0000000000004256 stval=0x0000000000012000
OK
test sbrkarg: OK
test validatetest: OK
test stacktest: usertrap(): unexpected scause 0x000000000000000d pid=6289
            sepc=0x0000000000002308 stval=0x000000000000fb90
OK
test opentest: OK
test writetest: OK
test writebig: OK
test createtest: OK
test openiput: OK
test exitiput: OK
test iput: OK
test mem: OK
test pipe1: OK
test preempt: kill... wait... OK
test exitwait: OK
test rmdot: OK
test fourteen: OK
test bigfile: OK
test dirfile: OK
test iref: OK
test forktest: OK
test bigdir: OK
ALL TESTS PASSED
$
全部修改后测试
xv6 kernel is booting

kmem0 have all free_pages: 32727
hart 2 starting
hart 1 starting
init: starting sh
$ kalloctest
start test1
test1 results:
--- lock kmem/bcache stats
lock: kmem0: #fetch-and-add 0 #acquire() 160393
lock: kmem1: #fetch-and-add 0 #acquire() 136444
lock: kmem2: #fetch-and-add 0 #acquire() 136185
lock: bcache0: #fetch-and-add 0 #acquire() 2
lock: bcache1: #fetch-and-add 0 #acquire() 4
lock: bcache2: #fetch-and-add 0 #acquire() 12
lock: bcache3: #fetch-and-add 0 #acquire() 8
lock: bcache4: #fetch-and-add 0 #acquire() 8
lock: bcache5: #fetch-and-add 0 #acquire() 8
lock: bcache6: #fetch-and-add 0 #acquire() 82
lock: bcache7: #fetch-and-add 0 #acquire() 82
lock: bcache8: #fetch-and-add 0 #acquire() 1082
lock: bcache9: #fetch-and-add 0 #acquire() 4
lock: bcache10: #fetch-and-add 0 #acquire() 4
lock: bcache11: #fetch-and-add 0 #acquire() 12
lock: bcache12: #fetch-and-add 0 #acquire() 4
--- top 5 contended locks:
lock: proc: #fetch-and-add 280724 #acquire() 99487
lock: proc: #fetch-and-add 221596 #acquire() 99489
lock: proc: #fetch-and-add 167785 #acquire() 99506
lock: proc: #fetch-and-add 161814 #acquire() 99488
lock: proc: #fetch-and-add 161555 #acquire() 99488
tot= 0
test1 OK
start test2
total free number of pages: 32499 (out of 32768)
.....
test2 OK
$ usertests sbrkmuch
usertests starting
test sbrkmuch: OK
ALL TESTS PASSED
$ bcachetest
start test0
test0 results:
--- lock kmem/bcache stats
lock: kmem0: #fetch-and-add 0 #acquire() 1444341
lock: kmem1: #fetch-and-add 0 #acquire() 460656
lock: kmem2: #fetch-and-add 0 #acquire() 2028366
lock: bcache0: #fetch-and-add 0 #acquire() 4180
lock: bcache1: #fetch-and-add 0 #acquire() 6184
lock: bcache2: #fetch-and-add 0 #acquire() 6337
lock: bcache3: #fetch-and-add 0 #acquire() 6332
lock: bcache4: #fetch-and-add 0 #acquire() 6386
lock: bcache5: #fetch-and-add 0 #acquire() 6328
lock: bcache6: #fetch-and-add 0 #acquire() 6751
lock: bcache7: #fetch-and-add 62 #acquire() 4626
lock: bcache8: #fetch-and-add 59 #acquire() 6844
lock: bcache9: #fetch-and-add 0 #acquire() 2122
lock: bcache10: #fetch-and-add 0 #acquire() 4126
lock: bcache11: #fetch-and-add 0 #acquire() 2126
lock: bcache12: #fetch-and-add 0 #acquire() 4136
--- top 5 contended locks:
lock: proc: #fetch-and-add 55180262 #acquire() 2483724
lock: proc: #fetch-and-add 14130223 #acquire() 2479768
lock: proc: #fetch-and-add 13543017 #acquire() 2479783
lock: proc: #fetch-and-add 13342974 #acquire() 2479727
lock: proc: #fetch-and-add 13148564 #acquire() 2479727
tot= 121
test0: OK
start test1
test1 OK
$ usertests
usertests starting
test manywrites: OK
test execout: OK
test copyin: OK
test copyout: OK
test copyinstr1: OK
test copyinstr2: OK
test copyinstr3: OK
test rwsbrk: OK
test truncate1: OK
test truncate2: OK
test truncate3: OK
test reparent2: OK
test pgbug: OK
test sbrkbugs: usertrap(): unexpected scause 0x000000000000000c pid=3253
            sepc=0x000000000000573e stval=0x000000000000573e
usertrap(): unexpected scause 0x000000000000000c pid=3254
            sepc=0x000000000000573e stval=0x000000000000573e
OK
test badarg: OK
test reparent: OK
test twochildren: OK
test forkfork: OK
test forkforkfork: OK
test argptest: OK
test createdelete: OK
test linkunlink: OK
test linktest: OK
test unlinkread: OK
test concreate: OK
test subdir: OK
test fourfiles: OK
test sharedfd: OK
test dirtest: OK
test exectest: OK
test bigargtest: OK
test bigwrite: OK
test bsstest: OK
test sbrkbasic: OK
test sbrkmuch: OK
test kernmem: usertrap(): unexpected scause 0x000000000000000d pid=6234
            sepc=0x0000000000002198 stval=0x0000000080000000
usertrap(): unexpected scause 0x000000000000000d pid=6235
            sepc=0x0000000000002198 stval=0x000000008000c350
usertrap(): unexpected scause 0x000000000000000d pid=6236
            sepc=0x0000000000002198 stval=0x00000000800186a0
usertrap(): unexpected scause 0x000000000000000d pid=6237
            sepc=0x0000000000002198 stval=0x00000000800249f0
usertrap(): unexpected scause 0x000000000000000d pid=6238
            sepc=0x0000000000002198 stval=0x0000000080030d40
usertrap(): unexpected scause 0x000000000000000d pid=6239
            sepc=0x0000000000002198 stval=0x000000008003d090
usertrap(): unexpected scause 0x000000000000000d pid=6240
            sepc=0x0000000000002198 stval=0x00000000800493e0
usertrap(): unexpected scause 0x000000000000000d pid=6241
            sepc=0x0000000000002198 stval=0x0000000080055730
usertrap(): unexpected scause 0x000000000000000d pid=6242
            sepc=0x0000000000002198 stval=0x0000000080061a80
usertrap(): unexpected scause 0x000000000000000d pid=6243
            sepc=0x0000000000002198 stval=0x000000008006ddd0
usertrap(): unexpected scause 0x000000000000000d pid=6244
            sepc=0x0000000000002198 stval=0x000000008007a120
usertrap(): unexpected scause 0x000000000000000d pid=6245
            sepc=0x0000000000002198 stval=0x0000000080086470
usertrap(): unexpected scause 0x000000000000000d pid=6246
            sepc=0x0000000000002198 stval=0x00000000800927c0
usertrap(): unexpected scause 0x000000000000000d pid=6247
            sepc=0x0000000000002198 stval=0x000000008009eb10
usertrap(): unexpected scause 0x000000000000000d pid=6248
            sepc=0x0000000000002198 stval=0x00000000800aae60
usertrap(): unexpected scause 0x000000000000000d pid=6249
            sepc=0x0000000000002198 stval=0x00000000800b71b0
usertrap(): unexpected scause 0x000000000000000d pid=6250
            sepc=0x0000000000002198 stval=0x00000000800c3500
usertrap(): unexpected scause 0x000000000000000d pid=6251
            sepc=0x0000000000002198 stval=0x00000000800cf850
usertrap(): unexpected scause 0x000000000000000d pid=6252
            sepc=0x0000000000002198 stval=0x00000000800dbba0
usertrap(): unexpected scause 0x000000000000000d pid=6253
            sepc=0x0000000000002198 stval=0x00000000800e7ef0
usertrap(): unexpected scause 0x000000000000000d pid=6254
            sepc=0x0000000000002198 stval=0x00000000800f4240
usertrap(): unexpected scause 0x000000000000000d pid=6255
            sepc=0x0000000000002198 stval=0x0000000080100590
usertrap(): unexpected scause 0x000000000000000d pid=6256
            sepc=0x0000000000002198 stval=0x000000008010c8e0
usertrap(): unexpected scause 0x000000000000000d pid=6257
            sepc=0x0000000000002198 stval=0x0000000080118c30
usertrap(): unexpected scause 0x000000000000000d pid=6258
            sepc=0x0000000000002198 stval=0x0000000080124f80
usertrap(): unexpected scause 0x000000000000000d pid=6259
            sepc=0x0000000000002198 stval=0x00000000801312d0
usertrap(): unexpected scause 0x000000000000000d pid=6260
            sepc=0x0000000000002198 stval=0x000000008013d620
usertrap(): unexpected scause 0x000000000000000d pid=6261
            sepc=0x0000000000002198 stval=0x0000000080149970
usertrap(): unexpected scause 0x000000000000000d pid=6262
            sepc=0x0000000000002198 stval=0x0000000080155cc0
usertrap(): unexpected scause 0x000000000000000d pid=6263
            sepc=0x0000000000002198 stval=0x0000000080162010
usertrap(): unexpected scause 0x000000000000000d pid=6264
            sepc=0x0000000000002198 stval=0x000000008016e360
usertrap(): unexpected scause 0x000000000000000d pid=6265
            sepc=0x0000000000002198 stval=0x000000008017a6b0
usertrap(): unexpected scause 0x000000000000000d pid=6266
            sepc=0x0000000000002198 stval=0x0000000080186a00
usertrap(): unexpected scause 0x000000000000000d pid=6267
            sepc=0x0000000000002198 stval=0x0000000080192d50
usertrap(): unexpected scause 0x000000000000000d pid=6268
            sepc=0x0000000000002198 stval=0x000000008019f0a0
usertrap(): unexpected scause 0x000000000000000d pid=6269
            sepc=0x0000000000002198 stval=0x00000000801ab3f0
usertrap(): unexpected scause 0x000000000000000d pid=6270
            sepc=0x0000000000002198 stval=0x00000000801b7740
usertrap(): unexpected scause 0x000000000000000d pid=6271
            sepc=0x0000000000002198 stval=0x00000000801c3a90
usertrap(): unexpected scause 0x000000000000000d pid=6272
            sepc=0x0000000000002198 stval=0x00000000801cfde0
usertrap(): unexpected scause 0x000000000000000d pid=6273
            sepc=0x0000000000002198 stval=0x00000000801dc130
OK
test sbrkfail: usertrap(): unexpected scause 0x000000000000000d pid=6285
            sepc=0x0000000000004256 stval=0x0000000000012000
OK
test sbrkarg: OK
test validatetest: OK
test stacktest: usertrap(): unexpected scause 0x000000000000000d pid=6289
            sepc=0x0000000000002308 stval=0x000000000000fb90
OK
test opentest: OK
test writetest: OK
test writebig: OK
test createtest: OK
test openiput: OK
test exitiput: OK
test iput: OK
test mem: OK
test pipe1: OK
test preempt: kill... wait... OK
test exitwait: OK
test rmdot: OK
test fourteen: OK
test bigfile: OK
test dirfile: OK
test iref: OK
test forktest: OK
test bigdir: OK
ALL TESTS PASSED
$
截图:make grade
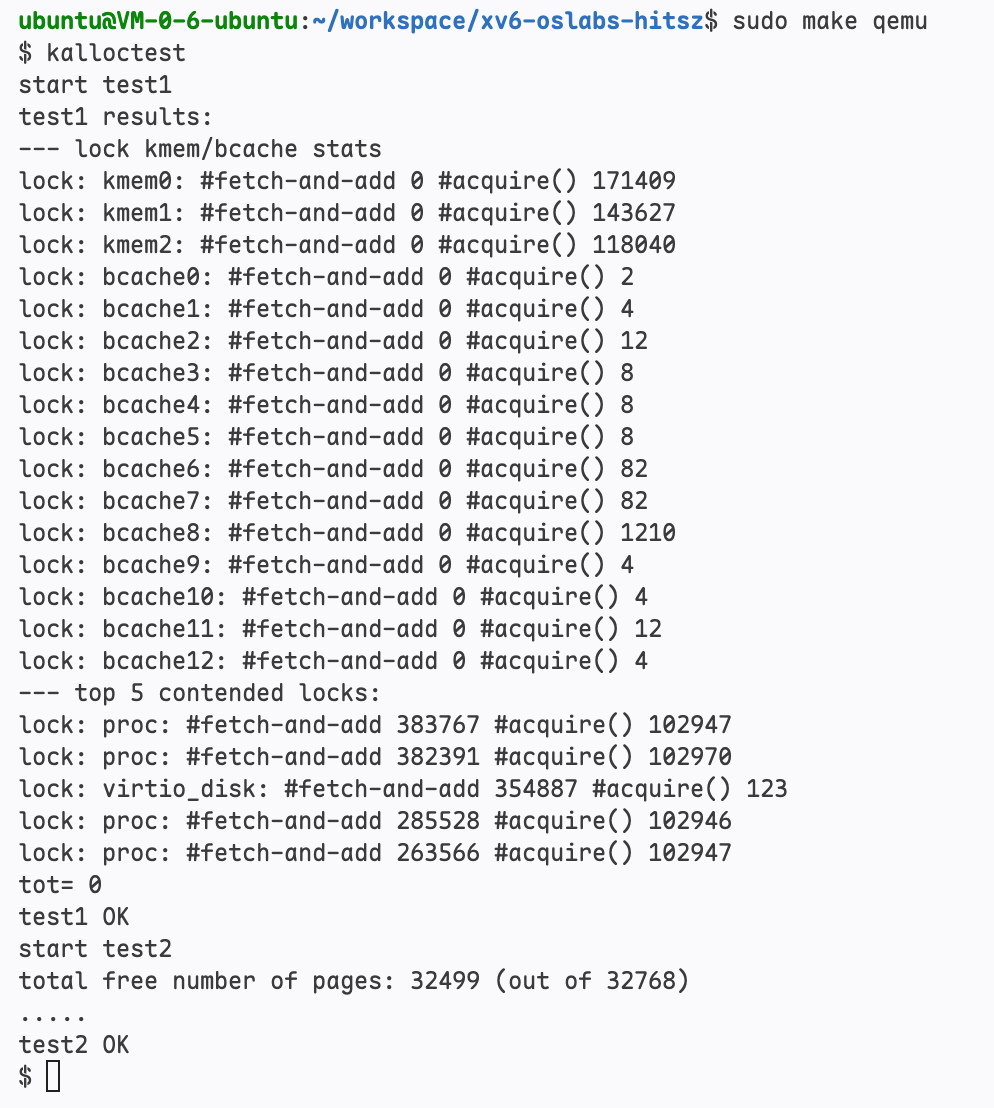
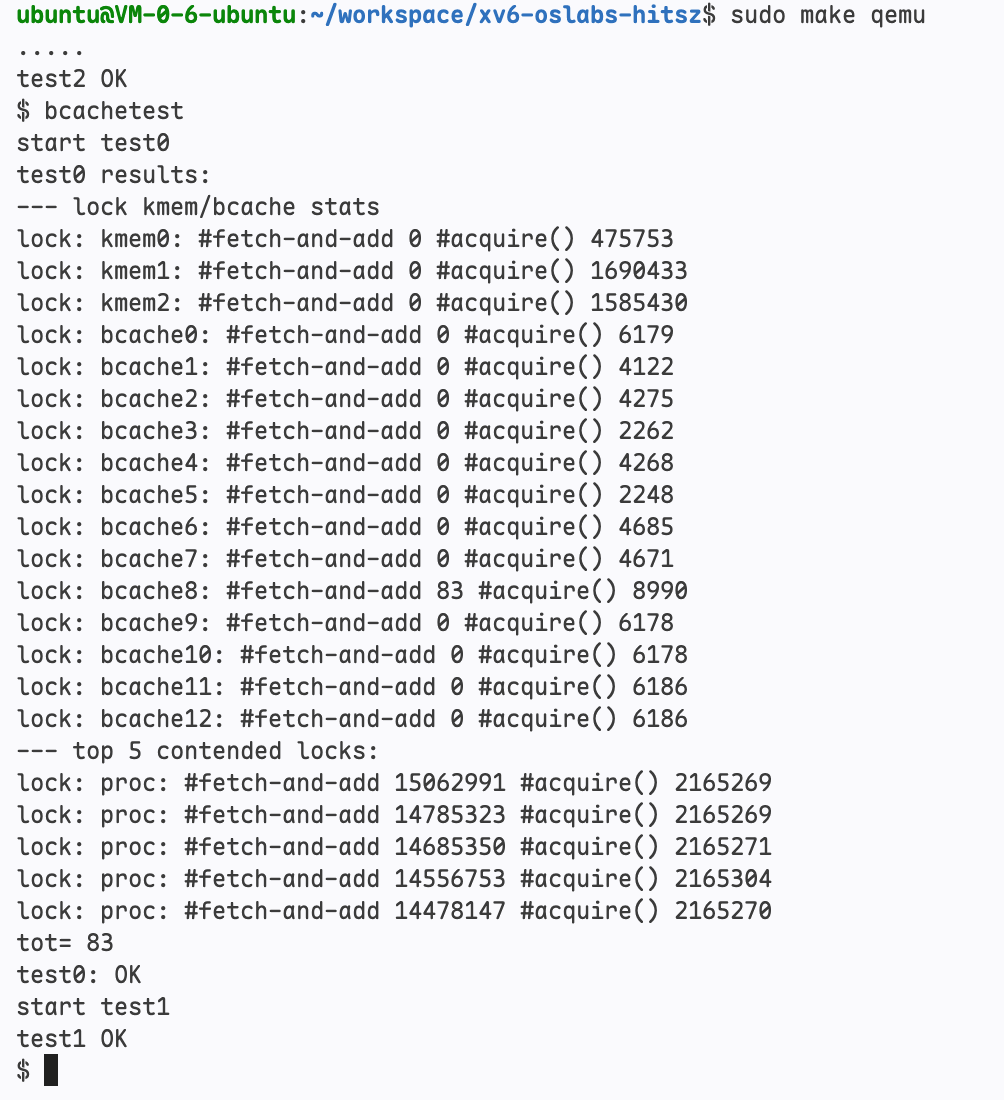
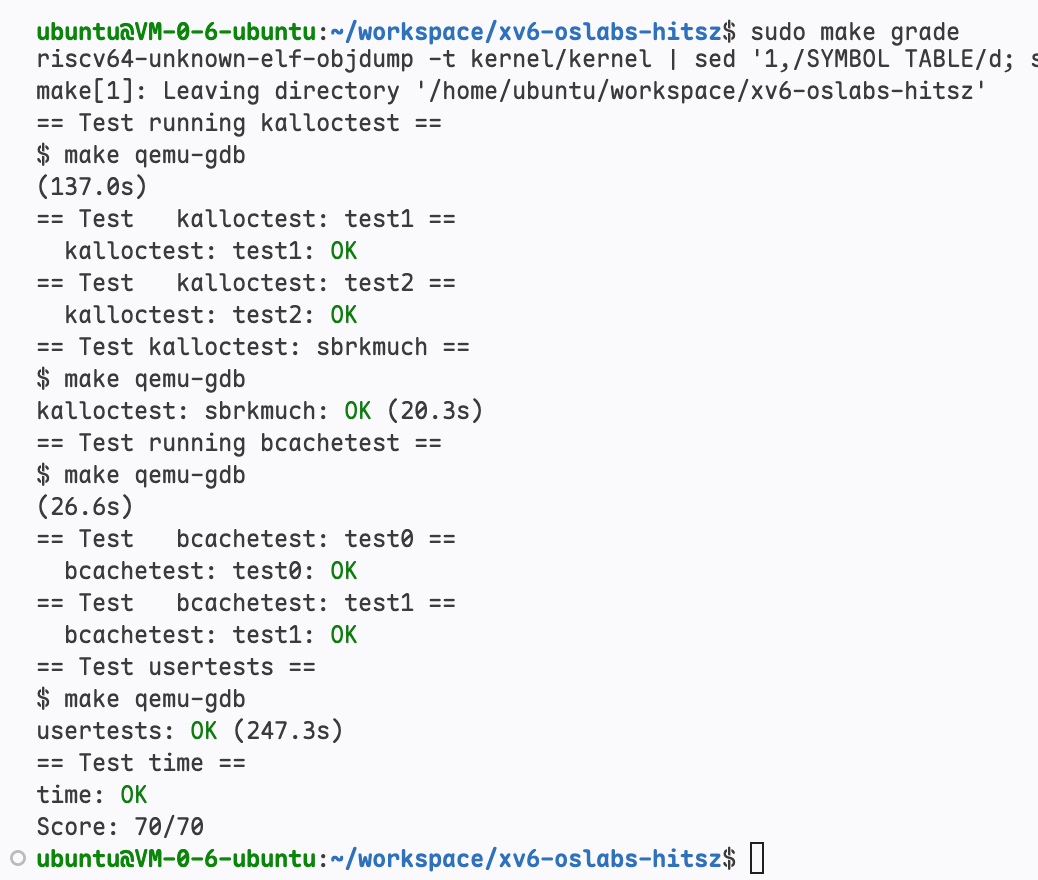
附加题
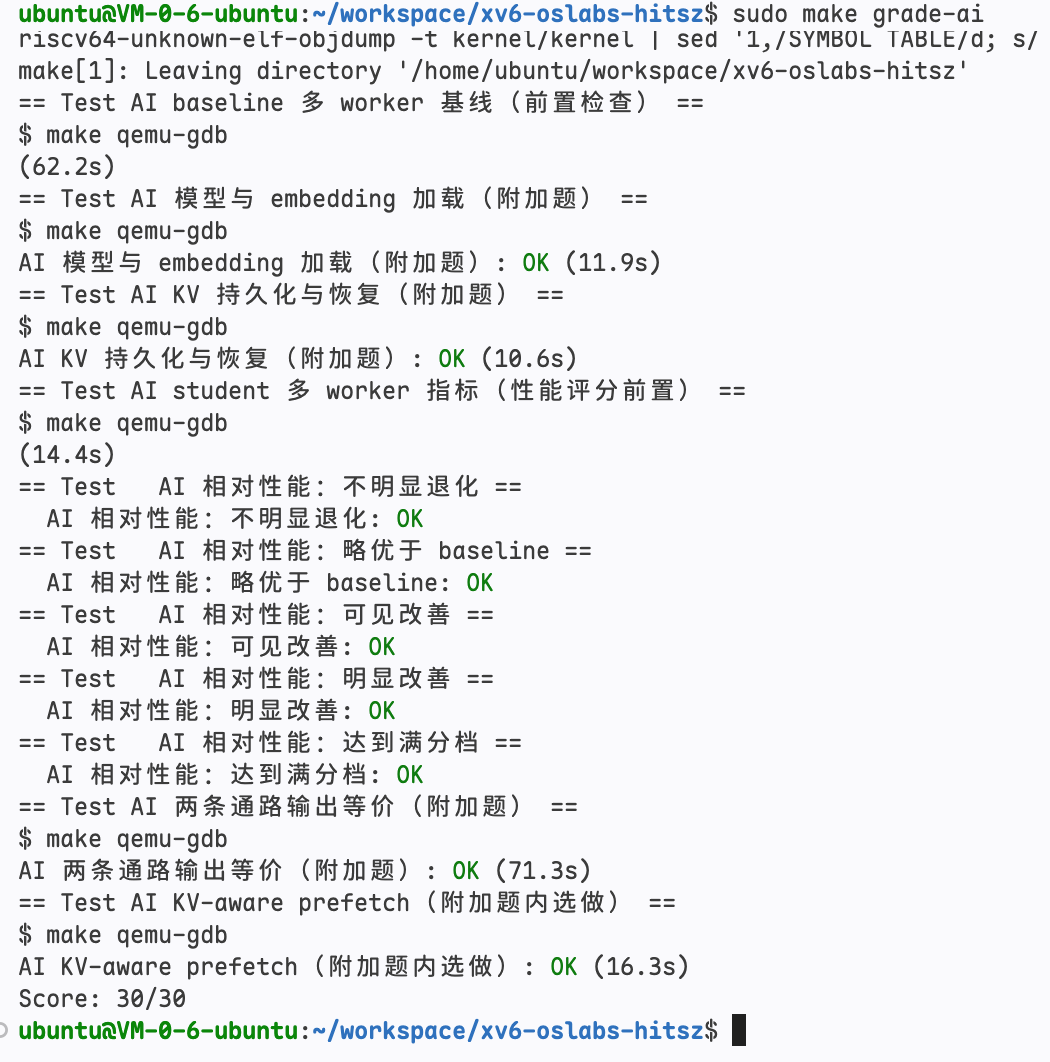
附加题测试结果
最终测试结果如下(2026-10-13)
xv6 kernel is booting

kmem0 have all free_pages: 32727
hart 2 starting
hart 1 starting
init: starting sh
$ modelprep
MODELPREP: OK shards=74 bytes=75776 checksum=1593388032
$ aimodeltest
AIMODELTEST: verify OK shards=74 checksum=1593388032
$ aikvtest
AIKVTEST: request order OK
AIKVTEST: verify OK requests=4 bytes=8192
$ aiinfer compare -w 3 -r 24
AIINFER_COMPARE: verify OK checksum=1717503730
$ aiinfer prefetch -w 3 -r 24
AIINFER: verify OK mode=prefetch
AIINFER_METRICS mode=prefetch workers=3 requests=24 elapsed_ticks=48 throughput_milli=15000 p95_ticks=15 kmem_spins=0 bcache_spins=629 total_spins=629 model_read_bytes=113664 embed_read_bytes=113664 kv_write_bytes=147456 kv_read_bytes=147456 checksum=1717503730
ubuntu@VM-0-6-ubuntu:~/workspace/xv6-oslabs-hitsz$ python3 tools/grade_ai.py --runs 3
{
  "baseline_median": {
    "bcache_spins": 35484,
    "checksum": 1717503730,
    "elapsed_ticks": 577,
    "embed_read_bytes": 2359296,
    "kmem_spins": 0,
    "kv_read_bytes": 147456,
    "kv_write_bytes": 147456,
    "model_read_bytes": 2359296,
    "p95_ticks": 440,
    "requests": 24,
    "throughput_milli": 1247,
    "total_spins": 35484,
    "workers": 3
  },
  "baseline_samples": [
    {
      "bcache_spins": 13878,
      "checksum": 1717503730,
      "elapsed_ticks": 564,
      "embed_read_bytes": 2359296,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 2359296,
      "p95_ticks": 440,
      "requests": 24,
      "throughput_milli": 1276,
      "total_spins": 13878,
      "workers": 3
    },
    {
      "bcache_spins": 239077,
      "checksum": 1717503730,
      "elapsed_ticks": 577,
      "embed_read_bytes": 2359296,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 2359296,
      "p95_ticks": 448,
      "requests": 24,
      "throughput_milli": 1247,
      "total_spins": 239077,
      "workers": 3
    },
    {
      "bcache_spins": 35484,
      "checksum": 1717503730,
      "elapsed_ticks": 578,
      "embed_read_bytes": 2359296,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 2359296,
      "p95_ticks": 435,
      "requests": 24,
      "throughput_milli": 1245,
      "total_spins": 35484,
      "workers": 3
    }
  ],
  "capped_ratios": {
    "p95": 2.0,
    "spins": 8.0,
    "throughput": 2.0
  },
  "performance_score": 6,
  "performance_score_max": 6,
  "required_ratios": {
    "p95": 40.0,
    "spins": 70.26534653465346,
    "throughput": 14.434643143544507
  },
  "runs": 3,
  "student_median": {
    "bcache_spins": 505,
    "checksum": 1717503730,
    "elapsed_ticks": 40,
    "embed_read_bytes": 113664,
    "kmem_spins": 0,
    "kv_read_bytes": 147456,
    "kv_write_bytes": 147456,
    "model_read_bytes": 113664,
    "p95_ticks": 11,
    "requests": 24,
    "throughput_milli": 18000,
    "total_spins": 505,
    "workers": 3
  },
  "student_samples": [
    {
      "bcache_spins": 253,
      "checksum": 1717503730,
      "elapsed_ticks": 41,
      "embed_read_bytes": 113664,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 113664,
      "p95_ticks": 10,
      "requests": 24,
      "throughput_milli": 17560,
      "total_spins": 253,
      "workers": 3
    },
    {
      "bcache_spins": 1010,
      "checksum": 1717503730,
      "elapsed_ticks": 40,
      "embed_read_bytes": 113664,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 113664,
      "p95_ticks": 11,
      "requests": 24,
      "throughput_milli": 18000,
      "total_spins": 1010,
      "workers": 3
    },
    {
      "bcache_spins": 505,
      "checksum": 1717503730,
      "elapsed_ticks": 39,
      "embed_read_bytes": 113664,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 113664,
      "p95_ticks": 11,
      "requests": 24,
      "throughput_milli": 18461,
      "total_spins": 505,
      "workers": 3
    }
  ],
  "weighted_ratio": 3.8
}
ubuntu@VM-0-6-ubuntu:~/workspace/xv6-oslabs-hitsz$ python3 tools/grade_ai.py --runs 3 --bonus
{
  "baseline_median": {
    "bcache_spins": 68344,
    "checksum": 1717503730,
    "elapsed_ticks": 598,
    "embed_read_bytes": 2359296,
    "kmem_spins": 0,
    "kv_read_bytes": 147456,
    "kv_write_bytes": 147456,
    "model_read_bytes": 2359296,
    "p95_ticks": 464,
    "requests": 24,
    "throughput_milli": 1204,
    "total_spins": 68344,
    "workers": 3
  },
  "baseline_samples": [
    {
      "bcache_spins": 68344,
      "checksum": 1717503730,
      "elapsed_ticks": 610,
      "embed_read_bytes": 2359296,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 2359296,
      "p95_ticks": 483,
      "requests": 24,
      "throughput_milli": 1180,
      "total_spins": 68344,
      "workers": 3
    },
    {
      "bcache_spins": 211406,
      "checksum": 1717503730,
      "elapsed_ticks": 579,
      "embed_read_bytes": 2359296,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 2359296,
      "p95_ticks": 443,
      "requests": 24,
      "throughput_milli": 1243,
      "total_spins": 211406,
      "workers": 3
    },
    {
      "bcache_spins": 3656,
      "checksum": 1717503730,
      "elapsed_ticks": 598,
      "embed_read_bytes": 2359296,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 2359296,
      "p95_ticks": 464,
      "requests": 24,
      "throughput_milli": 1204,
      "total_spins": 3656,
      "workers": 3
    }
  ],
  "bonus_ratios": {
    "p95": 1.0,
    "spins": 0.3484276729559748,
    "throughput": 0.9535307517084283
  },
  "capped_ratios": {
    "p95": 2.0,
    "spins": 8.0,
    "throughput": 2.0
  },
  "performance_score": 6,
  "performance_score_max": 6,
  "prefetch_median": {
    "bcache_spins": 795,
    "checksum": 1717503730,
    "elapsed_ticks": 43,
    "embed_read_bytes": 113664,
    "kmem_spins": 0,
    "kv_read_bytes": 147456,
    "kv_write_bytes": 147456,
    "model_read_bytes": 113664,
    "p95_ticks": 12,
    "requests": 24,
    "throughput_milli": 16744,
    "total_spins": 795,
    "workers": 3
  },
  "prefetch_samples": [
    {
      "bcache_spins": 77004,
      "checksum": 1717503730,
      "elapsed_ticks": 43,
      "embed_read_bytes": 113664,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 113664,
      "p95_ticks": 12,
      "requests": 24,
      "throughput_milli": 16744,
      "total_spins": 77004,
      "workers": 3
    },
    {
      "bcache_spins": 211,
      "checksum": 1717503730,
      "elapsed_ticks": 42,
      "embed_read_bytes": 113664,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 113664,
      "p95_ticks": 10,
      "requests": 24,
      "throughput_milli": 17142,
      "total_spins": 211,
      "workers": 3
    },
    {
      "bcache_spins": 795,
      "checksum": 1717503730,
      "elapsed_ticks": 44,
      "embed_read_bytes": 113664,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 113664,
      "p95_ticks": 13,
      "requests": 24,
      "throughput_milli": 16363,
      "total_spins": 795,
      "workers": 3
    }
  ],
  "required_ratios": {
    "p95": 38.666666666666664,
    "spins": 246.72924187725633,
    "throughput": 14.584717607973422
  },
  "runs": 3,
  "student_median": {
    "bcache_spins": 277,
    "checksum": 1717503730,
    "elapsed_ticks": 41,
    "embed_read_bytes": 113664,
    "kmem_spins": 0,
    "kv_read_bytes": 147456,
    "kv_write_bytes": 147456,
    "model_read_bytes": 113664,
    "p95_ticks": 12,
    "requests": 24,
    "throughput_milli": 17560,
    "total_spins": 277,
    "workers": 3
  },
  "student_samples": [
    {
      "bcache_spins": 109,
      "checksum": 1717503730,
      "elapsed_ticks": 43,
      "embed_read_bytes": 113664,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 113664,
      "p95_ticks": 12,
      "requests": 24,
      "throughput_milli": 16744,
      "total_spins": 109,
      "workers": 3
    },
    {
      "bcache_spins": 277,
      "checksum": 1717503730,
      "elapsed_ticks": 41,
      "embed_read_bytes": 113664,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 113664,
      "p95_ticks": 12,
      "requests": 24,
      "throughput_milli": 17560,
      "total_spins": 277,
      "workers": 3
    },
    {
      "bcache_spins": 1450,
      "checksum": 1717503730,
      "elapsed_ticks": 41,
      "embed_read_bytes": 113664,
      "kmem_spins": 0,
      "kv_read_bytes": 147456,
      "kv_write_bytes": 147456,
      "model_read_bytes": 113664,
      "p95_ticks": 10,
      "requests": 24,
      "throughput_milli": 17560,
      "total_spins": 1450,
      "workers": 3
    }
  ],
  "weighted_ratio": 3.8
}