Introduction
本文旨在记录作者完成课程任务 HITSZ os-lab4 的过程,可供参考。
本实验需要完成的内容包括
- 实现一个页表打印函数
vmprint(), 并在合适的位置打印第一个用户进程的页表; - 实现进程独立内核页表
- 给每个进程准备一张自己的内核页表;
- 当 CPU 运行这个进程的内核态代码时,切换到它自己的内核页表;
- 当进程结束时,把这张内核页表正确回收。
- 简化软件模拟地址翻译
- 在独立内核页表中加入用户地址空间映射;
- 用 copyin_new() / copyinstr_new() 替换原来的软件模拟翻译路径;
- 让内核在访问用户地址时可以更多依赖硬件,而不是每次都手动遍历页表。
实验仓库链接如下
指导书链接如下(需校内网)
仓库内有多个 lab 分支,本文所提的 lab4 对应的分支切换方法如下
git clone git@gitee.com:ftutorials/xv6-oslabs-hitsz.git
git checkout pgtbl
任务一:打印页表
这一题主要修改 kernel/vm.c 和 kernel/exec.c
本题的目标是:
- 实现一个页表打印函数
vmprint(); - 在合适的位置打印第一个用户进程的页表;
- 让输出格式严格符合本指导书要求。
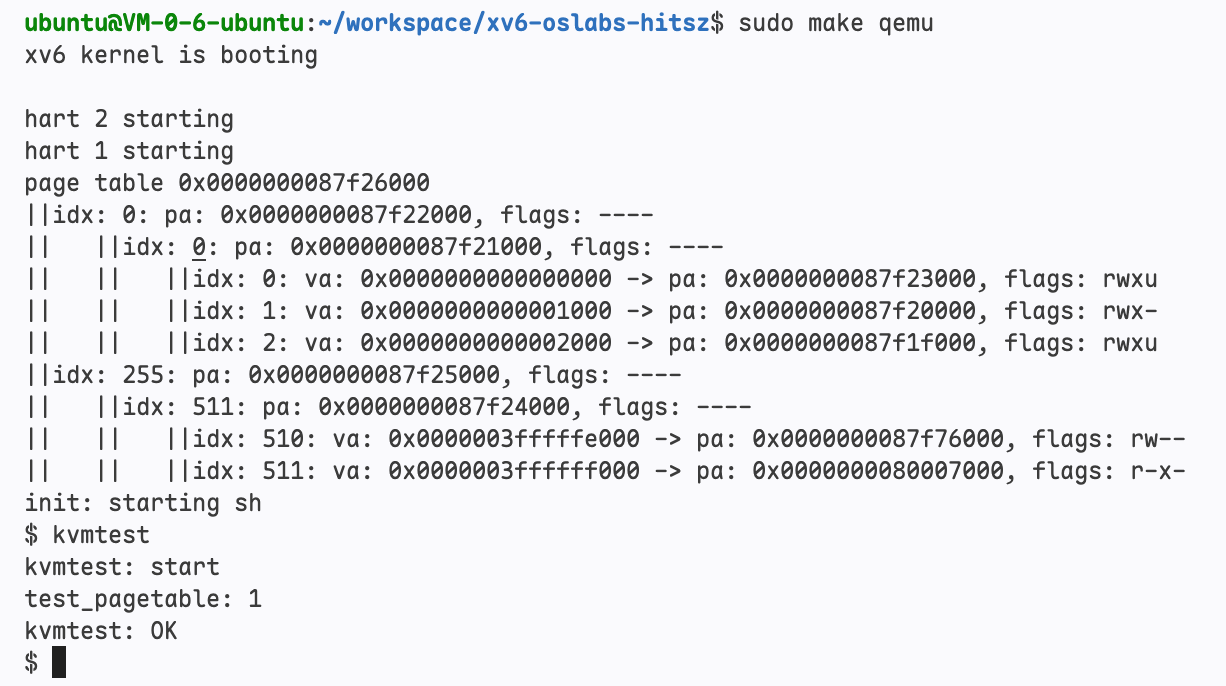
完成后,启动 xv6 时会有下面的输出
xv6 kernel is booting

hart 1 starting
hart 2 starting
page table 0x0000000087f26000
||idx: 0: pa: 0x0000000087f22000, flags: ----
||   ||idx: 0: pa: 0x0000000087f21000, flags: ----
||   ||   ||idx: 0: va: 0x0000000000000000 -> pa: 0x0000000087f23000, flags: rwxu
||   ||   ||idx: 1: va: 0x0000000000001000 -> pa: 0x0000000087f20000, flags: rwx-
||   ||   ||idx: 2: va: 0x0000000000002000 -> pa: 0x0000000087f1f000, flags: rwxu
||idx: 255: pa: 0x0000000087f25000, flags: ----
||   ||idx: 511: pa: 0x0000000087f24000, flags: ----
||   ||   ||idx: 510: va: 0x0000003fffffe000 -> pa: 0x0000000087f76000, flags: rw--
||   ||   ||idx: 511: va: 0x0000003ffffff000 -> pa: 0x0000000080007000, flags: r-x-
init: starting sh
$
vmprint() 实现
void vmprint(pagetable_t pgtbl)
vmprint 需要遍历并打印出每一个 PTE,这一行为其实和 freewalk() 有些类似
// vm.c
// Recursively free page-table pages.
// All leaf mappings must already have been removed.
void freewalk(pagetable_t pagetable) {
  // there are 2^9 = 512 PTEs in a page table.
  for (int i = 0; i < 512; i++) {
    pte_t pte = pagetable[i];
    if ((pte & PTE_V) && (pte & (PTE_R | PTE_W | PTE_X)) == 0) {
      // this PTE points to a lower-level page table.
      uint64 child = PTE2PA(pte);
      freewalk((pagetable_t)child);
      pagetable[i] = 0;
    } else if (pte & PTE_V) {
      panic("freewalk: leaf");
    }
  }
  kfree((void *)pagetable);
}
关于 riscv 的相关硬件机制以及 xv6 页管理机制,详见另一篇文章 OSTEP Note with xv6: Memory Virtualization
但是打印不同级别的条目需要不同的缩进,所以需要并不能简单地套用上面的函数
先写一个工具函数用来打印 PTE,从上面的打印格式可以看到 leaf PTE 是需要打印出 VA 的,所以这个工具函数也需要有相应的声明
为了方便起见,下面的函数都放在了 vm.c 中,和 freewalk 是同一份文件,这样可以便于使用页相关的宏定义。
void vmprint_pte(int idx, uint64 va, pte_t *pte, int level){
  char flags[5];
  flags[0] = *pte & PTE_R? 'r':'-';
  flags[1] = *pte & PTE_W? 'w':'-';
  flags[2] = *pte & PTE_X? 'x':'-';
  flags[3] = *pte & PTE_U? 'u':'-';
  flags[4] = '\0';
  switch(level){
    case(2):
      printf("||");
      break;
    case(1):
      printf("||   ||");
      break;
    case(0):
      printf("||   ||   ||");
      break;
    default:
      break;
  }
  if (!(*pte & (PTE_R|PTE_W|PTE_X))) { // not leaf
    printf("idx: %d: pa: %p, flags: %s\n", idx, PTE2PA(*pte), flags);
  }else{
    printf("idx: %d: va: %p -> pa: %p, flags: %s\n", idx, va, PTE2PA(*pte), flags);
  }
}
然后写一个递归函数,调用上面的打印工具,这个过程中不能丢失掉级别信息,所以每次递归调用都得 level++,而且上面的 freewalk 在递归调用时也没有保存 VA ,光靠 当前级别的 pagetable 是无法还原出 VA 的。
VA 的组成如下
63    39 3830 2921 2012 11       0
+---------------+------------+------------+------------+-----------+
| sign extension|   VPN[2]   |   VPN[1]   |   VPN[0]   |  offset   |
+---------------+------------+------------+------------+-----------+
 9 bits9 bits9 bits       12 bits

VA
 │
 ├── VPN[2]   ← 第一级索引,用于 L2 Page Table/Root Page Table
 ├── VPN[1]   ← 第二级索引,用于 L1 Page Table
 ├── VPN[0]   ← 第三级索引,用于 L0 Page Table
 └── offset   ← 页内偏移
索引本身就已经在 VA 中了,所以 VA 在传递过程中也在不断发生变化,递归调用的时候,需要根据当前的 index 传入新的 VA,直到叶子条目时打印出来。
void vmprint_walk(pagetable_t pagetable, int level, uint64 va){
  for (int i=0; i<512; i++){
    pte_t *pte = &pagetable[i];
    if (*pte & PTE_V) {
      uint64 new_va = va | ((uint64)i << (12 + level*9));
      vmprint_pte(i,new_va,pte,level);
      if (!(*pte & (PTE_R|PTE_W|PTE_X))) { // not leaf
        vmprint_walk((pagetable_t) PTE2PA(*pte), level-1, new_va);
      }
    }
  }
}
当前这个函数能够递归打印某个页条目下的页表树,将根页表传入就可以打印这个页表的全部条目了,这也就是 vmprint 要做的事情
// receive root pagetable pointer
// print pagetable
// idx: [索引编号]: pa: [物理地址], flags: [四个权限位(r/w/x/u)]
// idx: [索引编号]: va: [虚拟地址] -> pa: [物理地址], flags: [四个权限位(r/w/x/u)]
void vmprint_walk(pagetable_t pagetable, int level, uint64 va);
void vmprint_pte(int idx, uint64 va, pte_t *pte, int level);
void vmprint(pagetable_t pagetable) {
  printf("page table %p\n", pagetable);
  vmprint_walk(pagetable,2,0);
}
调用 vmprint() 在合适的位置打印第一个用户进程 init 的页表
在 Lab1 中,实验分析了第一个用户进程启动的过程
xv6 的启动流程大致如下
- 进入
entry.S中的_entry函数- 获取 CPU ID(
mhartid),设置启动栈(sp)
- 获取 CPU ID(
- 进入
start.c中的start()函数- 设置 previous mode 为 s-mode,,设置
mepc,禁用页表(satp设置为 0),设置中断/异常委托,初始化计时器、UART等 - 完成之后通过
mret进入mepc设置的地址(main)
- 设置 previous mode 为 s-mode,,设置
- 进入
main.c中的main()函数,调用很多初始化函数- 其中一个关键函数是
userinit(),它会分配一个新的进程,也就是initcode进程,并设置为RUNNABLE - 初始化完成之后,进入
scheduler()函数
- 其中一个关键函数是
proc.c中的scheduler()函数会遍历进程列表,找到RUNNABLE进程执行,然后会使用swtch切换到进程的上下文中- 首先执行的用户程序是
initcode,它的内容是调用exec(init, argv),将程序加载到内存中,执行完毕之后这个进程就会变成init init用户程序的内容则是打开控制台,并且fork()+exec("sh", argv),也就是打开 shell,然后init会调用wait进入睡眠。- 如果
sh退出了,那么init会被唤醒,重新fork()+exec()启动 shell - 如果不是
sh退出,那么说明是孤儿进程,init不会管这个进程,继续wait进入睡眠
- 首先执行的用户程序是
sh的内容大致是读取用户输入,并且执行对应的程序
exec(init..) 期间,pagetable 会重新写一遍,我们只需要在返回之前进行打印即可!在此之前记得将 vmprint() 声明在 defs.h 中。
int exec(char *path, char **argv) {
  ...
  // Commit to the user image.
  oldpagetable = p->pagetable;
  p->pagetable = pagetable;
  p->sz = sz;
  p->trapframe->epc = elf.entry;  // initial program counter = main
  p->trapframe->sp = sp;  // initial stack pointer
  proc_freepagetable(oldpagetable, oldsz);
  if (p->pid==1){
    vmprint(p->pagetable);
  }
  return argc;  // this ends up in a0, the first argument to main(argc, argv)
  ...
}
结果验证和分析
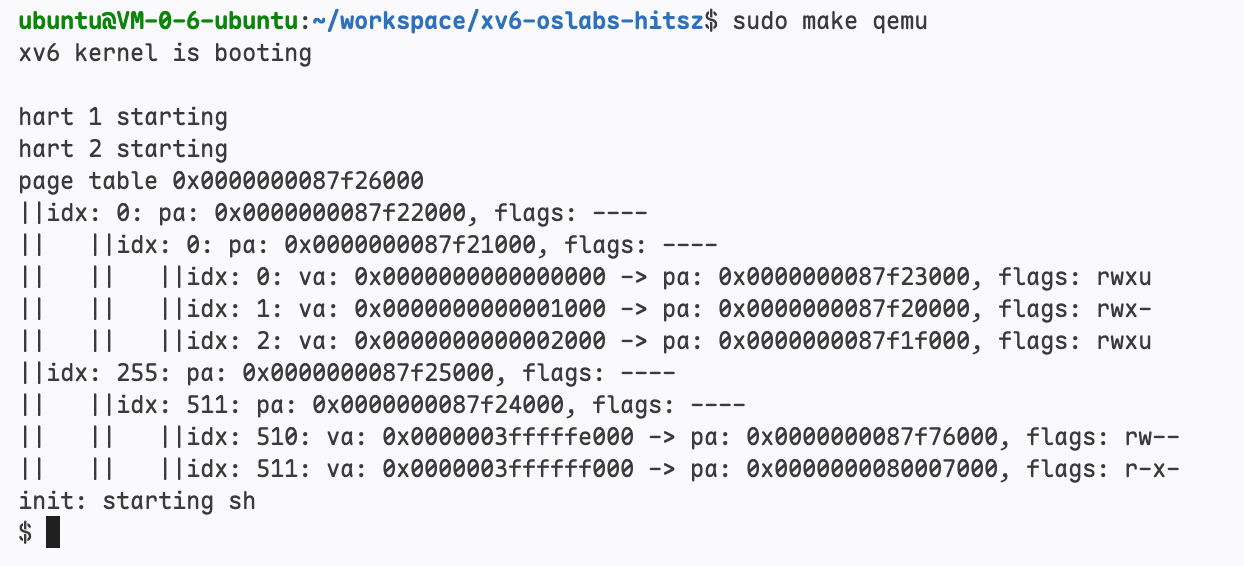
至于这些页表项怎么来的,可以查看 exec 来分析
0x0000003fffffe000 和 0x0000003ffffff000
首先,exec() 会调用 proc_pagetable() 来获取一份初始页表,这份页表包含了两项内容,分别是 TRAMPOLINE 和 TRAPFRAME 的映射
if ((pagetable = proc_pagetable(p)) == 0) goto bad;
pagetable_t proc_pagetable(struct proc *p) {
  pagetable_t pagetable;
  // An empty page table.
  pagetable = uvmcreate();  // 这个函数实际上只是调用 kalloc ,清空这一页后返回
  if (pagetable == 0) return 0;
  if (mappages(pagetable, TRAMPOLINE, PGSIZE, (uint64)trampoline, PTE_R | PTE_X) < 0) {
    uvmfree(pagetable, 0);
    return 0;
  }
  if (mappages(pagetable, TRAPFRAME, PGSIZE, (uint64)(p->trapframe), PTE_R | PTE_W) < 0) {
    uvmunmap(pagetable, TRAMPOLINE, 1, 0);
    uvmfree(pagetable, 0);
    return 0;
  }
  return pagetable;
}
这里 TRAMPOLINE 映射的作用是保证触发异常/中断时,在使用用户页表的情况下也能找到对应的 TRAMPOLINE 相关的入口
w_stvec(TRAMPOLINE + (uservec - trampoline));
TRAPFRAME 也是类似的,确保使用用户页表时,能找到当前进程对应的那份 TRAPFRAME
    # 进入 uservec 时从 sscratch 读取 TRAPFRAME 虚拟地址进行上下文保存
csrrw a0, sscratch, a0
// usertrapret 末尾
  uint64 satp = MAKE_SATP(p->pagetable);    // 切换到用户页表后可以使用 TRAPFRAME 了
  uint64 fn = TRAMPOLINE + (userret - trampoline);
  ((void (*)(uint64, uint64))fn)(TRAPFRAME, satp);
.globl userret
userret:
# 返回时,恢复上下文,用完后 TRAPFRAME 值放回 sscratch
# a0: TRAPFRAME, in user page table.
# a1: user page table, for satp.
# switch to the user page table.
csrw satp, a1
sfence.vma zero, zero
# put the saved user a0 in sscratch, so we
# can swap it with our a0 (TRAPFRAME) in the last step.
ld t0, 112(a0)
csrw sscratch, t0
TRAPFRAME 这个地址会保存在 sscratch 寄存器中,每一个用户进程根据这个虚拟地址能够映射到各自的 p->trapframe
所以现在可以知道地址 0x0000003fffffe000 和 0x0000003ffffff000 的来源是什么了
// riscv.h
#define MAXVA (1L << (9 + 9 + 9 + 12 - 1))  // 对应 sv39 方案,-1 是因为 xv6 不使用符号扩展,0x0000_0040_0000_0000

// memlayout.h
#define TRAMPOLINE (MAXVA - PGSIZE) // 0x0000_0040_0000_0000 - 0x0000_0000_0000_1000 = 0x0000_003f_ffff_f000
#define TRAPFRAME (TRAMPOLINE - PGSIZE)     // 0x0000_003f_ffff_f000 - 0x0000_0000_0000_1000 = 0x0000_003f_ffff_e000
0x0000000000000000 至 0x0000000000002000
而对于低地址的映射,这些一般会存放 ELF 的各个段,包括 .text, .data, .rodata, .bss 等
而在 xv6 中,载入内存的是 ELF 中需要载入内存的部分(ELF_PROG_LOAD)
// Program section header
struct proghdr {
  uint32 type;
  uint32 flags;
  uint64 off;
  uint64 vaddr;
  uint64 paddr;
  uint64 filesz;
  uint64 memsz;
  uint64 align;
};

  // Load program into memory.
  for (i = 0, off = elf.phoff; i < elf.phnum; i++, off += sizeof(ph)) { // 读取 ELF 的各个 headers
    if (readi(ip, 0, (uint64)&ph, off, sizeof(ph)) != sizeof(ph)) goto bad;
    if (ph.type != ELF_PROG_LOAD) continue;
    if (ph.memsz < ph.filesz) goto bad;
    if (ph.vaddr + ph.memsz < ph.vaddr) goto bad;
    uint64 sz1;
    if ((sz1 = uvmalloc(pagetable, sz, ph.vaddr + ph.memsz)) == 0) goto bad;    // 增大用户程序的大小,需要时分配页表
    sz = sz1;
    if (ph.vaddr % PGSIZE != 0) goto bad;
    if (loadseg(pagetable, ph.vaddr, ip, ph.off, ph.filesz) < 0) goto bad;      // 将 headers 对应的分段载入到内存中
  }
这就是 || || ||idx: 0: va: 0x0000000000000000 -> pa: 0x0000000087f23000, flags: rwxu 的来源
至于另外两个,它们的来源则是下面的代码
  // Allocate two pages at the next page boundary.
  // Use the second as the user stack.
  sz = PGROUNDUP(sz);
  uint64 sz1;
  if ((sz1 = uvmalloc(pagetable, sz, sz + 2 * PGSIZE)) == 0) goto bad;
  sz = sz1;
  uvmclear(pagetable, sz - 2 * PGSIZE);
  sp = sz;
  stackbase = sp - PGSIZE;
其中,VA 0x1000 的页经过 uvmclear 之后 flags 变为 rwx- 这样,如果栈超出范围了,可以检测出来,而 VA 0x2000 的页用作用户栈。
sp=0x3000stackbase=0x2000
任务二:独立内核页表
原版的 xv6 存在两种页表,内核页表和每个进程各自的用户页表,在进入和离开 trap 时会进行相应的切换。但是现在需要修改代码,使得 xv6 同时存在三种页表:
- 全局内核页表:也就是原来的内核页表
- 用户页表:还是原来的用户页表,每个进程都有一份
- 进程内核页表:新的页表,每个进程都有一份
进程进入内核态时,原本是需要切换到全局内核页表的,现在改成切换到进程内核页表,只有在调度器切换进程时,才回到全局内核页表,再切到对应进程的内核页表
改完之后,能够通过测试
kvmtest
usertests
这一题完成后,应该同时满足:
- 原版 xv6 的全局
kernel_pagetable仍然保留; - 每个进程在内核态运行时,使用自己的独立内核页表;
- 调度器
scheduler()自己运行时,仍然有一张可用的内核页表; - 每个进程的内核页表中,都能访问该进程自己的内核栈;
- 释放进程时,只释放“属于这张页表结构本身的页表页”,不能误释放共享的内核物理页。
设计实现
独立内核页表的内容以及初始化
首先需要搞清楚的事情是独立内核页表需要什么内容,原本的全局内核页表内容大致如下,查看 kvminit 等函数可以得知
UART0,VIRTIO0,CLINT,PLIC等硬件IO映射(Read, Write)KERNBASE映射到内核的.text字段的起始位置(Read,Execute)etext:内核的.text字段的结束为止(详见链接脚本kernel.ld,类似于 rCore 的内存布局部分)TRAMPOLINE:映射到 trampoline.S 的 tag,这部分和前面分析用户页表时是一样的KSTACK((int)(p - proc)):这部分在procinit()中,每一个进程都会有一个独立的内核栈区域,被无效 VA 包围
一个很容易发现的点是独立内核页表可以省去其他进程的内核栈映射,指导书还提到了“不要把 CLINT 映射进去,否则后面任务三做用户映射并入内核页表时会更容易遇到地址重合问题”
指导书提到:这一题里,这条映射(指内核栈)不能只放在全局 kernel_pagetable 里,还要出现在该进程自己的内核页表中。procinit() 负责“先分配物理页并保留全局映射”,allocproc() 再负责“补上进程私有内核页表里的那条映射”。对照源码时,可以先看 procinit(),再看 allocproc() 和 kernel/vm.c 里的 kvmmap()。
这里的 全局映射 容易误导人,实际上 procinit 不应该包含独立内核页表的任何操作,因为指导书的实现中它的生命周期应该是 alloproc 创建,freeproc 释放。
可以仿照 kvminit() 写一个类似的初始化函数,把独立内核页表的基本映射给建立,原本的 panic 改成了返回 -1 ,这是因为内核页表分配失败可以杀死进程而不必让整个系统崩溃。
// mappages for process kernel page table
int kvmmap_common(pagetable_t pagetable){
  // uart registers
  if (mappages(pagetable, UART0, PGSIZE, UART0, PTE_R | PTE_W)!=0) return -1;
  // virtio mmio disk interface
  if (mappages(pagetable, VIRTIO0, PGSIZE, VIRTIO0, PTE_R | PTE_W)!=0) return -1;
  // CLINT
  // if(mappages(pagetable, CLINT, 0x10000, CLINT, PTE_R | PTE_W)!=0) return -1;
  // PLIC
  if (mappages(pagetable, PLIC, 0x400000, PLIC, PTE_R | PTE_W)!=0) return -1;
  // map kernel text executable and read-only.
  if (mappages(pagetable, KERNBASE, (uint64)etext - KERNBASE, KERNBASE, PTE_R | PTE_X)!=0) return -1;
  // map kernel data and the physical RAM we'll make use of.
  if (mappages(pagetable, (uint64)etext, PHYSTOP - (uint64)etext, (uint64)etext, PTE_R | PTE_W)!=0) return -1;
  // map the trampoline for trap entry/exit to
  // the highest virtual address in the kernel.
  if (mappages(pagetable, TRAMPOLINE, PGSIZE, (uint64)trampoline, PTE_R | PTE_X)!=0) return -1;
  return 0;
}
写到这里的时候才发现可以改过来,原本是直接 panic,不过也能通过测试
然后仿照用户页表 proc_pagetable 的方式建一个 proc_kpagetable 函数
// Create a kernel page table for a given process,
pagetable_t proc_kpagetable(struct proc *p) {
  pagetable_t pagetable = (pagetable_t)kalloc();
  if (pagetable == 0) return 0;
  memset(pagetable, 0, PGSIZE);
  if (kvmmap_common(pagetable)!=0){
    free_kernel_pagetable(pagetable); // not free physical pages
    return 0;
  }
  if (mappages(pagetable, p->kstack, PGSIZE, p->kstack_pa, PTE_R | PTE_W) < 0){
    free_kernel_pagetable(pagetable); // not free physical pages
    return 0;
  }
  return pagetable;
}
这里 free_kernel_pagetable() 是新写的,能够清理页表而不释放对应的物理内存,后面会提及这一点。
注意到这里有个 p->kstack_pa 和 p->kstack,p_stack_pa 是新加到 struct proc 里面的字段。procinit 的时候对栈的物理地址进行了保存,就是为了这里的映射。
// initialize the proc table at boot time.
void procinit(void) {
  struct proc *p;

  initlock(&pid_lock, "nextpid");
  for (p = proc; p < &proc[NPROC]; p++) {
    initlock(&p->lock, "proc");

    // Allocate a page for the process's kernel stack.
    // Map it high in memory, followed by an invalid
    // guard page.
    char *pa = kalloc();
    if (pa == 0) panic("kalloc");
    uint64 va = KSTACK((int)(p - proc));
    kvmmap(va, (uint64)pa, PGSIZE, PTE_R | PTE_W);
    p->kstack = va;
    p->kstack_pa = (uint64)pa;  // 新加的
  }
  kvminithart();
}
同样的, k_pagetable 也是新加的字段
完成之后可以在 allocproc 中调用这个函数,同样仿照 proc_pagetable() 的格式
static struct proc *allocproc(void) {
  ...
  // Initialize process kernel page table
  p->k_pagetable = proc_kpagetable(p);
  if (p->k_pagetable == 0) {
    freeproc(p);
    release(&p->lock);
    return 0;
  }
  ...
}
独立内核页表的释放
独立内核页表的释放还是直接仿照 proc_freepagetable
// Free a process's page table, and free the
// physical memory it refers to.
void proc_freepagetable(pagetable_t pagetable, uint64 sz) {
  uvmunmap(pagetable, TRAMPOLINE, 1, 0);
  uvmunmap(pagetable, TRAPFRAME, 1, 0);
  uvmfree(pagetable, sz);
}
// Free a process's kernel page table, and free the
// physical memory it refers to.
void proc_freekpagetable(pagetable_t pagetable) {
  free_kernel_pagetable(pagetable);
}
在 freeproc 里调用
static void freeproc(struct proc *p) {
  if (p->trapframe) kfree((void *)p->trapframe);
  p->trapframe = 0;

  if (p->k_pagetable){
      proc_freekpagetable(p->k_pagetable);
  }

  if (p->pagetable)
      proc_freepagetable(p->pagetable, p->sz);
  p->k_pagetable = 0;
  p->pagetable = 0;
  p->sz = 0;
  ...
}
现在只剩下 free_kernel_pagetable() 需要解决了,直接抄袭 freewalk 即可
// freewalk, but not free physical pages
void free_kernel_pagetable(pagetable_t pagetable) {
  if(pagetable == 0)
    return;
  // there are 2^9 = 512 PTEs in a page table.
  for (int i = 0; i < 512; i++) {
    pte_t pte = pagetable[i];
    if ((pte & PTE_V) && (pte & (PTE_R | PTE_W | PTE_X)) == 0) {
      // this PTE points to a lower-level page table.
      uint64 child = PTE2PA(pte);
      free_kernel_pagetable((pagetable_t)child);
      pagetable[i] = 0;
    } else if (pte & PTE_V) {
      // leaf
      pagetable[i] = 0;
    }
  }
  kfree((void *)pagetable);
}
页表切换
内核页表的切换发生在 scheduler 中,选择好进程之后就可以切换到对应的内核页表,回来的时候变成全局内核页表,下面是指导书的示意图
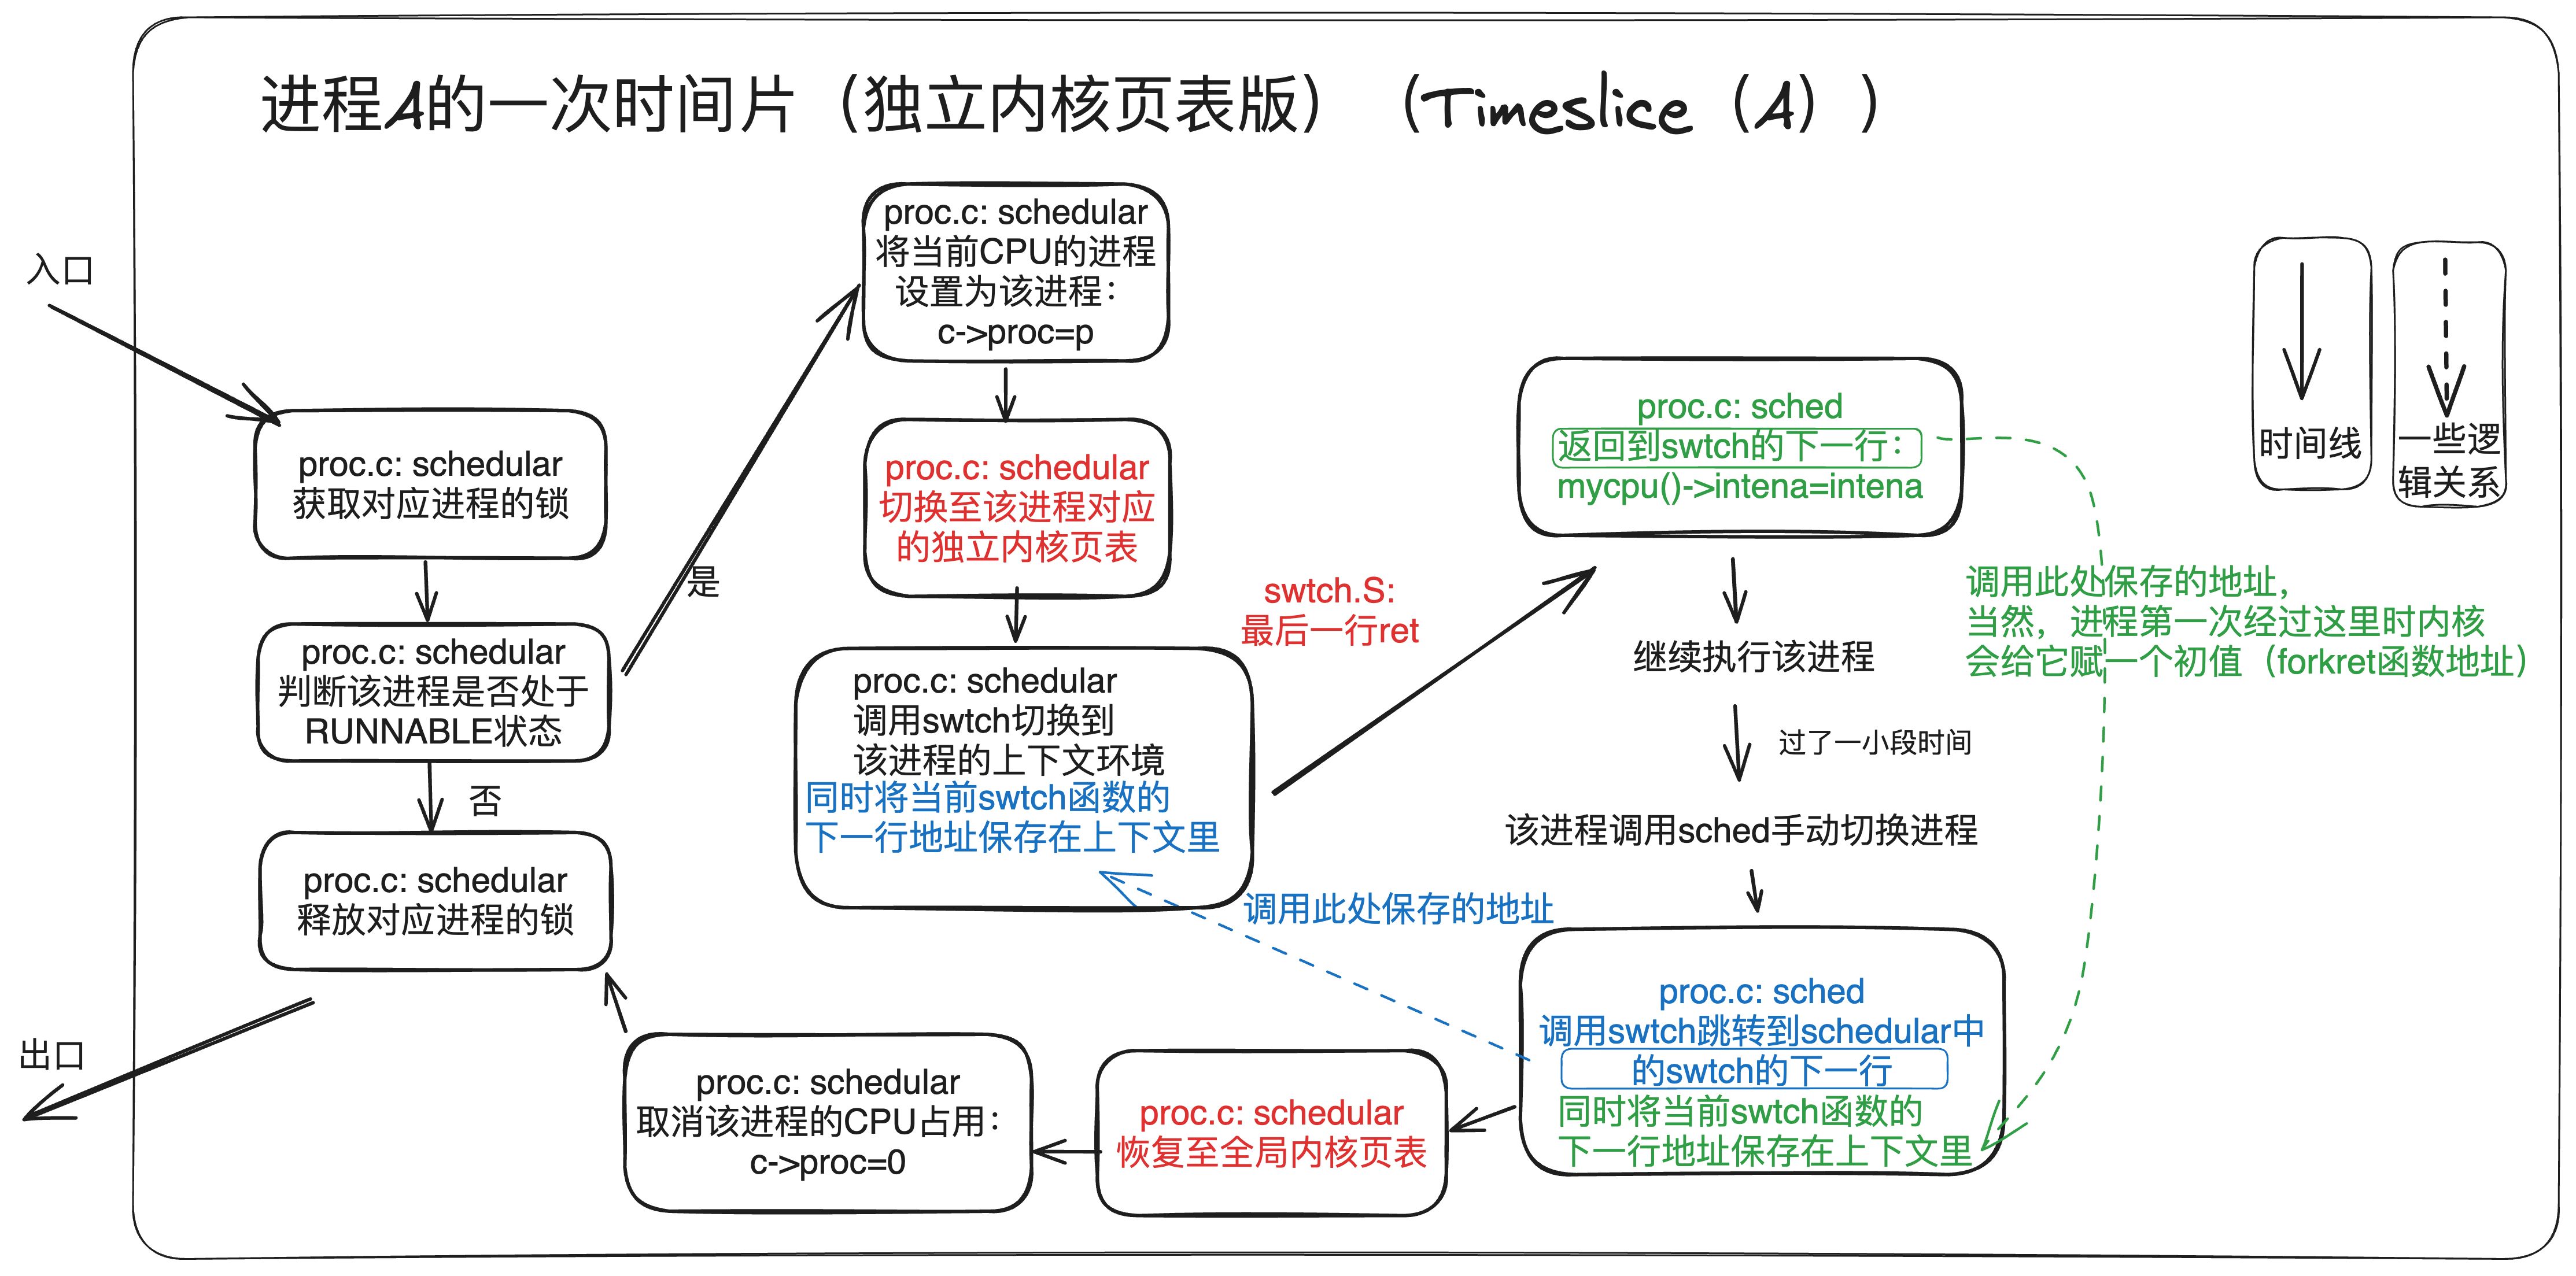
p->state = RUNNING;
c->proc = p;
w_satp(MAKE_SATP(p->k_pagetable));  // 切换页表到独立内核页表
sfence_vma();                       // 刷新 TLB
swtch(&c->context, &p->context);
// switch back to kernel page table
kvminithart();                      // 实际内容是切换到内核页表
当页表切换到独立内核页表并且进行上下文切换之后,回去时通常会经过 sched, yield(), usertrapret, 最后回到用户程序
在回到用户程序之前,可以看到 usertrapret 中有一段
void usertrapret(void) {
  struct proc *p = myproc();
  ...
  p->trapframe->kernel_satp = r_satp();          // kernel page table
  p->trapframe->kernel_sp = p->kstack + PGSIZE;  // process's kernel stack
  p->trapframe->kernel_trap = (uint64)usertrap;
  p->trapframe->kernel_hartid = r_tp();  // hartid for cpuid()
  ...
}
这意味着 p->trapframe->kernel_satp 被更换成了独立内核页表,而发生异常/中断时,恢复的内核页表就是从这里来的。
这样一来,不难发现正常情况下原本的全局内核页表只剩下 scheduler() 这一段在使用了。
测试运行
运行 kvmtest 和 usertests 分别验证独立内核页表功能和其他用户程序功能
init: starting sh
$ kvmtest
kvmtest: start
test_pagetable: 1
kvmtest: OK
$ usertests
...
任务三:简化软件模拟地址翻译
在原版的 xv6 中,如果用户程序数据与内核数据要发生交换,就需要使用 copyin, copyout 等函数,这个函数会使用 p->pagetable 来得到用户程序的虚拟地址对应的物理地址,然后进行拷贝。而虚拟地址到物理地址这个过程是由 walkaddr 完成的,它通过软件模拟一次页表查询的过程,来得到对应的物理地址。
如果把这用户程序数据部分映射保存到独立内核页表中,就可以省去软件模拟翻译这一步。这就是这个任务的目标:
完成后应满足:
- 独立内核页表中包含对应进程的用户地址映射;
copyin_new()/copyinstr_new()被接到正确的调用路径上;- 用户页表变化时,独立内核页表里的对应映射也能同步更新;
- 不会因为权限位、地址重合或页表回收引入新的错误。
独立内核页表和用户页表是否会有冲突问题?
用户虚拟地址范围不能和内核已经使用的虚拟地址范围重叠。
查看内核页表的布局,或者说物理内存的布局
// 00001000 -- boot ROM, provided by qemu
// 02000000 -- CLINT
// 0C000000 -- PLIC
// 10000000 -- uart0
// 10001000 -- virtio disk
// 80000000 -- boot ROM jumps here in machine mode
//             -kernel loads the kernel here
// unused RAM after 80000000.
其中 boot ROM 没有映射到内核页表,不用考虑
而 CLINT 是 Core-Local Interruptor,这部分区域通常不属于每个进程自己的内核执行流必须单独携带的地址空间,查看一下 xv6 有哪些地方用到了这块区域
// local interrupt controller, which contains the timer.
#define CLINT 0x2000000L
#define CLINT_MTIMECMP(hartid) (CLINT + 0x4000 + 8*(hartid))
#define CLINT_MTIME (CLINT + 0xBFF8) // cycles since boot.
从页表映射可以看到这块区域的范围是 0x0200_0000 至 0x020F_FFFF
void kvminit() {
  // CLINT
  kvmmap(CLINT, CLINT, 0x10000, PTE_R | PTE_W);
  ...
}
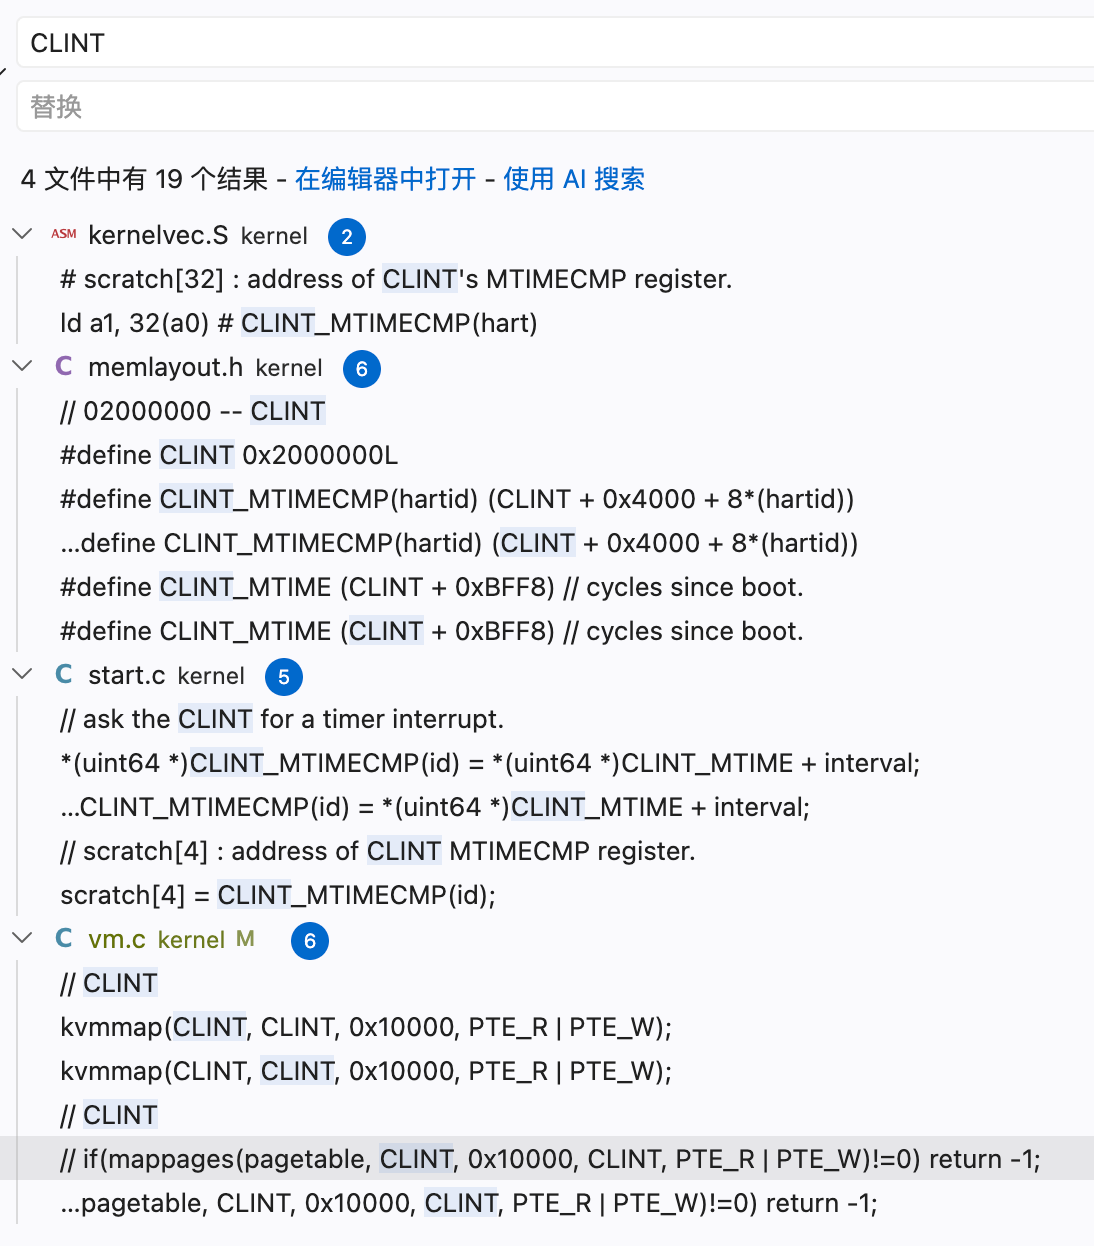
搜索发现,除去页表映射和宏定义,这段区域使用到的地方如下
timerinit- 获取 Hart id 并且设置对应的计时器比较值(大约是当前值+0.1s)
- 找到当前 Hart id 对应
&mscratch0[32 * id],每个CPU都能分到 32 个uint64_t大小的空间 - 这个
scratch的前三个位置用于保存寄存器a1, a2, a3,第四个位置存放比较值的物理地址,第五个位置存放了中断的间隔 - 将
scratch指针写入到mscratch寄存器中备用 - 设置
mtvec为timervec并启用 M-Mode 中断和计时器中断
timervec- 保存前三个寄存器
a1, a2, a3然后载入scratch里的第四、第五个值到a1, a2 - 从第四个值中得到计时器的当前值,并且将该值加上第五个值,写回计时器比较值对应的物理地址(相当于设置 TIMECMP = TIME + interval)
sip写入 2:触发/挂起一个 Supervisor(S-mode)软件中断
- 保存前三个寄存器
虽然有中断委托,但是 Machine timer interrupt (MTIP) 是不会被委托给 S-Mode 的,也就是说,xv6 发生计时器中断时,会进入 mtvec 指向的 timervec 并且特权模式会切换到 M-mode,而在 M-Mode 下,不会使用 satp 进行任何地址翻译,也就能够安全地使用 CLINT 这片区域。执行完 timervec 之后,触发一个软件中断就会进入 stvec 指向的 uservec 以及对应的 S-Mode,后续在 devintr() 中就会检测出来是软件中断,从而判断出这是计时器中断。
经过上面的分析,可以知道,正常情况下不会用到这块映射。因为要访问 CLINT 时都会在 M-Mode 下访问,所以独立内核页表可以安全地去掉这块映射,如此一来,用户的地址空间就可以扩展到 PLIC 之前的所有区域。而相比之下 PLIC 是会在 S-Mode 进行访问的,或者更准确地说,这片区域的使用情况会出现在 uservec->usertrap->devintr->plic_complete 的路径上,在此期间使用的都是独立内核页表,所以不能去掉这片页表映射。
由此可以确定,用户的 VA 范围就是 [0, 0x0C00,0000)
同步页表
确认了用户 VA 范围之后,就可以将用户页表同步到独立内核页表中。写一个同步函数如下,共享最后一级页表
// process kernel pagetable and user page table share the level 0 ptes
void sync_pagetable(pagetable_t pagetable, pagetable_t k_pagetable) {
    if (!(pagetable[0] & PTE_V))
        return;

    if (!(k_pagetable[0] & PTE_V))
        return;
    pagetable_t user_l1 = (pagetable_t)PTE2PA(pagetable[0]);
    pagetable_t kernel_l1 = (pagetable_t)PTE2PA(k_pagetable[0]);
    // 一页 4KiB,一个L1页表可以存放 4096/8 = 512 个 L0 Entry,对应 512 * 4096 Bytes 的空间
    // 0x0C00_0000 也就是 12 * 2^24 Bytes,需要 12 * 2^24 / (512*4096)=96 个 L1 页表,因为 96 < 512 所以只需要一个 L0 页表项就够了
    for(int i = 0; i < 96; i++){
        kernel_l1[i] = user_l1[i];
    }
}
现在还需要解决释放的问题,L0 页表是共享的,所以可能会有重复释放的问题,因此在释放独立内核页表前必须要将这部分页表删除掉,也就有了下面的工具函数
void clear_user_mapping(pagetable_t pagetable)
{
  if (!(pagetable[0] & PTE_V))
    return;
  pagetable_t kernel_l1 =
    (pagetable_t)PTE2PA(pagetable[0]);

  for(int i=0;i<96;i++){
    kernel_l1[i]=0;
  }
}
这个函数得补充到函数 freekpagetable 前
static void freeproc(struct proc *p) {
  if (p->trapframe) kfree((void *)p->trapframe);
  p->trapframe = 0;

  if (p->k_pagetable){
      clear_user_mapping(p->k_pagetable);
      proc_freekpagetable(p->k_pagetable);
  }
这样就解决了释放的问题,现在需要将同步页表函数放到各种地方,每一个用户页表更改的地方都需要放上这个同步函数
指导书给出了下面几个位置:
fork():子进程会继承父进程的用户地址空间。这里通常是在子进程的用户页表和私有内核页表都准备好之后,再对子进程 调用一次sync_pagetable()。注意,struct proc *np是子进程的 PCB,struct proc *p是父进程的 PCB,不要用错了。exec():它会丢弃旧的用户页表,重新建立一张新的用户页表。因此在新页表真正装到当前进程上之后,也要再调用一次sync_pagetable()。growproc()/sbrk():sbrk()是用户态申请或回收内存时走到的系统调用入口,而真正修改当前进程用户地址空间大小的,通常是内核里的growproc()。因此,更常见的改法是在growproc()完成扩容或缩容之后,再重新同步一次页表。userinit():第一个进程同样会建立自己的用户页表和独立内核页表,这里也不要漏掉同步。
把这些地方补上即可
把 copyin() / copyinstr() 改为调用新的实现
直接查找替换即可,它们的参数列表是一样的,但是改完之后运行会有权限问题,因为 L0 页表项中 PTE_U 是 1,内核不能直接访问,修改 copyin_new() 和 copyinstr() 如下
int copyin_new(pagetable_t pagetable, char *dst, uint64 srcva, uint64 len) {
  struct proc *p = myproc();
  w_sstatus(r_sstatus() | SSTATUS_SUM);

  if (srcva >= p->sz || srcva + len >= p->sz || srcva + len < srcva) {
    w_sstatus(r_sstatus() & ~SSTATUS_SUM);
    return -1;
  }
  memmove((void *)dst, (void *)srcva, len);
  stats.ncopyin++;  // XXX lock
  w_sstatus(r_sstatus() & ~SSTATUS_SUM);
  return 0;
}
这里临时将 SSTATUS_SUM 位设置为1,这样就可以允许 S-mode 访问 U 页(PTE_U=1)的 load/store。返回前设置回 0 恢复正常。
但是指导书说不要修改 kernel/vmcopyin.c。这部分是实验框架已经提供好的。那只能将这份代码全部复制一份了
int copyin_new(pagetable_t pagetable, char *dst, uint64 srcva, uint64 len) {
  struct proc *p = myproc();
  // w_sstatus(r_sstatus() | SSTATUS_SUM);

  if (srcva >= p->sz || srcva + len >= p->sz || srcva + len < srcva) {
    w_sstatus(r_sstatus() & ~SSTATUS_SUM);
    return -1;
  }
  memmove((void *)dst, (void *)srcva, len);
  stats.ncopyin++;  // XXX lock
  // w_sstatus(r_sstatus() & ~SSTATUS_SUM);
  return 0;
}
采用类似于下面的方式
  w_sstatus(r_sstatus() | SSTATUS_SUM);
  int err = copyinstr_new(p->pagetable, buf, addr, max);
  w_sstatus(r_sstatus() & ~SSTATUS_SUM);
  if (err < 0) return err;
全部测试
指导书建议按下面顺序检查:
- 任务一完成后,先对照指导书中的
vmprint()输出格式。 - 任务二完成后,先跑
kvmtest,再跑usertests。 - 任务三完成后,可以先跑
stats stats看修改后的实现是否真的被用到,再跑usertests和make grade
全部截图如下
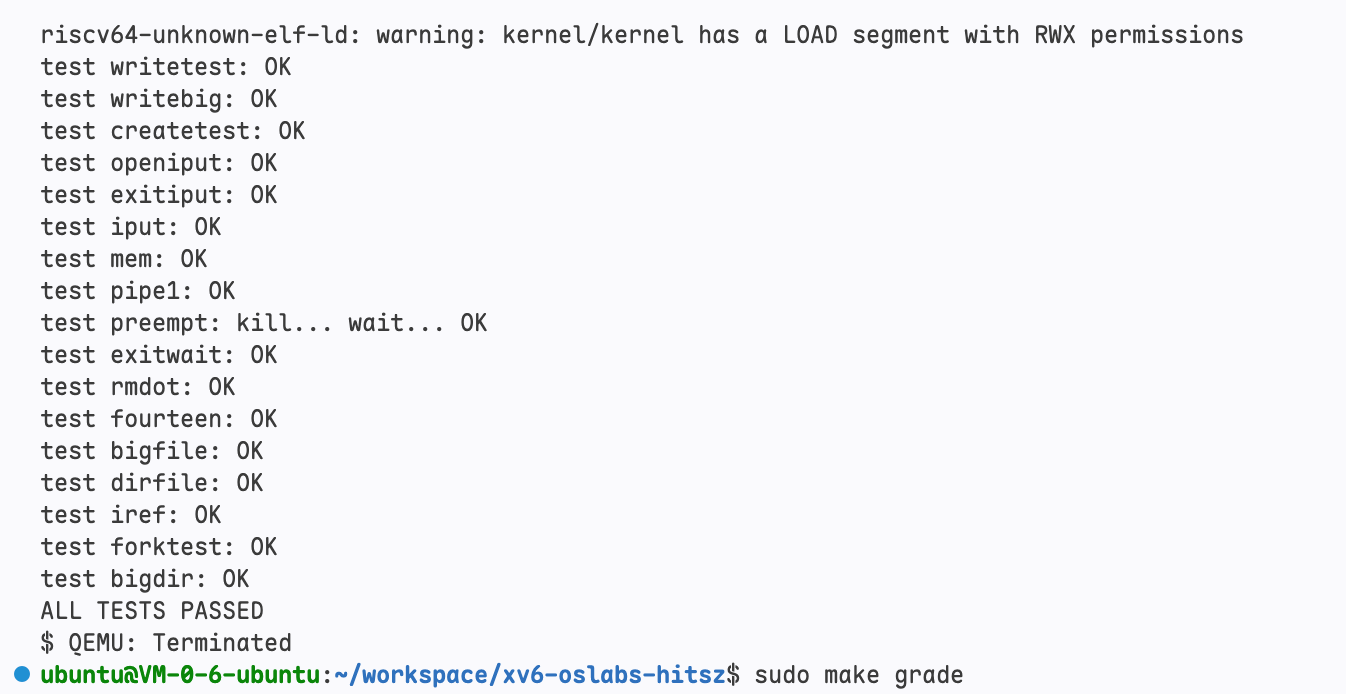
stats stats 和 make grade 的结果
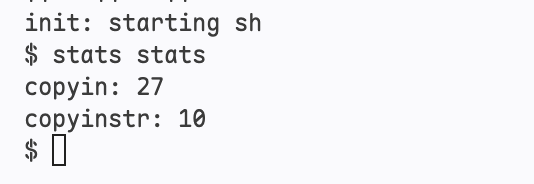
不为零说明确实用到了 copyin_new() / copyinstr_new()