实验目的
现代操作系统通常使用页表管理虚拟内存。一个虚拟地址可以拆分为 VPN(Virtual Page Number)和页内偏移量(offset);TLB 根据 VPN 和地址空间标识(ASID,Address Space ID)缓存对应的 PPN(Physical Page Number),从而减少页表遍历的次数。
TLB 的工作方式类似缓存:TLB hit 可以直接得到地址转换结果,TLB miss 则需要进行页表遍历,并把结果载入 TLB。由于 TLB 容量有限,访问的虚拟页数量增加到一定程度后,TLB miss 的比例可能上升,单次访问时间也会增加。
本实验来自 OSTEP 的 Paging: Faster Translations (TLBs) 章节。程序按页访问数组,逐渐增加工作集中的页数,并观察平均每次访问的耗时。需要注意:这个方法测到的是地址转换、数据缓存、页表缓存和虚拟化等因素叠加后的结果,因此只能帮助定位延迟变化的区间,不能单独证明某一级 TLB 的精确容量。
OSTEP 使用的核心循环如下:
int jump = PAGESIZE / sizeof(int);
for (i = 0; i < NUMPAGES * jump; i += jump) {
    a[i] += 1;
}
测试程序 tlb.c 接收两个参数:
- 访问的页数(number of pages)
- 测试的次数(number of trials)
OSTEP 给出的例子如下:
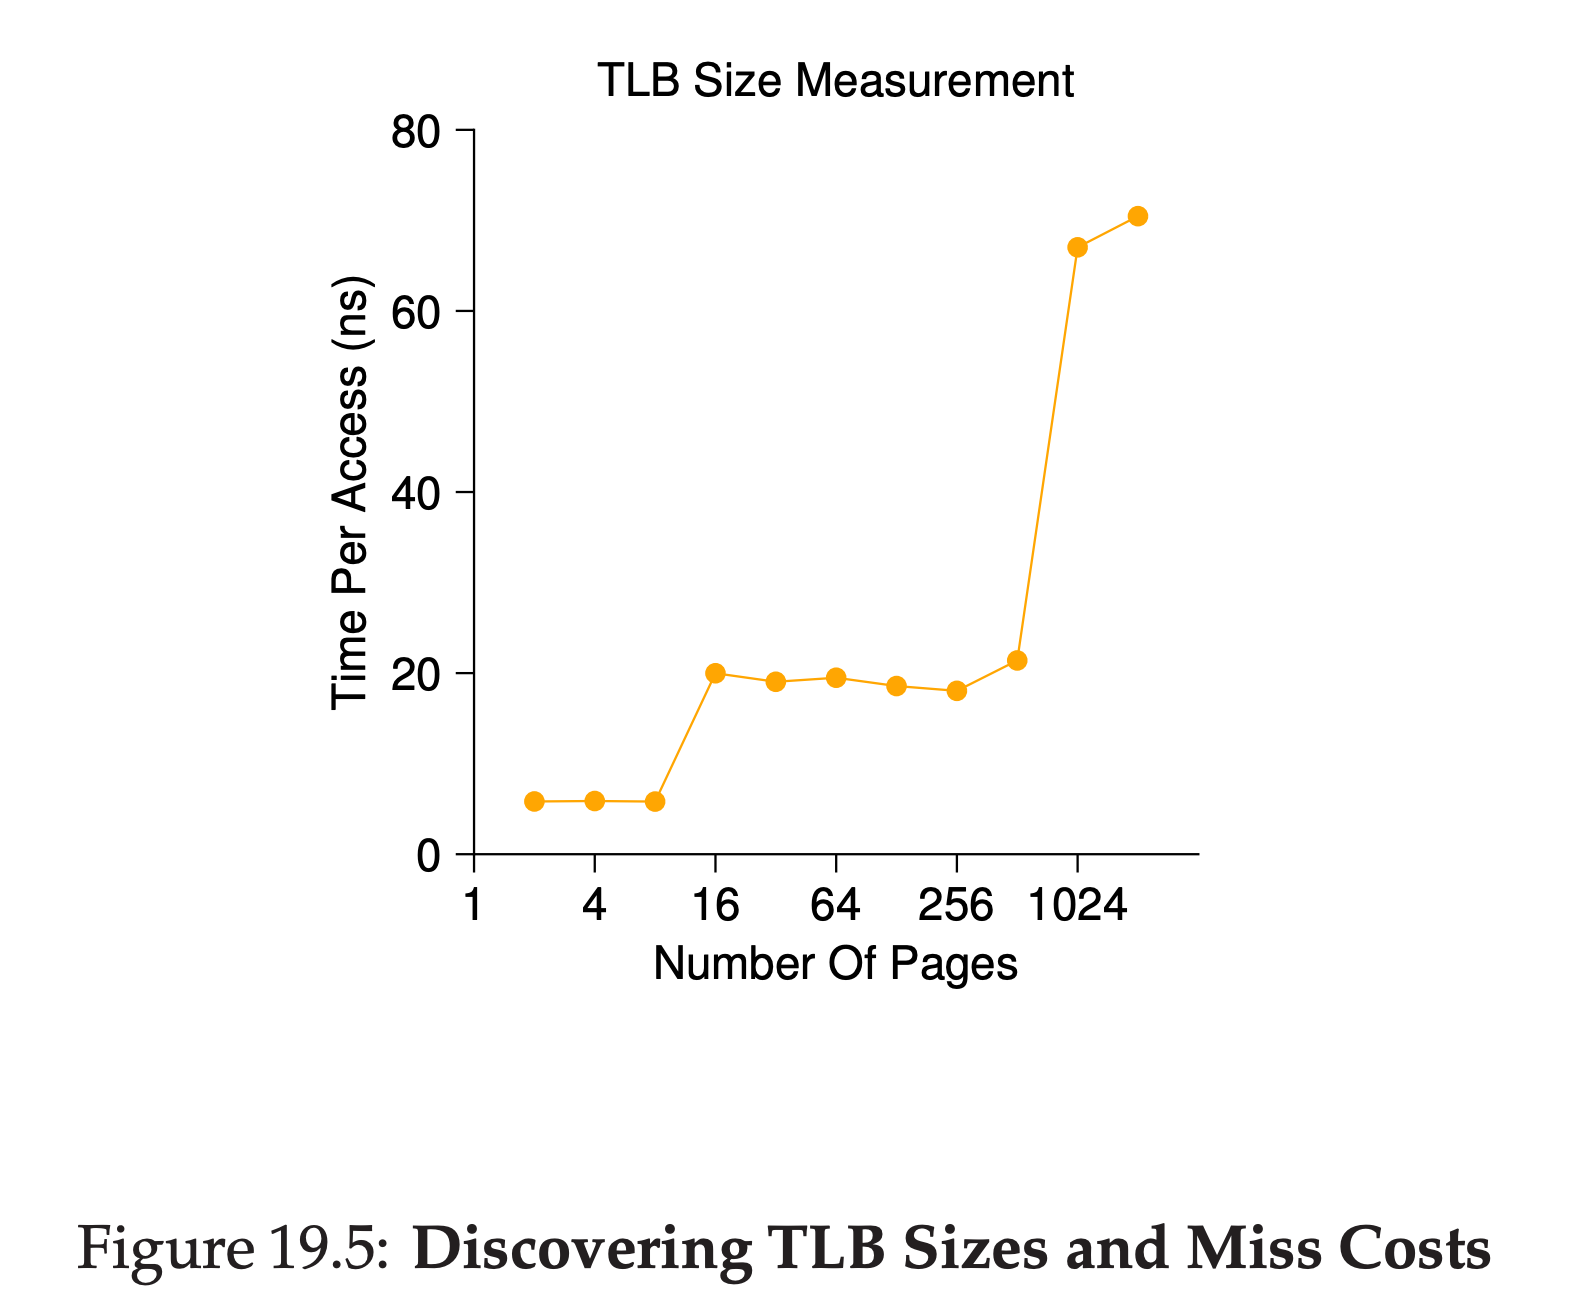
根据曲线,原文将第一级 TLB 的候选边界放在 8~16 个条目附近,将第二级 TLB 的候选边界放在 512 个条目附近。这里的判断依赖特定测试环境和访问模式,不能视为所有处理器的通用规格。
实验准备
测试环境
本文在多台机器上进行了测试。两台云主机的结果不能等同于裸机结果,因为虚拟 CPU、调度和宿主机缓存状态都可能影响曲线。
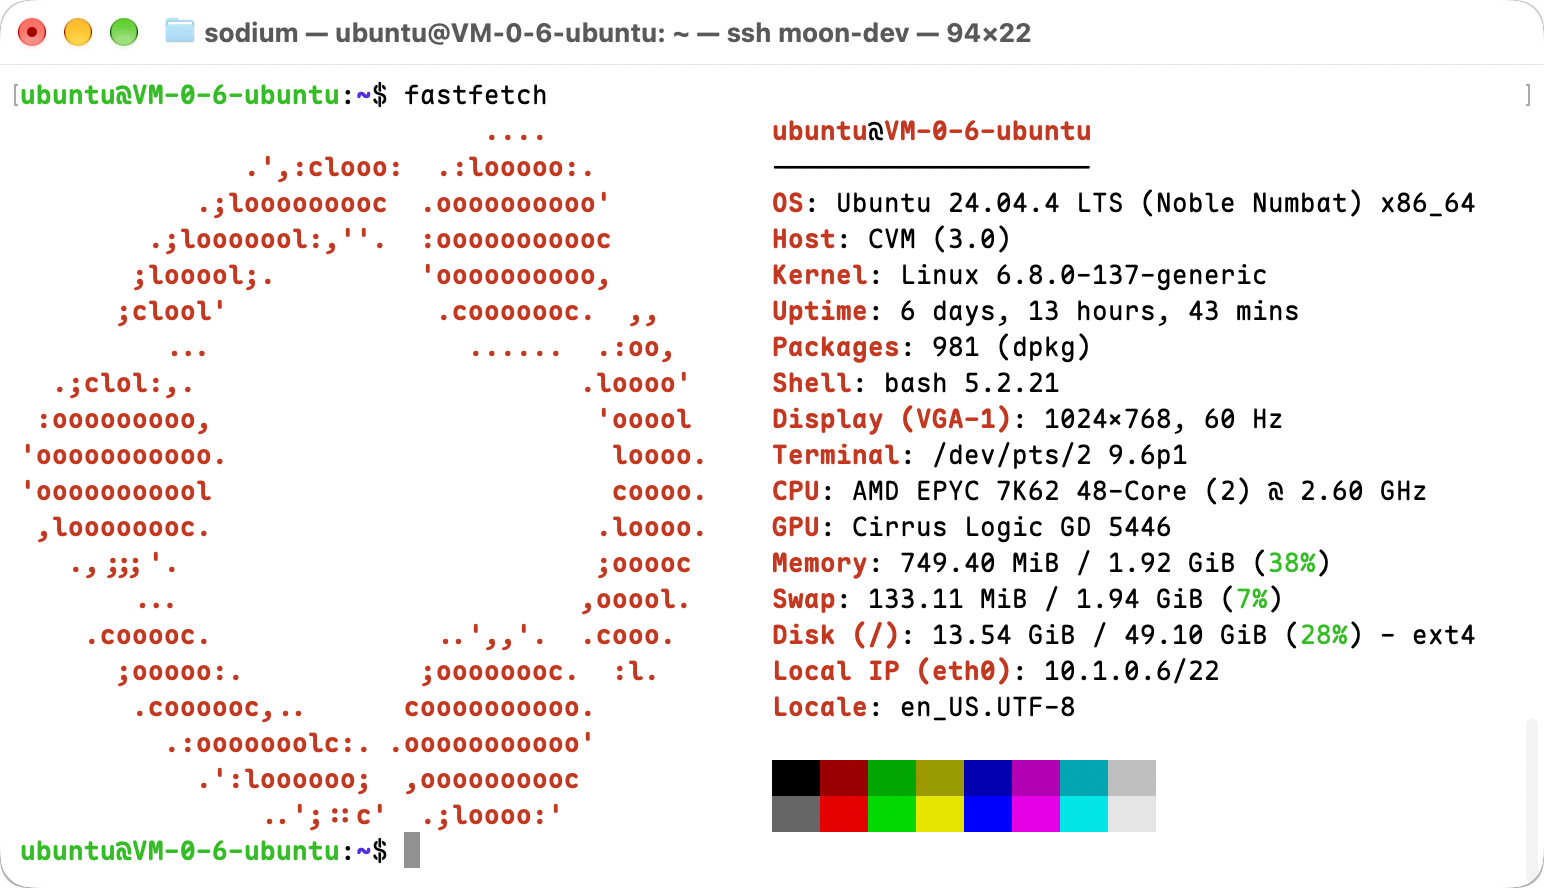
一号机器是腾讯云的轻量应用服务器(2CPU 2G+50G),GCC Version 13.3
二号机器是 Vultr 的 VPS (1vCPU 1G+25G),GCC Version 13.3
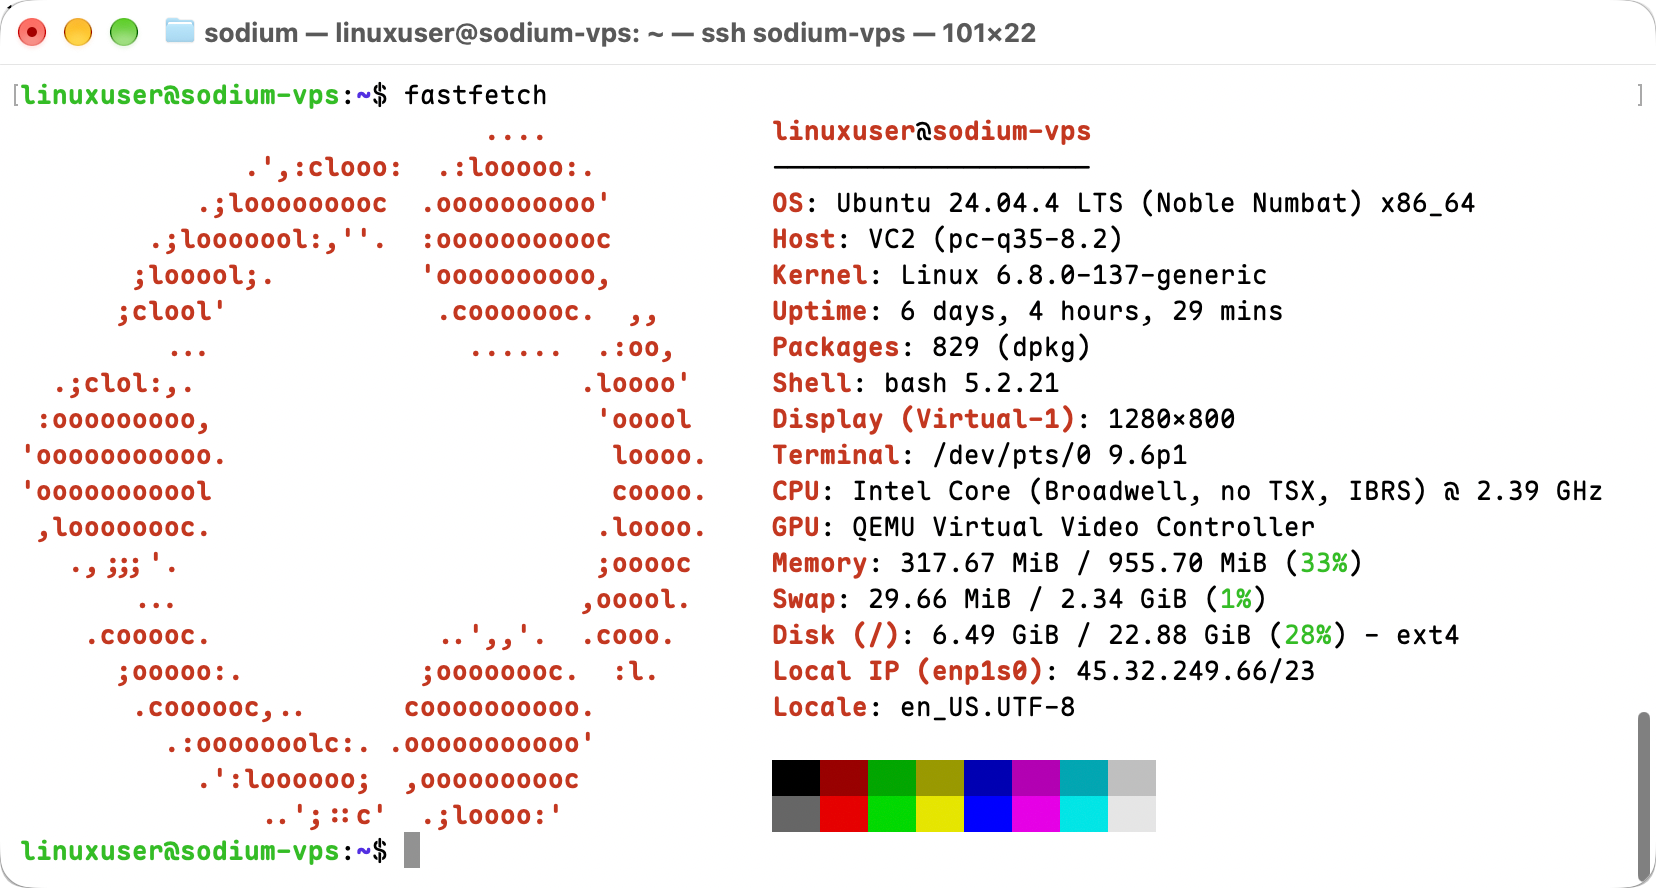
| 项目 | 一号机:腾讯云 CVM | 二号机:Vultr VPS |
|---|---|---|
| CPU | AMD EPYC 7K62 48-Core @ 2.60 GHz | Intel Core(Broadwell, no TSX, IBRS)@ 2.39 GHz |
| 内存 | 1.92 GiB | 955.70 MiB |
| Swap | 1.94 GiB | 2.34 GiB |
| 磁盘 | 49.10 GiB | 22.88 GiB |
| 虚拟化平台 | CVM 3.0 | VC2(pc-q35-8.2) |
| 操作系统 | Ubuntu 24.04.4 LTS x86_64 | Ubuntu 24.04.4 LTS x86_64 |
| Linux 内核 | 6.8.0-137-generic | 6.8.0-137-generic |
Vultr VPS 向虚拟机暴露的 CPU 模型 Intel Core Processor (Broadwell, no TSX, IBRS),CPUID 为 Family 6, Model 61, Stepping 2。该模型对应 QEMU 的 Broadwell-noTSX-IBRS 虚拟 CPU profile,因此无法仅根据该信息确定宿主机上的具体物理 CPU 型号。
除此之外还借用了两台机器:三号机器是 WSL(宿主机为 AMD Ryzen 7 8845HS,Zen 4 架构),四号机器是 Linux 物理机(Intel Core i5-9600F,Coffee Lake Refresh 架构)。
计时器
原始版本使用 gettimeofday() 获取时间。它返回墙上时钟时间,可能受系统校时影响;同时它的微秒分辨率也不适合直接测量很短的单次访问。更稳妥的实现应使用单调时钟,例如 clock_gettime(CLOCK_MONOTONIC, ...),并通过足够多次重复来降低计时器开销。
#include <time.h>       // 提供 clock_gettime
#include <stdio.h>      // 提供 printf

int main(void) {
    struct timespec val;
    int ret = clock_gettime(CLOCK_MONOTONIC, &val);
    if (ret == -1) {
        perror("clock_gettime");
        return ret;
    }
    printf("sec: %lld, nsec: %ld\n", (long long)val.tv_sec, val.tv_nsec);
    return 0;
}
上一篇 Homework Measurement 对系统调用本身有更详细的说明,详见 OSTEP HWM1:System Call。
绑定 CPU
为了减少进程在 CPU 之间迁移带来的噪声,可以把进程绑定到一个 CPU。绑定 CPU 并不能消除调度抢占和虚拟化带来的影响。
sched_setaffinity() 函数能让我们指定进程在特定的一个或多个CPU上运行,一个简单用例如下
cpu_set_t set;
CPU_ZERO(&set);     // 清空 CPU mask
CPU_SET(0, &set);   // 添加 CPU 0
if (sched_setaffinity(0, sizeof(set), &set) == -1) {    // 绑定当前进程到 CPU 0
    perror("sched_setaffinity");
    exit(1);
}
上一篇 Homework Measurement 对该接口有更详细的说明,详见 OSTEP HWM1:System Call。
编译优化
GCC 常见的优化级别如下
| 选项 | 含义 | 特点 |
|---|---|---|
-O0 | 不优化 | 默认;方便调试,代码通常最慢 |
-O1 | 基础优化 | 优化编译速度、代码大小和运行速度的平衡 |
-O2 | 较强优化 | 工程中很常见,通常是推荐的生产构建级别 |
-O3 | 激进优化 | 在 -O2 基础上进一步进行循环、向量化等优化 |
-Os | 优化代码大小 | 尽量减小生成的可执行文件 |
-Oz | 极致代码大小 | GCC 支持情况取决于版本/目标平台,Clang 更常见 |
-Ofast | 极致性能 | 在 -O3 基础上允许一些不严格遵守语言/IEEE 标准的优化 |
-Og | 调试优化 | 保持较好的调试体验,同时进行一些优化 |
编译器优化可能改变循环的实现,甚至删除没有可观察副作用的访问。因此需要保留可观察结果,或使用合适的 volatile,并明确记录编译选项。不同优化级别的结果不应直接混在同一条曲线中比较。
gcc -O0 tlb.c -o tlb-O0
gcc -O2 tlb.c -o tlb-O2
gcc -O3 tlb.c -o tlb-O3
本文统一采用 -O2 优化级别。
页对齐
为了使页数和访问范围更容易对应,可以把数组起始地址对齐到页边界。posix_memalign() 成功时返回的地址满足指定对齐要求:
int posix_memalign(
    void **memptr,      // 把申请到的内存地址写入到 memptr。
    size_t alignment,   // 返回的地址必须是 alignment 的整数倍
    size_t size         // 表示申请 size 个字节。
);
示例:
int *a = NULL;  // 数组基地址
    if (posix_memalign((void **)&a, page_size, array_size) != 0) {
    perror("posix_memalign");
    return 1;
}
页大小
Unix-like 系统提供了接口来查询 Page Size,用例如下
#include <unistd.h>
#include <stdio.h>

int main() {
    long page_size = sysconf(_SC_PAGESIZE);
    printf("Page size: %ld bytes\n", page_size);
    return 0;
}
本文测试环境中的结果是:
Page size: 4096 bytes
测试程序
程序介绍
下面是程序的核心循环部分,在 OSTEP 给出的 base code 基础上扩展而来:
for (size_t num_pages = min_pages; num_pages <= max_pages; num_pages += number) {
    // 防止编译器优化掉整个测试
    volatile int *va = a;
    gettimeofday(&start, NULL);
    for (uint64_t r = 0; r < repeat; r++) {
        for (size_t i = 0; i < num_pages * stride; i += stride) {
            va[i] += 1;
        }
    }
    gettimeofday(&end, NULL);
    uint64_t total_accesses = (uint64_t)num_pages * repeat;
    uint64_t elapsed_ns =
            (uint64_t)(end.tv_sec - start.tv_sec) * 1000000000ULL + (uint64_t)(end.tv_usec - start.tv_usec) * 1000ULL;
    double ns_per_access =
            (double)elapsed_ns / (double)total_accesses;

    printf("%ld, %llu, %.3f\n",
           num_pages,
           (unsigned long long)total_accesses,
           ns_per_access);
}
测试结果
一号机器:腾讯云 CVM
# pages, total accesses, ns/access
1, 10000, 2.500
2, 20000, 2.300
4, 40000, 1.300
8, 80000, 0.725
16, 160000, 11.969
32, 320000, 16.575
64, 640000, 15.527
128, 1280000, 15.791
256, 2560000, 13.778
512, 5120000, 15.418
1024, 10240000, 16.253
2048, 20480000, 16.054
4096, 40960000, 16.075
8192, 81920000, 13.065
16384, 163840000, 12.938
32768, 327680000, 12.908
65536, 655360000, 13.498
为减少短测试的计时误差,又使用更大的重复次数进行了测试:
# pages, total accesses, ns/access
1, 10000000, 2.473
2, 20000000, 2.342
4, 40000000, 1.324
8, 80000000, 0.763
16, 160000000, 12.102
32, 320000000, 16.302
64, 640000000, 15.904
128, 1280000000, 16.459
256, 2560000000, 15.949
512, 5120000000, 16.618
1024, 10240000000, 16.567
扩展程序后,又测试了更大的工作集:
min_pages: 65536
max_pages: 262144
# pages, total accesses, ns/access
65536, 655360000, 12.839
131072, 1310720000, 12.877
262144, 2621440000, 12.942
# VA for array: 30000
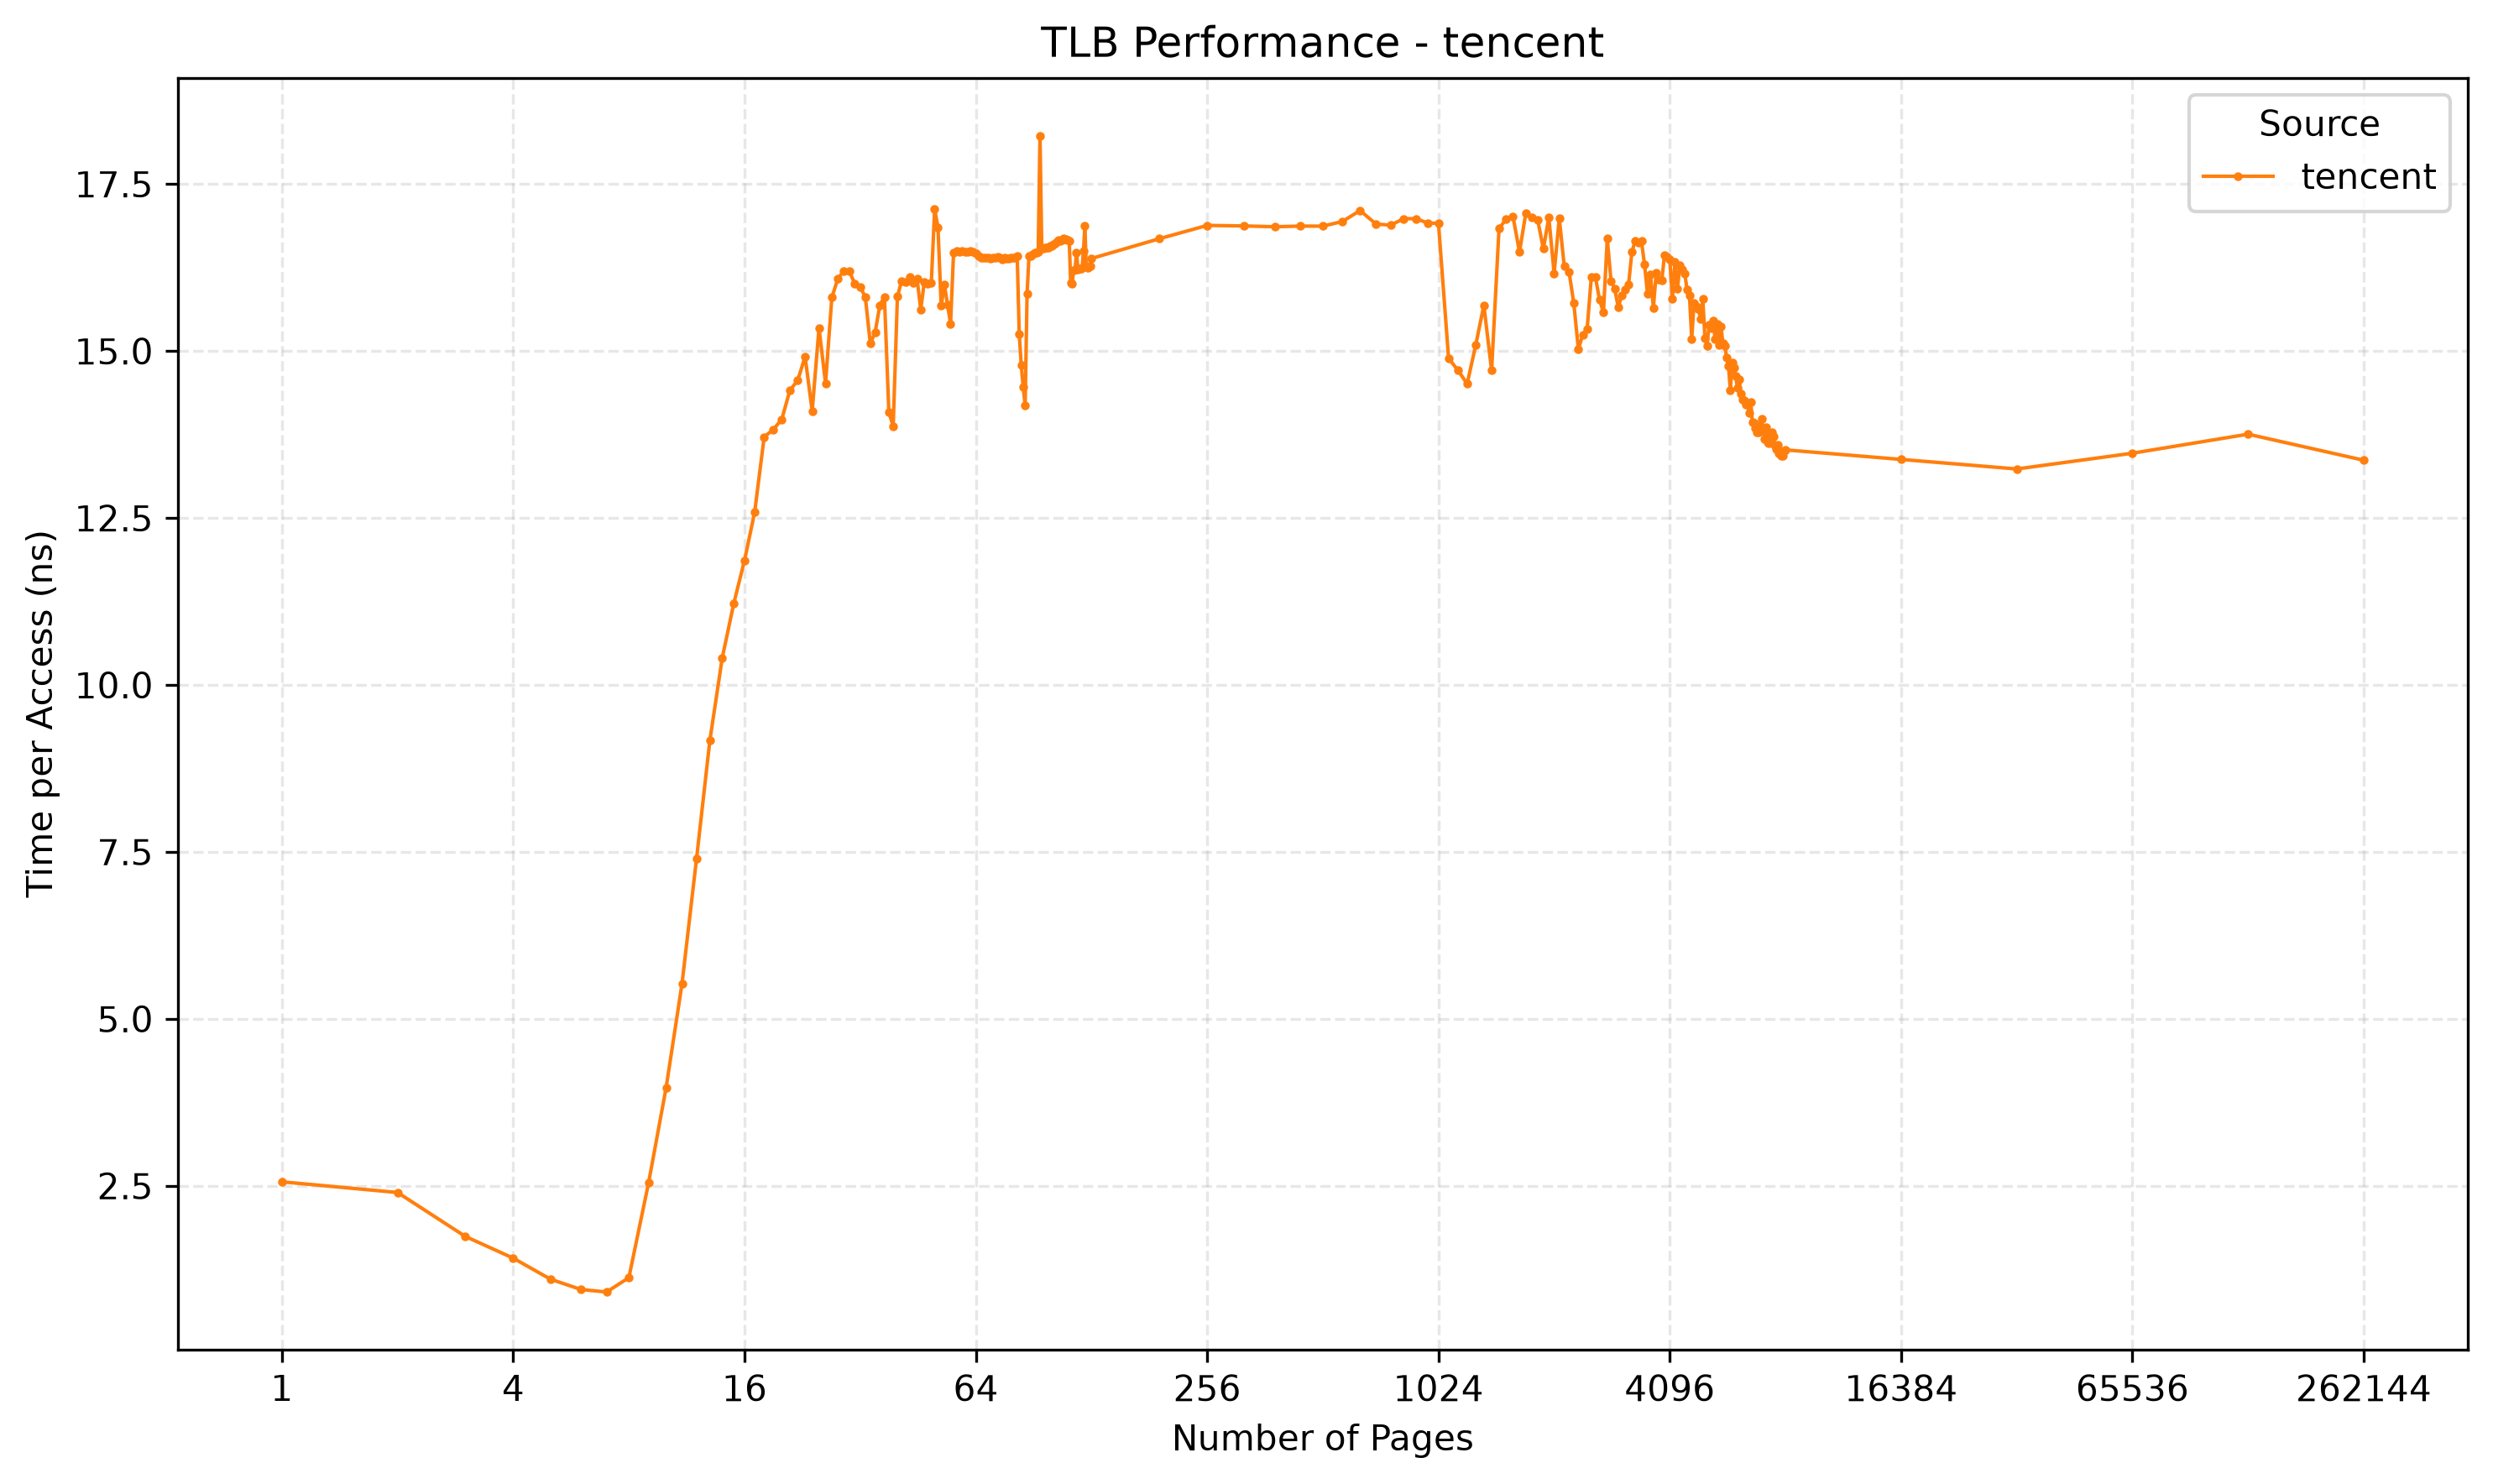
根据初步趋势,将测试分成三个区间:
# 小工作集:逐页扫描
ubuntu@VM-0-6-ubuntu:~$ ./tlb2 1 128 add 1 100000
# 主曲线:128–8192 pages,每 64 pages
ubuntu@VM-0-6-ubuntu:~$ ./tlb2 128 8192 add 64 100000
# 超大工作集:8192–262144 pages(1024MB),指数增长
ubuntu@VM-0-6-ubuntu:~$ ./tlb2 8192 262144 mul 2 100000
结果如下:
二号机器:Vultr VPS
# pages, total accesses, ns/access
1, 10000, 2.600
2, 20000, 1.200
4, 40000, 0.900
8, 80000, 1.387
16, 160000, 6.419
32, 320000, 7.016
64, 640000, 9.312
128, 1280000, 11.194
256, 2560000, 11.522
512, 5120000, 13.737
1024, 10240000, 11.436
2048, 20480000, 11.392
4096, 40960000, 11.712
8192, 81920000, 30.590
16384, 163840000, 30.055
32768, 327680000, 30.496
65536, 655360000, 31.472
当页数较少时,总运行时间较短,gettimeofday() 的微秒级取样会造成明显量化误差,因此小页数的 ns/access 不宜过度解读。扩展程序后测量了更密集的区间:
# 小工作集:逐页扫描
./tlb2 1 128 add 1 100000
min_pages: 1
max_pages: 128
# pages, total accesses, ns/access
1, 100000, 3.840
2, 200000, 1.160
3, 300000, 0.897
4, 400000, 1.133
5, 500000, 1.164
6, 600000, 1.540
7, 700000, 1.386
8, 800000, 2.545
9, 900000, 3.612
...
128, 12800000, 12.052
# VA for array: 12800000


# 主曲线:128–8192 pages,每 64 pages
./tlb2 128 8192 add 64 100000
min_pages: 128
max_pages: 8192
# pages, total accesses, ns/access
128, 12800000, 12.192
192, 19200000, 12.249
256, 25600000, 12.490
320, 32000000, 12.440
384, 38400000, 12.318
448, 44800000, 12.480
...
8192, 819200000, 30.227
# VA for array: 12700000


# 超大工作集:8192–131072 pages(512MB),指数增长,因为机器内存只有 1GB,所以只测量到了 512MB 工作集
./tlb2 8192 131072 mul 2 100000
min_pages: 8192
max_pages: 131072
# pages, total accesses, ns/access
8192, 819200000, 30.139
16384, 1638400000, 29.969
32768, 3276800000, 29.320
65536, 6553600000, 30.575
131072, 13107200000, 32.180
# VA for array: 500000
图表
数据使用 Python 脚本绘制如下:
三号机器 WSL 和四号机器 Linux 物理机
三、四号机器采用了和一号机器同样的测试范围
# 小工作集:逐页扫描
ubuntu@VM-0-6-ubuntu:~$ ./tlb2 1 128 add 1 100000
# 主曲线:128–8192 pages,每 64 pages
ubuntu@VM-0-6-ubuntu:~$ ./tlb2 128 8192 add 64 100000
# 超大工作集:8192–262144 pages(1024MB),指数增长
ubuntu@VM-0-6-ubuntu:~$ ./tlb2 8192 262144 mul 2 100000
数据汇总
四条曲线合并如下:
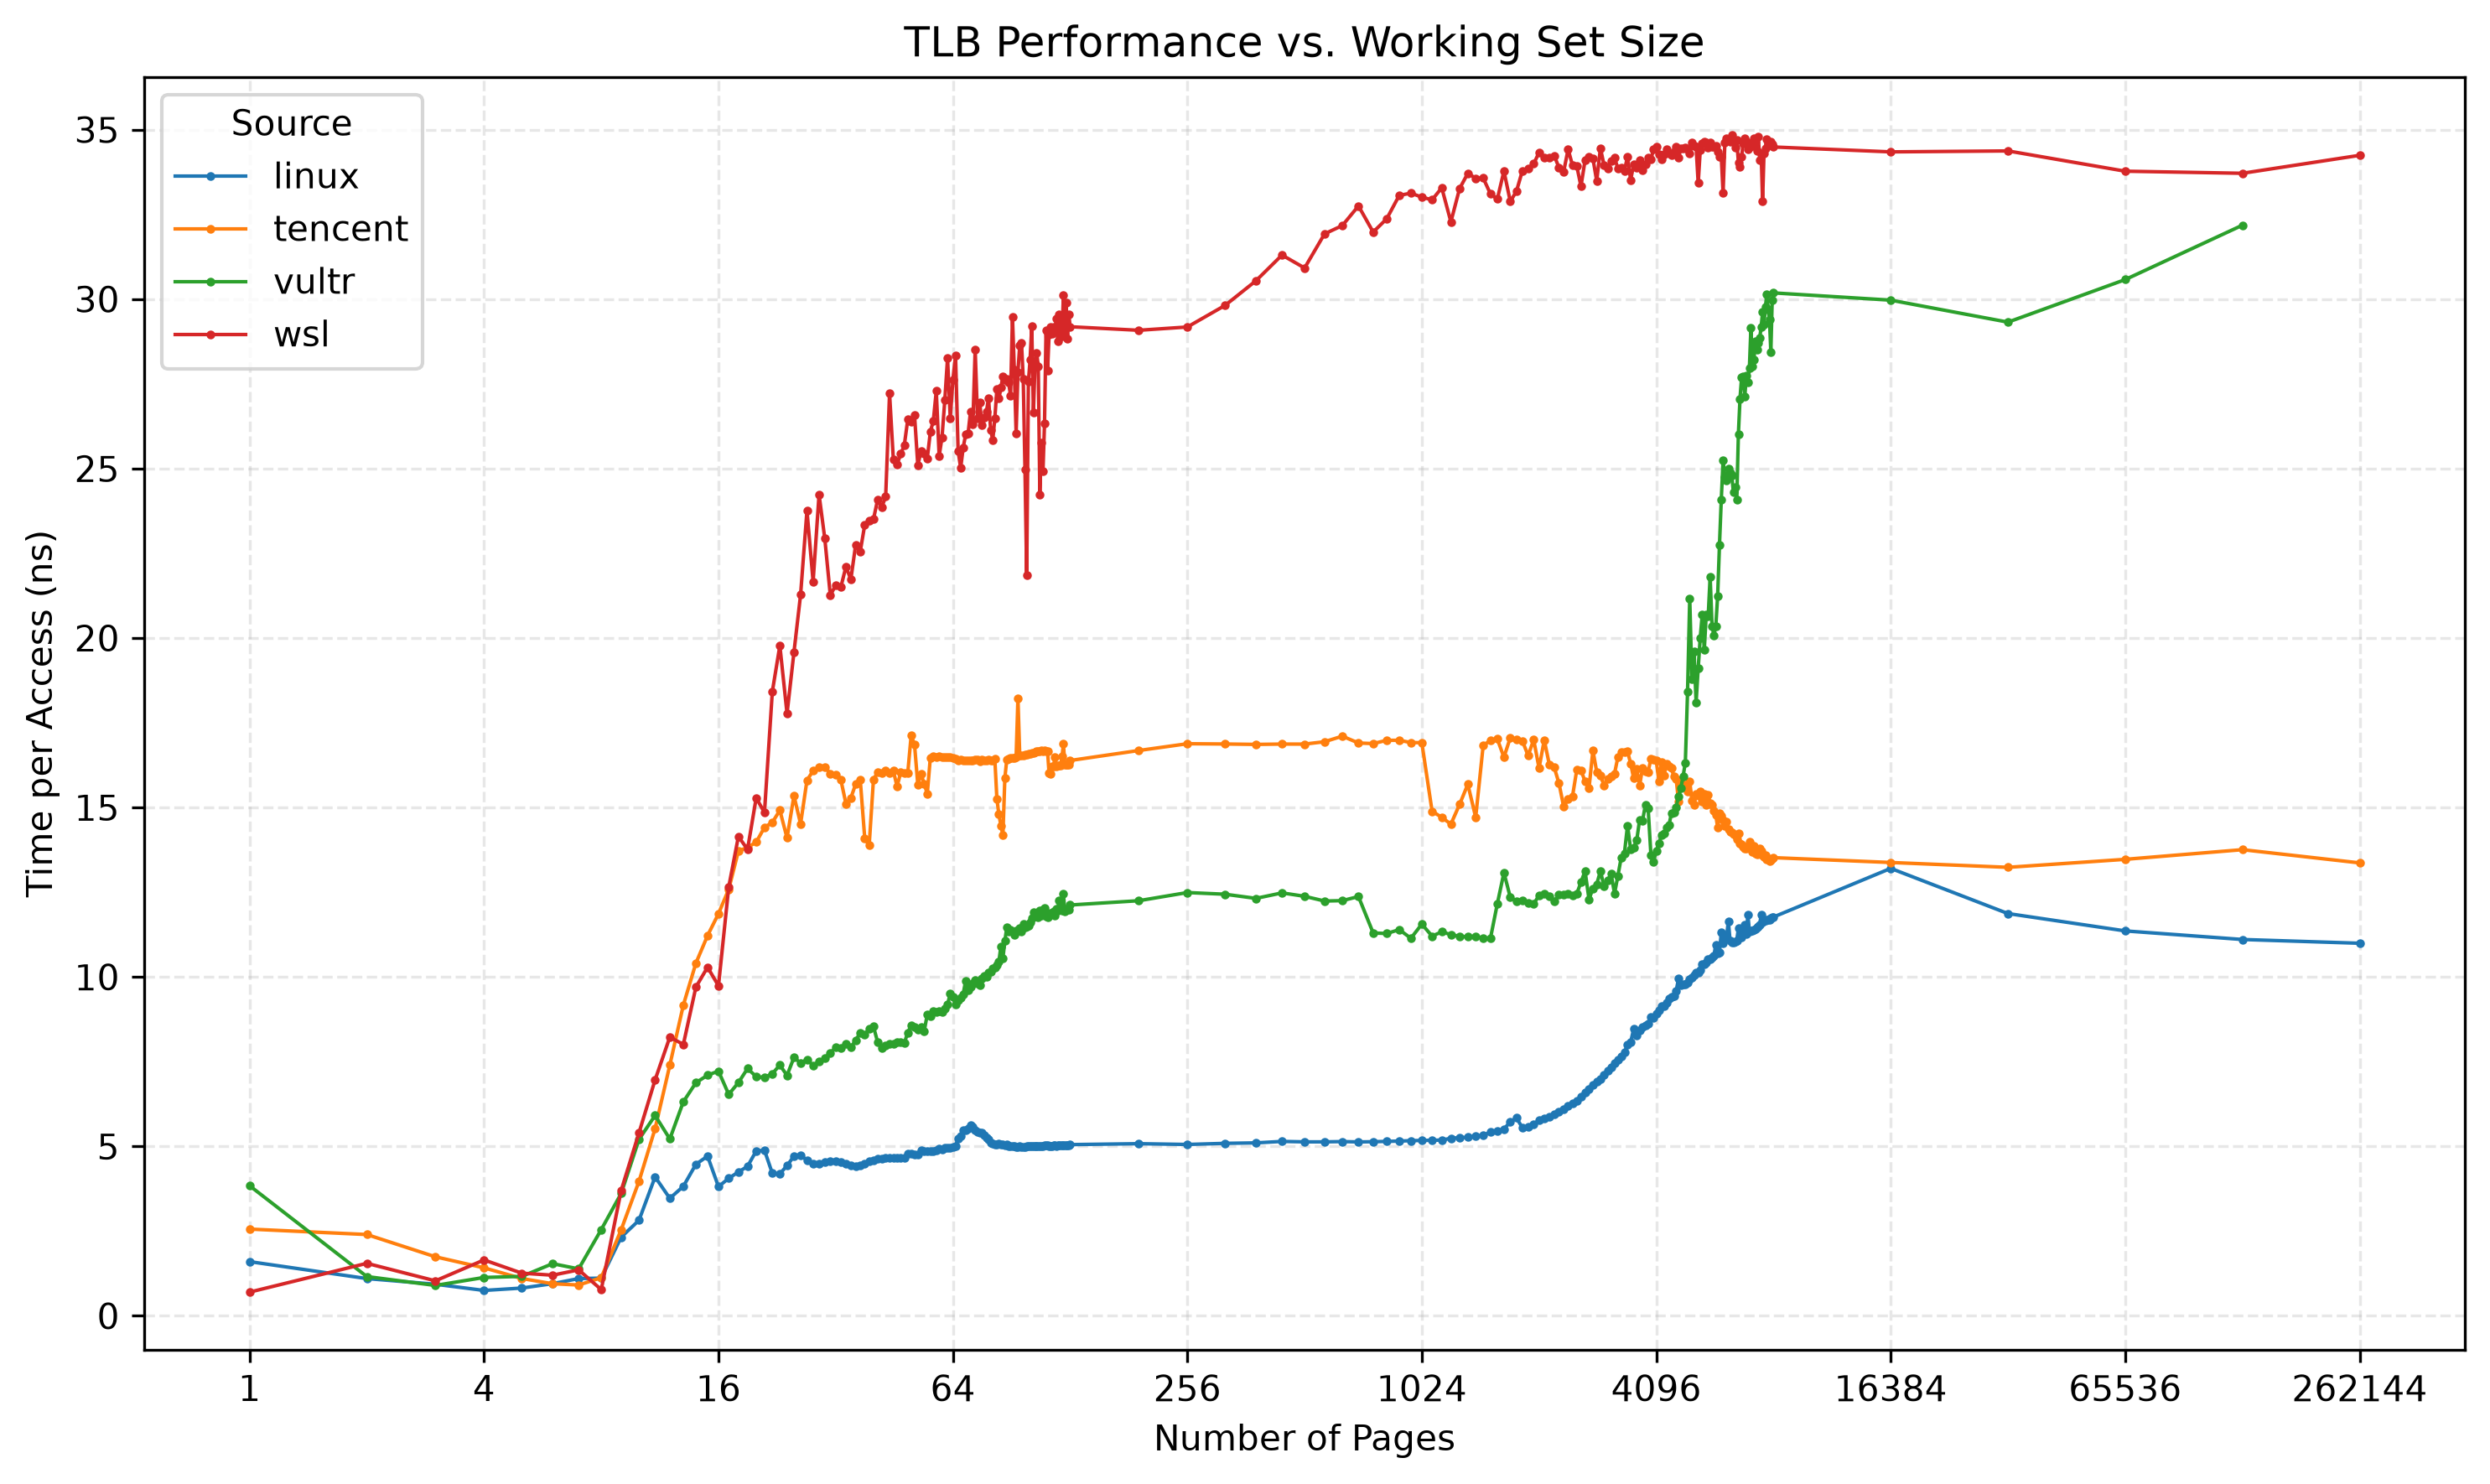
从曲线可以观察到几个较稳定的现象:
- 工作集从 8 页(约 32 KiB)开始,多个平台出现明显延迟变化。这与 L1 数据缓存容量相近,因此首先应解释为数据缓存层级变化,不能直接归因于 TLB。
- 一号机器在大工作集上没有呈现清晰、单调的 TLB 或 L3 拐点;大页、预取、宿主机调度和云平台实现都可能改变曲线形状。
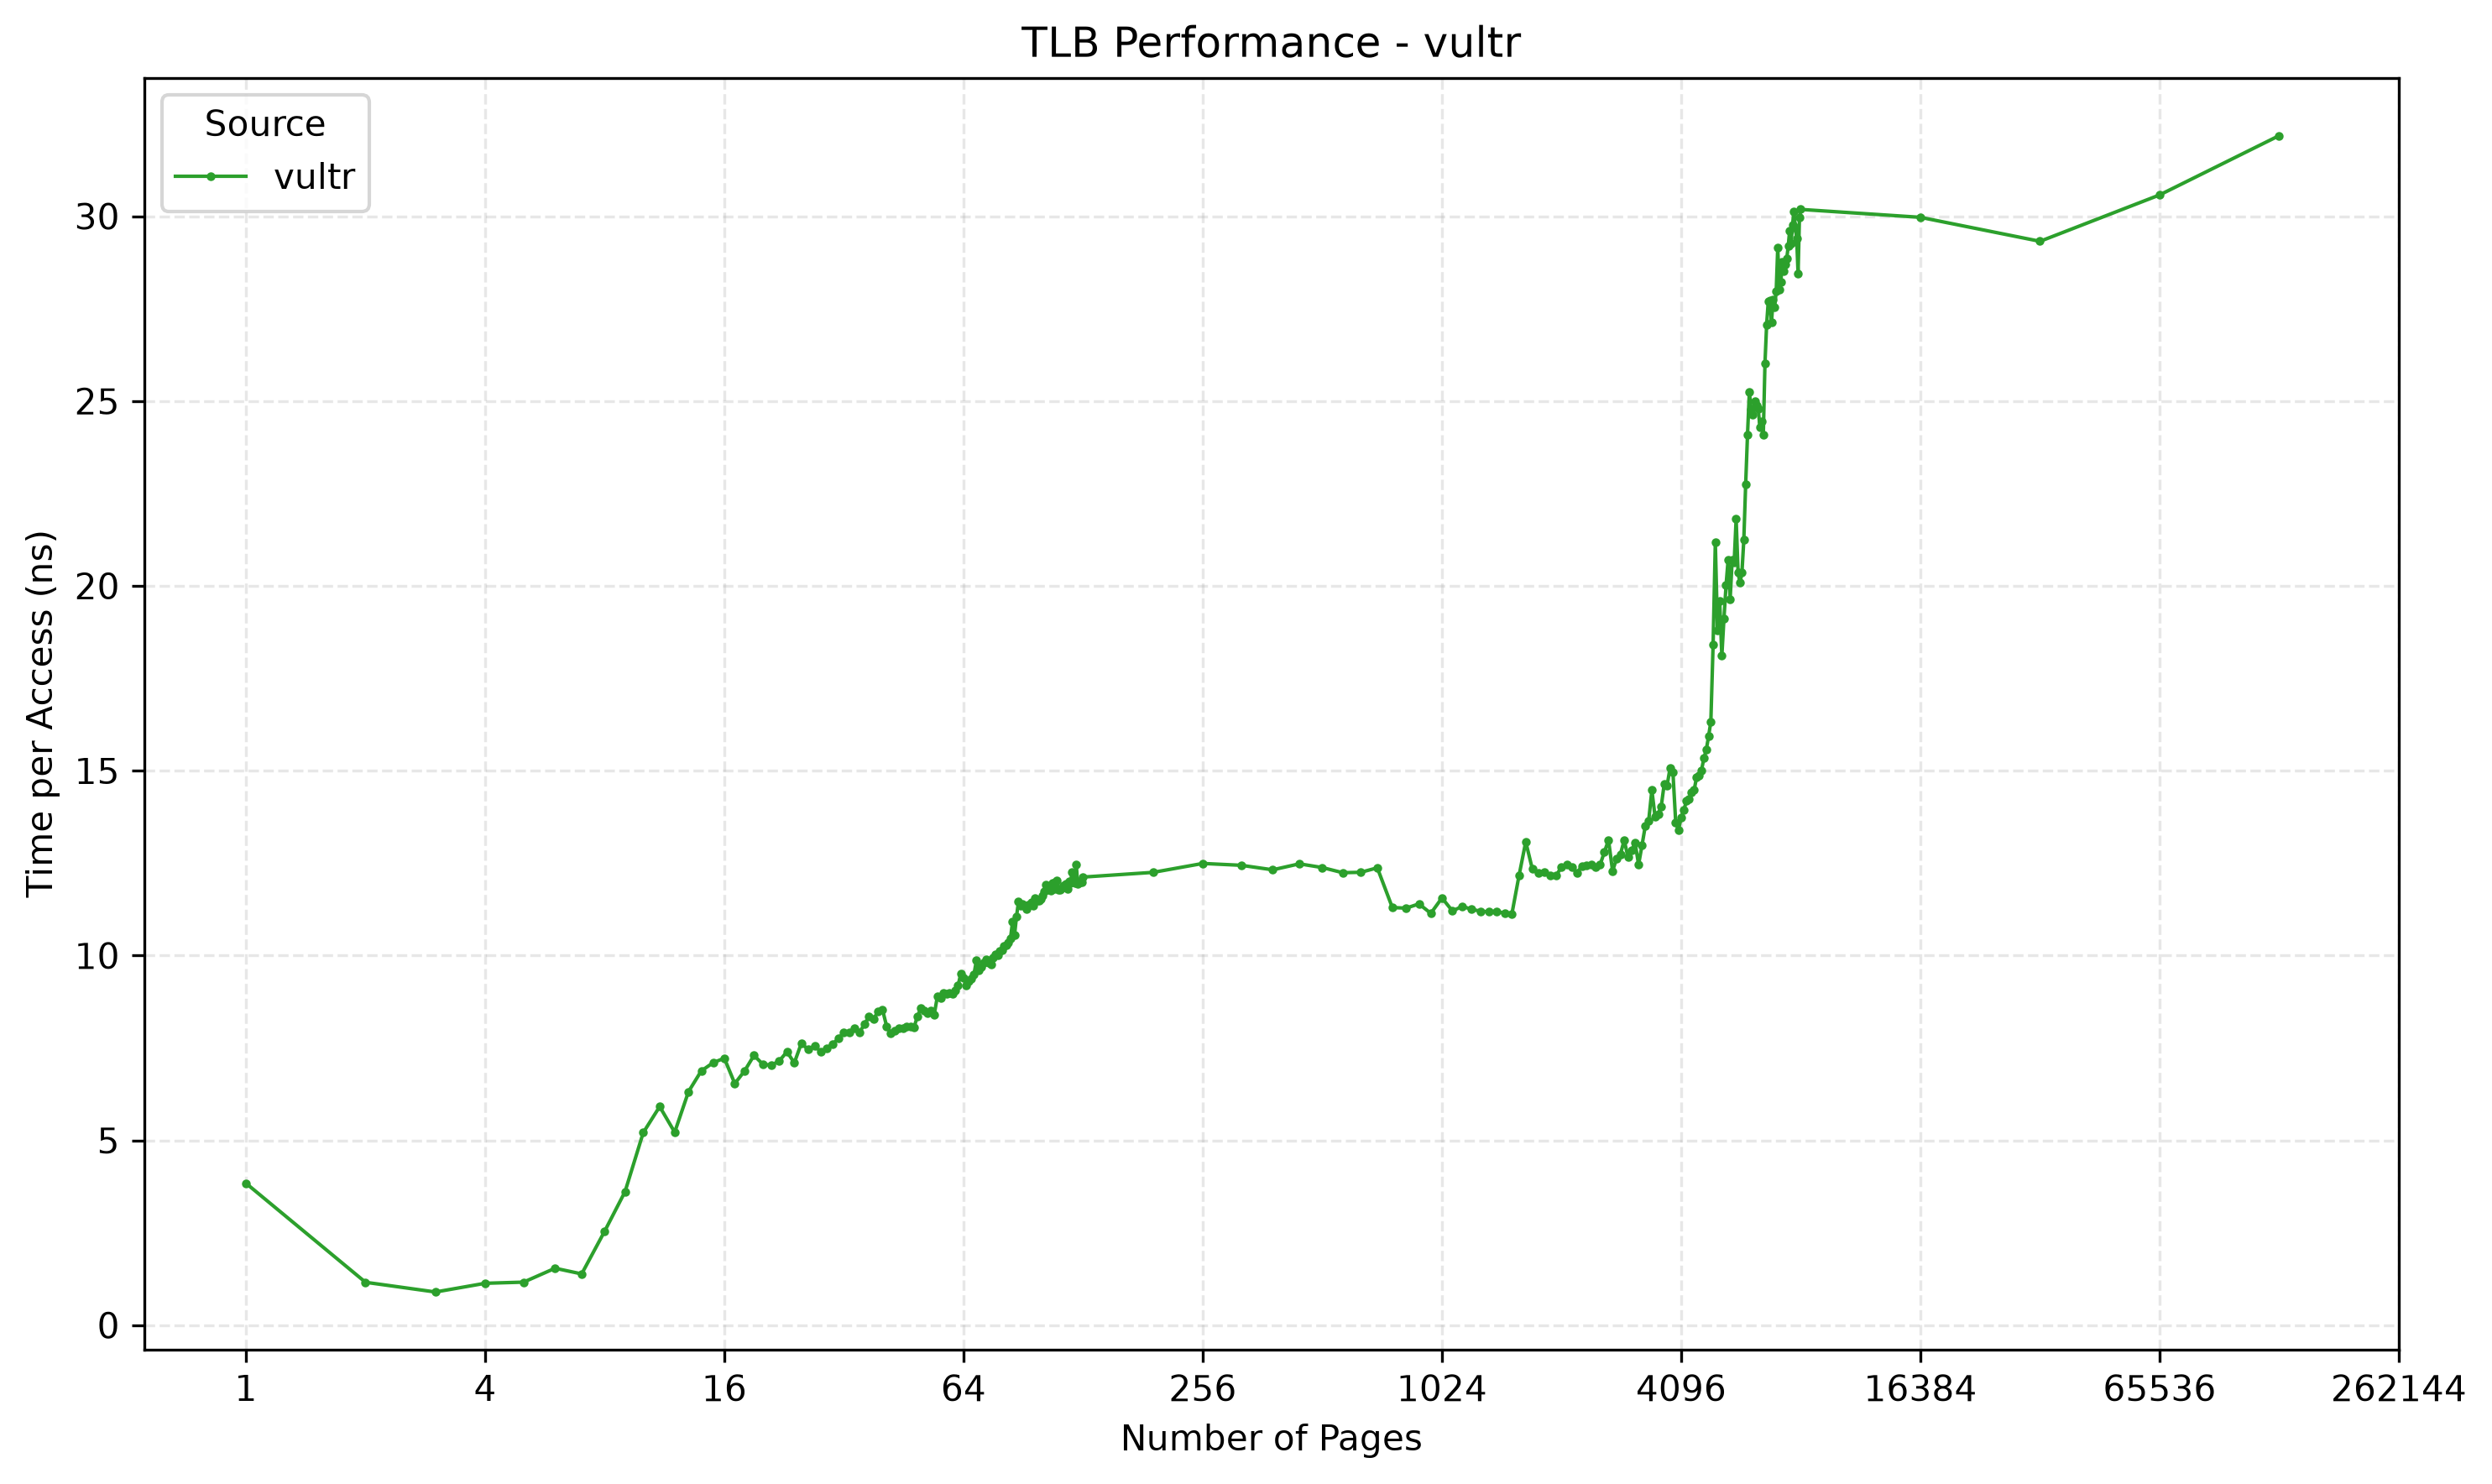
- 二号机器在约 1536 页附近出现局部尖峰,在约 4096 页之后进入更高延迟区。前者与某些 Broadwell 资料中的 STLB 容量相近,后者与二号机虚拟机报告的约 16 MiB L3 容量相近,但这些只是相关性,不能由本实验单独确认,四号机器形状类似二号机器,同理。
- 三号机器访存用时提升明显较快,在工作集达到 64 页时就已经接近 30 ns。
硬件信息与结果分析
一号和二号机器
云主机返回的 CPUID 信息显示,两台虚拟机具有相同的部分 TLB 参数,而 CPU 型号和实测曲线并不相同。因此这些参数不能直接当作底层物理 CPU 的完整规格。lscpu 通常能可靠地提供缓存和拓扑的概览,但一般不会完整报告 TLB 容量。
下表只保留与本实验最相关的公开资料和观测位置。它们是对照线,不是由本实验直接测得的硬件参数。
| 平台 | L1 D-Cache | L2 Cache | L3 Cache | 公开资料中的 4 KiB TLB 线索 |
|---|---|---|---|---|
| AMD Zen 2(腾讯云虚拟机所报告的型号) | 约 32 KiB / core | 约 512 KiB / core | EPYC 7K62 的具体拓扑决定实际分布 | 不同资料对 4 KiB DTLB 的描述存在差异;L2 TLB 结构较复杂 |
| Intel Broadwell(Vultr 暴露的虚拟模型) | 约 32 KiB / core(实体型号参考值) | 约 256 KiB / core(实体型号参考值) | 具体实体型号不同;不能由虚拟机信息确定 | 4 KiB DTLB 约 64 项、STLB 约 1536 项是部分 Broadwell 型号的参考值 |
CPUID 输出的“255 项、1-way”以及大页 TLB 为 0 等结果,与公开资料和曲线都不完全吻合,不能直接据此下硬件结论。QEMU 文档也说明,命名 CPU 模型用于向客户机提供稳定的模型接口,并不保证精确复现宿主机的型号、步进或全部微架构细节。
一号机器:曲线分析
一号机器的曲线大部分都没法用缓存或者 TLB 来进行解释。公开 Zen 2 资料中的 L1 数据缓存约为 32 KiB,约对应 8 个 4 KiB 页;曲线确实在 8 页附近开始变化。64 页、512 KiB 和 2048 页附近没有足够清晰的独立拐点,不能据此确认 L1 DTLB、L2 Cache 或 STLB 的容量;大页数下延迟下降也可能来自硬件预取、访问模式变化或测量噪声等原因,不能得到其与 L3 缓存的联系。
二号机器:曲线分析
二号机器的曲线整体来说与缓存和 TLB 容量关联程度较大。二号机器在 8 页附近开始出现缓存层级变化,64 页附近有较小波动,约 1536 页附近出现尖峰,约 4096 页后延迟明显升高。这些位置分别与 32 KiB L1 Cache、64 项 L1 DTLB、1536 项 STLB 以及虚拟机报告的 16 MiB L3 Cache 相近,但缓存 miss 与 TLB miss 会同时影响一次访问,实验无法把它们完全分离,从 L1 Cache 和 L3 Cache 边界的情况判断可能 Cache 对曲线的影响更大。
三号机器 WSL 与 四号机器 Linux 物理机:曲线分析
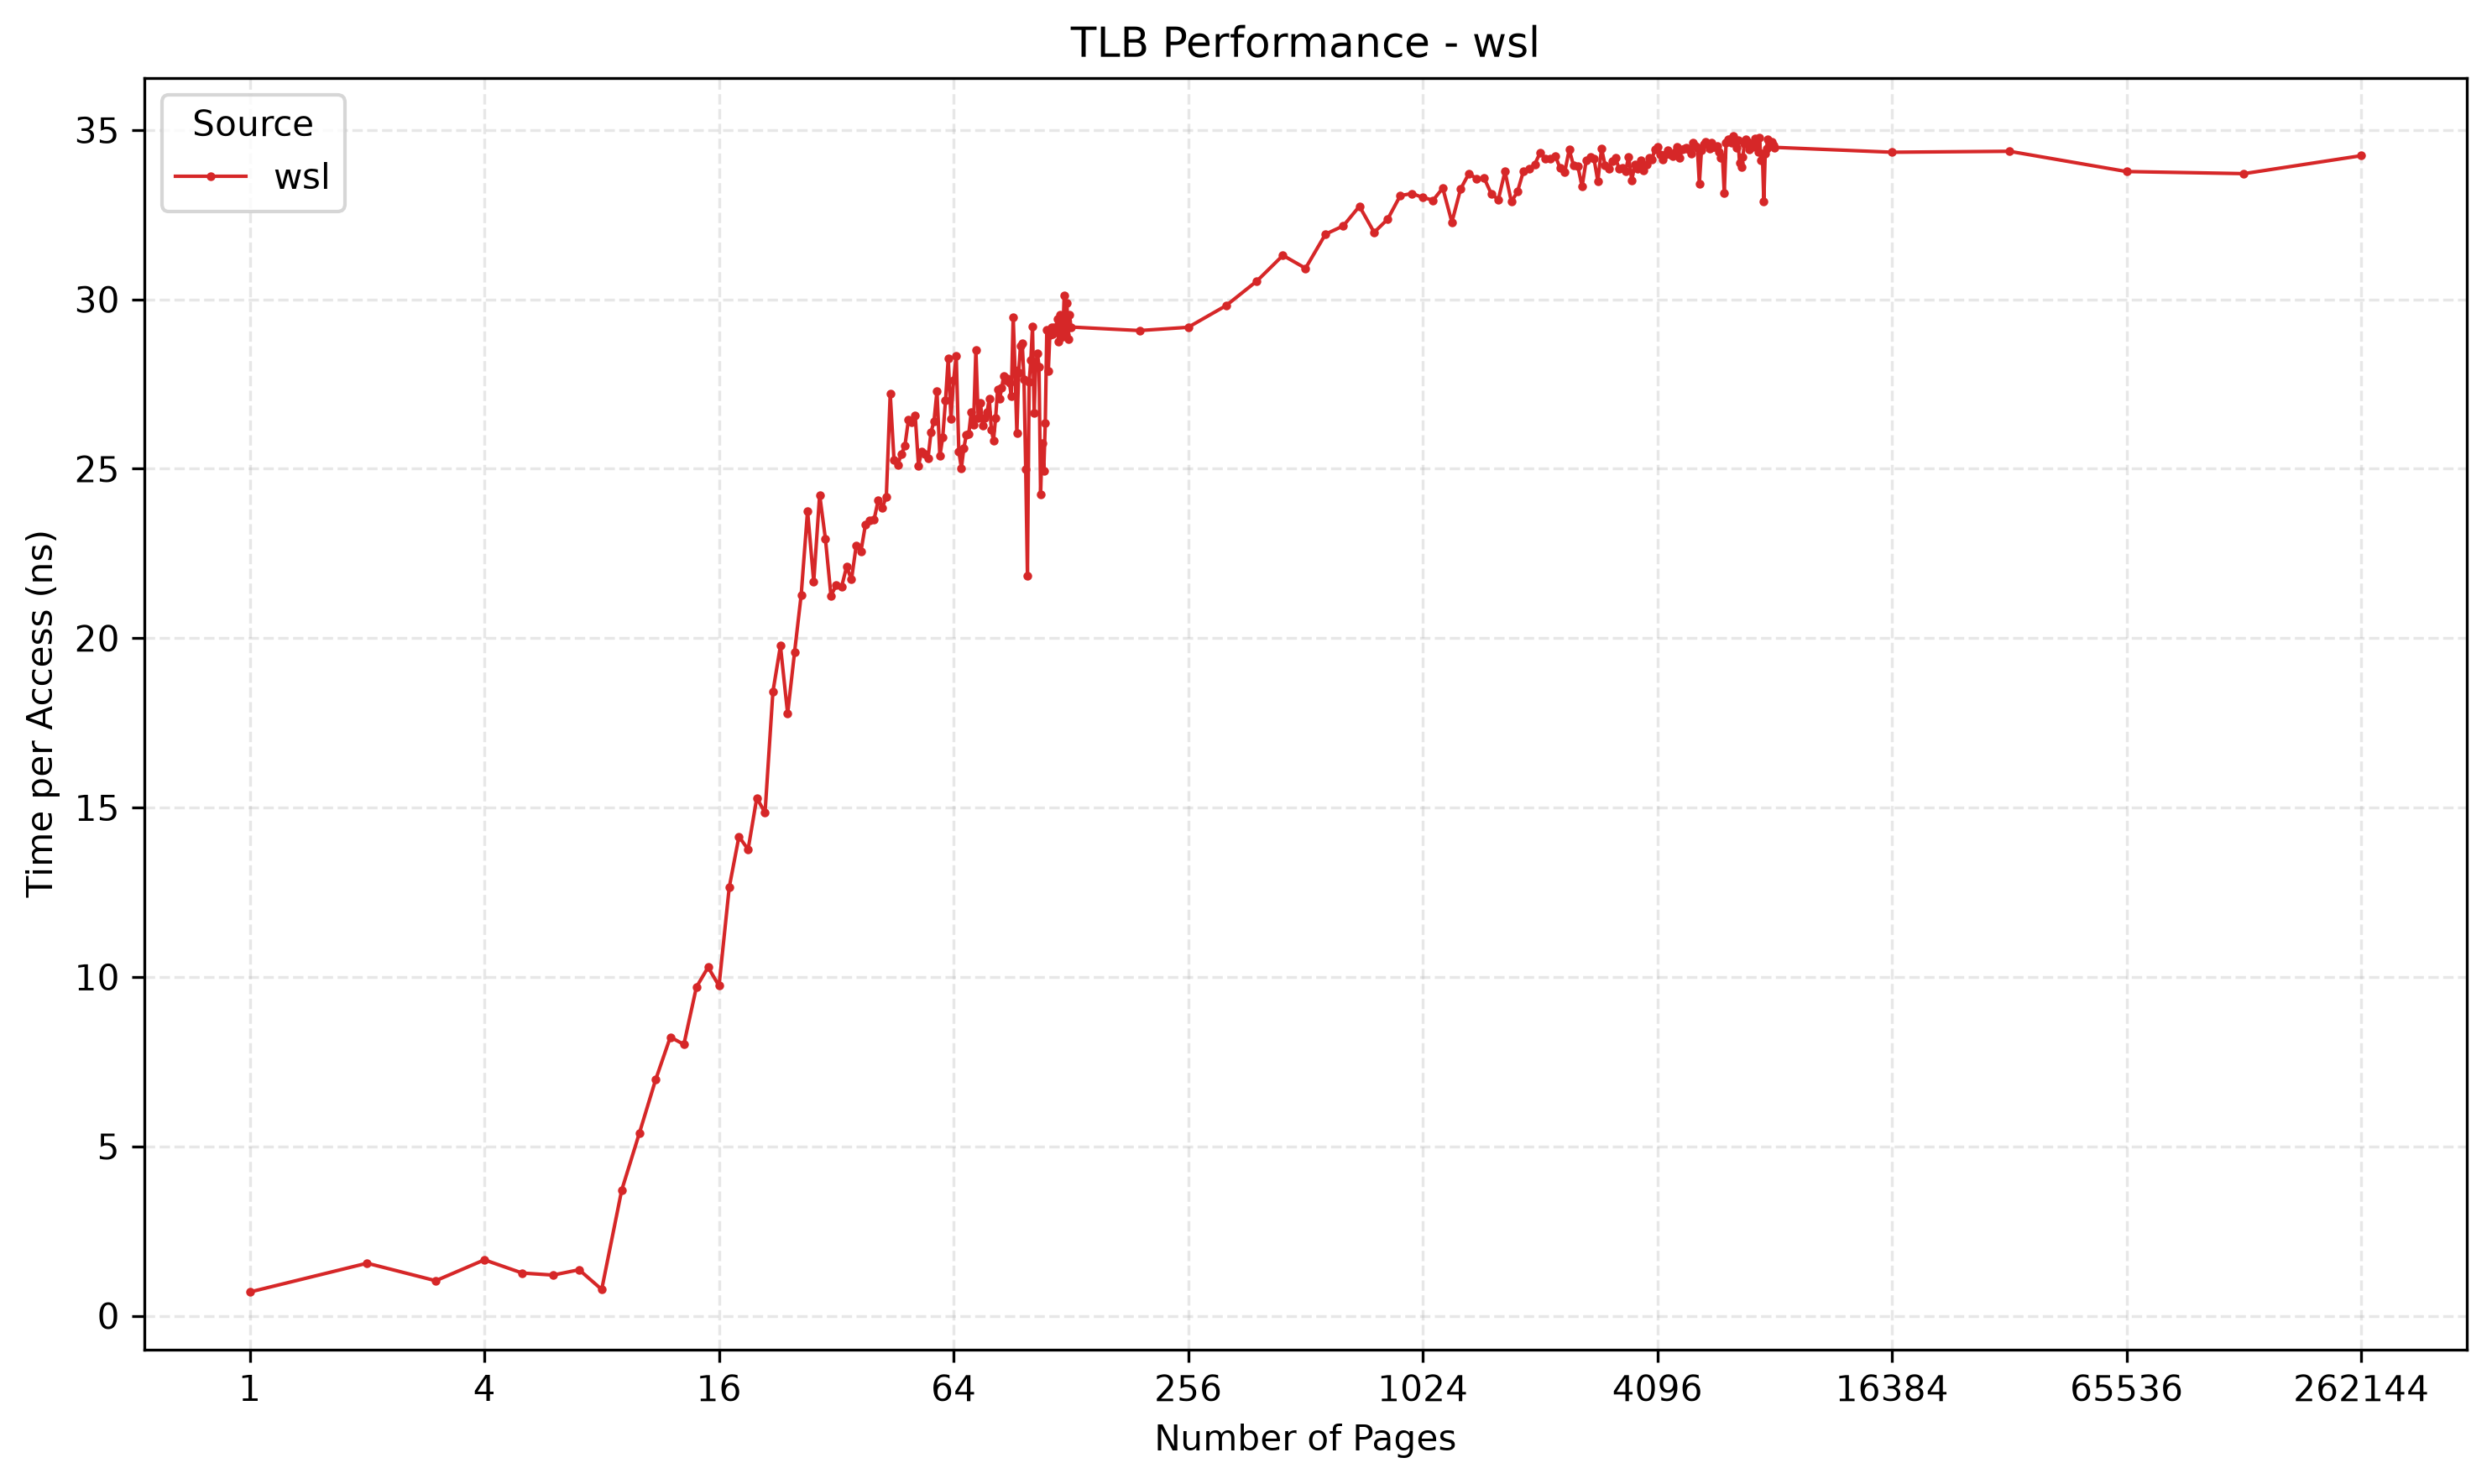
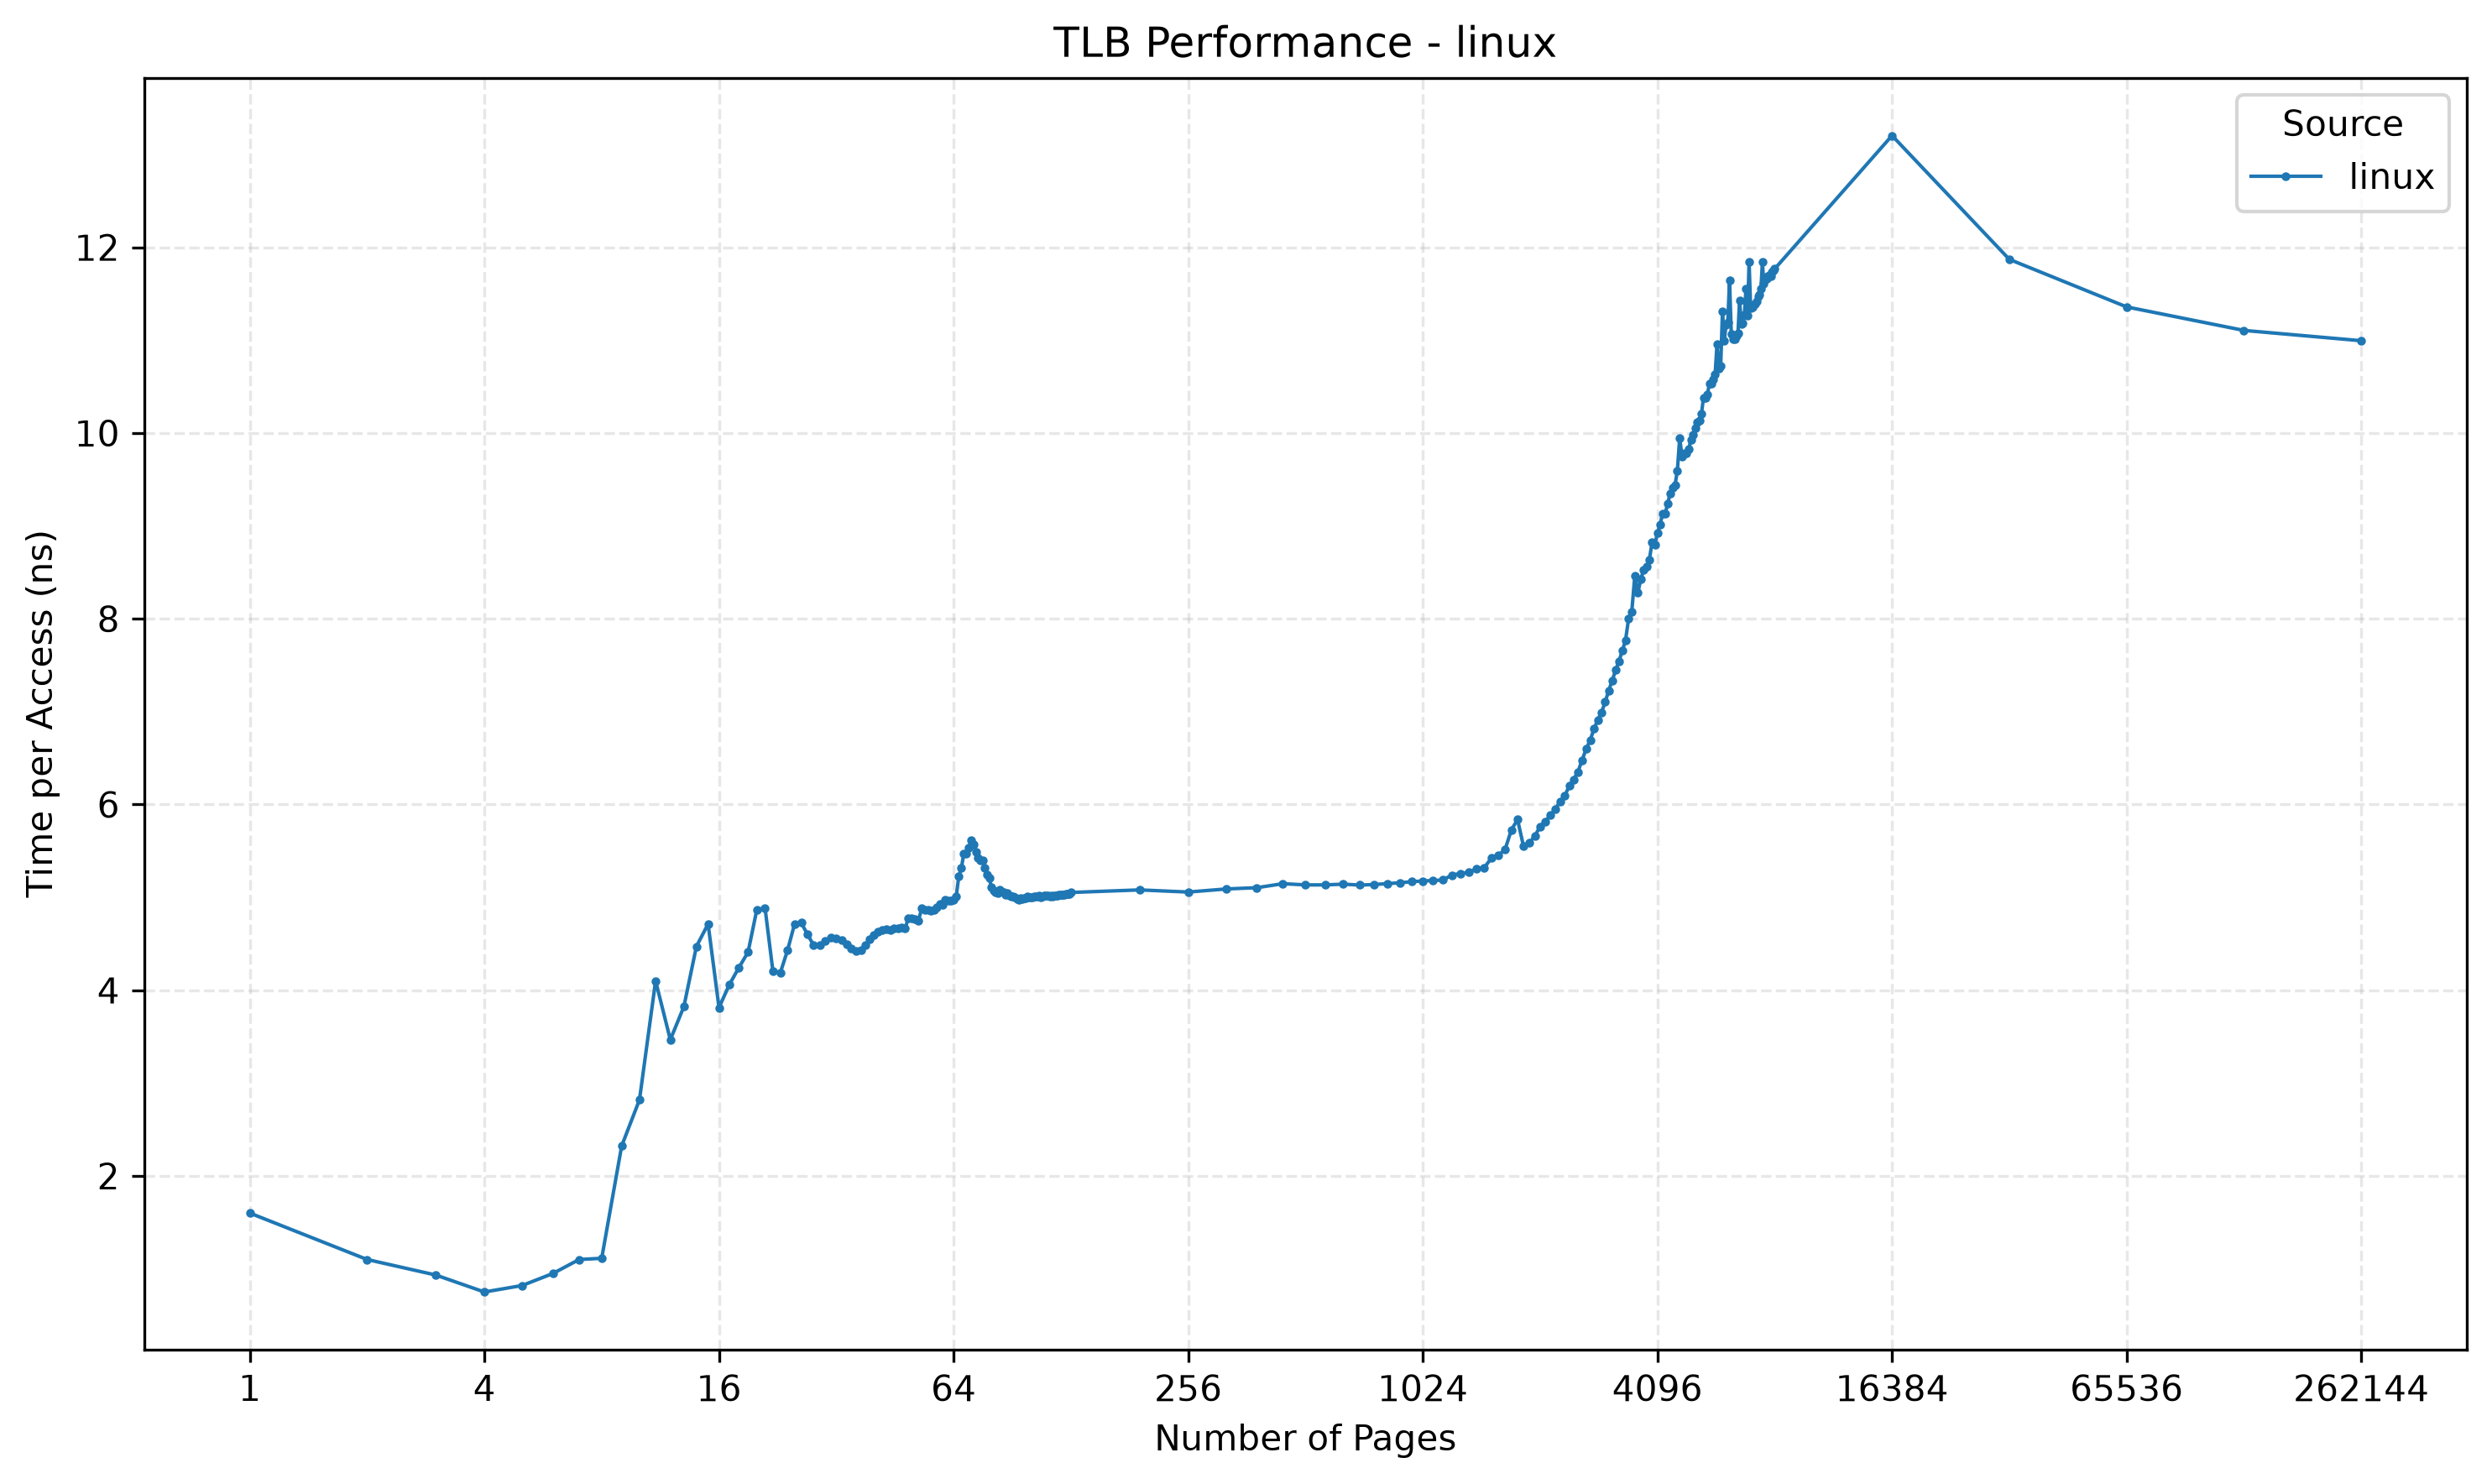
可能受架构因素的影响,三号和四号的曲线分别与一号二号相似。
| - | 一号机器 | 二号机器 | 三号机器 | 四号机器 |
|---|---|---|---|---|
| CPU型号 | AMD EPYC 7K62 | Intel Core(Broadwell) | AMD Ryzen 7 8845HS | Intel Core i5 9600F |
| CPU架构 | Zen2 | Broadwell | Zen4 | Coffee Lake Refresh |
WSL 的曲线整体上升较快,可能同时受到宿主机调度、虚拟化地址转换、透明大页和缓存层级的影响。Linux 物理机的曲线与二号机器相似:8 页附近对应 L1 数据缓存,64 页和约 1536 页附近有较小变化,约 2304 页(9 MiB)之后延迟继续升高。
实验局限
本实验成功展示了:随着按页访问的工作集增大,平均访问时间会出现分段变化;在部分平台上,变化位置与已知的缓存或 TLB 容量大致相符。但原始程序测量的是多个硬件机制的综合效果,不能仅凭一条延迟曲线准确测出 TLB 大小。因此,书中根据曲线判断 TLB 容量的方法在本实验环境中只能作为初步估计,不能视为严格测量。
为了得到更强的结论,后续实验可以:
- 使用
clock_gettime(CLOCK_MONOTONIC_RAW, ...)或硬件周期计数器,并报告重复测量的中位数和离散程度; - 对每个页数随机化测试顺序,加入预热,并多次重复整条曲线;
- 分别测试读访问、写访问、不同访问步长和大页,观察缓存与地址转换的变化是否分离;
- 使用
perf stat记录dTLB-load-misses、缓存 miss 和 page walk 等计数器; - 在裸机上固定 CPU、禁用或控制透明大页,并明确记录内核、微架构和编译器版本。
因此,本文更准确的结论是:这些数据可以帮助估计缓存和 TLB 层级变化的候选区间,但不应把某个拐点直接等同于某一级 TLB 的容量。访存时间还可能受到 CPU 虚拟化、架构设计、系统调度、透明大页和硬件预取等因素影响,不能简单地从曲线得出唯一结论。
结论
随着按页访问的工作集增大,四个平台的平均访问时间都出现了不同程度的分段变化。8 页附近的变化在多个平台上与 32 KiB L1 D-Cache 相符;64 页、1536 页和更大工作集附近也出现了与公开 TLB 或缓存参数相近的候选边界。
不过,本实验同时受到数据缓存、TLB、页表缓存、硬件预取、虚拟化和调度的影响。因而,曲线中的拐点只能作为定位硬件层级变化的线索,不能直接等同于某一级 TLB 的精确容量。
附录中的 WSL 和 Linux 物理机原始记录用于补充上述汇总。
参考资料
- AMD EPYC 7003 Series:EPYC 7K62 的官方产品信息。
- QEMU:x86 CPU model configuration:说明命名 CPU 模型、host model 和 host passthrough 的差异。
- Linux Kernel:Transparent Hugepage Support:说明透明大页、multi-size THP 以及它们对页表和 TLB 行为的影响。
- 7-cpu:AMD Zen 2:提供 Zen 2 缓存和 TLB 的实测参考,并标注部分参数的不确定性。
- 7-cpu:Intel Broadwell:提供特定 Broadwell 型号和页大小下的缓存、TLB 参考数据。
附录:原始硬件记录
四种架构的 Cache 和 TLB 信息汇总
| - | 一号机器 | 二号机器 | 三号机器 | 四号机器 |
|---|---|---|---|---|
| CPU 型号 | AMD EPYC 7K62 | Intel Core(Broadwell) | AMD Ryzen 7 8845HS | Intel Core i5-9600F |
| CPU 架构 | Zen 2 | Broadwell | Zen 4 | Coffee Lake Refresh |
| L1 I-Cache | 32 KB / 核,私有 | 32 KB / 核,私有 | 32 KB / 核,私有 | 32 KB / 核,私有 |
| L1 D-Cache | 32 KB / 核,私有 | 32 KB / 核,私有 | 32 KB / 核,私有 | 32 KB / 核,私有 |
| L2 Cache | 512 KB / 核,私有 | 256 KB / 核,私有 | 1 MB / 核,私有 | 256 KB / 核,私有 |
| L3 Cache | EPYC 7K62 标称 256 MB,按 CCD/CCX 分布 | Broadwell 具体型号不同;虚拟机报告值为 16 MB | 16 MB,共享 | 9 MB,共享 |
| L1 ITLB | 64 entries(参考值) | 128 entries(参考值) | 64 entries(参考值) | 128 entries(参考值) |
| L1 DTLB | 64 entries(参考值) | 64 entries(参考值) | 72 entries(参考值) | 64 entries(参考值) |
| L2 ITLB | 512 entries | 由 L2 TLB 结构决定 | 512 entries | 统一 STLB |
| L2 DTLB | 2048 entries(参考值) | 1536 entries(参考值) | 3072 entries(参考值) | 1536 entries(参考值) |
| L2 TLB 类型 | 分离 ITLB / DTLB | 统一 TLB | 分离 ITLB / DTLB | 统一 STLB |
一号和二号机器:原始信息
硬件信息
本文尝试使用了 cpuid 和 lscpu 来尝试查询有关 TLB 和 Cache 的信息,得到的结果如下
| 参数 | 一号机:腾讯云 CVM — CPUID | 一号机:腾讯云 CVM — lscpu | 一号机:AMD Zen 2 公开资料 | 二号机:Vultr — CPUID | 二号机:Vultr — lscpu | 二号机:Intel Broadwell 公开资料 | 判断 |
|---|---|---|---|---|---|---|---|
| L1 D Cache | 64 KB,2-way | 64 KB(32 KB/core) | 32 KB/core,8-way | 64 KB,2-way | 32 KB | 32 KB/core,8-way | 两机实测 Cache 行为倾向于支持约 32 KB L1 |
| L1 I Cache | 64 KB,2-way | 64 KB(32 KB/core) | 32 KB/core,8-way | 64 KB,2-way | 32 KB | 32 KB/core,8-way | 本测试不涉及 ICache;lscpu 与公开资料基本吻合 |
| L2 Cache | 512 KB,8-way | 8 MB(4 MB/core) | 512 KB/core,8-way | 512 KB,8-way | 4 MB | 256 KB/core,8-way | 二号机测试更倾向于支持 256KB(64 pages);一号机未观察到清晰 L2 拐点 |
| L3 Cache | 256 MB | 16 MB | 16 MB/CCX;整颗 7K62 属于 Zen 2 多-CCX 架构 | 16 MB | 16 MB | 取决于具体 Broadwell 型号 | 二号机约 16 MB(4096 pages)后进入明显高延迟区;一号机未观察到清晰 L3 拐点 |
| Cache Line | — | 64 B(通常) | 64 B | — | 64 B(通常) | 64 B | 与常见 x86 Cache 结构一致 |
| L1 DTLB,4 KB | 255 entries,1-way | — | 约 64 entries;Zen 2 具有复杂的多页尺寸 TLB 结构 | 255 entries,1-way | — | 64 entries,4-way | CPUID 的 255/1-way 无法从测试结果中得到验证,二号机的 64 entries 和 L2 Cache 位置重合 |
| L1 ITLB,4 KB | 255 entries,1-way | — | 约 64 entries | 255 entries,1-way | — | 128 entries,4-way/相关结构 | CPUID/lscpu 显示结果与公开资料不符 |
| L2 / STLB,4 KB | 512 entries,4~5-way | — | 2048 entries,16-way | 512 entries,4~5-way | — | 1536 entries,6-way | CPUID 的 512 entries 与两种理论架构均不符;二号机的测试结果更倾向于支持 1536 entries |
| L2 TLB,2 MB | 0 | — | 2048 entries,16-way(2 MB/相关大页结构) | 0 | — | Broadwell 存在独立大页 TLB 结构 | CPUID 的 0 显然不适合作为真实硬件结论 |
| TLB 层次结构 | L1 + L2 | — | 多级 TLB | L1 + L2 | — | L1 + STLB | 两台 VM 的 CPUID 给出了相同 TLB 参数,可信度较低 |
可以看出来两台虚拟机中的 lscpu/CPUID 信息参考价值并不大。尤其是 TLB 参数,与对应微架构的公开资料存在明显差异。
一号机(腾讯云 CVM)曲线对照
将公开的 Zen2 架构中的 Cache 和 TLB 容量与 pages 数量相对应可以制作成如下的表格
| 边界 | 类型 | 对应位置 | 访存用时现象 | 分析 |
|---|---|---|---|---|
| L1 DCache | 缓存 | 8 pages (32KB) | 从 1ns 左右开始明显越升,最后稳定在 16ns 附近 | 8 pages 之后 L1 Cache 开始出现 miss,需要从 L2 Cache 中读取 |
| L1 DTLB | TLB | 64 pages (64 entries) | 无明显波动 | 64 页处没有独立拐点,不能仅凭该曲线确认 L1 DTLB 容量。 |
| L2 Cache | 缓存 | 128 pages (512 KiB) | 上升十分微小,几乎可忽略 | 512 KiB 附近没有清晰的独立拐点,缓存层级变化被其他因素掩盖。 |
| L2 STLB | TLB | 2048 pages (2048 entries) | 开始波动并有下降趋势 | 波动位置与公开资料中的 STLB 容量不够吻合,且下降趋势不符合简单的容量溢出模型,不能据此确认。 |
| L3 Cache | 缓存 | 4096 pages (16 MiB) | 明显下降,8192 页后稳定在约 13 ns | 4096 页处没有出现典型的延迟上升;大工作集的下降可能与预取、虚拟化或测量噪声有关。 |
由于一号机是腾讯云服务器提供的 vCPU,无法确定这一现象的真实原因。大工作集下的下降可能与预取、虚拟化实现或测量噪声有关,不能直接归因于某种确定的硬件优化。
二号机(Vultr VPS)曲线对照
这里同样适用公开的 Broadwell 架构(Core 五代)中的 Cache 和 TLB 信息对比现象
| 边界 | 类型 | 对应位置 | 访存用时现象 | 分析 |
|---|---|---|---|---|
| L1 DCache | 缓存 | 8 pages (32 KiB) | 从 1~2 ns 开始明显上升,16 页之后放缓(7 ns 到 9 ns) | 8 页附近与 32 KiB L1 D-Cache 容量相符,应首先解释为数据缓存 miss 增多。 |
| L1 DTLB | TLB | 64 pages (64 entries) | 延迟持续上升直到 128 页(9 ns 到 12 ns) | 64 页附近与公开的 L1 DTLB 容量相符,但同一范围也受到缓存变化影响,不能单独确认 TLB miss。 |
| L2 Cache | 缓存 | 64 pages (256 KiB) | 与前一阶段变化重合,约 704 页后暂时稳定在 11 ns | 256 KiB 可能参与延迟变化,但曲线没有清晰拐点,不能把 64 页处的变化单独归因于 L2 Cache。 |
| L2 STLB | TLB | 1536 pages (1536 entries) | 出现较高尖峰(11 ns 到 13 ns) | 尖峰与公开的 1536 项 STLB 容量相近,是较有价值的候选位置;仍需计数器验证。 |
L3 Cache(取 lscpu 和 cpuid 的结果) | 缓存 | 4096 pages (16 MiB) | 延迟从约 13 ns 阶梯式升至约 30 ns | 4096 页与 16 MiB L3 容量相符;此处可能同时发生 L3 miss 和页表遍历,无法分离两者贡献。 |
总体而言,缓存容量变化对二号机器曲线的影响明显大于 TLB 的局部尖峰。
WSL 和 Linux 物理机
Cache 和 TLB 信息
WSL 运行在 AMD Zen4 架构的Ryzen 8845HS 上;Linux 物理机运行在 Intel Coffee Lake Refresh 架构的 Core i5-9600F 上,查询到相关信息如下
| CPU | Cache | 容量 | 相联度 | 归属 |
|---|---|---|---|---|
| Ryzen 7 8845HS | L1 I-Cache | 32 KB / core | 8-way | 每核心独立 |
| L1 D-Cache | 32 KB / core | 8-way | 每核心独立 | |
| L2 Cache | 1 MB / core | 8-way | 每核心独立 | |
| L3 Cache | 16 MB | — | 多核心共享 | |
| Core i5-9600F | L1 I-Cache | 32 KB / core | 8-way | 每核心独立 |
| L1 D-Cache | 32 KB / core | 8-way | 每核心独立 | |
| L2 Cache | 256 KB / core | 4-way | 每核心独立 | |
| L3 Cache | 9 MB | 16-way | 多核心共享 |
| CPU | TLB | Page Size | Entries | 相联度 | 归属 |
|---|---|---|---|---|---|
| Ryzen 7 8845HS / Zen 4 | L1 ITLB | 4 KB / 2 MB / 1 GB | 64 | Fully associative | 每核心独立 |
| L1 DTLB | 4 KB / 2 MB / 1 GB | 72 | Fully associative | 每核心独立 | |
| L2 ITLB | 4 KB / 2 MB | 512 | 8-way | 每核心独立 | |
| L2 DTLB | 4 KB / 2 MB | 3072 | 24-way | 每核心独立 | |
| Core i5-9600F / Coffee Lake | L1 ITLB | 4 KB | 128 | 8-way | 每核心独立 |
| L1 ITLB | 2 MB | 8 / thread | — | 每核心 | |
| L1 DTLB | 4 KB | 64 | 4-way | 每核心独立 | |
| L1 DTLB | 2 MB / 4 MB | 32 | 4-way | 每核心 | |
| L1 DTLB | 1 GB | 4 | 4-way | 每核心 | |
| STLB(I+D) | 4 KB / 2 MB | 1536 | 12-way | 每核心 | |
| STLB | 1 GB | 16 | 4-way | 每核心 |
WSL 曲线对照
从曲线的形状上来看,WSL 的测试结果与二号机的四段阶梯状差别较大
| 边界 | 类型 | 对应位置 | 访存用时现象 | 分析 |
|---|---|---|---|---|
| L1 DCache | 缓存 | 8 pages (32 KiB) | 从 1 ns 左右阶梯式上升 | 8 页附近与 32 KiB L1 D-Cache 容量相符,是最明确的第一处缓存边界。 |
| L1 DTLB | TLB | 72 pages (72 entries) | 延迟继续上升,随后稳定在约 28 ns | 72 页附近没有清晰尖峰;上升趋势更可能是缓存层级、地址转换和虚拟化开销共同作用的结果。 |
| L2 Cache | 缓存 | 256 pages (1024 KiB) | 延迟继续上升,直到约 34 ns | 256 页与 1 MiB L2 Cache 容量相符,但曲线未出现明确拐点,只能作为候选边界。 |
| L2 DTLB | TLB | 3072 pages (3072 entries) | 在约 34 ns 附近波动 | 3072 页附近没有明显新的延迟跃升,无法仅凭该结果确认 L2 DTLB 容量。 |
| L3 Cache | 缓存 | 4096 pages (共享 16 MiB) | 与上一阶段接近 | 4096 页与共享 L3 容量相近,但曲线没有独立拐点;WSL 的虚拟化和共享缓存环境会降低判断可靠性。 |
这里的延迟上升得较快,64 页之前就已经超过 20 ns,说明该曲线不能只用单一的 TLB 容量模型解释。WSL 还可能受到宿主机调度、虚拟化地址转换和透明大页的影响。
Linux 物理机曲线对照
曲线形状和 Intel Broadwell 架构的 Vultr VPS 相似,值得注意的是它们的架构存在很多相似之处,只是 STLB 相联度不太一样(6路 vs 12路)
| 项目 | Broadwell | Coffee Lake Refresh |
|---|---|---|
| 制程 | 14 nm | 14 nm |
| 微架构 | Broadwell | Skylake-derived |
| L1 I-Cache | 32 KB / core | 32 KB / core |
| L1 D-Cache | 32 KB / core | 32 KB / core |
| L2 | 256 KB / core | 256 KB / core |
| L3 | 约 2 MB / core,共享 | 约 2 MB / core,共享 |
| L1 ITLB,4 KB | 128 entries / core | 128 entries / core |
| L1 ITLB,2/4 MB | 8 / thread | 8 / thread |
| L1 DTLB,4 KB | 64 entries / core | 64 entries / core |
| L1 DTLB,2/4 MB | 32 entries / core | 32 entries / core |
| L1 DTLB,1 GB | 4 entries / core | 4 entries / core |
| L2/STLB,4 KB | 1536 entries / core | 1536 entries / core |
| L2/STLB,2/4 MB | 与 4 KB 共享 | 与 4 KB 共享 |
| L2/STLB,1 GB | 16 entries | 16 entries |
| 边界 | 类型 | 对应位置 | 访存用时现象 | 分析 |
|---|---|---|---|---|
| L1 DCache | 缓存 | 8 pages (32KB) | 从 1ns 左右阶梯式上升 | 8 pages 之后 L1 Cache 开始出现 miss,需要从 L2 Cache 中读取 |
| L1 DTLB | TLB | 64 pages (64 entries) | 存在小尖刺(5 ns 到 5.6 ns) | 位置与 64 项 L1 DTLB 相符,但尖峰很小,且与 256 KiB L2 Cache 的候选边界重合,证据有限。 |
| L2 Cache | 缓存 | 64 pages (256 KiB) | 与上一处小尖峰重合 | 64 页与 256 KiB L2 Cache 相符,但无法从这条曲线区分 L2 Cache 和 L1 DTLB 的影响。 |
| L2 STLB | TLB | 1536 pages (1536 entries) | 出现小尖刺(5.4 ns 到 5.8 ns) | 1536 页处与公开 STLB 容量相符,但变化幅度很小,只能作为候选位置。 |
| L3 Cache | 缓存 | 2304 pages (9 MiB 共享) | 明显上升趋势(6 ns 到 11 ns 以上) | 2304 页与 9 MiB 共享 L3 容量相符,是曲线中较明显的高延迟区;同时仍可能包含页表遍历开销。 |
值得注意的一点是,四号机即便在工作集大小超过 L3 Cache 之后,整体的访存用时仍然较低,可能存在硬件预取等机制在起作用,但当前数据不足以证明具体原因。
以上硬件参数和边界位置仅作为对照记录,不能替代在同一环境中进行的硬件计数器测量。